深入解析 Cilium:eBPF 卷起云原生网络栈,Identity 与 5 条 datapath 全栈拆解
💬 评论CNCF Graduated 项目 Cilium:620K 行 Go + 92K 行 BPF,Identity 模型、5 条 datapath、kube-proxy socket-level 替换、Hubble/ClusterMesh 一篇讲透。
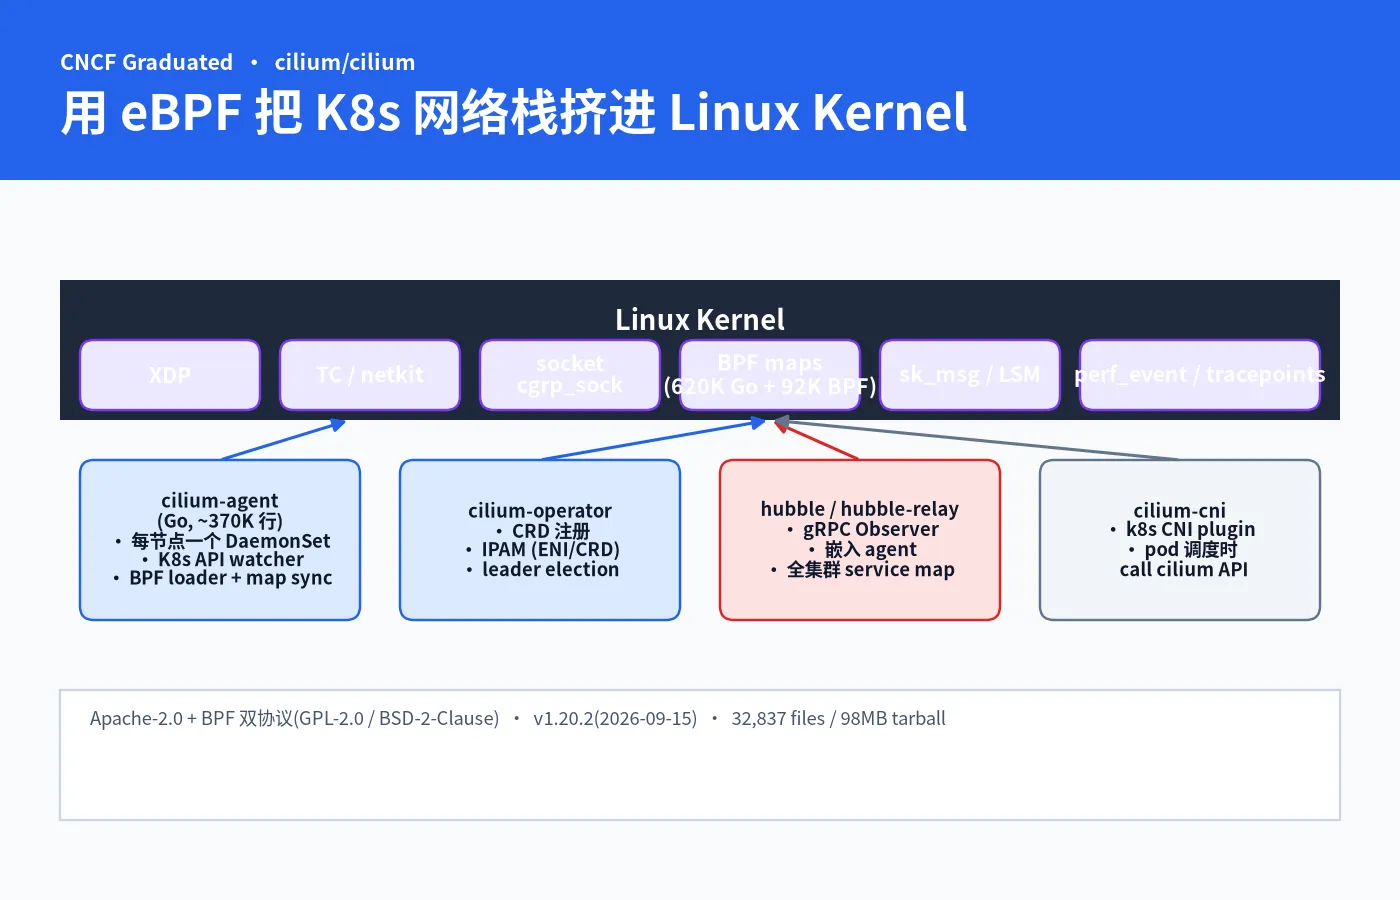
仓库:cilium/cilium ↗ License:Apache-2.0(userspace)+ BPF 代码 GPL-2.0 / BSD-2-Clause 二选一 v1.20.2 · 2026-09-15 · 32,837 files · 98MB tarball · 620K 行 Go + 92K 行 BPF
Cilium 是第一个用 eBPF 把整个 Kubernetes 网络栈挤进 Linux Kernel 的 CNCF Graduated 项目。在它之前,所有 CNI(Flannel、WeaveNet、原始 kube-proxy + iptables)的转发路径都绕”内核 → 用户空间 → 内核”一圈;在它之后,这条路径可以完全留在内核里,应用进程 connect() 一个 Service VIP 时,内核直接在 BPF 程序里改 dst,根本不会出 userland。
但 Cilium 不只是”换种实现”,它是把”网络、负载均衡、安全、可观测性、跨集群”五个传统独立的工具栈,全部融在同一个 eBPF dataplane 上。结果是——这五个子系统之间共享同一份状态(BPFS maps)、同一套 hookpoint(TC/XDP/sock_ops)、同一套部署模型(DaemonSet),没有一个独立的 sidecar。
这篇文章拆掉这个 32K 文件 / 620K 行 Go / 92K 行 BPF 的庞然大物。
一、为什么需要 Cilium#
1.1 传统 K8s 网络栈的三段痛点#
一个 Pod-to-Pod 的 HTTP 请求,在传统 CNI + kube-proxy 下走过这些环节:
Pod A connect → Service VIP
  → kernel netfilter / iptables PREROUTING chain walk
  → DNAT to backend IP
  → conntrack update (lock)
  → route lookup
  → kernel forward
  → XDP/egress TC (host)
  → network
  → remote host: kernel → XDP/ingress TC → conntrack reverse
  → iptables POSTROUTING → DNAT reverse
→ kernel forward → Pod B痛点:
- iptables 规则链是 O(N) — 每条 Service 链上挂一条 DNAT 规则,30K Service 时 iptables 单次 regen 已经几十秒
- conntrack 全局锁 — DNAT 必须查 + 更新 conntrack,内核里这是一把全局 spinlock,流量大的时候是瓶颈
- per-packet 用户空间 audit table — 用户空间程序(kube-proxy)必须周期性 regen 整套规则
1.2 eBPF 把这三条都打掉#
eBPF 的核心卖点不是”快”,是”程序能在内核里以 native 速度跑、不出 kernel space”。Cilium 利用这一点做了三件事:
- 不重写包,改连接:
bpf_sock.c在connect()syscall 时直接改 dst,后面 packet 是 backend IP 直发,无 NAT - 不维护 conntrack:
cilium_conntrackmap 替代,但每个 conntrack entry 是 BPF map 更新,无全局锁 - 不维护 iptables 规则:
cilium_lb4/cilium_lb6是个 hash table,改 backend 是bpf_map_update_elem,O(1)
结果是:Cilium 1.20 在 100K 服务 + 200K Pod 的集群下,Service-to-pod 转发延迟基本贴近同主机转发,iptables 模式早就崩了。
1.3 适用面#
不适用:
- 一定要 iptables 而不是 nftables 的网络审计工具(那些工具读 conntrack,Cilium 的 conntrack 在 BPF map 里)
- 一定要 Sidecar proxy 来实现 L7 策略的(Envoy + Istio 仍然更成熟)
- 必须内核 < 4.19 的(5.10+ 才能稳定用 netkit + 完整 TCX)
适用:
- 大规模 EKS / AKS / GKE 集群(1000+ 节点)
- 多云 / 多集群 + 统一安全策略
- Service Mesh 想消 sidecar(Istio Ambient 已经抄了 Cilium 的零 sidecar 路线)
二、整体架构:5 个组件共享一份 eBPF dataplane#
Cilium 的官方 component 图把整个系统拆成 5 个独立组件 + 1 个共享内核态:
+---------------------------------------------+
|  cilium-agent       cilium-operator        |
|  cilium-cni         hubble / hubble-relay  |
+---------------------------------------------+
              ↕          ↕
       +-----------------------------+
       |      Linux Kernel eBPF      |
       |  XDP / TC / SOCK_OPS / maps |
+-----------------------------+2.1 cilium-agent(每个节点一个)#
370K 行 Go(pkg/),是 cilium 全部逻辑的所在地。一个 agent 干这些事:
- API 监听:K8s API + ClusterMesh API + Cilium 自己 CRD
- 状态计算:从 K8s API 算每个 endpoint 的 identity、policy、IP、security context
- BPF 加载:通过
pkg/datapath/loader/把 bpf_xdp/bpf_host/bpf_lxc/bpf_overlay/bpf_sock 5 个 .o load 到 kernel,attach 到对应 hook - BPF map 同步:用
cilium_apisyscall 把算出来的 endpoint / policy / lb4 写进 BPF map - Hubble 嵌入:Hubble Server 是 agent 里的一个 goroutine,不是独立进程
- 健康 + 指标:
cilium-dbg status/cilium-dbg bpf lb list/ Prometheus
pkg/datapath/loader/ 是 Go 端最关键的目录,12 个 .go 文件 9393 行:base.go(写 config header 文件)、endpoint.go(单 endpoint attach)、tc.go + netkit.go(TC attach)、xdp.go(XDP attach)、template.go(模板渲染)。
2.2 cilium-operator#
干 cluster-wide 的(不每节点干):
- CRD 注册:CiliumIdentity / CiliumNetworkPolicy / CiliumClusterwideEnvoyConfig…
- IPAM:ENI 模式从 AWS 拿 IP,CRD 模式分配 CIDR
- leader election(
lease/lockslib,1.14+):多副本 HA - Gateway API 实现:operator 角色
operator 不在数据转发关键路径。挂了集群大部分流量还是通的,但新 Pod 调度会因为 IPAM 慢下来;Hubble 健康检测会报 kvstore 不健康。
2.3 cilium-cni#
就是 CNI plugin:每节点一份,被 kubelet 在 pod 调度时调用。它不直接干网络,而是调用同节点 cilium-agent 的 REST API(/endpoint),让 agent 准备 endpoint 配置,完成后回报。
daemon/cmd/daemon.go 330 行,是 agent REST API 入口。
2.4 hubble / hubble-relay#
两个东西:
- Hubble Server:
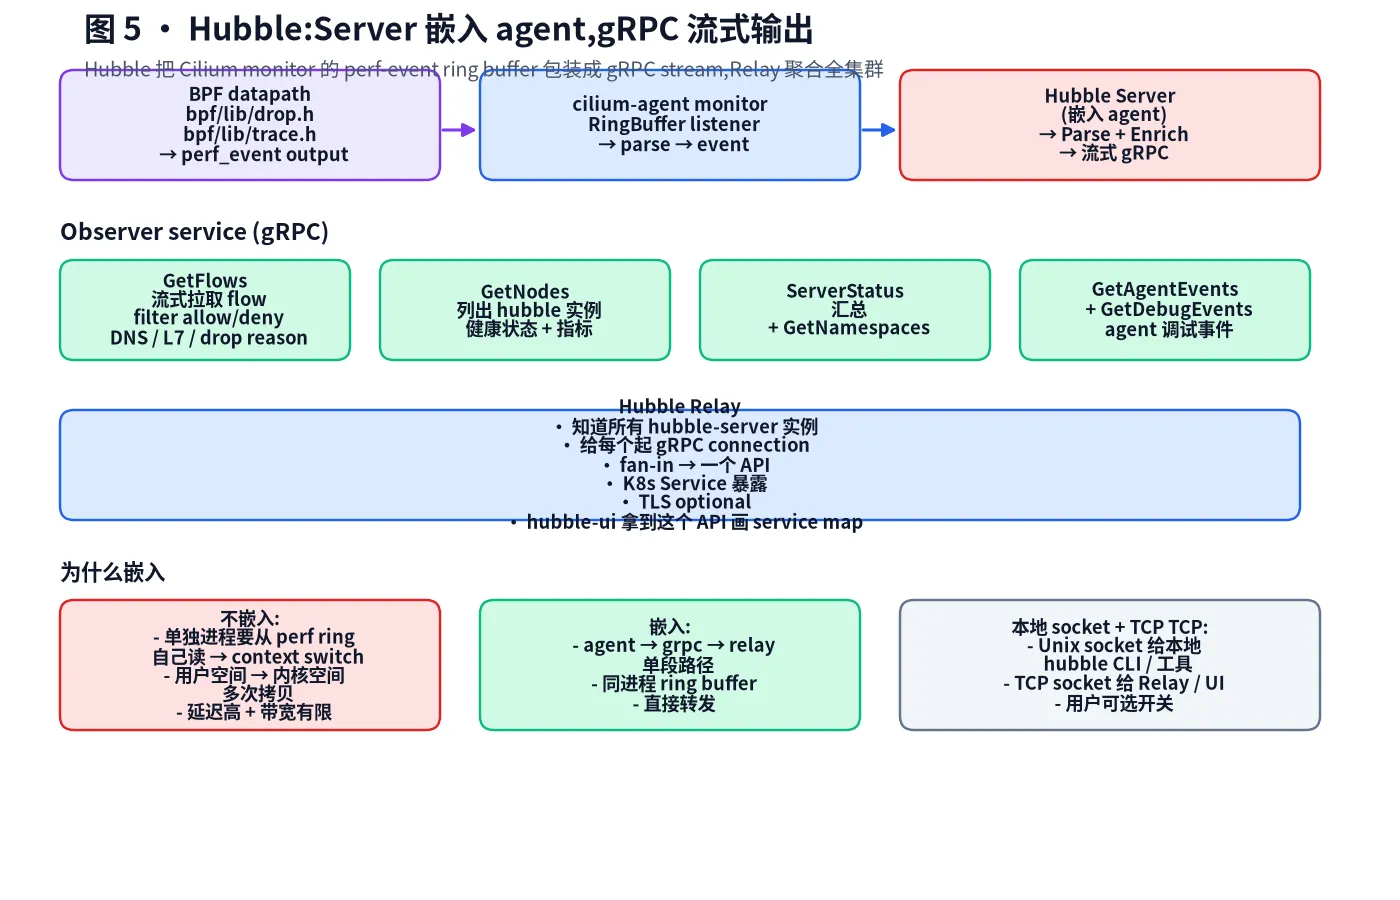
cilium-agent里的一个 goroutine,从 Cilium monitor 的 ring buffer 读 perf-event,解析为 flow payload,挂 gRPC(Observer服务 +Peer服务) - Hubble Relay:独立进程,知道所有 hubble-server,fan-in 成一个 API
gRPC 4 个 RPC:
GetFlows— 流式拉 flowGetNodes— 实例列表 + 健康指标GetNamespaces— 过去一小时内有 flow 的 namespaceServerStatus— 汇总
hubble-ui 拿到 Relay 的 API 画 service map。
2.5 ClusterMesh(operator 角色)#
多集群互联。每个 cluster 跑 cilium-agent,通过一个共享的 kvstore(etcd)交换:
- identity(8-bit cluster-id 编码进 identity)
- service(global services)
- endpoint
不是独立进程,功能分散在 agent + operator 里。
2.6 Linux Kernel eBPF#
共享 dataplane,5 个 program type + ~14 个 BPF map,这是整个 cilium 的事实核心。后面单独拆。
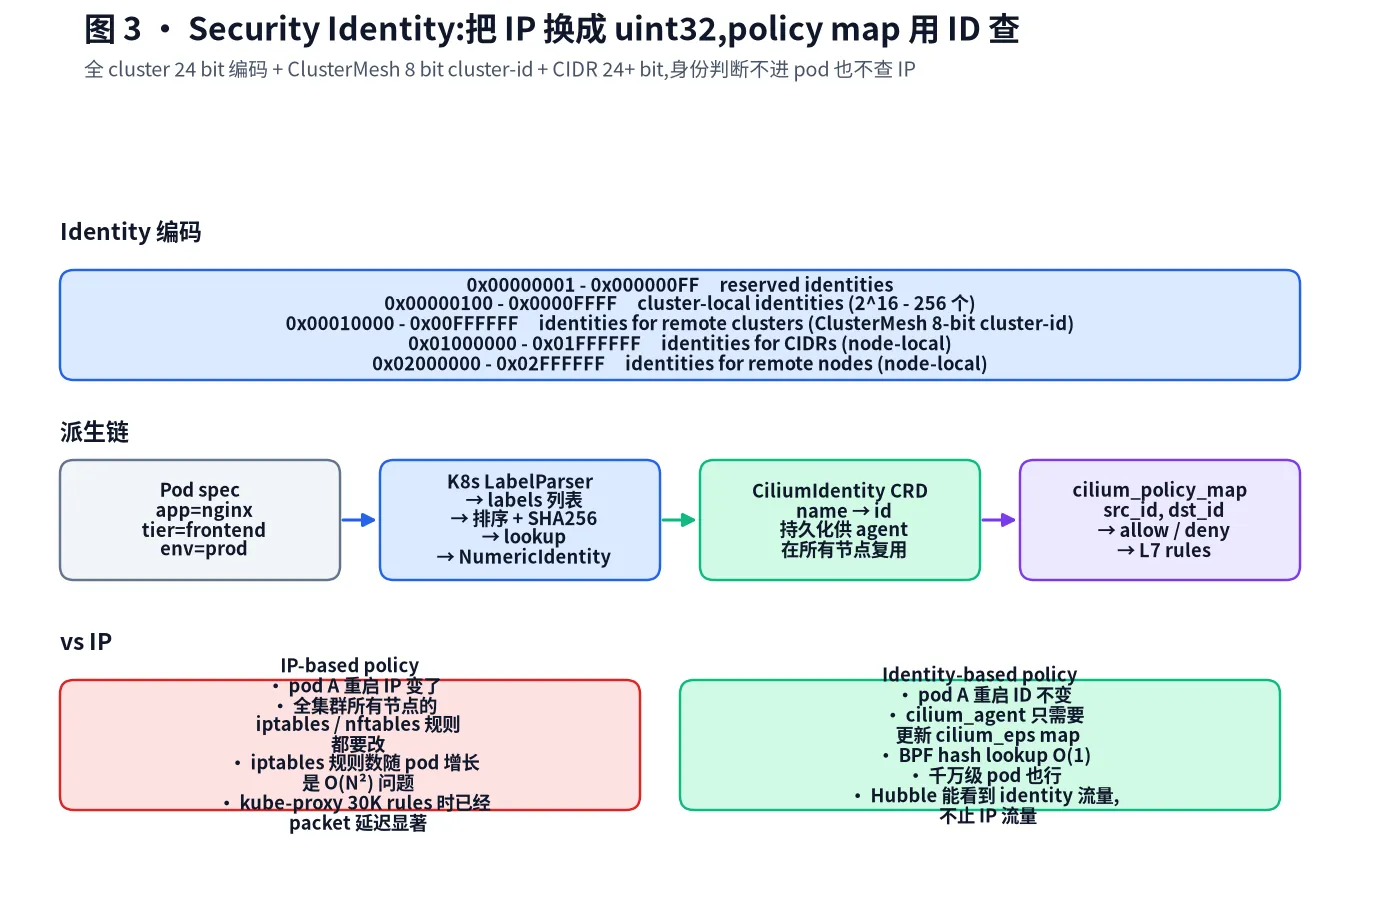
三、Security Identity:把 IP 换成 uint32#
Cilium 文档 Documentation/internals/security-identities.rst 写的:
Security identities are generated from labels. They are stored as
uint32, which means the maximum limit for a security identity is2^32 - 1.
3.1 编码布局#
0x00000001 - 0x000000FF     reserved identities
0x00000100 - 0x0000FFFF     cluster-local identities  (2^16 - 256 个)
0x00010000 - 0x00FFFFFF     identities for remote clusters (ClusterMesh 8-bit cluster-id)
0x01000000 - 0x01FFFFFF     identities for CIDRs (node-local)
0x02000000 - 0x02FFFFFF identities for remote nodes (node-local)identity 0 是特殊值(在 BPF datapath 里表示 “any identity”,wildcard allow)。
CIDR 标识是 node-local 的(同 CIDR 在两个节点可能不同身份),不进 VXLAN/Geneve tunnel metadata(那个字段只有 24 bit),所以 CIDR identity 从 2^24+1 起。
3.2 派生链#
Pod spec
  app=nginx, tier=frontend, env=prod
  ↓ LabelParser
labels list (排序 + hash)
  ↓ Label SHA256 → 查 ipcache
NumericIdentity: uint32
  ↓ 写到 CiliumIdentity CRD
  ↓ Agent 写到 cilium_ipcache + cilium_eps
cilium_policy_map: key=(src_id, dst_id)
  ↓ value
allow/deny + L7 ruleCiliumIdentity CRD 持久化这个映射——同一个 label set 在所有节点都拿到同一个 identity,不用每节点重算 SHA256。
3.3 为什么 identity > IP#
| 维度 | IP-based (iptables / nft) | Identity-based (Cilium) |
|---|---|---|
| Pod 重启 | IP 变 → 全集群所有节点规则都改 | identity 不变 → 仅 endpoint 状态变 |
| 规则规模 | O(N²) 问题,30K services 不可用 | O(N) hash,千万级 pod 稳定 |
| Hubble 可观测性 | 只能看 IP 流量 | 看 identity + labels + DNS + L7 |
| cluster 跨集群 | 每 cluster 各自 identity | 8-bit 编码进 uint32,跨集群无冲突 |
| L7 策略 | iptables 不做 | Cilium Agent + Envoy inline |
Cilium 集群规模到 100K Pod 时,iptables 模式已经崩,identity-based 模式稳定跑。这不是性能优化,是唯一能跑得动的实现。
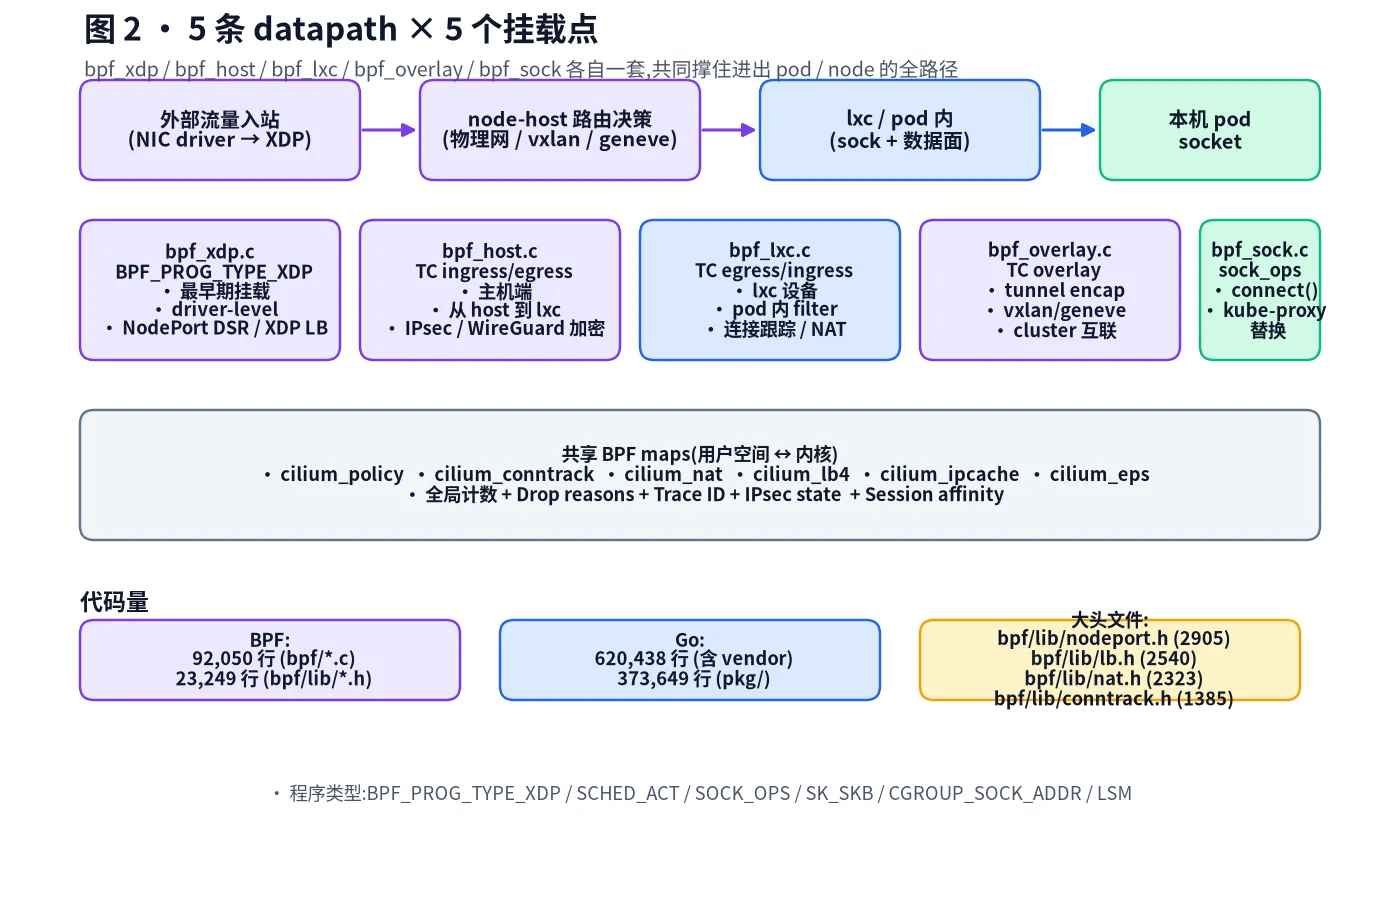
四、5 条 datapath × 5 个挂载点#
bpf/ 目录 92,050 行 C 代码,23,249 行 BPF lib header。Documentation/internals/hooks.rst 列了 program type:
- BPF_PROG_TYPE_XDP
- BPF_PROG_TYPE_SCHED_ACT
- BPF_PROG_TYPE_CGROUP_SOCK_ADDR
- BPF_PROG_TYPE_SOCK_OPS / SK_SKB
- BPF_PROG_TYPE_CGROUP_SKB
- BPF_PROG_TYPE_LSM
- BPF_PROG_TYPE_TRACING4.1 bpf_xdp.c#
最早期的挂载点。NIC driver 收到 frame 后,在分配 skb 之前 hook。能做非常廉价的 LB / drop / DSR。pkg/datapath/loader/xdp.go 459 行负责 attach + detect NIC driver 兼容性(不同厂商 XDP driver mode 行为不同)。
XDP 三种 mode:
native XDP:NIC 驱动支持(mlx5、i40e、ixgbe…)generic XDP:内核里模拟,慢 10-100x,fallbackoffloaded XDP:跑到网卡硬件,某些 SmartNIC 支持
Cilium 的 XDP 模式取决于 NIC。Cilium 5.10+ 还用 netkit(net/sched/netkit.c,kernel 6.7+),这是新一代 tc hook 替代品,能让 BPF 程序跳出 major-number / minor-number 限制,直接挂到 driver 之外的虚拟 device。
4.2 bpf_host.c + bpf_overlay.c#
bpf_host.c 处理 host-level traffic:从物理 NIC 收到包 → 入 host → 转给 lxc/pod;或 lxc/pod 出包 → 从 host 出去。两个方向都用 TC ingress/egress。
bpf_overlay.c 是 bpf_host.c 的 overlay 版本:走 VXLAN/Geneve 隧道时把 encap/decap 写在 TC hook 里。
bpf/lib/encap.h 负责 encap,bpf/lib/clustermesh.h 负责 clustermesh header 编码(8-bit cluster-id)。
这两个加起来 ~12K 行,跟 IPsec / WireGuard 加密交叉,所以也包含 bpf/lib/encrypt.h + bpf/lib/wireguard.h(171 行)。
4.3 bpf_lxc.c#
挂在每个 pod 的 lxc 设备上。负责:
- 入向 policy check(根据 src_identity + dst_port 查 cilium_policy_map)
- 连接跟踪(
cilium_conntrackmap) - LB (Bandwidth) limit(
cilium_sock里的 socket-level 限速,而不是 XDP 限速) - Sockmap redirect(load balance 优化路径)
bpf/lib/lb.h 2540 行是核心 LB header,整个 cilium 最复杂的逻辑在这里——Maglev consistent hashing / DSR / session affinity / DNS-based LB / externalTrafficPolicy 全在这。
4.4 bpf_sock.c + bpf_sock_term.c#
kube-proxy 替换的核心。bpf_sock.c 头一句注释:
sock_ops:在connect()syscall 里直接改 dst IP。 应用进程拿到的 IP 已经是 backend IP。
cgroup_sock_addr program type 挂在 cgroup 上,所有进程 connect() 都会过这个 BPF 程序(配合 cgroup-aware)。程序做的事:
// bpf/lib/lb4.h 中的核心逻辑,大致:
key = (src_ip, src_port, dst_ip=vip, dst_port, family)
value = cilium_lb4[key]  // hash table
if (value && value->flags & SERVICE_FLAG_NAT) {
    sk->dst_ip = value->backend[select(value)].ip;
    sk->dst_port = value->backend[...].port;
    // 后续无 NAT
}这样整个数据包生命周期里没有 NAT——connect() 返回的 IP 已经是 backend IP,数据包从 pod 出去直接发到 backend,不绕 conntrack / netfilter。
bpf_sock_term.c 是 bpf_sock.c 的 egress version,负责在 connect 之后 packet 出去时做相应的 socket-level operations。
4.5 bpf_wireguard.c#
WireGuard encryption 走 socket-level,不是 BPF。这只是 wg device 的 tc hook,做许可策略。
4.6 BPF lib(共 23K 行)#
大头文件按行数排:
| 文件 | 行数 | 干什么 |
|---|---|---|
bpf/lib/nodeport.h | 2905 | NodePort / LoadBalancer / externalTrafficPolicy |
bpf/lib/lb.h | 2540 | LB 核心算法 / Maglev / session affinity |
bpf/lib/nat.h | 2323 | SNAT / DNAT(节点级,与 conntrack 联动) |
bpf/lib/conntrack.h | 1385 | 连接跟踪 + tcp state |
bpf/lib/nodeport_egress.h | 750 | NodePort egress 路径 |
bpf/lib/icmp6.h | 695 | ICMPv6 处理 |
bpf/lib/host_firewall.h | 636 | host firewall BPF 化 |
bpf/lib/egress_gateway.h | 612 | Egress Gateway 策略 |
bpf/lib/policy.h | 513 | Policy map 查找 / 缓存 |
bpf/lib/trace.h | 349 | Hubble tracing events |
bpf/lib/wireguard.h | 171 | WireGuard keymap |
bpf/lib/auth.h | 134 | Mutual Authentication (mTLS) |
bpf/lib/clustermesh.h | ? | ClusterMesh 头编码 |
lb.h 2540 行不是手写魔数 —— 是 Big Tech 多年做 production-grade service mesh 的工程结晶:Maglev hashing / consistent backend selection / sticky / external traffic policy / DSR / session affinity / SourceIP 选择策略 全在这。
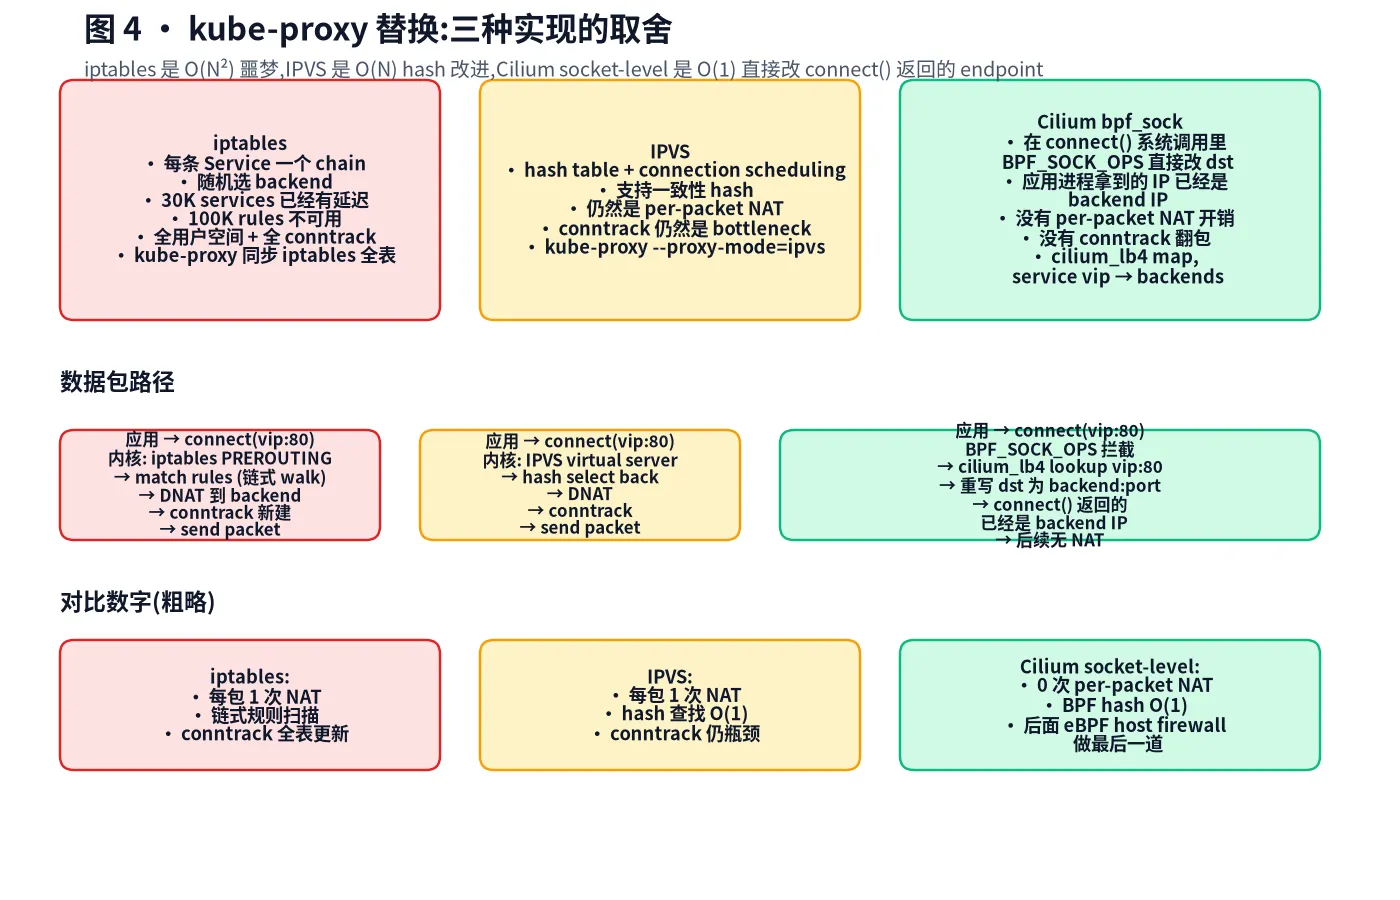
五、kube-proxy 替换:socket-level connect() 重写#
5.1 三种实现的本质差异#
| 实现 | 拦截位置 | 改写时机 | 后续 NAT | conntrack |
|---|---|---|---|---|
| iptables | netfilter PREROUTING | 每包 | 是 | 全局锁 |
| IPVS | IPVS virtual server | 每包 | 是 | 仍瓶颈 |
| Cilium sock_ops | connect() 系统调用 | 仅一次 | 否 | 进 BPF map(无锁) |
Cilium 走第三条路 —— bpf_sock.c 的 sock_ops 程序挂在 cgroup connect_4(IPv4) 和 connect_6(IPv6),任何进程发 connect() 都会跑一遍这个 BPF 函数。
5.2 LB map 数据结构#
cilium_lb4 是 hash table:
key = {
    .address   = Service VIP,
    .dport     = Service port,
    .family    = AF_INET,
    .protocol  = TCP/UDP,
    .scope     = SCOPE_FORWARD | SCOPE_REVERSE | SCOPE_BIDIR,
}
value = {
    .count     = backend 数,
    .backend[i] = { .address, .port, .flags },
    .rev_nat_index,
    .flags     = SERVICE_FLAG_NAT | SERVICE_FLAG_AFFINITY | ...,
}select(bindir) 是 backend 选择(weight / round-robin / random / Maglev / sticky),不同 backend 选择策略决定 flags。
5.3 connect() 重写流程#
// bpf_sock.c 中的伪代码逻辑,简化版
static __always_inline void sock4_update_policy(struct bpf_sock_ops *skops) {
    const __be32 dst_ip = skops->remote_ip4;
    const __be32 dst_port = skops->remote_port;

    // 1. 检查 destination 是不是 service VIP
    struct lb4_service *svc = lb4_lookup_service(skb, dst_ip, dst_port);
    if (!svc) return;

    // 2. 选 backend
    backend = select_backend(svc, skops);

    // 3. 改写 socket 状态
    skops->remote_ip4  = backend->address;
    skops->remote_port = backend->port;

    // 4. 没 NAT 没 conntrack
}注释里写得很直白:
Hack due to missing narrow ctx access. // 用 volatile 强转 8-bit 字段
这是 BPF verifier 5.10 时代的限制——窄访问要靠 volatile cast,版本新的话修。
5.4 NodePort DSR#
NodePort 是另一条更难的路径,因为源 IP 可能是外部 client(不是 pod)。Cilium 默认是 SNAT 模式,把 client IP 换成 node IP 进 cluster;DSR(Direct Server Return)模式是后端 server 直接回 client,源 IP 不变。
bpf/lib/nodeport.h 2905 行大部分是 DSR 的实现细节:encap IP option / route lookup 反向 / 收包时按 IP option 识别 client IP。
5.5 全套被 XDP / TC / sock_ops 三层覆盖#
单一节点 service-to-prod 流量不一定都走 sock_ops:有些是 NodePort(走 TC ingress),有些是 externalTrafficPolicy(走 XDP),有些是 host firewall(走 TC)。三层覆盖保证任何流量都有 5 个 datapath 程序可选。
六、Hubble:Server 嵌在 agent 里的可观测性#
Documentation/internals/hubble.rst 写得很清楚:
Hubble’s server component is embedded into the Cilium agent in order to achieve high performance with low-overhead.
6.1 数据来源#
bpf/lib/drop.h   → send_drop_notify(ctx, reason)
bpf/lib/trace.h  → send_trace_notify(ctx, obs_point)
  ↓
perf_event ring buffer (kernel)
  ↓
cilium-agent monitor subscriber
  ↓ (ring buffer parser, not syscall)
Hubble Server goroutine
  ↓
gRPC Observer.GetFlows(stream)
  ↓
  - Unix socket → local hubble CLI
- TCP socket → Hubble Relay / UI关键点:Hubble Server 不是独立进程,是 cilium-agent 进程里的一个 goroutine。pkg/hubble/server/ 实现。它从 cilium monitor subsystem(也是 agent 内部)的 ring buffer 拉 perf events,不走 syscall,纯内存拷贝。
6.2 四个 RPC#
GetFlows— 流式 flow events,allow/deny filter,DNS / L7 / drop reason / verdict 都查GetNodes— hubble 实例列表 + 健康GetNamespaces— 过去一小时有 flow 的 namespaceServerStatus— 集群级汇总
GetAgentEvents 和 GetDebugEvents 是 GetFlows 的简化版,无 filter。
6.3 Hubble Relay 独立#
Hubble Relay 是独立进程(hubble-relay),它做的事就是 fan-in:
Relay
  ├─ connect to hubble-server-1 (gRPC)
  ├─ connect to hubble-server-2 (gRPC)
  ├─ ...
  └─ connect to hubble-server-N (gRPC)
       ↓
    fan-in → 一个 API
       ↓
    K8s Service (hubble-relay.kube-system.svc:80)
       ↓
hubble-ui / hubble CLIRelay 知道所有 hubble-server,因为它 watch K8s API 上的 CiliumNode 资源,每个节点跑 agent 时会有 CiliumNode。Relay 用 CiliumNode 上的 Hubble endpoint 字段去 dial。
6.4 嵌入的设计取舍#
不嵌入(早期架构):
- 单独 hubble-server 进程,scallthrough 一个 perf ring buffer → 4G,4 次拷贝
- 用户空间 → 内核空间 + 用户空间 → 用户空间
- 延迟高,带宽限制
嵌入:
- agent 进程 → gRPC → Relay
- 同进程 ring buffer listener
- 直接转发,无 syscall
代价:Hubble 跟 agent 一起崩,如果 agent 重启 RingBuffer 状态丢失。Hubble 文档里说 relay 会自动重新订阅,所以这点不重要。
七、BPF Map 数据模型:14 张共享表#
Cilium 最有意思的设计是:所有的状态共享一组 BPF map,不是按功能分多个独立 map。
7.1 中心:BPF map 是共享内存数据库#
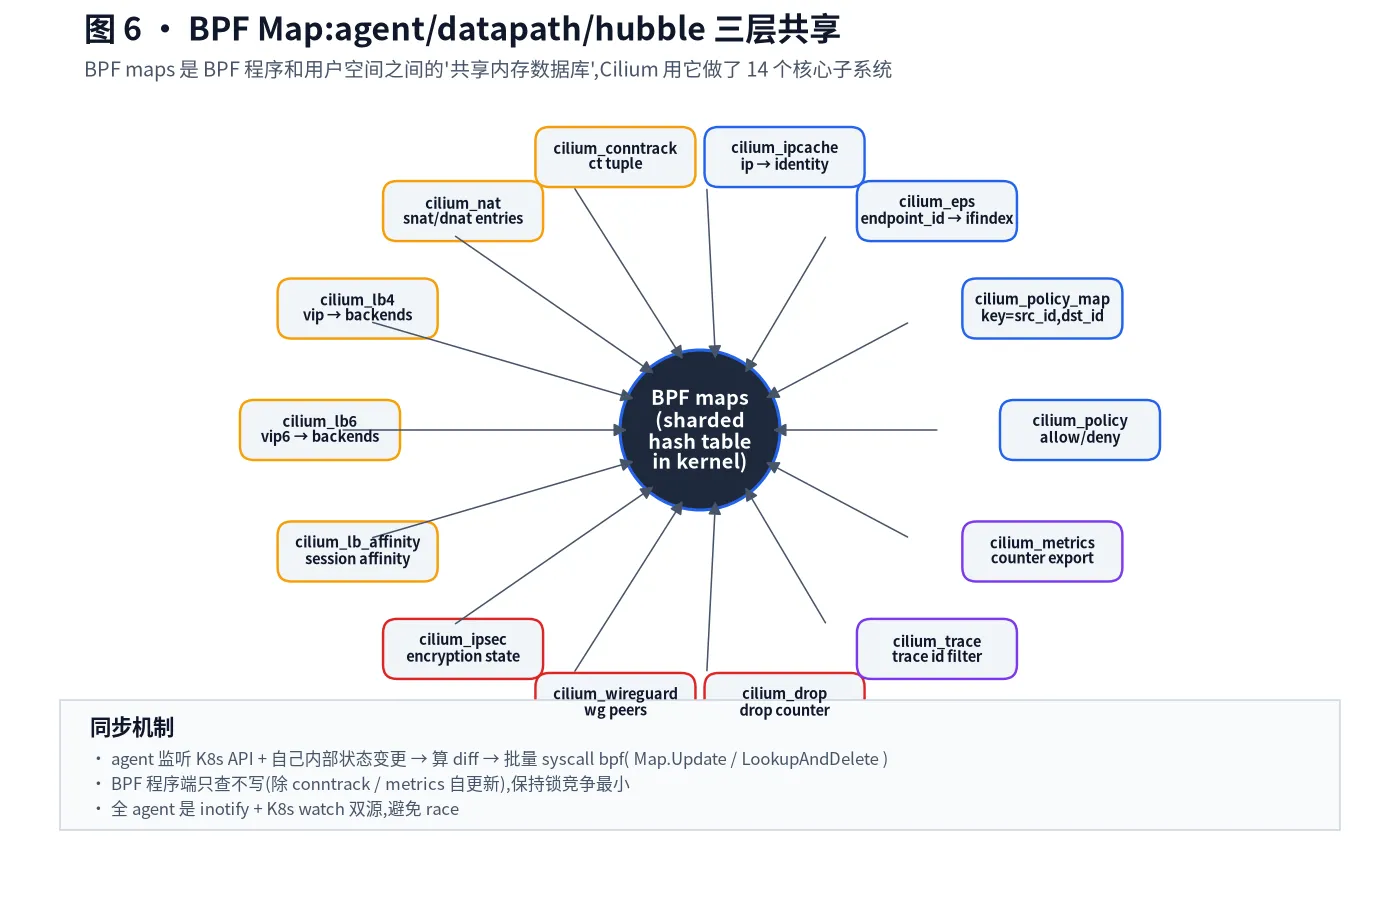
BPF map 在内核里是 typed shared memory,both BPF program 和 user space 都能 read/write。是 eBPF 的”事实数据库”。Cilium 用它做了 14 个核心子系统:
中心:BPF maps (sharded hash table in kernel)

├─ Policy
│  ├─ cilium_policy         (allow/deny per identity pair)
│  ├─ cilium_policy_map     (key = (src_id, dst_id))
│  └─ cilium_ep_config      (per-endpoint config)
├─ Endpoint
│  ├─ cilium_eps            (endpoint_id → ifindex)
│  └─ cilium_ipcache        (ip → identity)
├─ Conntrack + NAT
│  ├─ cilium_conntrack      (ct tuple → ct state)
│  ├─ cilium_nat            (snat/dnat entries)
│  └─ cilium_ct4_global     (v4 conntrack)
├─ LB
│  ├─ cilium_lb4            (vip → backends)
│  ├─ cilium_lb6            (vip6 → backends)
│  ├─ cilium_lb_affinity    (session affinity)
│  └─ cilium_lb4_reverse    (backend → vip)
├─ Security
│  ├─ cilium_ipsec          (IPsec state)
│  └─ cilium_wireguard      (wg peers)
└─ Observability
   ├─ cilium_drop           (drop counter)
   ├─ cilium_trace          (trace id filter)
└─ cilium_metrics (counter export)7.2 同步机制#
cilium-agent 这边的循环大致是:
1. inotify K8s API + cilium-agent internal events
3. 算 diff(每个 map 类型一个 reconciler)
4. 批量 syscall bpf_map_update_elem / bpf_map_lookup_and_deleteBPF 程序端一般只查不写(除 conntrack / metrics 自己更新)。lock contention 最小化。
7.3 sharded hash table#
cilium_lb4 这类大 map 用 sharded hash table —— 内核 BPF map 容量有限(LPM TRIE 是 16M entries,LRU_HASH 也是 16M,但 per-CPU hash 性能更好),所以 cilium-agent 启动时把 vip 按 hash 分片到 N 个子 map,BPF 程序端只查自己分到的子 map。
这就是为什么 cilium_agent 可以查 dp14 个 BPF map,几百 G 内存不嫌大。
八、ClusterMesh 与 Gateway API:跨集群与 L7#
8.1 ClusterMesh#
跨多集群,把多个 K8s cluster 合并成一个”logical cluster”。
Identity 8-bit cluster-id 编码(在 Documentation/internals/security-identities.rst):
0x00FF0000 位置放 cluster-id(8 bit)
0x00000001-0x0000FFFF 是 cluster-local
0x00010000-0x00FFFFFF 是跨集群(再加 cluster-id)每个集群 agent watch 一个共享 kvstore(etcd)获取其他集群的:
- identity(CiliumIdentity CRD)
- service(global services)
- endpoint(cilium endpoints)
实现细节散在 pkg/clustermesh/ 和 pkg/ipcache/。ClusterMesh 不需要 Operator 角色,Operator 只在某些模式负责 IPAM。
8.2 Gateway API#
Kubernetes SIG-Network Gateway API 是 K8s 1.22+ 的下一代 ingress / service mesh / east-west LB 标准 API。Cilium 1.13+ 提供了完整的 Gateway API 实现:
GatewayClass/Gateway/HTTPRoute/TCPRoute等 CRD- 由 cilium-operator 处理
- data plane 走 cilium-proxy (Envoy) + Cilium eBPF
Cilium 1.20 是 Gateway API conformance v1.6 的官方实现方(README 徽章里写的)。
8.3 Service Mesh#
Cilium 的 Service Mesh 是 “no sidecar” 路线 —— 不需要每 pod 一个 Envoy sidecar。理由:
- L4 转发(Cilium Agent + eBPF)直接由 BPF datapath 搞定
- L7 策略(HTTP / gRPC / TLS)在 cilium-proxy(per-node Envoy)里跑
- mTLS 走 IPsec / WireGuard
这条路线和 Istio Ambient 几乎一致 —— Ambient 也是”per-node zt4 + cilium-proxy 形态”。
九、复盘:值得抄的 5 个设计#
写完 8 节,提炼 5 条真正值得抄到自己项目的设计:
9.1 identity > IP:把识别模型和寻址模型解耦#
Cilium 不把 security 和 IP 绑定:identity 是从 label 派生的 uint32,IP 只是 identity 的”网络可达途径”。后果是 Pod 重启、IP 变化、cluster 切换都不会影响 security 决策。
9.2 BPF map 作为通用共享状态层#
14 个子系统不再各自就事 —— 全部通过 BPF map 共享状态。这是 eBPF 系统设计的精髓:用内核态共享内存做 IPC,比 RPC / message queue 都快。后续项目如果要做”高性能内核态共享状态”,BPF map 是首选。
9.3 sock_ops 做 LB:拦截在 syscall 层,不是在 netfilter 层#
传统 LB 在 netfilter hook 改包,sock_ops 在 connect() 直接改 socket 状态。一次性拦截,后续无 NAT、无 conntrack。
9.4 Hubble 嵌入而非独立#
可观测性子系统嵌在主进程内,不走独立 RPC/独立 perf ringbuffer 读取。代价是挂了一起挂,但收益是延迟低、带宽大、不需要 broker。
9.5 BPF 程序 + 用户空间同步机制#
agent 端 K8s watch + inotify → 算 diff → 批量 syscall 写 BPF map。BPF 程序端只查不写,保持无锁。
一些统计#
- 仓库大小:98MB tarball / 32,837 files
- Go 代码:620,438 行(含 vendor),373,649 行(pkg/)
- BPF 代码:92,050 行(C)+ 23,249 行(BPF lib header)
- 5 条 datapath:
bpf_xdp.c/bpf_host.c/bpf_lxc.c/bpf_overlay.c/bpf_sock.c - 14 个核心 BPF maps
- BPF program types:XDP / SCHED_ACT / SOCK_OPS / SK_SKB / CGROUP_SOCK_ADDR / CGROUP_SKB / LSM / TRACING
- 5 大组件:
cilium-agent/cilium-operator/cilium-cni/hubble(+ hubble-relay) / ClusterMesh - License:Apache-2.0(userspace)+ GPL-2.0 / BSD-2-Clause(BPF)
- v1.20.2(2026-09-15),main 分支 daily build
- 大客户(USERS.md 前 10):Adobe / AWS / Back Market / ClickHouse / Datadog / Google / Microsoft / Shopify 等
参考#
- cilium/cilium 仓库 ↗
Documentation/overview/component-overview.rst↗Documentation/internals/security-identities.rst↗Documentation/internals/hubble.rst↗Documentation/internals/cilium_operator.rst↗Documentation/internals/hooks.rst↗bpf/lib/lb.h↗(2540 行)bpf/lib/nodeport.h↗(2905 行)bpf/bpf_sock.c↗pkg/datapath/loader/↗- eBPF.io 文档 ↗
- CNCF Cilium 项目页 ↗
- Isovalent(原始公司,被思科收购) ↗