深入解析 ComfyUI:33 万行 Python 怎么搭出一张节点图编程引擎
💬 评论comfyanonymous/ComfyUI 主仓 33 万行 Python。NODE_CLASS_MAPPINGS 全局注册表、DynamicPrompt 子图注入、DAG 输入签名缓存、ModelPatcher 零拷贝副本 + 软释放、多版本 API 同图共存。
ComfyUI: 33 万行 Python 撑起一张节点图,这件事到底怎么做到的#
仓库 comfyanonymous/ComfyUI ↗,开源 Stable Diffusion 推理引擎,主分支 1001 个
.py文件,共 336708 行。我自己也是个经常拖节点玩 ComfyUI 的人,但一直很好奇,前端那个”画节点 + 拉线”的画布,到了后端到底被翻译成了什么。下面这些是我把代码翻完后,觉得最值得聊的 6 个工程点。
0. 先看数字#
仓库(我下载时是 master,约 50MB 解压后)的关键体量:
| 文件 / 目录 | 行数 | 作用 |
|---|---|---|
nodes.py | 2630 | 全部内置节点的类 + NODE_CLASS_MAPPINGS 注册表 |
execution.py | 1465 | 调度核心:拓扑序 + 状态机 + 缓存 |
server.py | 1768 | HTTP/WS 接口,前端就调这里 |
comfy/ | 125669 | 推理内核:UNet / sampler / VAE / lora 等等 |
comfy_execution/ | 约 8000 | DAG / 缓存 / 验证 / 进度回调 |
comfy_api/ | 约 7600 | 多版本节点 API 注册表 + v3 Schema |
comfy_extras/ + comfy_api_nodes/ | 30+ 万 | 各类内置 + 第三方(Anthropic / Gemini / Meshy / Tripo…) |
| 合计 | 336708 |
如果只看”主体”(comfy/, comfy_execution/, comfy_api/, execution.py, nodes.py, server.py)—— 大约 17 万行,这就是”一台节点图推理引擎”本身的体量。剩下的 16 万是无数细分模型适配(ControlNet / LoRA / IP-Adapter / 视频 / 3D / 各家云 API 的 wrapper)。
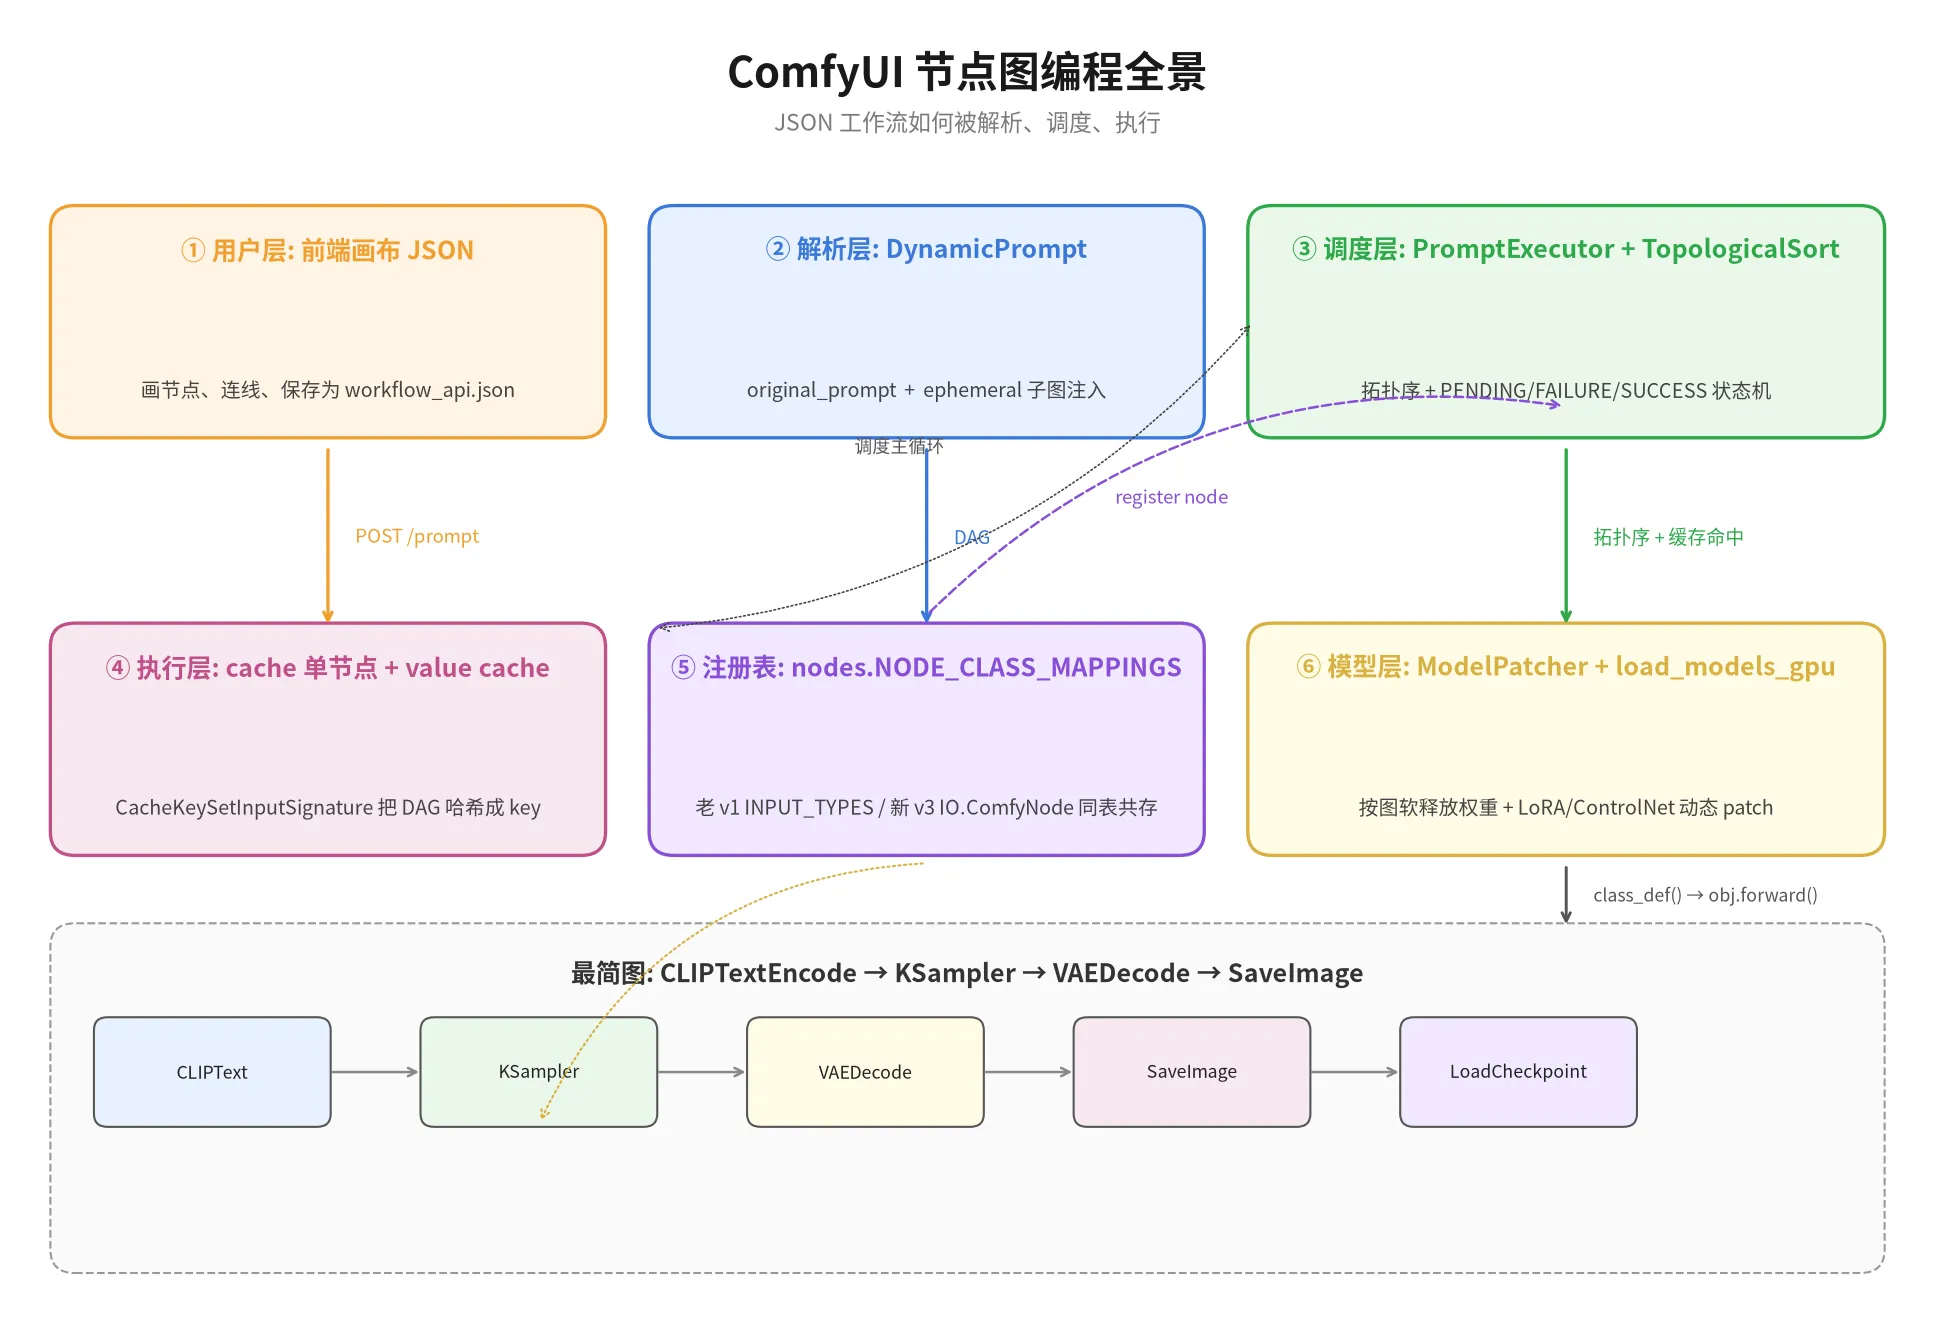
让我先放一张全景图,后面再一行行抠机制。
1. 节点是个 dict: NODE_CLASS_MAPPINGS 是怎么把所有节点串起来的#
整个 ComfyUI 最让我惊讶的设计是:节点不是一个继承体系,而是一个全局 dict。
nodes.py 末尾那张表(简化):
NODE_CLASS_MAPPINGS = {
    "KSampler":           KSampler,
    "KSamplerAdvanced":   KSamplerAdvanced,
    "CLIPTextEncode":     CLIPTextEncode,
    "LoraLoader":         LoraLoader,
    "VAELoader":          VAELoader,
    "SaveImage":          SaveImage,
    "LoadImage":          LoadImage,
    "ConditioningCombine": ConditioningCombine,
    ...
}每个节点类只声明三件事(老 v1 写法):
class KSampler(ComfyNodeABC):
    @classmethod
    def INPUT_TYPES(s):
        return {"required": {
            "model":    ("MODEL", {"tooltip": "..."}),
            "seed":     ("INT", {"default": 0, ...}),
            "steps":    ("INT", {"default": 20, ...}),
            "cfg":      ("FLOAT", {"default": 8.0, ...}),
            "sampler_name": (comfy.samplers.KSampler.SAMPLERS, ...),
            "scheduler":   (comfy.samplers.KSampler.SCHEDULERS, ...),
            "positive": ("CONDITIONING", ...),
            "negative": ("CONDITIONING", ...),
            "latent_image": ("LATENT", ...),
        }}
    RETURN_TYPES = ("LATENT",)
    FUNCTION = "sample"
    def sample(self, model, seed, steps, cfg, ...):
...FUNCTION = "sample" 是个字符串,调度器靠它反射出真正的方法。INPUT_TYPES 返回的是 dict,前端拿到这张表就能画表单(下拉、slider、tooltip 全部来自这里)。
为什么是 dict 而不是 class hierarchy?—— 我后来想明白了,这是让用户扩展最小摩擦的设计:
- 第三方插件(就是大家装的那些
ComfyUI-Manager里的 1M+ extension)只需要在模块里写一个NODE_CLASS_MAPPINGS = {...},然后把自己的文件夹塞到custom_nodes/下面 nodes.py里init_external_custom_nodes()自动import_module然后for name, cls in module.NODE_CLASS_MAPPINGS.items(): NODE_CLASS_MAPPINGS[name] = cls- 不需要继承、不需要注册装饰器、不需要写配置文件
整个项目的安装体验跟 npm 装 plugin 一样自然,关键就在这一步”全部节点就是一个 dict”。
2. DynamicPrompt: 用户拖的图 + 节点运行期间塞进来的图#
前端的”工作流”长这样(default_workflow.json 一例):
{
  "1": {"class_type": "CLIPTextEncode",
        "inputs": {"text": "a cat", "clip": ["5", 0]}},
  "2": {"class_type": "KSampler",
        "inputs": {"model": ["4", 0], "seed": 42, ...}},
  "3": {"class_type": "VAEDecode",
        "inputs": {"samples": ["2", 0], "vae": ["4", 2]}}
}["5", 0] 是边:5 号节点的第 0 个输出。
但 ComfyUI 比这复杂 —— 一个节点在运行时可以往图里塞新节点。comfy_execution/graph.py 里 DynamicPrompt:
class DynamicPrompt:
    def __init__(self, original_prompt):
        self.original_prompt  = original_prompt
        self.node_overrides   = {}   # 运行时替换原节点
        self.ephemeral_prompt = {}   # 执行期塞进来的子图
self.ephemeral_parents = {} # 父节点追踪配合 execution.execute() 里的这段:
if has_subgraph:
    for node_id, node_info in new_graph.items():
        dynprompt.add_ephemeral_node(node_id, node_info, unique_id, display_id)
        # 判断是否是 OUTPUT_NODE
        if getattr(class_def, 'OUTPUT_NODE', False):
            new_output_ids.append(node_id)
    ...
    pending_subgraph_results[unique_id] = cached_outputs
return (ExecutionResult.PENDING, None, None)这段在干什么?—— 一些高级节点(for-each、迭代器、KSampler (Advanced) 的 img2img 在 mask 变化时需要动态展开)会在 execute 期间生成新的子节点,这些新节点又会被纳入调度。
这种”图里塞图”的设计在普通 DAG 引擎里很罕见(一般 DAG 都是静态的),ComfyUI 把图当成了”动态拼接栈”,扩展性极强 —— 社区现在 1M+ 的 extension 里有相当一部分就是靠这个机制工作的。
3. DAG 缓存: 输入签名递归包含所有祖先#
调度过的节点,ComfyUI 会算一个 cache key 把它”结果”存下来 —— 下次同样的输入再来,直接拿缓存,不重跑。
comfy_execution/caching.py 里的 CacheKeySetInputSignature:
async def get_node_signature(self, dynprompt, node_id):
    signature = []
    ancestors, order_mapping = self.get_ordered_ancestry(dynprompt, node_id)
    signature.append(await self.get_immediate_node_signature(dynprompt, node_id, ...))
    for ancestor_id in ancestors:
        signature.append(await self.get_immediate_node_signature(dynprompt, ancestor_id, ...))
return to_hashable(signature)注意:递归地把所有祖先的输入签名也包含进来。to_hashable 把整个签名序列化成 frozenset / Unhashable(NaN),保证 hashable。
为什么这么做?—— 因为同一条 prompt 里”上游 VAEDecode 的输出变了”,KSampler 的结果肯定也会变,缓存如果不包含上游,就可能给错结果。
更妙的是 IS_CHANGED:节点类可以声明 IS_CHANGED(s, **inputs) -> hash,调度器会先问”你的输入有没有变”。LoadImage 节点的实现非常典型:
class LoadImage:
    @classmethod
    def IS_CHANGED(s, image):
        image_path = folder_paths.get_annotated_filepath(image)
        m = hashlib.sha256()
        with open(image_path, 'rb') as f:
            m.update(f.read())
return m.digest().hex()也就是说:同一张图换了文件、文件内容变了 → IS_CHANGED 返回值变了 → 缓存失效,重跑。这个机制让”加载同一张图”也走得通重算,而不是无脑命中缓存。
4. ModelPatcher: 一份权重,你可以有 N 个”快照”#
下面是我觉得最值的工程点 —— 整个 ComfyUI 显存管理的核心:
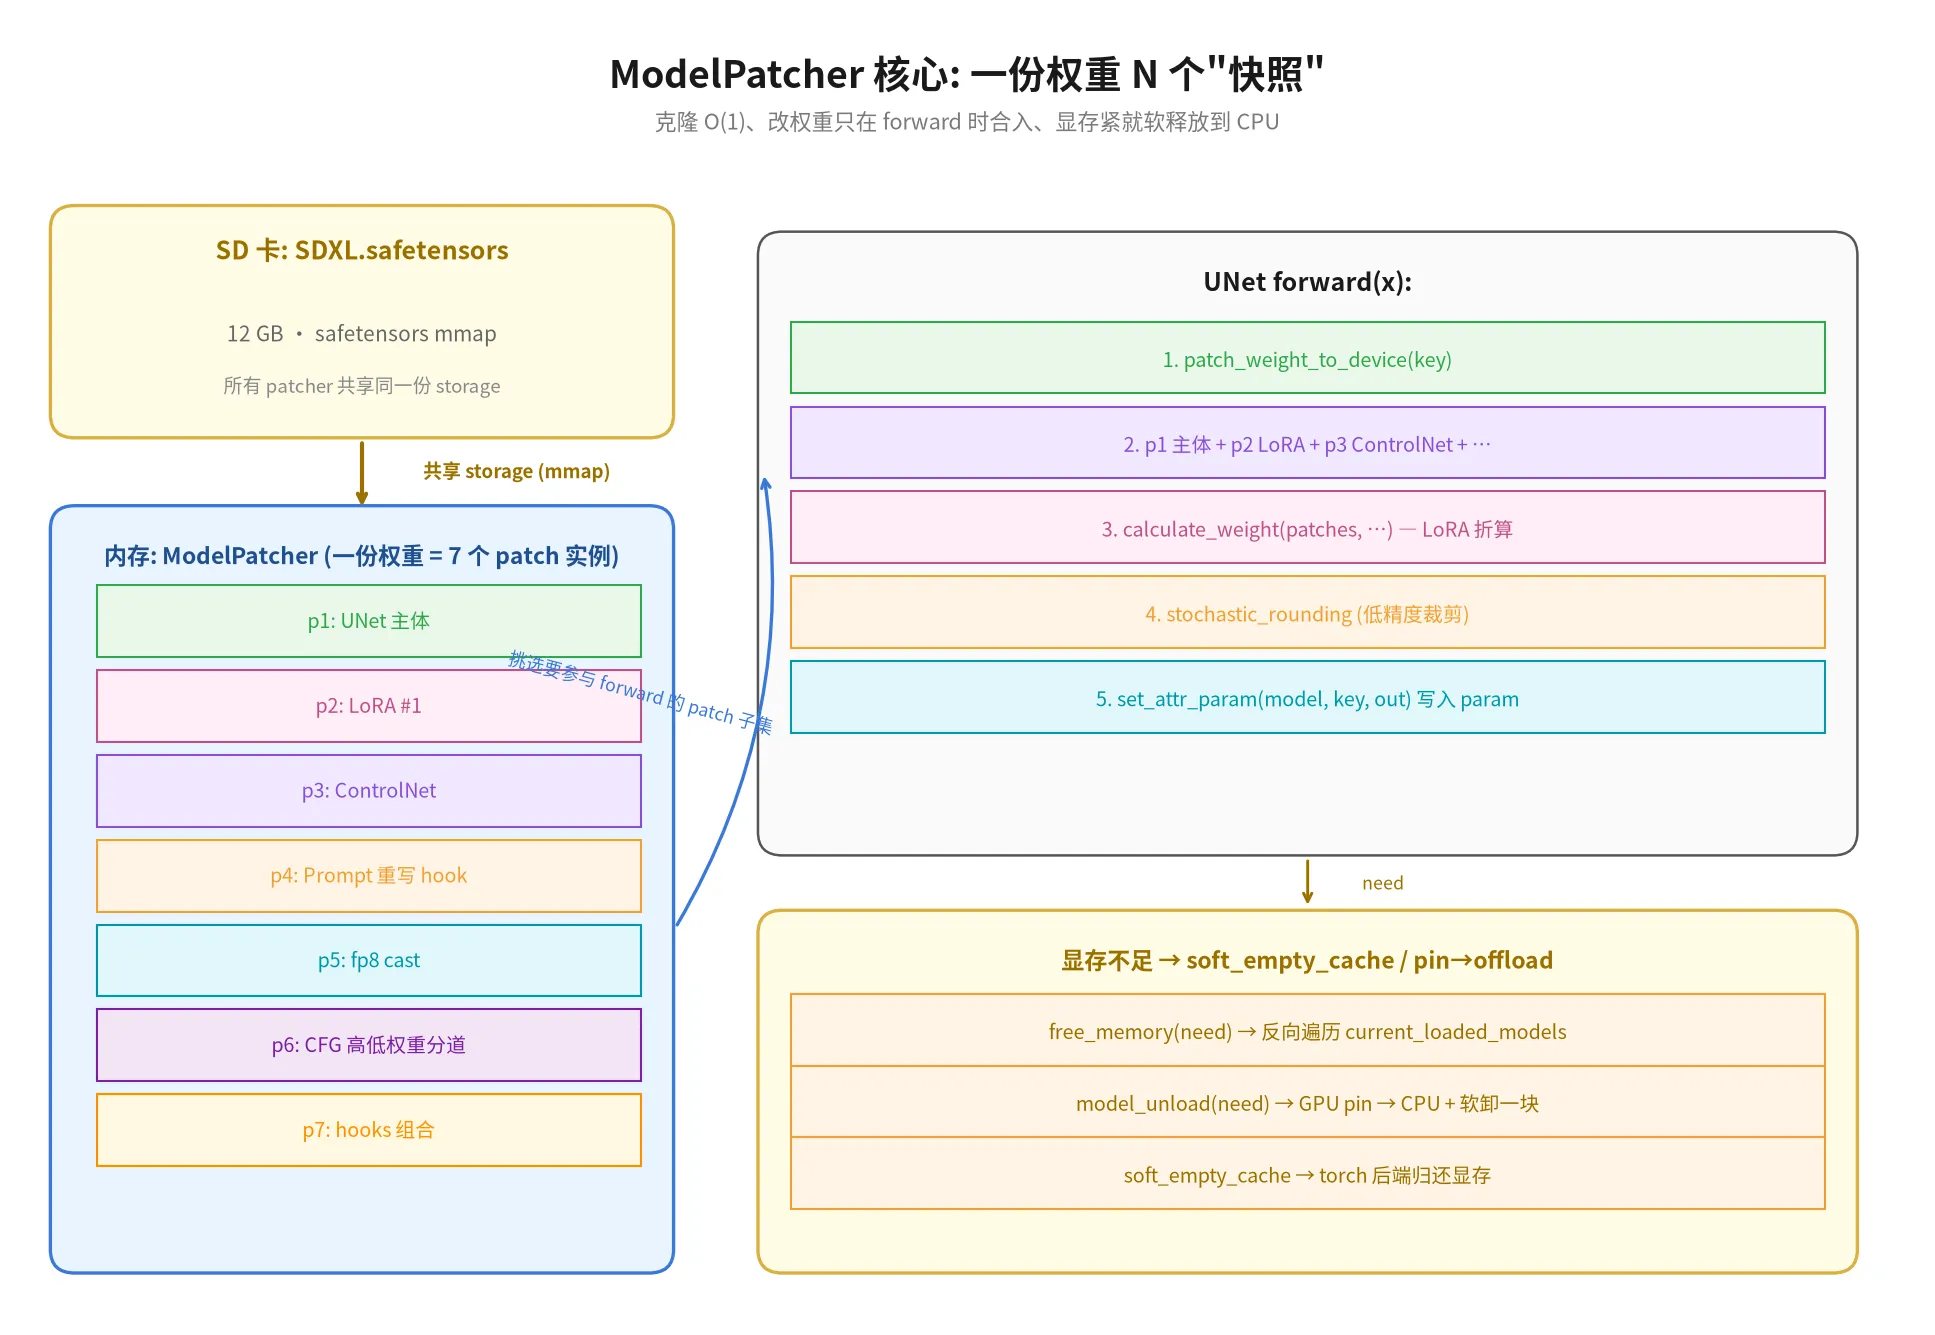
怎么做到的?—— 看 comfy/model_patcher.py 第 460 行的 clone():
def clone(self, ...):
    n = class_(model_override[0], self.load_device, self.offload_device, ...)
    n.patches = {}                  # 1. 复制 patches dict(浅拷贝 + patches 内容复制)
    for k in self.patches:
        n.patches[k] = self.patches[k][:]
    ...
    n.object_patches = self.object_patches.copy()
    n.weight_wrapper_patches = self.weight_wrapper_patches.copy()
    n.model_options = comfy.utils.deepcopy_list_dict(self.model_options)
    n.parent = self
...每次你要”加个 LoRA / 接 ControlNet / 调一组 prompt”,就 clone() 出一个新 ModelPatcher,只复制 patches 字典,不复制底层 torch 张量。底层那张 12GB 的 SDXL.safetensors 文件是用 mmap 打开的,所有 patcher 共享同一份 storage。
真正改权重发生在哪里?—— patch_weight_to_device():
def patch_weight_to_device(self, key, device_to=None, ...):
    weight, set_func, convert_func = get_key_weight(self.model, key)
    if key not in self.backup and not return_weight:
        self.backup[key] = ...  # 备份原权重到 CPU

    temp_dtype = comfy.model_management.lora_compute_dtype(device_to) if key in self.patches else None
    temp_weight = comfy.model_management.cast_to_device(weight, device_to, temp_dtype, copy=True)
    if convert_func is not None:
        temp_weight = convert_func(temp_weight, inplace=True)

    # 计算合并后的权重 (LoRA 折算)
    out_weight = comfy.lora.calculate_weight(self.patches[key], temp_weight, key) if key in self.patches else temp_weight
    ...
    if inplace_update:
        comfy.utils.copy_to_param(self.model, key, out_weight)
    else:
comfy.utils.set_attr_param(self.model, key, out_weight)关键观察:改权重只在 UNet 真正 forward 时才发生(每次拿到 key 后才把 LoRA/ControlNet 折算进 temp_weight,然后才写回)。同一个 ModelPatcher 在不同 prompt 下走两次,实际算出来的”weight + patch” 合成结果可能不一样 —— 但 patcher 实例本身不变,变的是 self.backup 和 self.patches 字典里的引用。
显存不够的时候怎么办?—— model_management.py 里 free_memory():
def free_memory(memory_required, device, keep_loaded=[], ...):
    cleanup_models_gc()
    unloaded_models = []
    for i in range(len(current_loaded_models) -1, -1, -1):
        shift_model = current_loaded_models[i]
        if not shift_model.is_clone(keep_loaded[i]):
            ...
            if memory_to_free > 0 and current_loaded_models[i].model_unload(memory_to_free):
                ...
        unloaded_models.append(current_loaded_models.pop(i))
    soft_empty_cache()
return unloaded_models反向遍历 current_loaded_models 列表,把权重从 GPU pin 回 CPU,然后 soft_empty_cache()。整个过程不是真的卸载,只是把权重搬到 offload_device,模型实例还在。
为什么这块重要?—— 因为 ComfyUI 是面向 SDXL(6GB) / Flux(23GB) / Wan2.1(28GB) 这种”一张消费级 4090 跑不下”的模型的。如果不能 clone 出多个 patcher,每个新 LoRA 都要重新读一遍 12GB 的 checkpoint;而 clone O(1) + on-demand merge,使得同一个图里”换不同的 LoRA / ControlNet 组合”几乎是零成本。
5. 多版本 API: 同一个执行图里,老节点和新节点共存#
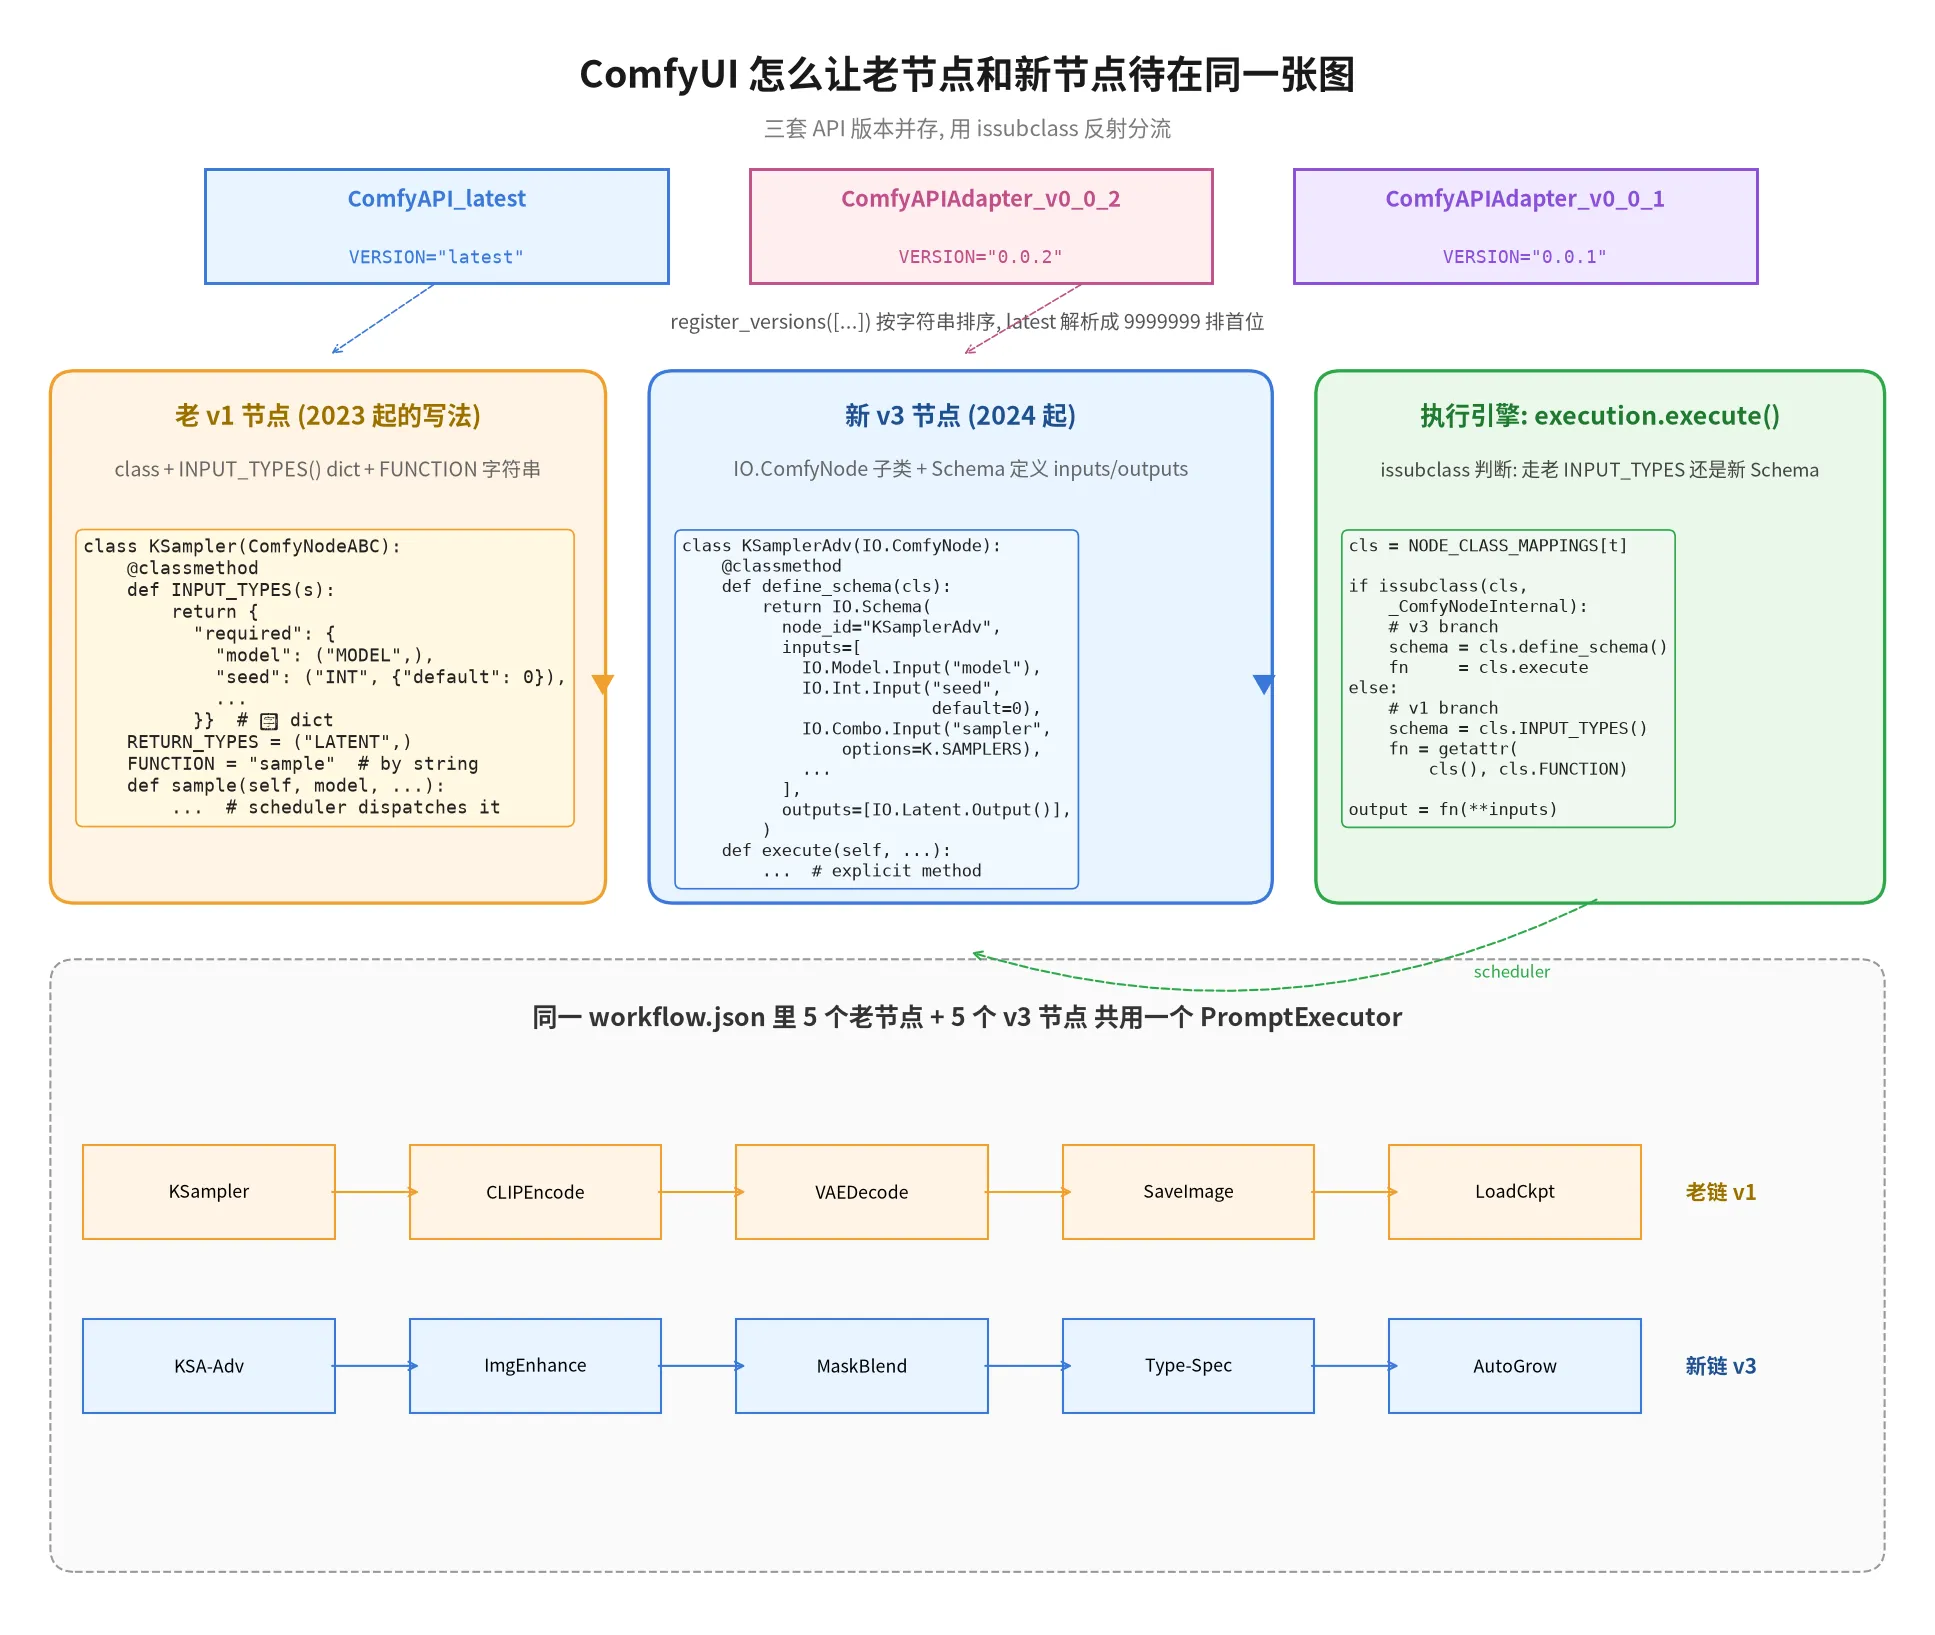
这块是我觉得 ComfyUI 社区生态不停歇的关键 —— 同一个图,5 个老节点 + 5 个新节点,一个执行器搞定。
comfy_api/version_list.py 把三套版本注册成 list:
supported_versions: list[type[ComfyAPIBase]] = [
    ComfyAPI_latest,
    ComfyAPIAdapter_v0_0_2,
    ComfyAPIAdapter_v0_0_1,
]每套版本号是个字符串:"latest" 解析成 9999999,这样它永远排第一;"0.0.2"、"0.0.1" 按字符串排序注册到 register_versions。
老 v1 节点 vs 新 v3 节点的区别 —— 直接对比代码风格:
# 老 v1
class KSampler(ComfyNodeABC):
    @classmethod
    def INPUT_TYPES(s):
        return {"required": {
            "model": ("MODEL",),
            "seed":  ("INT", {"default": 0}),
            ...
        }}                              # dict
    RETURN_TYPES = ("LATENT",)
    FUNCTION = "sample"                # 字符串方法名
    def sample(self, model, ...):
        ...

# 新 v3
class KSamplerAdv(IO.ComfyNode):
    @classmethod
    def define_schema(cls):
        return IO.Schema(
            node_id="KSamplerAdv",
            inputs=[
                IO.Model.Input("model"),
                IO.Int.Input("seed", default=0),
                IO.Combo.Input("sampler", options=K.SAMPLERS),
                ...
            ],
            outputs=[IO.Latent.Output()],
        )                                # Schema 对象
    def execute(self, ...):              # 显式方法名
...执行器怎么分辨?—— execution.py 里靠 issubclass:
if issubclass(class_def, _ComfyNodeInternal):
    # v3 路径
    schema = class_def.define_schema()
    fn     = class_def.execute
else:
    # v1 路径
    schema = class_def.INPUT_TYPES()
fn = getattr(class_def(), class_def.FUNCTION)_ComfyNodeInternal 是 v3 节点类的”标记接口”—— 一旦继承自它,就走新路径;否则按老路径走。
_ComfyNodeInternal 本身怎么找?—— comfy_api/internal/__init__.py 里有个非常聪明的小函数:
def first_real_override(cls, name, *, base=None):
    """找到 cls 上第一个不是 base 提供的、真正覆盖过的方法"""
    ...
    for c in cls.mro():                       # 从子类往基类爬
        if c is base:                         # 到达 base 占位符就停
            break
        if name in c.__dict__:                # 找到 c 里第一次定义这个 attr 的层
            func = getattr(c, name).__func__
            if func is not base_func:         # 确认不是占位
                return getattr(cls, name)
return None也就是说,类自己 override 的方法才能被识别出来,继承自 base 的占位实现不算。这套”反射式 override” 允许同一个执行器同时跑 v1 / v3 节点,这是 ComfyUI 生态不停歇的关键 —— 第三方插件不需要为了赶新 API 重写全部老节点,新插件可以用 v3 写得更优雅。
6. check_lazy_status: 让节点自己声明”我现在还缺哪些输入”#
最后这块让我读的时候愣了一下。
execution.py 里这段:
if lazy_status_present:
    required_inputs = await _async_map_node_over_list(
        prompt_id, unique_id, obj, input_data_all, "check_lazy_status",
        allow_interrupt=True, v3_data=v3_data_lazy)
    required_inputs = set(sum([r for r in required_inputs if isinstance(r,list)], []))
    required_inputs = [x for x in required_inputs if isinstance(x,str) and (
        x not in input_data_all or x in missing_keys
    )]
    if len(required_inputs) > 0:
        for i in required_inputs:
            execution_list.make_input_strong_link(unique_id, i)
return (ExecutionResult.PENDING, None, None)check_lazy_status(self, **inputs) -> list[str] —— 节点自己声明”我现在还缺哪些输入”。如果节点发现自己需要的输入上游还没给(比如 LoadCheckpoint 节点要等 CheckpointLoaderSimple 先跑),就返回这些 key,执行器会建一个”强连接”:
def make_input_strong_link(self, to_node_id, to_input):
    inputs = self.dynprompt.get_node(to_node_id)["inputs"]
    if to_input not in inputs:
        raise NodeInputError(...)
    value = inputs[to_input]
    if not is_link(value):
        raise NodeInputError(...)
    from_node_id, from_socket = value
self.add_strong_link(from_node_id, from_socket, to_node_id)强连接的意思是:这条边没算完之前,本节点不能跑。
为什么需要这个?—— ComfyUI 里 LoadCheckpoint 这种”返回 (MODEL, CLIP, VAE) 三个 output”的节点,前端连线可能只用到了 MODEL,但 CLIP/VAE 也得跑(否则 GPU 显存闲置).没有 check_lazy_status 的话,执行器会”先跑下游节点,发现需要 CLIP 时再回头跑” —— 这就乱套了。
让节点自己声明需求,而不是执行器去猜测 —— 这就是声明式调度 vs 命令式调度 的区别,ComfyUI 选前者,运行时反馈”我现在还缺什么”,调度器照着做。
7. 一些值得抄的小工程习惯#
除了上面 6 个核心点,还有一些边角的小设计我读着也挺喜欢,放在一起说:
output_node_name静态映射表缓存(nodes.py第 2367 行base_node_names = set(NODE_CLASS_MAPPINGS.keys()))—— 防止 hot path 反复做dir()/getattr,这种小优化在 33 万行项目里到处可见weakref.finalize(real_model, cleanup_models)(model_management.py第 826 行)—— 模型实例 GC 时自动清理显存,杜绝”模型实例没了但显存还在被引用” 的内存泄漏PromptModelTracker(model_patcher.py第 47 行)—— 追踪当前 prompt 用到的所有 model,prompt 结束后批量解除”in use” 状态,触发显存回收.ci/和.spectral.yaml(openapi lint 配置)—— 24 万行的 openapi.yaml 不是手写的,是从 Python schema 自动生成的(看comfy_api/generate_api_stubs.py)protocol.py(2 行)—— 只导入了一个BinaryEventTypes,这是前端 WS 通讯协议的事件类型 enum,做成单独文件避免循环 import
8. 它不漂亮的地方(诚实说说)#
读代码不能光夸,我把不漂亮的地方也说清楚:
- 33 万行 Python 的代码量已经接近”维护不动的边界。任何尝试”重写 ComfyUI 核心”的项目基本都死在第一步 —— 这套 API 是有”载荷”的,换底层就要重写全部 1M+ extension
execution.py那一坨 1465 行 ——PromptExecutor类的方法太密集,执行 / 校验 / 调度 / 缓存 / 状态机全在一个文件里。重构空间很大,但风险也很大 —— 谁都不敢动- 没有真正的”类型系统” ——
IO.ComfyType这套装饰器协议虽然新,但本质上是把类型信息塞进 dict 字段里,没有 dataclass / TypedDict 那种编译器能查的强约束。第三方插件的 input 经常对不上,前端错位 - asyncio 和 sync 混用 ——
create_sync_class把 async v3 节点自动变成 sync wrapper(comfy_api/v0_0_2/__init__.py),这套转换机制非常聪明但也意味着调试时要小心 stack 里随时可能出现”sync 调 async” 的隐患 comfy_execution/caching.py的Unhashable(NaN)兜底 —— 当缓存 key 里出现不可哈希的对象时(比如 tensor),会被替换成 NaN,意味着这个节点永远会被重跑。生产上这是 silent 的性能损失 —— 我读到这里的时候想”为啥不直接 raise”,后来想想可能是为了不让一个插件拖垮整个 workflow,做了兜底
9. 我的几个观察#
写到这里,可以收个尾了。这套架构最让我佩服的不是某个具体技术点,而是它怎么在 33 万行代码里把”易扩展” 和 “易调度” 平衡好:
NODE_CLASS_MAPPINGS是全局 dict —— 扩展性 100%,类型检查 0DynamicPrompt是图 + 子图 —— 灵活 100%,调试可视化复杂度 100- ModelPatcher 零拷贝 —— 显存 100%,patch 顺序调试极难
- 多版本 API —— 兼容 100%,executor 复杂度+100
check_lazy_status—— 声明式 100%,调度器职责反推
ComfyUI 不是”clean code” 教科书级的项目,但它是”实际跑起来最稳的 Stable Diffusion 引擎” —— 这个权衡是它能活下来的原因。
OK,以上就是这次读代码的全部收获。三个图都是我自创的(从代码逻辑梳理出来,不是抄 README),fig0 是节点图编程全景,fig1 是 ModelPatcher 的零拷贝 + 软释放,fig2 是多版本 API 兼容 —— 都是”代码里没图,我来补一张” 的角度。如果你最近也在用 ComfyUI,希望这些视角能帮到你。
参考#
- 仓库: https://github.com/comfyanonymous/ComfyUI ↗
- 关键文件:
nodes.py/execution.py/comfy_execution/{caching,graph,validation}.py/comfy/model_management.py/comfy/model_patcher.py/comfy_api/latest/_io.py - 多版本 API 注册表:
comfy_api/version_list.py+comfy_api/internal/api_registry.py