深入解析 context-mode:18 个 AI agent 同一份 MCP,把 315KB 压成 5.4KB
💬 评论mksglu/context-mode 14MB TS 仓库 + 7 个 esbuild bundle,3 种 hook 范式统一 18 个 AI 编程 agent 平台,BM25 + Trigram + RRF 搜索,FloodGuard 限流,拆解工业级 MCP context 治理方案。
context-mode:18 个 AI 编程 agent 同一份 MCP,98% 的 context 洪水怎么挡住#
最近在 GitHub Trending 上看到的项目 mksglu/context-mode,slogan 写着 “The other half of the context problem”。我一开始以为又是个”prompt 压缩”的工具,翻完代码发现这个项目是把 MCP 服务器 + 18 个平台适配 + FTS5 知识库 + 会话连续性揉成了一套工业级 context 治理方案。HN #1,15K+ stars,关键是——这个项目就是装在我现在用的 OpenClaw / Pi Agent 上的 extension,写这篇的过程里它就在帮我省 token。
定位:为什么说 “the other half”#
做 AI 编程 agent 的人都知道,context window 是个漏水的桶。README 给了几个具体数字:一个 Playwright snapshot 56KB,20 个 GitHub issue 59KB,一条 access log 45KB。30 分钟下来 40% 的 context 没了,接下来 agent 一压缩,把”刚才在改哪个文件""任务进度到哪了”全忘了。
context-mode 的解法分四块:
- Context Saving — 沙箱不让原文进 context。315KB → 5.4KB,98% 降幅。
- Session Continuity — 文件编辑、git 操作、task、错误、用户决定全部写进 SQLite。压缩后从 FTS5 + BM25 检索,模型能接得上。
- Think in Code — 让 LLM 编程,不是让 LLM 算。要数 50 个文件的函数个数,模型写个脚本
console.log()完事,而不是读 50 个文件到 context。 - No prose-style enforcement — 不规定模型怎么写答案。README 引用了 Moonshot 的研究,证明激进的 brevity prompt 会拖低 kimi-k2.5 的代码/推理 benchmark。
第 4 点特别重要——大多数”AI 工具”会塞一段”请简洁回答 / 少用礼貌语 / 不要写长篇解释”,context-mode 明确说不做这事,只管”数据去哪”,不管”模型怎么说话”。
仓库结构:src 41K 行 TS + 7 个 bundle#
仓库 14MB,但 src/ 加起来才 41K 行 TS。大头在测试和文档,生产代码量控制得极好。server.ts 是 4991 行的主文件(对应 MCP 服务器本体),cli.ts 2040 行(对应 context-mode CLI 工具)。
最有意思的是 bundle 拆分。npm run bundle 这条命令一次打 7 个文件:
server.bundle.mjs (659K) — MCP server 主体,所有平台都用
cli.bundle.mjs (726K) — 18 平台统一 CLI
hooks/session-extract.bundle.mjs (46K) — session 事件提取
hooks/session-snapshot.bundle.mjs (6.1K) — 压缩前 snapshot
hooks/session-db.bundle.mjs (26K) — SessionDB 持久化
hooks/security.bundle.mjs (14K) — Bash 沙箱规则
hooks/session-attribution.bundle.mjs (2.8K) — 事件归属每个 bundle 都被 --external:better-sqlite3(原生模块不进 bundle)。assert-bundle 和 assert-asymmetric-drift 两条 assert 命令确保这些 bundle 互相不会漂移——也就是说,改了 server.ts 但忘了 rebuild session-extract.bundle.mjs,CI 会立刻报。
核心设计 1:3 种 hook 范式统一抽象#
18 个 AI 编程 agent,18 套事件协议。context-mode 用一个 HookParadigm 字段把它们压成 3 类:
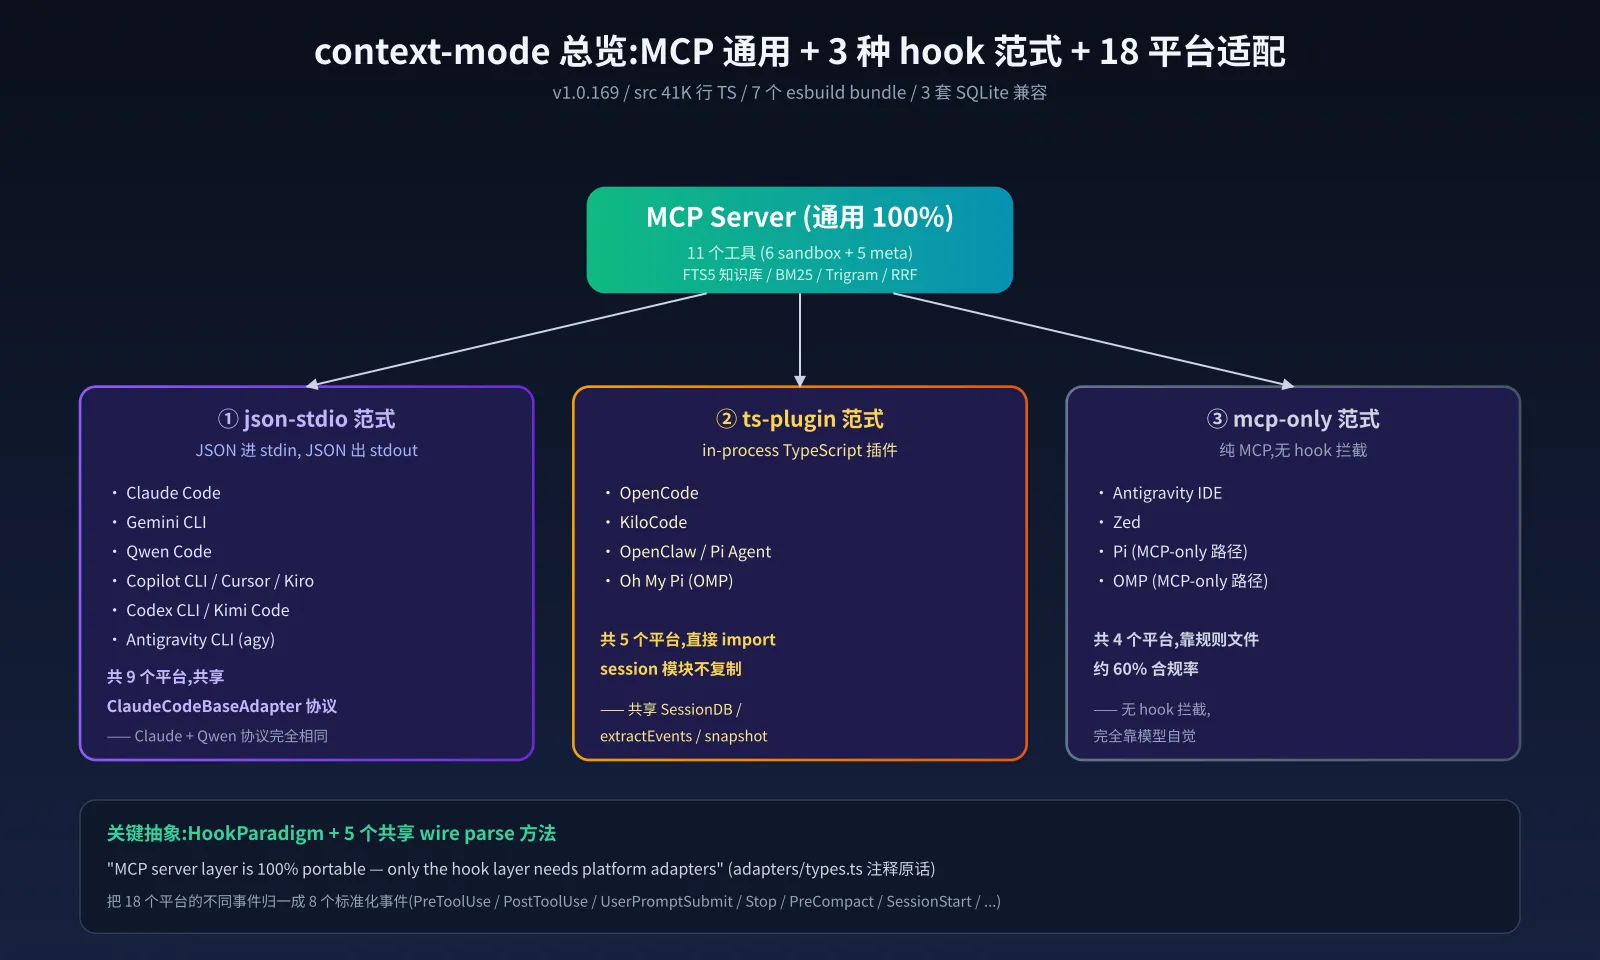
① json-stdio 范式 — 9 个平台:Claude Code / Gemini CLI / Qwen Code / Copilot CLI / Cursor / Kiro / Codex CLI / Kimi Code / Antigravity CLI (agy)。所有事件走 JSON 进 stdin / JSON 出 stdout,共享 ClaudeCodeBaseAdapter 这个 168 行的基类。Claude Code 和 Qwen Code 的协议完全相同,所以这两个 adapter 各自只有 672 行和适配代码,核心 parse/format 全部走基类。
② ts-plugin 范式 — 5 个平台:OpenCode / KiloCode / OpenClaw / Pi Agent / OMP。in-process TypeScript 插件,直接 import SessionDB / extractEvents / buildResumeSnapshot,不复制 session 逻辑。这种”in-process 跑”的范式比 stdio MCP 少一个子进程,OpenClaw 文档明确说”无冗余 stdio MCP child per session”。
③ mcp-only 范式 — 4 个平台:Antigravity IDE / Zed / Pi 的 MCP-only 路径 / OMP 的 MCP-only 路径。完全靠规则文件(GEMINI.md / AGENTS.md / SYSTEM.md),约 60% 合规率,模型自觉。
adapters/types.ts 顶部注释原话:“The MCP server layer is 100% portable and needs no adapter. Only the hook layer requires platform-specific adapters.” —— 这一点是这个项目架构的核心论点:把协议适配收敛到一个层,MCP 本体不动。
每个 adapter 都要实现 8 个标准化 hook event:PreToolUse / PostToolUse / UserPromptSubmit / Stop / PreCompact / SessionStart / 加上各平台特有。基类 BaseAdapter 提供共享 getSessionDir() + backupSettings(),ClaudeCode / Qwen 共享 ClaudeCodeBaseAdapter 的 8 个 parse/format 方法。
核心设计 2:Session Continuity 5 hook 协同 + FloodGuard#
要让模型在压缩后还能接上工作,需要 5 个 hook 各司其职。README 给了一张 16 平台的完整度矩阵(我把这张矩阵重新画了一遍,把 ”✓” / ”~” / ”—” 标得更清楚):
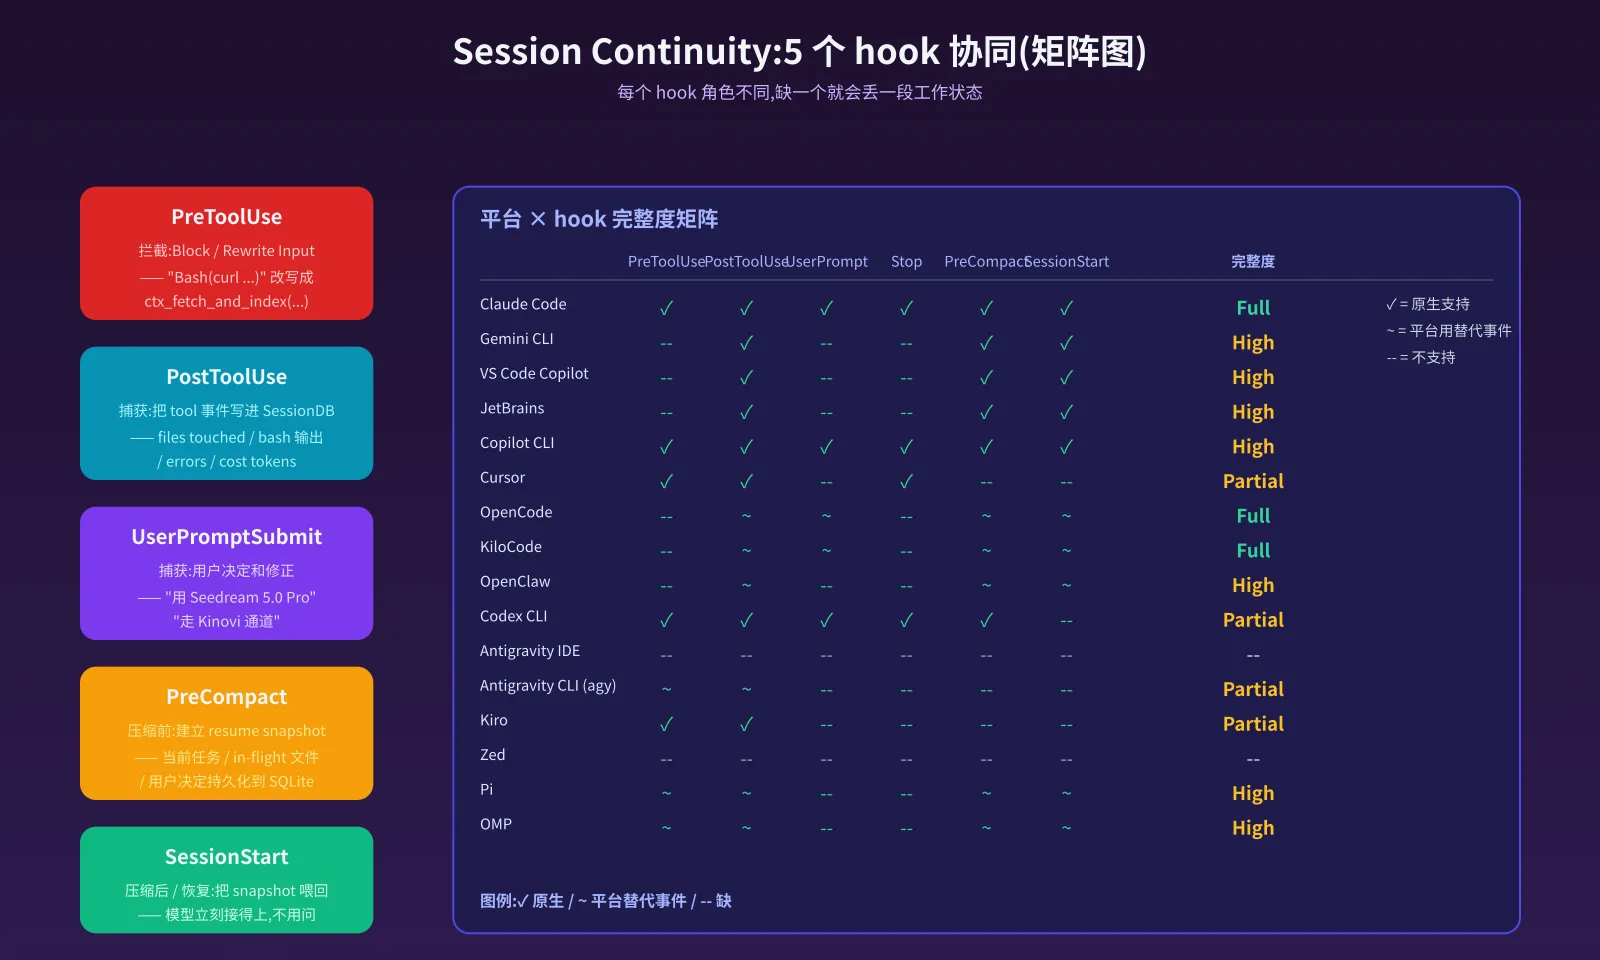
5 个 hook 角色:
- PreToolUse — 拦截:Block / Rewrite Input。把
Bash(curl ...)改写成ctx_fetch_and_index(...)。 - PostToolUse — 捕获:把 tool 事件写进 SessionDB(files touched / bash 输出 / errors / tokens)。
- UserPromptSubmit — 捕获用户决定(“用 Seedream 5.0 Pro” / “走 Kinovi 通道”)。
- PreCompact — 压缩前:建立 resume snapshot(任务 / in-flight 文件 / 用户决定 → SQLite)。
- SessionStart — 压缩后 / 恢复:把 snapshot 喂回,模型立刻接得上。
每行右侧的”完整度”(Full / High / Partial / —)是 README 自己标的。从矩阵看出:Claude Code 是唯一全 ✓ 的平台,OpenCode / KiloCode 用”~“(用替代事件)也能凑出 Full;Antigravity IDE / Zed 完全没 hook,只能走规则文件。
更细节的是 FloodGuard 限流(src/search/flood-guard.ts):
class FloodGuard {
  // 1-3 次:正常(2 结果/查询)
  // 4-8 次:降级(1 结果/查询)+ 警告
  // 9+ 次:硬阻断,redirect → ctx_batch_execute
}README issue #769 提到一个关键 bug:多 agent 并发时,模块全局计数器会误伤——10 个子 agent 各搜 2 次,会被当成单个 actor 搜了 20 次而硬阻断。修法是按 agentKey 切桶:
class FloodGuard {
  #buckets = new Map<string, Bucket>();  // per-agent-context
  // ... 单 actor 限流不变,并发 agent 独立计数
}追踪的 key 数有硬上限(防御性),避免被恶意 host 撑爆内存。这个模块被刻意做成”pure and transport-free”,只接受参数,不动 I/O,可以直接 unit test 不用启 MCP server。
核心设计 3:FTS5 + BM25 + Porter + Trigram + RRF#
context-mode 的知识库不是普通 ES,是用 SQLite FTS5(Full-Text Search 5)虚拟表存文本,BM25 算相关性,Porter + Trigram 两套 tokenizer 并行查询,最后用 Reciprocal Rank Fusion (RRF) 合并。
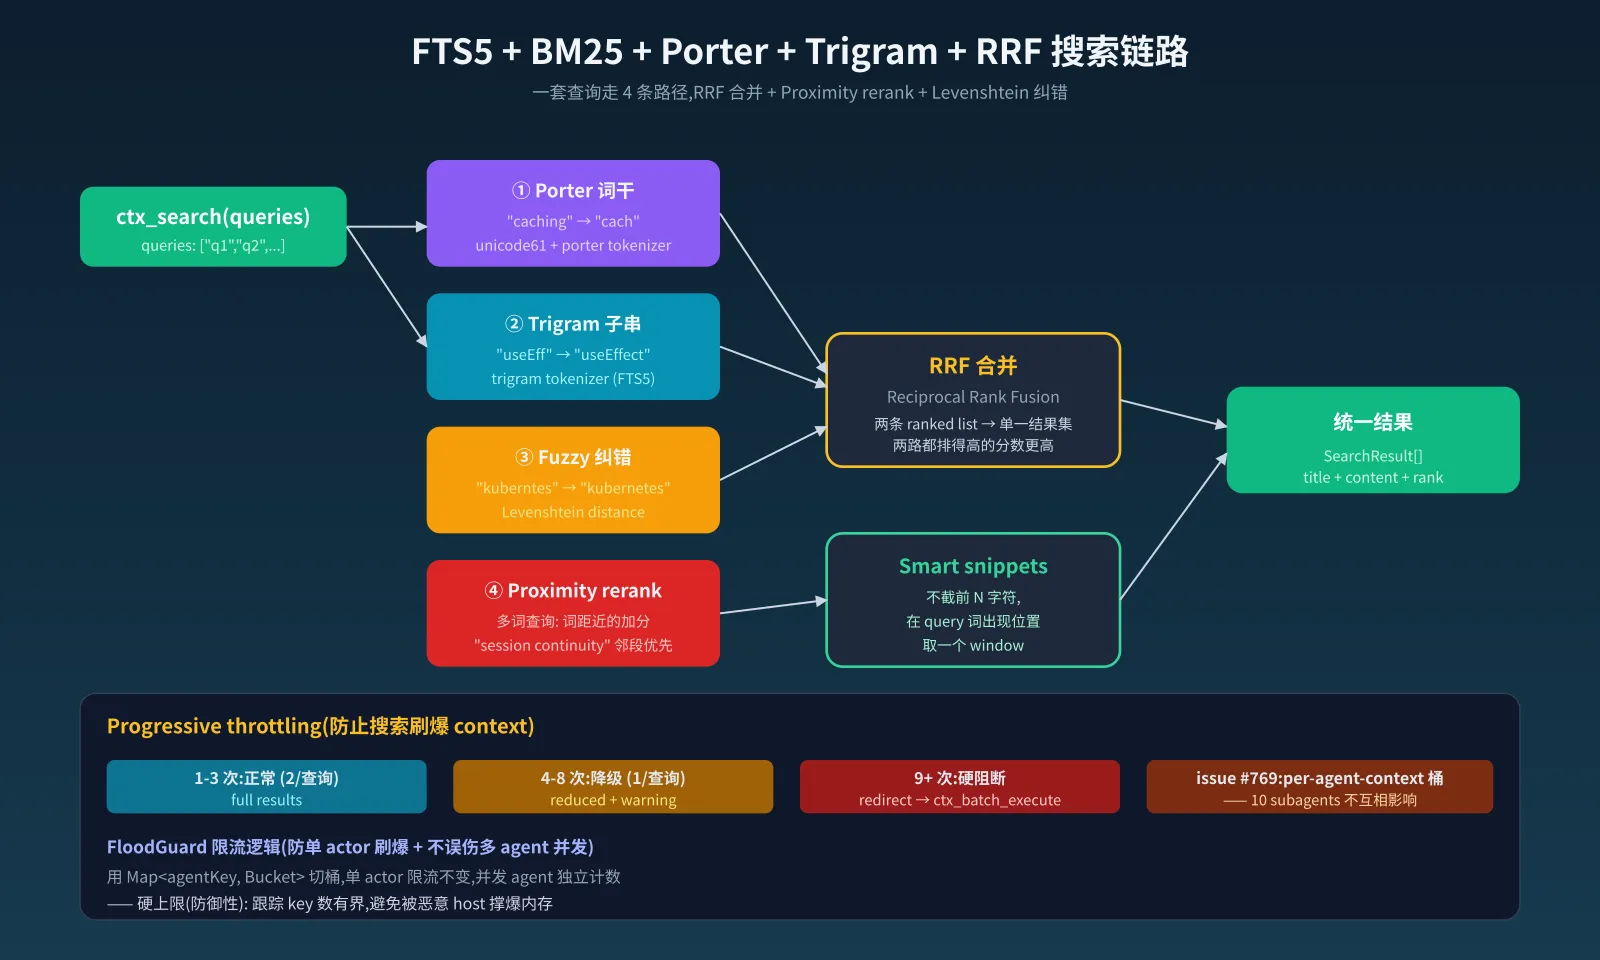
一条 ctx_search(queries) 查询走 4 条路径:
- ① Porter 词干 —
chunks表用tokenize='porter unicode61'。"caching"自动匹配"cached"/"caches"/"cach"。 - ② Trigram 子串 —
chunks_trigram表用tokenize='trigram'。"useEff"找"useEffect","authenticat"找"authentication"。 - ③ Levenshtein 纠错 —
"kuberntes"→"kubernetes",纠完重查。 - ④ Proximity rerank — 多词查询,词距近的片段加分。
"session continuity"邻段优先于跨段匹配。
RRF 合并两套 Porter 和 Trigram 的 ranked list,两路都排得高的结果分数更高。这替代了旧的”cascading fallback”(trigram 只在 porter 找不到时才用),现在两路并行跑。
然后 Smart snippets 不截前 N 字符,而是在 query 词出现位置取一个 window——更可能命中关键内容。
标题和 heading 在 BM25 里加权 5x,精确的导航查询能立刻命中。
核心设计 4:composeFetchCacheKey 防 source 标签碰撞#
这是个小但重要的细节,src/fetch-cache.ts 整个文件就 30 行:
export function composeFetchCacheKey(
  source: string | undefined, url: string
): string {
  return source === undefined ? url : `${source}::${url}`;
}痛点:同一个 source 标签(如 “Docs”),在不同 URL 下绝不能命中同一条 cache,也不能在 FTS5 里 dedup 到同一行。文件顶部注释原话:“Two distinct URLs that share a user-supplied source label MUST NOT collide in the cache.”
ctx_search(source: "Docs") 仍然能用,因为 LIKE 模式 source 过滤匹配子串 “Docs”(出现在 “Docs::https://…” 里)。
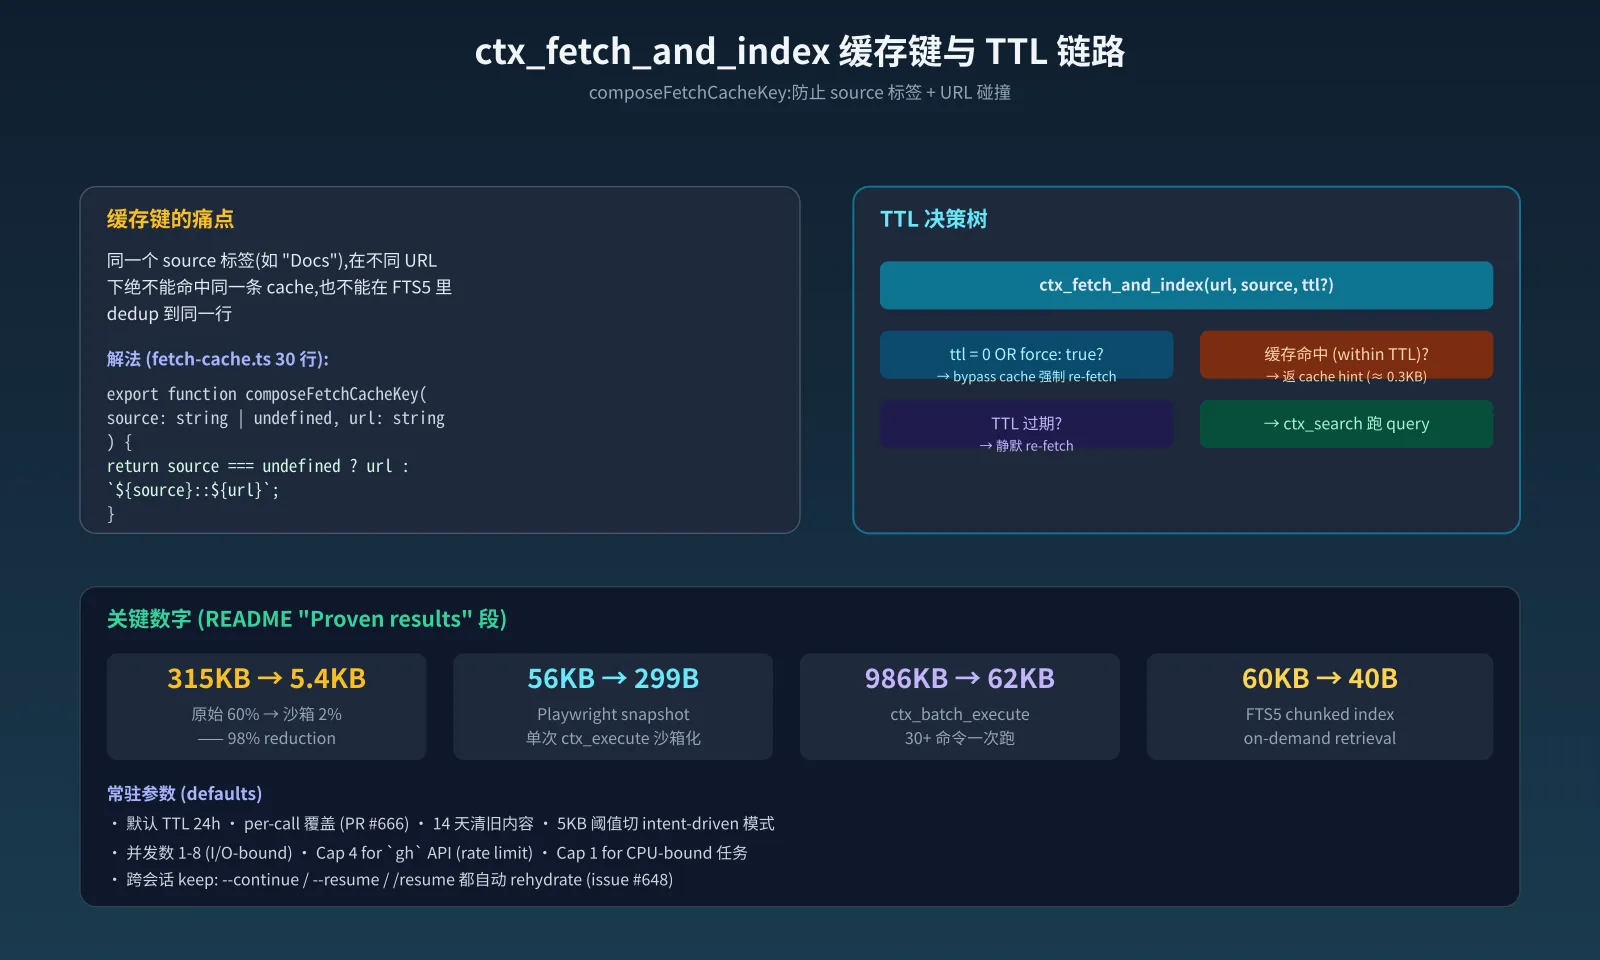
TTL 决策树(图里画了):默认 24h,per-call 用 ttl: <ms> 覆盖,ttl: 0 或 force: true 强制 re-fetch。14 天清旧内容,5KB 阈值切到 intent-driven 模式(自动索引全文,只返回匹配 intent 的片段)。--continue 会话跨重启不丢索引——14 天内 resume 直接用本地,不用 re-fetch。
README 给了几个震撼数字:315KB → 5.4KB(98% reduction),986KB → 62KB(ctx_batch_execute 30+ 命令一次跑),56KB → 299B(Playwright snapshot 进沙箱),60KB → 40B(FTS5 chunked index)。
核心设计 5:CONTEXT_MODE_DATA_DIR 通用存储覆盖 + 3 套 SQLite#
如果你跑过 CI runner 或 Docker 容器,可能会被”找不到 home / home 是只读”坑过。context-mode 做了个通用 escape hatch(issue #649):
export function resolveContextModeDataRoot(env = process.env): string | null {
  const raw = env.CONTEXT_MODE_DATA_DIR;
  if (!raw || raw.trim() === "") return null;
  if (raw.startsWith("~")) {
    return resolve(homedir(), raw.replace(/^~[/\\]?/, ""));
  }
  return resolve(raw);
}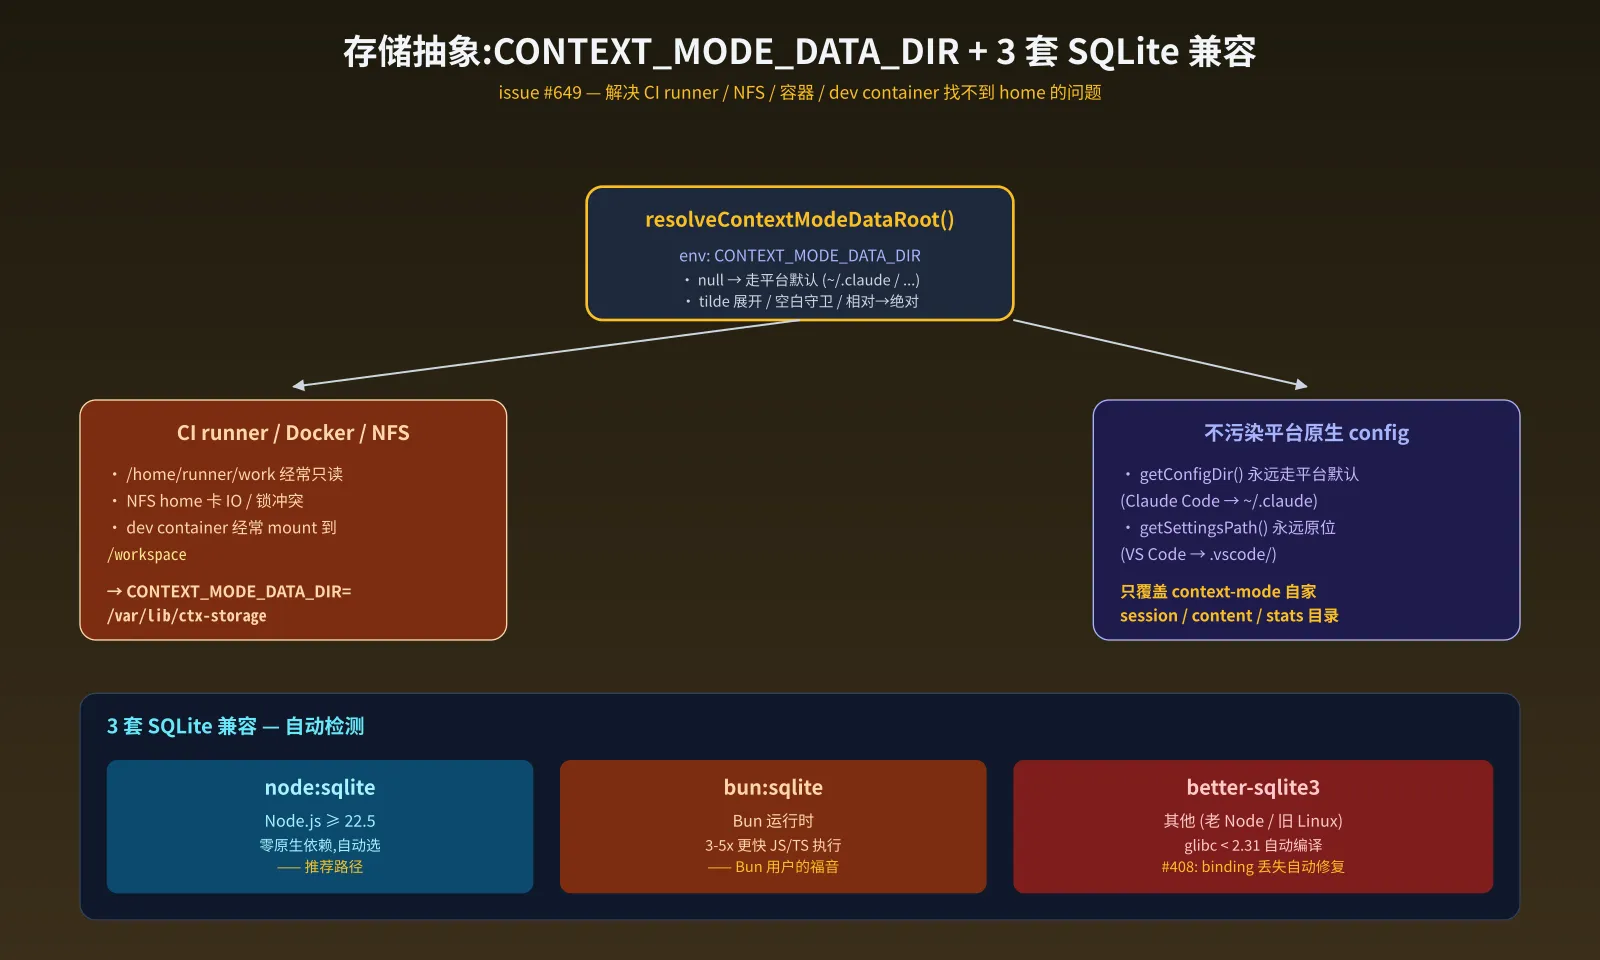
关键约束:只覆盖 context-mode 自家的 getSessionDir() / getMemoryDir(),永远不碰平台原生 config。getConfigDir() / getSettingsPath() 永远走平台默认(Claude Code 找 ~/.claude,VS Code 找 .vscode/)。
这套设计复制了 resolveClaudeConfigDir 的全部合同——tilde 展开、空白守卫、相对路径 → 绝对——所以 server / CLI / security / adapter 4 层路径计算逐字节一致。
3 套 SQLite 自动检测:
- node:sqlite — Node ≥ 22.5,零原生依赖,推荐路径。注释里特别提到:这个选择是为了避开 V8
madvise(MADV_DONTNEED)在 Linux 上偶发 SIGSEGV 崩 better-sqlite3 的 .got.plt 段(nodejs/node#62515)。 - bun:sqlite — Bun 运行时,JS/TS 执行快 3-5x。
- better-sqlite3 — 老 Node / 旧 Linux 兜底。glibc < 2.31 自动从源码编译。
better_sqlite3.node丢失时 postinstall 自动 re-fetch 修复(issue #408)。
Linux + Node < 22.5 直接不安装——README 给了”unsupported”标签和 remediation 提示。
核心设计 6:跟我的工作流直接相关的 OpenClaw 集成#
这个项目之所以吸引我,是因为它原生支持我现在用的 OpenClaw / Pi Agent。src/adapters/openclaw/ 单独一个目录,src/adapters/pi/ 又分 extension.ts + mcp-bridge.ts 两个文件,1039 行的 plugin.ts 是 OpenClaw 适配器。
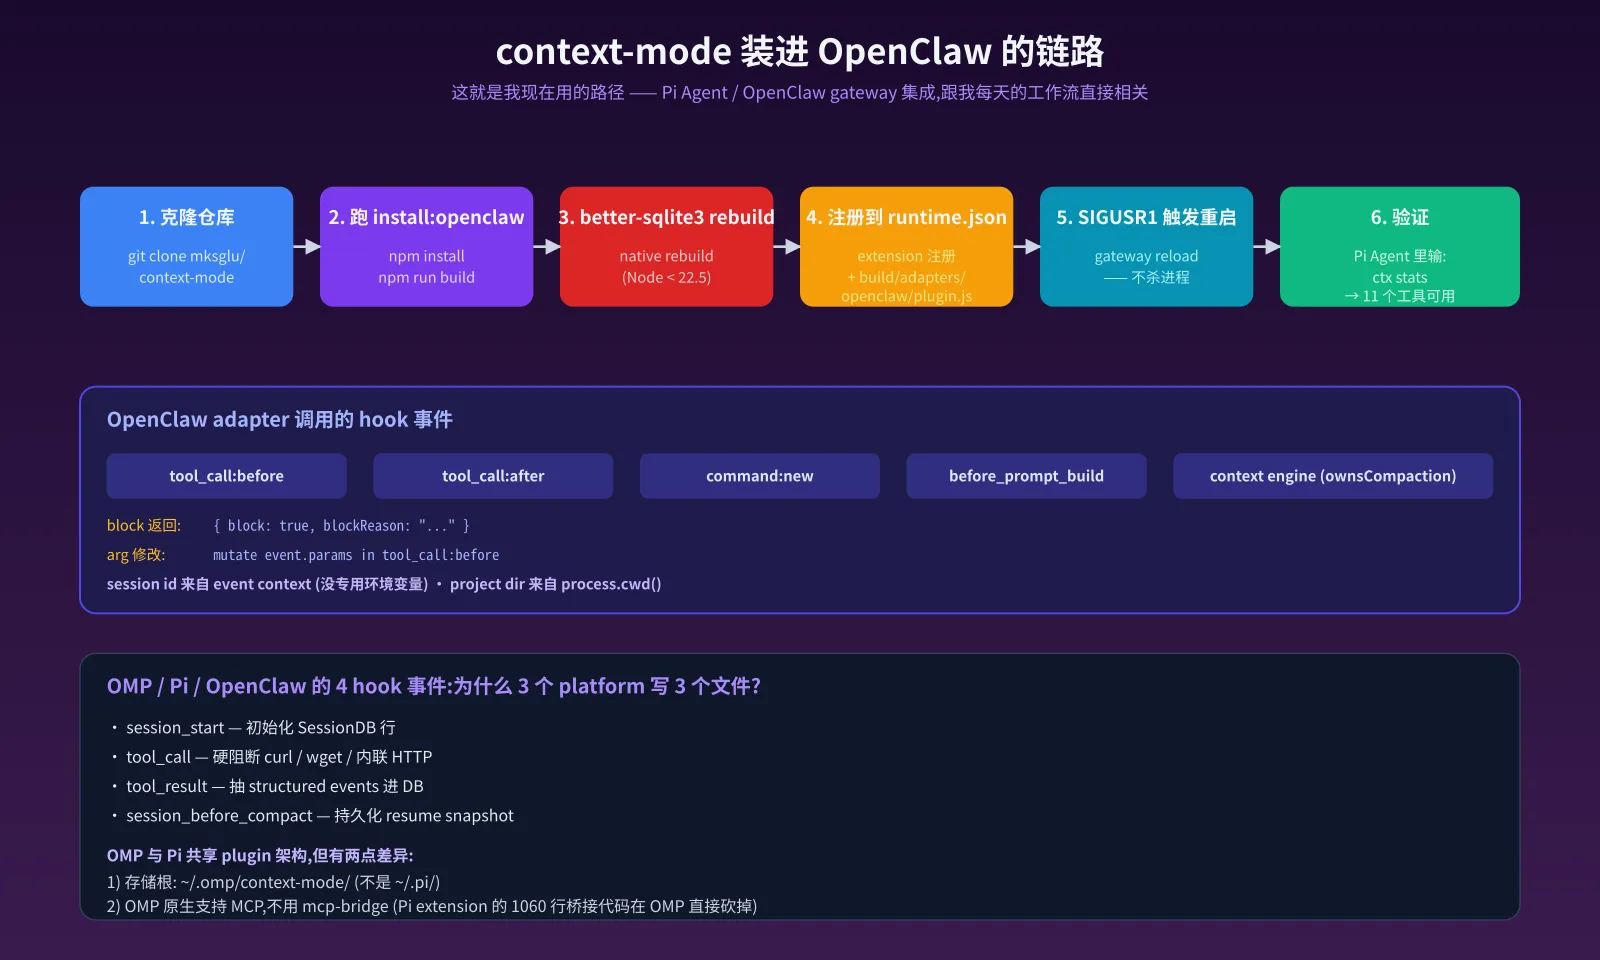
安装路径很直接:
git clone仓库npm run install:openclaw(用$OPENCLAW_STATE_DIR,默认/openclaw)- installer 自动做:
npm install/npm run build/better-sqlite3native rebuild / extension 注册到runtime.json/ 发 SIGUSR1 让 gateway 重启 - Pi Agent 里输
ctx stats验证 11 个工具都可用
OpenClaw adapter 调用的 hook 事件:
tool_call:before/tool_call:after— 拦截 / 捕获command:new— 新命令开始before_prompt_build— 注入 routing 指令context engine带ownsCompaction— 自己管压缩- 阻断返
{ block: true, blockReason }/ arg 修改mutate event.params
session id 来自 event context(没专用 env var),project dir 来自 process.cwd()。
OpenClaw 文档提了一个最低版本要求:> 2026.1.29(包含 PR #9761 的 api.on() lifecycle 修复)。老版本 lifecycle hook 静默失败,adapter 会 fallback 到 DB snapshot 重建(精度差但保住关键状态)。
OMP(Oh My Pi)和 Pi 共享 plugin 架构,但有 2 个差异:
- 存储根:
~/.omp/context-mode/,不是~/.pi/ - OMP 原生支持 MCP——
mcp-bridge.ts这 1060 行桥接代码在 OMP 直接砍掉
这个细节我特别喜欢:两个 engine 共享 plugin contract,只在 storage 和 MCP 桥接上做平台适配。这跟 OpenCode / KiloCode 共享 OpenCodeAdapter 是同一个套路——#if platform_specific_branch #endif 比复制代码好。
几条不那么显眼但很实在的设计#
issue #625 把 curl / wget 跟 fetch() / requests.get() 分开处理:
- 语言级 HTTP 永远 block(
fetch(、requests.get(、urllib.request、Invoke-WebRequest) - curl / wget 单独判定:
isSafeCurlWget()区分”静默 + 写文件”允许(作 MCP 挂了的逃生舱)vsstdout/ 缺文件输出(仍 block)
—— 防止 MCP 挂掉时整个 session 死锁。
OMP_TOOL_MAP / PI_TOOL_MAP 把 OMP/Pi 的小写工具名(bash / read / edit)归一化成 shared extractor 期待的 PascalCase(Bash / Read / Edit)。这是把”shared session 逻辑”做成 plugin 模式必须的胶水。
stripQuotedContent() 先剥离带引号的 CLI 参数(避免 gh issue list --search "curl wget" 这种 false-positive),再判 BLOCKED_HTTP_PATTERNS。
preToolUse matcher 用正则:run_shell_command|read_file|read_many_files|grep_search|web_fetch|activate_skill|mcp__plugin_context-mode|mcp__context-mode|mcp__(?!.*context-mode)。注意负向预查 mcp__(?!.*context-mode)——除了 context-mode 自家 MCP 工具外,所有其他 MCP 工具的 hook 拦截都打开,但 context-mode 自己的工具不重复拦。
version-sync.mjs 自动同步 package.json 的 version 到 9 个不同 manifest(.claude-plugin/plugin.json / .cursor-plugin/plugin.json / .codex-plugin/plugin.json / 等等)——一个 npm 升级命令,9 个 marketplace 同步。
复用价值最高的 5 条#
如果让我从 context-mode 抄走 5 样东西,我会选:
① 3 种 hook 范式统一抽象(HookParadigm + BaseAdapter + 8 个标准化 event) —— 多平台项目直接抄。MCP / LSP / extension 协议都该这么设计:核心 100% 通用,只把”协议适配”压到一个层。
② composeFetchCacheKey 防 source 标签碰撞 —— 任何带”用户标签 + 资源 ID”的缓存系统都该有这个 30 行的 helper。${label}::${id} 复合键 + LIKE 模式检索,两全其美。
③ CONTEXT_MODE_DATA_DIR 通用存储覆盖 —— CI / Docker / dev container 场景必备。只覆盖自家存储,不碰平台原生 config,这个边界划得很清楚。
④ FloodGuard per-agent-context 限流 —— 多 agent / 多 session 项目必修。单 actor 限流不变,按 agentKey 切桶解决”误伤并发”。
⑤ 7 个 esbuild bundle + assert-asymmetric-drift —— 多 entry point 项目的防漂移手段。改一个文件忘了 rebuild 另一个,CI 立刻报错。
一些观察#
GitHub Trending 但 HN #1 的项目——HN 帖子拿了 570+ points,评论里吵得最凶的是”为什么需要 18 个平台的适配”。我个人看法是:这是 open source 想生存的代价。Claude Code 一个平台能拿 80% 用户,但 20% 的 Cursor / Gemini / Codex 用户被忽视,GitHub issue 第二天就来。context-mode 选择把 18 个平台都做了,代价是 5 个 hook 完整度矩阵里有大量 “Partial” / ”—“,但换来的是任何 AI 编程 agent 用户都能用。这种”不挑食”策略是项目传播率的基础。
MCPorter 风格的 plugin 适配代码非常重——adapters/ 加起来 17K 行(占整个 src 41%)。这种重是合理的,因为平台协议是客观存在的,没法”抽象掉”。但不要在 production code 里”为了优雅”而自己发明协议,老老实实去适配 Anthropic / Google / OpenAI 的标准。
ComposeFetchCacheKey 这种 30 行 helper 比多数 300 行的 class 更有价值——读代码时我被这种”短小精悍、注释完整、解决一个具体问题”的 helper 击中,比看 class AbstractFactoryBuilder<T, U, V> 舒服得多。
参考资料
- mksglu/context-mode GitHub 仓库 ↗
- context-mode npm 包 ↗
- HN #1 讨论 (570+ points) ↗
- 仓库内
CLAUDE.md是 mandatory routing rules(对所有 18 平台通用) - 仓库内
docs/platform-support.md是平台完整度矩阵的来源 - 仓库内
BENCHMARK.md是各工具的实测数字来源