深入解析 MathModelAgent:从 SKILL 到 4-Agent 自动跑完一篇建模论文
💬 评论jihe520/MathModelAgent 是一个开源的数学建模竞赛自动化系统,把建模 / 代码 / 论文拆成 6 个 SKILL + 4 个 Agent,17 套 Typst/LaTeX 模板,9 步自动验收,本地 Jupyter + 云端 E2B 双 Code Interpreter,OpenAlex 文献检索。
全国大学生数学建模竞赛、国赛、美赛、华数杯、华为杯——三天三夜、一篇能提交的论文、一份要跑出来的代码、一摞能用的图表。这件事的痛点二十年来没变过:它从来不是「模型不会建」,而是「时间不够」。
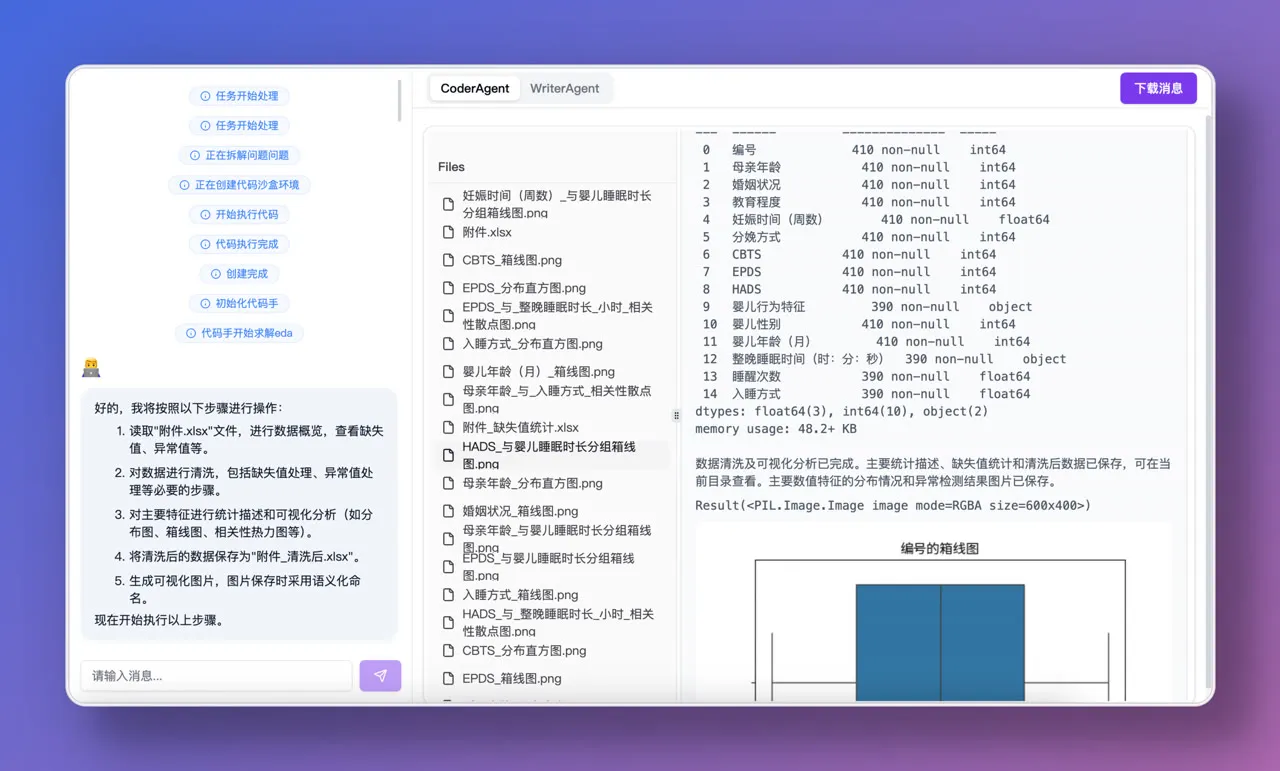
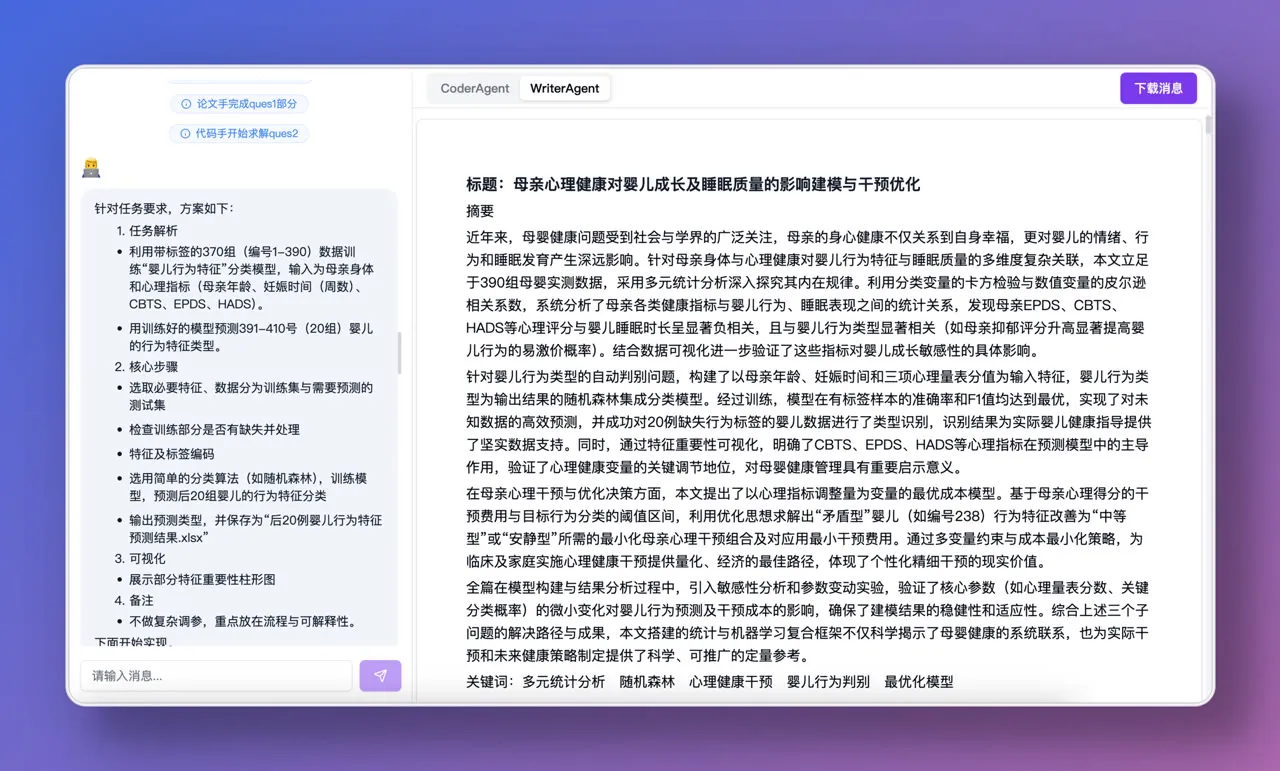
jihe520/MathModelAgent 是一个专门为这件事设计的 Agent 系统。它把整条流水线切成了 6 个可独立调用的 Skill,再由后端的 4 个 Agent 协作执行——你只需要在 Claude Code / Codex 里敲一句 /1start-mathmodel 完成这个建模任务,它会自动跑完分析、建模、编码、绘图、流程图、论文撰写和验收,产出一份可直接提交的 PDF。
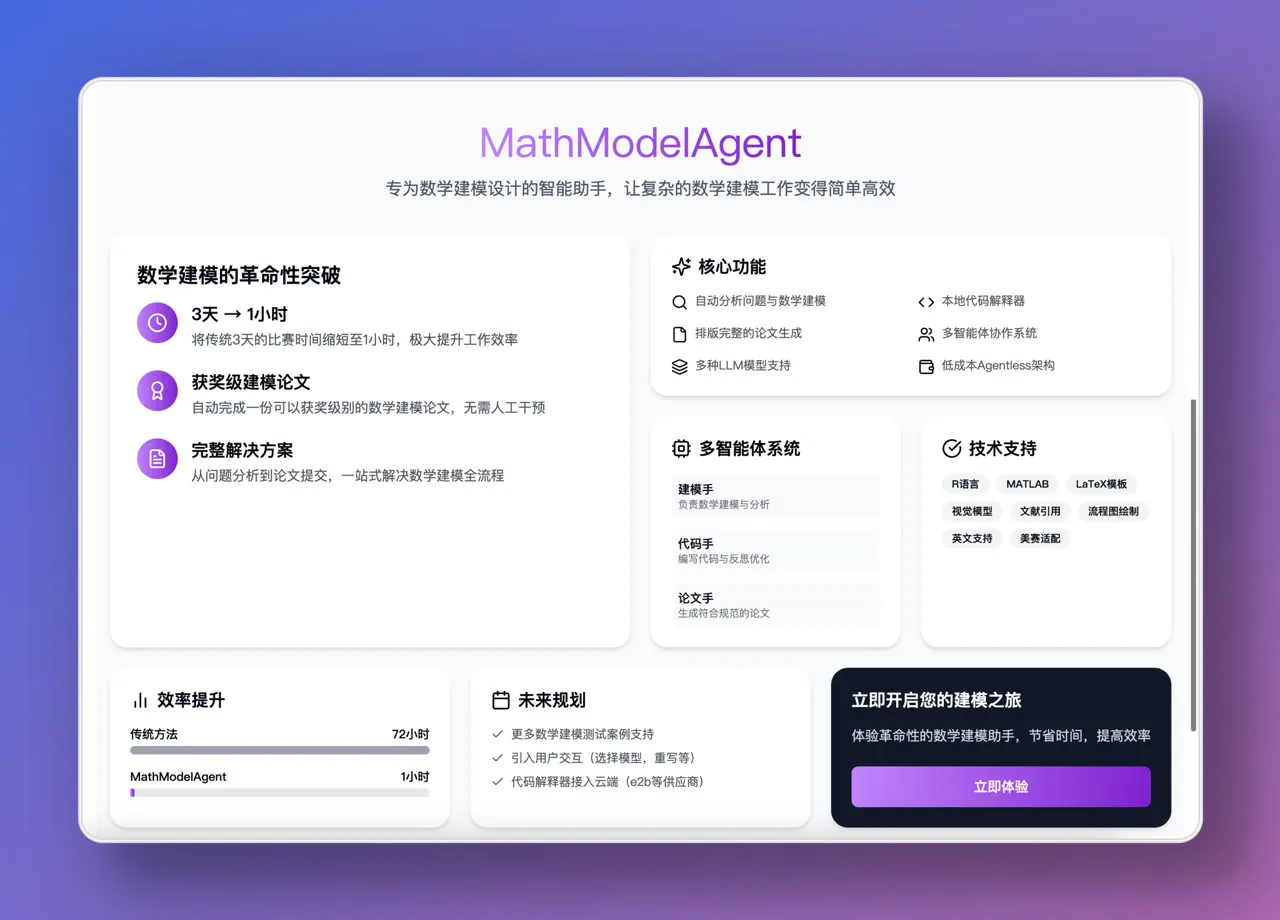
本文是 2026-09-13 这个 41MB / 966 文件 / 6 个 SKILL + 4 个 Agent / 17 套模板 / 9 步验收的项目的一次完整源码级深拆。我会带你看:作者两年前从自研 Agent 框架到完全迁到 Harness+SKILL 的转向、Skill 与 Agent 的边界怎么划、Agent 基类怎么在 token 撑爆前”安全切割”压缩记忆、Coder 怎么反思重试、Writer 怎么调 OpenAlex 搜文献、取消信号怎么贯穿整个异步链,以及一个让 Agent 开发者眼前一亮的工程套路清单。
1. 项目定位与全景#
MathModelAgent 的 README 第一行就立了 Flag:
专为数学建模设计的 Agent,自动完成数学建模,生成一份完整的可以直接提交的论文。
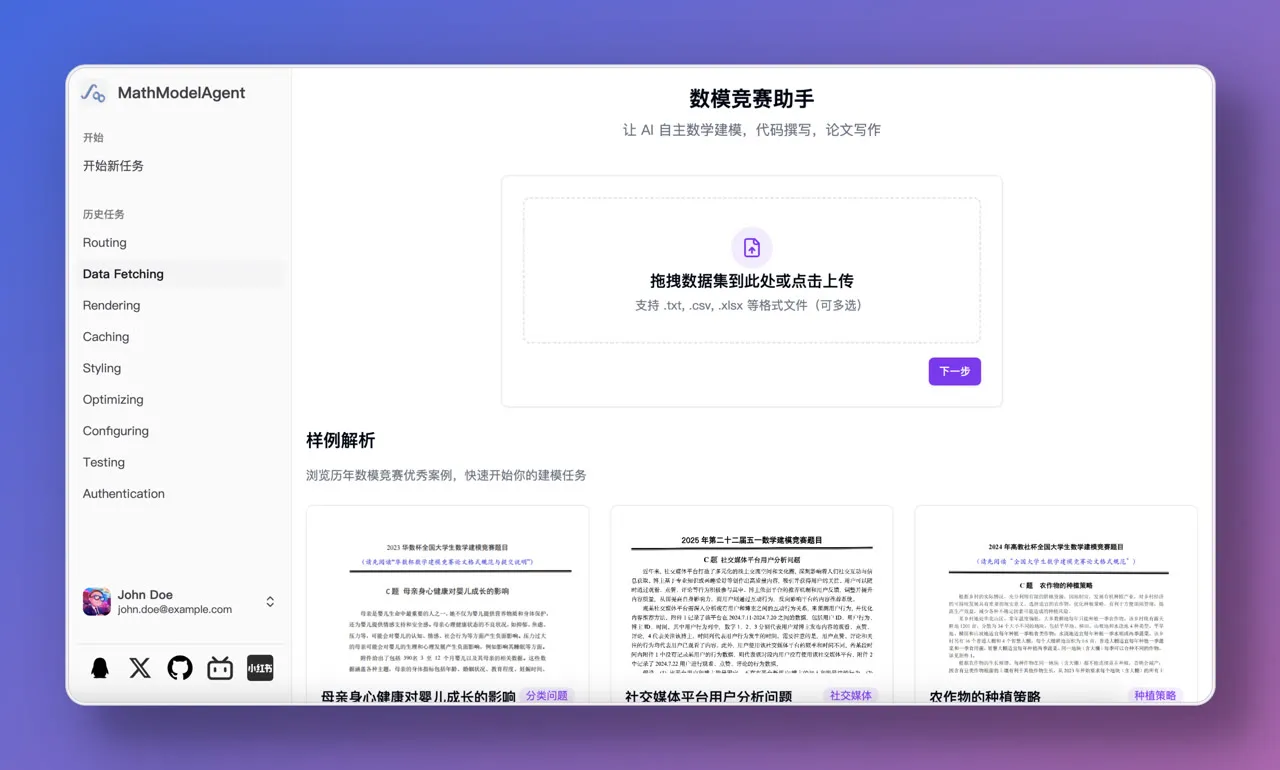
它在 GitHub 上的形态是一组可独立安装的 SKILL 包,通过 npx skills add jihe520/MathModelAgent --all 安装,运行在 Claude Code / Codex / Pi 等任意兼容 AgentSkills 规范的 Harness 上。同时也提供了桌面版(Electron + 内置 Claude Code,macOS 已 Developer ID 签名并通过 Apple 公证,Windows 上线中)和 WebUI(Vue3 + FastAPI + Redis)。
剥掉所有外壳,这个项目做的事情可以收成一句话:把数学建模竞赛的全流程(读题 → 拆题 → 建模 → 写代码 → 跑代码 → 出图 → 写论文 → 验收)切成一组有明确边界、可独立调用的 Skill,后端用 4 个 Agent 协作执行,最终交付一份可提交的论文 PDF。
它给出的特性也是这张流水线的展开:
- 17 套 Typst + LaTeX 双引擎论文模板(国赛 / 美赛 / 华数杯 / 华为杯 / APMCM / MCM / ICM 等)
- 9 步自动验收(文本泄漏检测 → 数值一致性 → 编译 → PDF 可视化)
- 6 种 HIL 决策动作(
confirm / edit / regenerate / ask / skip / abort) - Code Interpreter 双形态:本地 Jupyter(代码存成 notebook 方便再编辑)+ 云端 E2B / Daytona
- multi-llms:每个 Agent 可以单独配置最合适的模型,底层走 LiteLLM 兼容 100+ provider
- Web Search(Tavily) + RAG 知识库(ChromaDB + Rerank,建模方法/代码模板/论文写作参考)
- 多 Agent:Coordinator(协调)/ Modeler(建模)/ Coder(写代码)/ Writer(写论文)
- 四层容错:有限重试 → Fallback Hand Off → Evaluator Shadow Mode → Feedback Rerun
- 多入口:桌面版 / WebUI / CLI(
master分支)/ SKILL(main分支,2026 年的主推形态)
读完这份 README,我最感兴趣的不是某个具体特性,而是作者在 Thinking 段写下的两句话:
两年前,我都是自己实现一套 Agent 框架,现在和以后更多的 Agent 产品直接基于 Harness 如 Codex / Claude Code / Pi + SKILLS 来构建。
项目以后只会做 SKILLS 层的迭代和优化,不会再做其他部分。
这两句话是整个项目最重要的工程信号。MathModelAgent 不是又一个 Agent 框架,它是一个”Harness 之上的 Skill 教材”。作者把整个 Agent 框架里所有可重用的部分(消息协议、Provider 抽象、Tool Call 协议、记忆压缩、取消信号)都内化在了 SKILL 里——你不需要再写一份框架,你只需要在支持 AgentSkills 的 Harness 里加载这套 SKILL。
2. 6 步 SKILL Pipeline:Harness 上的”流程管道”#
整个项目的目录结构是这种形状:
skills/
├── 1start-mathmodel/   # 入口:询问偏好 + 生成 plan.md + 串联各阶段
├── 2analysis-modeling/ # 赛题分析 + 建模设计 → reports/ANALYSIS_MODELING_REPORT.md
├── 3coding-visual/     # 编程实现 + 数据图表 → code/ + figures/*.pdf + RESULTS_REPORT.md
├── 4drawio/            # 非数据图(技术路线图 / 流程图 / 架构图)→ figures/*.drawio + PDF
├── 5writing/           # 撰写论文(双引擎)→ paper/main.typ 或 main.tex
├── 6verity/            # 验收:文本门禁 + 编译 + PDF 检查 → reports/VERIFY_REPORT.md
├── doctor/             # 环境检查
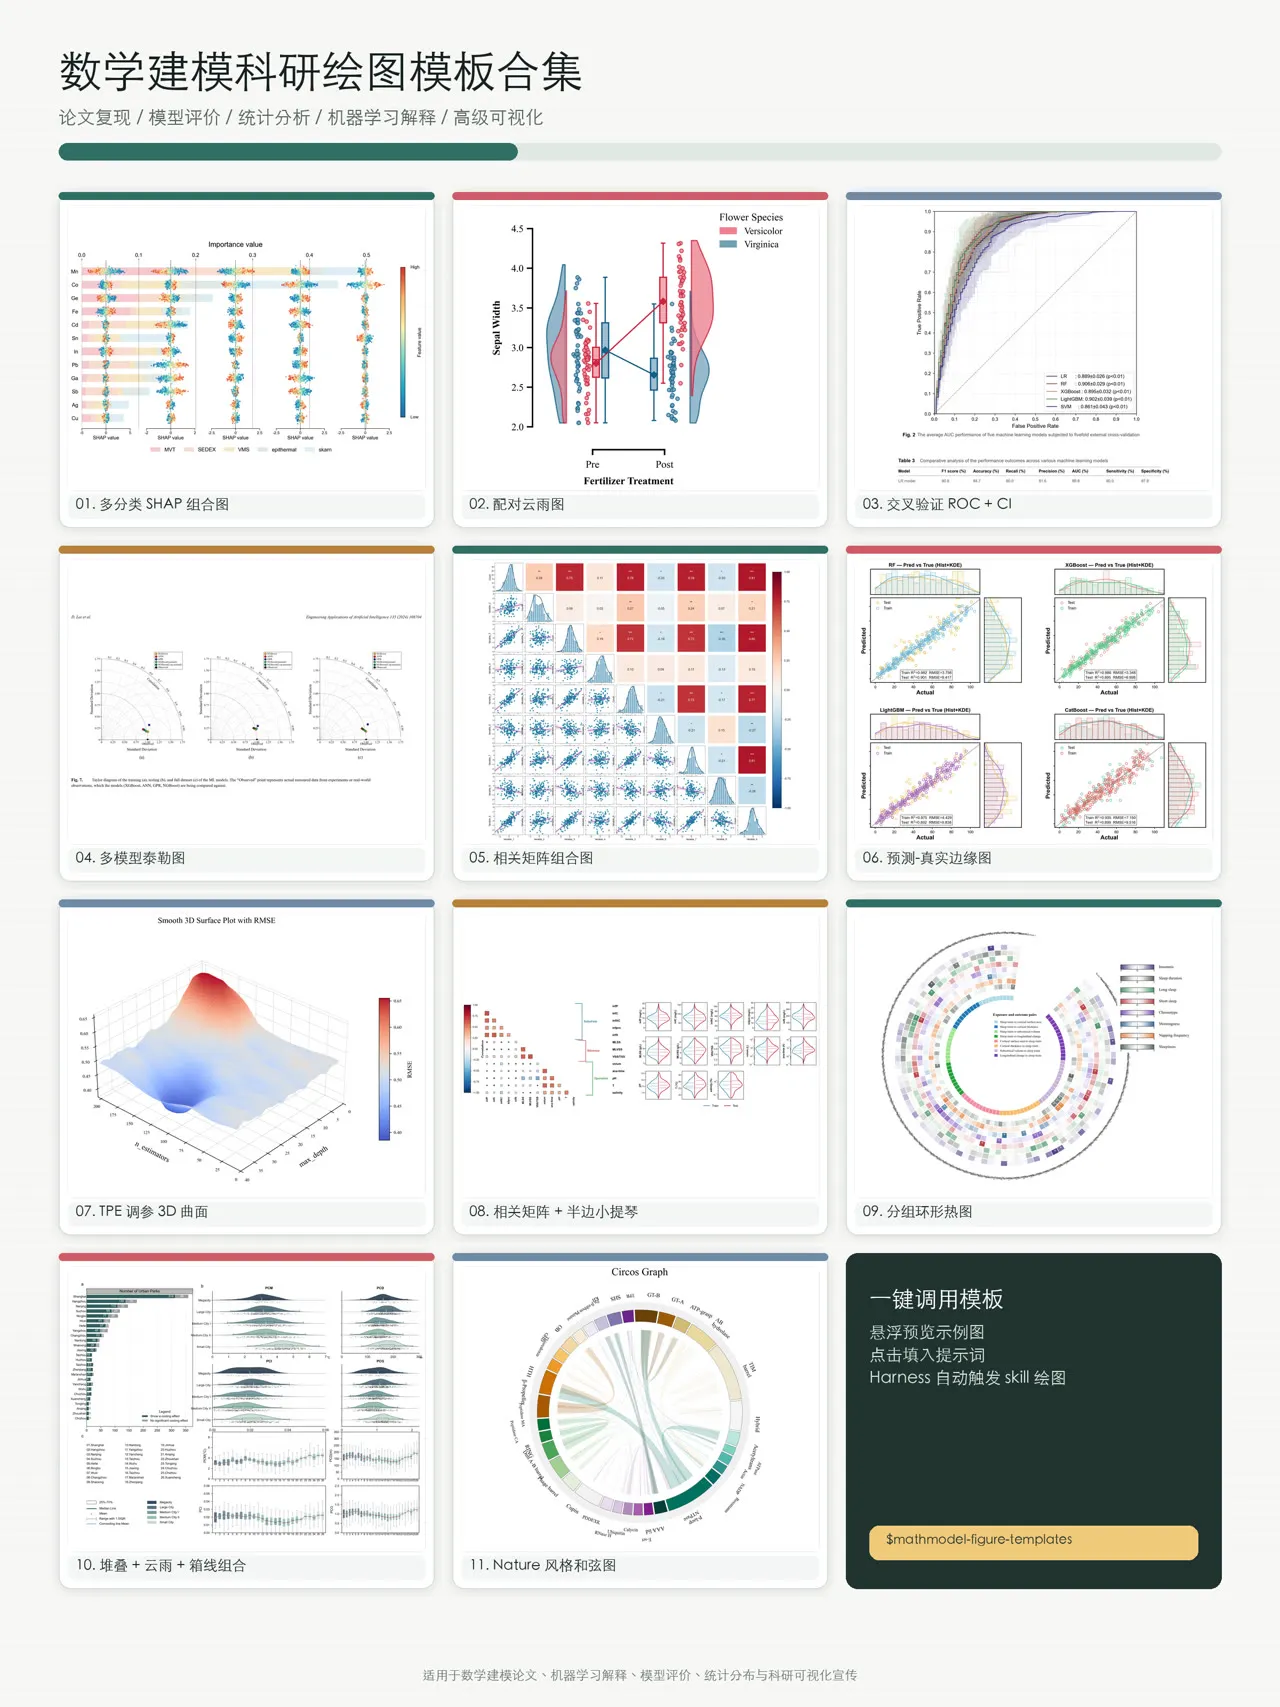
├── mathmodel-figure-templates/  # 科研图表模板(sci-box 姊妹项目)
├── typst-author/       # Typst 知识助手(独立 skill)
└── _references/ # 数学建模规范知识库(只读)每个 Skill 都是一份标准的 agentskills.io ↗ 格式文件——SKILL.md 包含 name / description / allowed-tools,正文写工作流、产出、阶段边界和质量要求。Harness(Claude Code、Codex、Pi)加载后会按 Skill 的 frontmatter 注册为可调用命令,正文按需加载到 LLM 上下文。
Skill 之间不互相 import,只通过文件约定通信——这是它和传统 Python 包最大的区别:
| 阶段 | Skill | 读 | 写 |
|---|---|---|---|
| 1. 入口 | 1start-mathmodel | 用户输入 | plan.md, todo.md |
| 2. 分析 | 2analysis-modeling | plan.md | reports/ANALYSIS_MODELING_REPORT.md |
| 3. 代码 | 3coding-visual | ANALYSIS_MODELING_REPORT.md | code/, figures/*.pdf, RESULTS_REPORT.md |
| 4. 流程图 | 4drawio | 前三份 report | figures/*.drawio, DRAWIO_REPORT.md |
| 5. 论文 | 5writing | 所有 report + figures | paper/main.typ 或 main.tex |
| 6. 验收 | 6verity | 所有产物 | reports/VERIFY_REPORT.md |
这种”文件系统作为 Skill 间 API”的设计有个隐藏好处:你可以在断网的情况下,手动把中间产物修改一下,然后从断点继续跑剩下的 Skill。后端 4 个 Agent 也只是”在 Harness 上实现 Skill 描述的工作流”——它没有跨 Skill 的强耦合逻辑。
2.1 入口 Skill 的”询问与决策”#
1start-mathmodel 这个 Skill 很有意思——它不干活,只问问题:
## 工作流

### 1. 询问用户偏好 AskUserQuestions

在规划前,只询问会实质影响流程的问题。问题要少而关键。

优先询问(按重要性排序):

1. 排版引擎:Typst 还是 LaTeX?
2. 竞赛类型:国赛/华为杯/华中杯/MCM/...
3. 论文语言:中文/英文
4. 子问题数量是否已知

将用户的选择记录到 plan.md 的"方案"小节中。然后根据用户的回答,生成 plan.md 和 todo.md,再依次调用 2 → 3 → 4 → 5 → 6。整个流程在 todo.md 里就是 5 行 checkbox:
# 待办事项
- [ ] 1. 赛题分析与建模设计 - `2analysis-modeling`
- [ ] 2. 编程实现和图表生成 - `3coding-visual`
- [ ] 3. 流程与架构图绘制 - `4drawio`
- [ ] 4. 竞赛论文撰写 - `5writing`
- [ ] 5. 验证和验收 - `6verity`每完成一个阶段,就在对应行打勾。这是一个简单但有效的进度持久化机制——下次 Session 重启时,只要读 todo.md 就能知道当前在哪一步。
3. 后端 4-Agent:角色、Prompt、协作#
后端是基于 FastAPI + Redis + LiteLLM 实现的 4-Agent 协作系统,代码集中在 backend/app/core/ 下,核心 2406 行:
backend/app/core/
├── agents/
│   ├── agent.py             # Agent 基类(302 行):对话历史 / 轮次控制 / 记忆压缩
│   ├── coordinator_agent.py # Coordinator(74 行):意图识别 + 子问题拆解
│   ├── modeler_agent.py     # Modeler(119 行):数学建模
│   ├── coder_agent.py       # Coder(219 行):代码生成与执行 + 反思
│   └── writer_agent.py      # Writer(187 行):论文撰写 + 文献搜索
├── llm/
│   ├── llm.py               # LLM 封装(205 行):多 Provider + 重试 + 工具调用
│   ├── llm_factory.py       # LLMFactory(57 行):按 Agent 类型分配模型
│   ├── providers/           # OpenAI Chat / OpenAI Responses / Anthropic
│   └── types.py             # StandardResponse 统一返回类型
├── prompts/                 # 各 Agent 的系统提示词
├── flows.py                 # 编排逻辑(179 行)
└── workflow.py # 主流程入口(243 行)3.1 工作流入口:workflow.py 的”舞台调度”#
workflow.py 里的 MathModelWorkFlow.execute() 是整个系统的总指挥。打开它,你会看到一个非常清晰的”舞台调度”代码:
async def execute(self, problem: Problem):
    # 1. 预校验 4 个 Agent 的 model 和 api_key 配置,缺一就拒
    # 2. LLMFactory 创建 4 个独立 LLM 实例(每个 Agent 配不同模型)
    # 3. CoordinatorAgent 跑意图识别 + 子问题拆解 → questions dict
    # 4. ModelerAgent 跑数学建模 → 假设 + 目标函数 + 约束 + 求解策略
    # 5. 创建 code_interpreter(local jupyter)+ scholar(OpenAlex 文献)
    # 6. 创建 CoderAgent 和 WriterAgent
    # 7. 进入 solution_flows 循环(每个子问题):Coder 跑 → Writer 写
    # 8. 进入 write_flows 循环(摘要 + 引言 + 结论等):Writer 写
# 9. user_output.save_result() 落盘最关键的是第 6 步:4 个 Agent 在循环外一次性创建好,在循环里复用同一个 chat_history(各自维护)。这意味着 Coder 在写问题 1 代码时积累的对话历史,会作为”上下文”带到问题 2——这是为什么 Coder 能保持前后逻辑一致的根本原因。
而中间每一步都有 await self._check_cancelled(),配合 redis_manager.publish_message(...) 实时把进度推到前端 WebSocket。这是数学建模场景下用户对长任务必须可见可中断的硬需求——24 小时的任务,你不可能等它跑完再看。
3.2 角色拆解:从 Prompt 看”分工”#
4 个 Agent 的系统提示词(backend/app/core/prompts/*.py)决定了它们的实际行为:
- Coordinator(25 行 prompt): 负责”意图识别 + 拆题”。读题面,识别子问题数量,生成结构化的 questions dict——
{"ques1": "...", "ques2": "..."} - Modeler(150 行 prompt): 负责”建立数学模型”。对每个子问题输出 ModelerToCoder,包含假设、变量、目标函数、约束、求解算法、代码实现要点
- Coder(225 行 prompt): 负责”写代码 + 跑代码”。默认使用 LiteLLM 的 tool call 协议调
execute_code工具,在 Jupyter kernel 里执行,有错误就反思重试 - Writer(220 行 prompt): 负责”写论文”。除了写,还负责用
search_papers工具调 OpenAlex 检索真实文献插入引用,以及按章节插入coder_response.created_images返回的图片
这 4 个 Agent 不是”协作完成任务”那种平行关系,而是严格串行的接力——Coordinator 不知道 Modeler 的存在,Modeler 不知道 Coder 的存在,Coder 不知道 Writer 的存在。它们唯一的接口是 UserOutput 这个中间产物:
user_output = UserOutput(work_dir=self.work_dir, ques_count=self.ques_count)
# ...
user_output.set_res(key, writer_response)  # 把每段写好的论文塞进去
# ...
user_output.save_result() # 最终落盘这种”窄接口 + 文件系统即上下文”的设计让 4 个 Agent 完全可以独立替换、独立测试、独立调优——这就是为什么项目能稳定迭代两年。
4. 核心设计 1:Agent 基类的”安全切割”记忆压缩#
这是我读完 backend/app/core/agents/agent.py 后觉得整个项目最值得学的工程细节。302 行的 Agent 基类,核心就解决一个问题:当对话历史撑爆上下文窗口时,怎么压缩,才不会破坏 tool call 序列的完整性?
OpenAI / Anthropic 的对话 API 有个铁律:如果你想让 role=tool 的消息作为某个 assistant 调用的结果出现,那条 assistant 消息里必须有对应的 tool_calls 字段,反之亦然。换句话说,对话历史里的 tool 消息和它的 tool_call 必须是连续的。随便从中间切一刀,API 就会报 messages: tool_calls ids didn't match 错误。
很多 Agent 框架的做法是”无脑丢老消息”——先把最早的系统消息留住,然后从前往后丢到 token 阈值以内。但 MathModelAgent 用了更精细的策略。
4.1 三段式压缩:compress_if_needed#
async def compress_if_needed(self) -> None:
    threshold = int(self.context_window * self.token_threshold_ratio)  # 默认 75%
    if self.current_token_count <= threshold:
        return

    # 1. 保留第一条系统消息(永远不能丢)
    system_msg = self.chat_history[0] if self.chat_history[0]["role"] == "system" else None

    # 2. 找到"安全切割点":保证切割点之后的对话里没有孤立的 tool 消息
    preserve_start_idx = self._find_safe_preserve_point()

    # 3. 切割点之前的对话用 LLM 总结成一条"历史对话总结",塞回去
    start_idx = 1 if system_msg else 0
    end_idx = preserve_start_idx

    # 4. 拼回去:system + 总结 + 切割点之后的消息
    new_history = [system_msg] + [summary_msg] + self.chat_history[preserve_start_idx:]
self.chat_history = new_history_find_safe_preserve_point 是关键。它从后往前扫描,找到最后一个”从此处切下去,后面的消息里没有孤立 tool”的位置:
def _find_safe_preserve_point(self) -> int:
    min_preserve = min(3, len(self.chat_history))
    preserve_start = len(self.chat_history) - min_preserve

    for i in range(preserve_start, -1, -1):
        if self._is_safe_cut_point(i):
            return i
return len(self.chat_history) - 1 # 兜底:至少保留最后一条_is_safe_cut_point 检查从 i 开始的所有消息,如果遇到 role=tool 的消息,就向前找对应的 tool_call_id 在 start_idx 之前出现过——没有就说明是孤儿,这个切点不安全,继续往前找。
4.2 三段兜底:失败也不让对话崩坏#
LLM 总结本身可能失败(网络/限流/超长 prompt),所以 Agent 基类还设计了三层 fallback:
- 首选:用 LLM 总结历史
- 次选:
_get_safe_fallback_history—— 不总结,只保留 system + 最后 N 条非 tool 消息(从后往前找,直到切点安全为止) - 最差:只保留最后一条非 tool 消息(对话退化,但 API 不会报错)
这种**“LLM 总结失败也不让对话结构破坏”** 的设计,是 Agent 在生产环境长期跑 24 小时任务最关键的鲁棒性——你的代码必须保证 LLM 怎么抽风,对话历史都不会让下一次 API 调用直接 400。
4.3 取消信号:asyncio.wait 的 FIRST_COMPLETED 套路#
Agent 基类还埋了一个不起眼但极其重要的细节:_chat 方法的可中断等待。
async def _chat(self, **kwargs) -> Any:
    if not self.cancel_event:
        return await self.model.chat(**kwargs)

    chat_task = asyncio.create_task(self.model.chat(**kwargs))
    cancel_wait_task = asyncio.create_task(self.cancel_event.wait())
    done, pending = await asyncio.wait(
        {chat_task, cancel_wait_task},
        return_when=asyncio.FIRST_COMPLETED,
    )
    if cancel_wait_task in done:
        chat_task.cancel()
        for p in pending:
            p.cancel()
        raise asyncio.CancelledError("任务被用户停止")
return await chat_taskasyncio.wait(... FIRST_COMPLETED) 会在两个任务任一完成时立即返回——只要 cancel_event 一 set,正在跑的 LLM 调用就会被立刻取消,而不是等它跑完再判断。这对前端”停止按钮”的体验至关重要:用户点停止,1 秒内整个工作流停掉,而不是等 Claude 把当前 token 吐完再退出(可能 30 秒)。
这种”取消语义贯穿 chat / agent / workflow 三层”的设计,是 Agent 长任务 UI 体验的分水岭。
5. 核心设计 2:Coder 的反思重试 + Writer 的文献 tool call#
5.1 Coder:execute_code + 反思 prompt#
Coder Agent 的核心循环非常清晰——生成代码 → 调 execute_code 工具在 Jupyter kernel 里执行 → 拿到执行结果 → 如果报错,生成反思 prompt → 重新调用 LLM 让它改代码 → 直到跑通。
while True:
    if retry_count >= max_retries:
        return CoderToWriter(code_response=f"任务失败,超过最大尝试次数{max_retries}, 最后错误信息: {last_error_message}", created_images=[])

    response = await self._chat(history=..., tools=coder_tools, tool_choice="auto")

    if response.tool_calls:
        tool_call = response.tool_calls[0]
        if tool_call.name == "execute_code":
            code = json.loads(tool_call.arguments)["code"]
            text_to_gpt, error_occurred, error_message = await self.code_interpreter.execute_code(code)

            if error_occurred:
                # 把错误信息塞回去,加一句"反思 prompt"让 LLM 自我纠正
                await self.append_chat_history({"role": "tool", "tool_call_id": tool_id, "name": "execute_code", "content": error_message})
                retry_count += 1
                reflection_prompt = get_reflection_prompt(error_message, code)
                await self.append_chat_history({"role": "user", "content": reflection_prompt})
                continue
            else:
                # 成功了也继续循环,等待下一步指令(LLM 会再调一次 execute_code 或说"完成了")
                await self.append_chat_history({"role": "tool", "tool_call_id": tool_id, "name": "execute_code", "content": text_to_gpt})
                continue
    else:
        # 没有 tool_call = LLM 觉得任务完成 → 返回结果
return CoderToWriter(code_response=response.content, created_images=await self.code_interpreter.get_created_images(subtask_title))两个细节值得拎出来:
第一,没有用”循环调 LLM → 让它自己决定 retry”,而是把”是否 retry”这个决策显式写在 Python 代码里。LLM 只负责”反思”——是否继续交给 retry_count 计数器和 max_retries 边界控制。这避免了一个常见坑:LLM 在反思 prompt 里”自信地说”已修复但其实没修,导致循环跑空。
第二,成功路径不 return,而是 continue——让 LLM 决定是否还有下一步。这给了 LLM 自主决定”这个子问题是否已经做完”的灵活性(比如画完图之后还要不要算下统计指标),但又通过 current_chat_turns 做了硬边界保护:
if self.max_chat_turns is not None and self.current_chat_turns >= self.max_chat_turns:
raise Exception(f"Reached maximum number of chat turns ({self.max_chat_turns}). Task incomplete.")max_retries(反思次数)和 max_chat_turns(总对话次数)两个独立计数器,前者管错误恢复,后者管总消耗。这是”任务级 budget”和”操作级 budget”分离的标准做法。
5.2 Writer:Anthropic/OpenAI 双 tools + search_papers#
WriterAgent 比 Coder 更复杂——它需要写论文,还要搜文献,所以有两套 tool:
api_type = self.model.api_type
tools = writer_tools_anthropic if api_type == ApiType.ANTHROPIC else writer_toolsAnthropic 的 tool use 协议(2024 年 11 月起)和 OpenAI 不完全一致:Anthropic 用 input_schema,OpenAI 用 parameters。所以同一份 tool 描述要在两边各写一份。这个细节暴露了一个事实:LiteLLM 帮你屏蔽了 chat 协议,但 tool call schema 还是要自己分版本。
search_papers 是 WriterAgent 最关键的 tool——它在写某个章节前会先调一下,拿到真实文献:
if response.tool_calls and response.tool_calls[0].name == "search_papers":
    query = json.loads(response.tool_calls[0].arguments)["query"]
    papers = await self.scholar.search_papers(query)  # OpenAlex
    papers_str = self.scholar.papers_to_str(papers)
    await self.append_chat_history({"role": "tool", "tool_call_id": tool_id, "name": "search_papers", "content": papers_str})

    # 再调一次 LLM,把文献塞进上下文,让它继续写
    next_response = await self._chat(history=self.chat_history, tools=tools, tool_choice="auto")
response_content = next_response.content or ""注意这里有个特别细节:Writer 在 tool_call 拿到文献后必须再调一次 LLM,因为第一轮 LLM 只产出了 tool_call 还没写正文。这是 tool call 协议的标准模式——但很多 Agent 实现者在第一轮拿到 tool_call 后就直接 return,导致后续 LLM 没机会看到 tool 结果。MathModelAgent 这里处理得很干净。
5.3 OpenAlex 替代 Tavily:开源学术搜索的务实选择#
README 里有一行 TODO 注释很扎眼:
<!-- NOTE: 原计划 Tavily API 未实现,当前使用 OpenAlex 替代 -->
- [ ] web search tool: Tavily API 搜索互联网获取真实数据backend/app/tools/openalex_scholar.py 实现了一个对 OpenAlex ↗(一个开源的学术元数据索引)的薄封装——它免费、无 API Key 也能用,有 Key 的话能拿到更高的 rate limit。对于数学建模这种”找真实文献”的需求,OpenAlex 比 Tavily 更专业(Tavily 是通用 Web 搜索)。
这是工程上很务实的一次”原型替换”——Tavily 适合搜”今年 iPhone 销量”,OpenAlex 适合搜”ARIMA 在能源预测里的应用”。
6. 核心设计 3:多 Provider 抽象 + Code Interpreter 双形态#
6.1 LLM Provider 抽象:同一接口三种协议#
backend/app/core/llm/providers/ 实现了三种 LLM 协议适配:
OpenAIChatProvider:经典的/v1/chat/completions(兼容 100+ provider)OpenAIResponsesProvider:新的/v1/responses(支持 reasoning_content、tool_calls 结构不同)AnthropicProvider:Anthropic Messages API(input_schema 风格)
抽象接口是 BaseProvider.call(messages, model, api_key, base_url, tools, tool_choice, max_tokens, top_p) -> StandardResponse。返回的 StandardResponse 把三种协议的差异抹平:
@dataclass
class StandardResponse:
    content: str | None           # 文本回复
    reasoning_content: str | None # 思考过程(DeepSeek / o1)
    tool_calls: list[ToolCall]    # 工具调用
usage: Usage # token 用量切换 Provider 只用改 LLMFactory 里的配置——Coder 想用 GPT-4o,Writer 想用 Claude Sonnet 4.5,Coordinator 想用 DeepSeek,Modeler 想用 GLM,这些都靠 api_type 字段分派。这种设计在 2024 年底到 2025 年很常见(参考 Pi Agent Harness ↗ 的 pi-ai 同样模式),但 MathModelAgent 在 SKILL 框架下做到了”换 Provider 不换 Skill”。
6.2 Code Interpreter 双形态:本地 Jupyter + 云端 E2B/Daytona#
代码执行是个有状态的活——不是简单的 subprocess.run(),它需要变量持久化、状态连续、能把图存到指定目录。backend/app/tools/ 里的代码解释器设计成了抽象工厂:
code_interpreter = await create_interpreter(
    kind="local",          # 或 "e2b" / "daytona"
    task_id=self.task_id,
    work_dir=self.work_dir,
    notebook_serializer=notebook_serializer,
    timeout=3000,
)- local:基于本地 Jupyter kernel,代码块逐步执行,执行历史存成
.ipynb文件方便用户再编辑 - e2b:E2B 云端 sandbox,适合需要更强算力或隔离环境的场景
- daytona:Daytona 沙盒,同上
这种”本地 + 云端 sandbox 双形态”的模式,在 2025 年的 Agent 产品里几乎是标配(E2B 早期投资人里就有 LangChain 的 Harrison Chase)。它解决的是”代码执行不能污染本机环境”这个生产环境核心问题——Agent 跑用户代码,99% 时间没事,但那 1% 的 rm -rf / 足以搞挂生产。
6.3 Redis + WebSocket:实时进度推送#
整个系统用 Redis 做两件事:任务状态持久化 + 进度广播。redis_manager.publish_message(task_id, SystemMessage(content="建模手开始建模ing...")) 这类调用在工作流里到处都是,WebSocket 路由(/ws/task_id)订阅同一 channel 推到前端 Vue。
这套”Redis pub/sub + WebSocket 桥接”的模式是 FastAPI 长任务可视化的标准答案。优点是水平扩展友好(加 Redis cluster 就行),缺点是断线后会丢消息——所以前端还要靠 GET /api/task/{id}/history 拉一次快照补齐。
7. 求解 + 写作的”二阶段编排”:flows.py 里的 9 段式结构#
backend/app/core/flows.py 是工作流的”细节编排”,把整个论文产出分成两段:
求解段(get_solution_flows)——按固定顺序产出 EDA + 每个子问题 + 灵敏度分析:
def set_flows(self, ques_count: int):
    seq = [
        "firstPage",            # 首页信息
        "RepeatQues",           # 问题重述
        "analysisQues",         # 问题分析
        "modelAssumption",      # 模型假设
        "symbol",               # 符号说明
        "eda",                  # 探索性数据分析
        *ques_str,              # ques1, ques2, ques3, ...
        "sensitivity_analysis", # 灵敏度分析
        "judge",                # 模型评价
    ]
self.flows = {key: {} for key in seq}求解段的每一项都通过 coder_agent.run(prompt=...) + writer_agent.run(writer_prompt) 双 Agent 串行执行——Coder 先跑出代码和图,Writer 基于结果写这一段的论文。
写作段(get_write_flows)——在求解段之后,补上摘要、结论、参考文献、附录等不需要重新跑代码的部分,只用 Writer Agent。
write_flows = flows.get_write_flows(user_output, config_template, problem.ques_all)
for key, value in write_flows.items():
    writer_response = await writer_agent.run(prompt=value, sub_title=key)
user_output.set_res(key, writer_response)这种”先求解后写作”的拆法有个隐藏好处:用户在跑完求解段之后,可以中途修改 coder 的代码或结果,只重跑写作段,不必从拆题重来。WebUI 正是靠这个机制实现”HIL 编辑”决策——用户在 Coder 跑出问题 1 后,觉得问题 2 的图不好看,可以直接编辑图片重新生成,只让 Writer 重写相关段落。
整个编排没有用任何工作流框架(Airflow / Temporal / Prefect),纯 Python async 循环。对一个 24 小时内的任务来说,这是过度工程化的反义词——简单可调试,作者在 README 里有句很坦诚的话:
💰 成本低:workflow agentless,不依赖 agent 框架
这话解释了为什么整个项目能稳定两年——没有框架升级带来的破坏性变更。
8. Typst + LaTeX 双引擎:17 套模板的工程化#
5writing Skill 里有一行很关键的约定:
撰写论文前必须让用户选择排版引擎。引擎决定后续所有步骤(模板路径、章节文件扩展名、图片插入语法、编译命令),选错会导致整篇论文格式错误。
两个引擎的”路径选择”硬约定:
Typst  → templates/<lang>/<竞赛>/main.typ          编译命令 typst compile main.typ
LaTeX → templates/<lang>/<竞赛>-latex/main.tex 编译命令 xelatex -interaction=nonstopmode main.tex(跑两次)支持的竞赛模板(Typst + LaTeX 双版本全覆盖):
- 中文:apmcm, changsanjiao, cumcm(国赛), diangongbei, dongsansheng, huashubei(华数杯), huaweibei(华为杯), huazhongbei(华中杯), mathorcup, mcm, shuweibei, stats, wuyibei(五一杯)
- 英文:apmcm, default, mcm(美赛)
华为杯/华中杯/五一杯这些名字容易混,项目用统一别名 huaweibei / huazhongbei / wuyibei 收口。
而图片插入语法也要按引擎切换——Typst:
#figure(image("../../figures/xxx.pdf", width: 85%), caption: [...])LaTeX:
\begin{figure}[H]
\centering
\includegraphics[width=0.85\textwidth]{../../figures/xxx.pdf}
\caption{...}\label{fig:xxx}
\end{figure}这套”双引擎双模板”的工作量很大,但回报也很大——2024 年起 Typst 崛起,很多选手想换 Typst 不想用 LaTeX,但模板生态跟不上。MathModelAgent 直接给你 17 套现成的两种格式,这种”工程红利”在 GitHub 上很难找。
9. 9 步验收 + 6 种 HIL 决策:Agent 不孤军#
9.1 6verity 的 9 步自动验收#
最后一道 Skill 6verity 的存在让整个系统闭环。它的入口脚本 skills/6verity/scripts/writing_check.sh 按引擎自动选择检查逻辑:
bash "$SCRIPT_PATH" \
  --paper-dir "$PAPER_DIR" \
  --main "$MAIN_FILE" \
  --sections-dir "$SECTIONS_DIR" \
  --references "$REFERENCES_FILE" \
  --figures-dir "$FIGURES_DIR" \
  --results-file "$RESULTS_FILE" \
  --problem-analysis "$PROBLEM_ANALYSIS_FILE" \
  --all-results "$ALL_RESULTS_FILE" \
| tee _tmp/writing_check.log脚本只扫描文本,不重跑实验、不编译 PDF。它的检查覆盖:
- 章节数量和标题顺序(include 顺序 vs 文件名前缀)
- 文本泄漏检测(占位符、内部文件路径)
- 图表引用完整性(文中提到的图是否存在)
- 数值一致性(
RESULTS_REPORT.md里的数字 vs 论文里的数字) - Typst/LaTeX 编译(
typst compile/xelatex跑两遍) - PDF 可视化检查(
pdfinfo验证页数正常) - 参考文献格式
- 代码可复现性(
code/目录能否重新运行) - 提交清单(题目要求的所有材料是否齐全)
9.2 HIL 人机协同:6 种决策动作#
README 里有一个未完成的功能值得展开:
- [ ] human in loop (HIL): 关键节点暂停等待用户审批,支持 6 种决策动作
  <!-- TODO: 数据模型已实现,但工作流集成未完成 -->
(confirm / edit / regenerate / ask / skip / abort)这套设计非常合理:让用户在关键节点(比如 Coder 跑出问题 1 后)暂停,做 6 种决策:
- confirm: 接受当前结果,继续下一步
- edit: 编辑当前产物(改图、改代码段),再继续
- regenerate: 整个重新跑这一步
- ask: 反问 LLM 一个具体问题,拿到答案再决定
- skip: 跳过这一步(比如灵敏度分析不写了)
- abort: 整个任务终止
这是 Agent 走向生产的关键设计——纯自动跑下来,用户很难放心;但全程每步都让用户确认又太累。只在”关键节点”做 HIL 是工程上的甜区。目前数据模型实现了(schemas/A2A.py 里的 WriterResponse、CoderToWriter),但工作流里还没接——这是 README 标注的 TODO。
10. 四层容错:渐进式降级#
README 列出的容错体系:
🛡️ 四层容错:有限重试 → Fallback Hand Off → Evaluator Shadow Mode → Feedback Rerun
| 层 | 做什么 | 代码在哪 |
|---|---|---|
| 1. 有限重试 | 单次 LLM 调用失败,指数退避重试 | LLM.chat(max_retries=...) |
| 2. Fallback Hand Off | 主模型失败自动切备用模型 | LLMFactory 配置 |
| 3. Evaluator Shadow Mode | 后台跑第二个模型评分,不阻塞主流程 | TODO |
| 4. Feedback Rerun | 评估器打分低 → 把反馈注入 prompt 重跑 | TODO |
注意第 3、4 层都是 TODO——README 列出来了但没实现。这和 Pi Agent Harness 的”早期就上 Pi-ai 多 provider + 后期才做 evaluation”是同一种节奏:先把骨架打通,再补鲁棒性。但这里把”四层容错”明明白白写在 README 里,是一种对用户的预期管理——告诉用户”我知道现在不完美,但这是路线图”。
11. 数据流图与可视化:从一张图看完整流水线#
把前面所有内容浓缩成一张图,就是 MathModelAgent 的本质:
┌─────────────────────────────────────────────────────────────┐
│                    6 SKILL Pipeline                          │
│                                                             │
│  /1start-mathmodel → /2analysis-modeling → /3coding-visual │
│         ↓                  ↓                  ↓            │
│  plan.md + todo.md   ANALYSIS_REPORT.md   code/ + figures/  │
│                                            + RESULTS_REPORT  │
│         ↓                  ↓                  ↓            │
│  /4drawio → /5writing → /6verity                            │
│     ↓           ↓          ↓                               │
│  .drawio    paper/main   VERIFY_REPORT                      │
│  + PDF      .typ/.tex    + 提交清单                         │
└─────────────────────────────────────────────────────────────┘
                            ↓
                  由 4 Agent 协作执行
                  ┌───────────────┐
                  │ Coordinator   │ → questions dict
                  │ Modeler       │ → 假设/目标/约束/求解
                  │ Coder         │ → 代码 + execute_code 反思
                  │ Writer        │ → 论文 + search_papers
                  └───────────────┘
                            ↓
                  Redis + WebSocket 实时进度
                            ↓
Vue3 WebUI / 桌面版 / CLI这张图就是 6 个 SKILL、4 个 Agent、3 层可视化入口的完整映射。中间产物(plan / report / paper)全部是文件系统里的 Markdown 或 PDF,没有任何内部状态藏在数据库里——这就是**“开源 + 可调试 + 可接力”** 的本质。
12. 文档、UI 与可观察性:工程化的最后一公里#
12.1 WebUI:Vue3 + Pinia + shadcn-vue + WebSocket#
前端是个标准的现代 Vue3 工程:
- 状态管理:Pinia stores(对话历史、任务状态、用户配置)
- UI 库:shadcn-vue(
components/ui/不要修改,这是 shadcn-vue 生成代码) - WebSocket 客户端:
utils/websocket.ts订阅 Redis 推送的进度消息 - 页面结构:
pages/chat/(对话交互)、pages/task/(任务进度)、pages/example/(历史案例)、pages/login/
12.2 desktop 版:Electron + 内置 Claude Code#
README 顶部就推桌面版:
桌面版已内置 Claude Code 与全套 MathModelAgent SKILLS,无需安装 Python / Node.js / Redis,也无需手动配置 SKILL,装好填一个模型 API Key 即可开始建模。
桌面版把后端 + 前端 + Claude Code 全打包进去,用户不需要懂环境配置。macOS 版还做了 Developer ID 签名 + Apple 公证。Windows 版因为代码签名证书没搞定,所以会有 SmartScreen 提示——README 里特意教了”更多信息 → 仍要运行”。
这套”桌面版优先 + 开源版次之”的策略,说明作者的核心用户群是参赛学生——他们没时间配环境,装了就能用最重要。
12.3 CLAUDE.md:把 AI 编程 Agent 当成协作者#
仓库根的 CLAUDE.md 写得很细——这不是写给人类看的,是写给 Claude Code 自己看的:
## Commands
### 后端
uv sync
ENV=DEV uvicorn app.main:app --host 0.0.0.0 --port 8000 --ws-ping-interval 60 --ws-ping-timeout 120 --reload

### 前端
pnpm i && pnpm run dev && pnpm run build

## Code Style
- 模块级、类级、公共方法均使用 Google 风格 docstring
- 类型注解:使用 `str | None` 而非 `Optional[str]`
- 异步:全程 async/await
- 注释:中文,解释 WHY 而非 WHAT

## Boundaries
### 不要修改的内容
- frontend/src/components/ui/ — shadcn-vue 第三方 UI 库组件
- 已有的 # type: ignore 注释 — 这些是经过验证的类型抑制
- .env 相关文件中的实际配置值这套”AI 编程协作者”的指令清单(命令、代码风格、边界)在 2025 年越来越常见——把 AI 当成团队成员,就要像 onboarding 新人一样给它写文档。MathModelAgent 在这一点上做得很完整,甚至还配了一个 .claude/hook_lint.sh 做 Edit/Write 后自动 ruff + biome 检查。
13. 可复用的工程套路清单#
读完全部源码,我自己提炼了一份”给 Agent 开发者的可复用套路清单”,每条都能直接搬到别的项目:
13.1 SKILL 取代 Harness:“Skill 是文件,不是 import”#
不要在 Python 里 import 别的 Skill,而是让 Skill 通过文件系统通信。这让 Skill 可以独立版本化、独立替换、独立测试——你可以把某段 Skill 完全重写,只要文件格式不变,别的 Skill 不受影响。
13.2 Skill 间 API 用”约定文件”#
不要用 RPC、不要用消息队列,直接用 Markdown 文件:
| 写 | 读 |
|---|---|
plan.md | 1start-mathmodel → 2analysis-modeling |
ANALYSIS_MODELING_REPORT.md | 2analysis-modeling → 3coding-visual |
RESULTS_REPORT.md | 3coding-visual → 5writing |
figures/*.pdf | 3coding-visual / 4drawio → 5writing |
VERIFY_REPORT.md | 6verity → 用户 |
文件系统即 Skill API,这条规则比任何抽象都稳。
13.3 Agent 基类必备 3 件事#
每个写 Agent 框架的人都应该有的 3 件事:
- 记忆压缩的安全切割:不要无脑丢老消息,要保证 tool_call 序列不切断
- 取消信号的可中断等待:
asyncio.wait(FIRST_COMPLETED)双任务模式 - 失败兜底的三段降级:LLM 总结失败 → 安全 fallback → 只保留最后一条非 tool 消息
13.4 Coder Agent 的”反思+重试”硬边界#
if retry_count >= max_retries: return error_response  # 操作级 budget
if current_chat_turns >= max_chat_turns: raise # 任务级 budgetLLM 只负责反思,Python 代码控制是否 retry——避免 LLM 在反思 prompt 里”自信地说”已修复但其实没修,导致循环跑空。
13.5 Tool Call 协议要分 Provider#
Anthropic 用 input_schema,OpenAI 用 parameters,新 Responses API 又不一样——不要指望 LiteLLM 帮你处理 tool schema 差异。把 tools 按 Provider 类型分开,代码会清晰很多:
tools = writer_tools_anthropic if api_type == ApiType.ANTHROPIC else writer_tools13.6 多 Provider 抽象的关键是返回类型统一#
不管协议怎么变,你的 Agent 代码只面对一种返回:
StandardResponse(content, reasoning_content, tool_calls, usage)这是 Pi-ai 和 MathModelAgent 都用的同一招,返回类型统一比调用统一更重要——LLM 的输入可以随 Provider 变,但 Agent 的输入永远是这一个 shape。
13.7 Code Interpreter 一定要”本地 + 云端 sandbox”#
永远不要 subprocess.run(user_code)。本地 Jupyter kernel + 云端 E2B/Daytona 双形态是 2025 年的标准答案。99% 的时间没事,1% 的 rm -rf / 足以搞挂生产。
13.8 WebUI 实时进度:Redis pub/sub + WebSocket 桥接#
FastAPI 长任务的标准答案。redis_manager.publish_message(task_id, message) 在工作流里到处调,WebSocket 路由订阅同一 channel 推到前端 Vue3。
13.9 HIL 决策动作做成”数据模型 + TODO”#
把 HIL 6 种决策(confirm / edit / regenerate / ask / skip / abort)做成数据模型(在 schemas/A2A.py),但工作流暂时不接——先把 schema 定下来,后面慢慢接 UI。这种”先定协议,后定集成”的节奏,可以避免大改。
13.10 README 的 TODO 注释是”用户预期管理”#
- [ ] web search tool: Tavily API 搜索互联网获取真实数据
<!-- NOTE: 原计划 Tavily API 未实现,当前使用 OpenAlex 替代 -->把”未实现”明明白白写出来,比假装实现了更好。这让用户对项目状态有真实预期,不会以为你是骗子。
14. 已知短板与未完成项#
源码级深拆就要诚实。下面这些都是 README 或代码里明确标记的 TODO,未来这个项目能不能从”工具”走向”产品”,就靠这些:
| 状态 | 模块 | 备注 |
|---|---|---|
| ✅ | 6 步 SKILL pipeline | 完整可用 |
| ✅ | 4 Agent 协作 | Coordinator / Modeler / Coder / Writer 全部实现 |
| ✅ | Code Interpreter 双形态 | local Jupyter + 云端 E2B/Daytona |
| ✅ | LLM 多 Provider | OpenAI Chat / Responses / Anthropic 三套 |
| ✅ | Typst + LaTeX 双引擎 | 17 套模板双版本 |
| ✅ | OpenAlex 文献检索 | 替代原计划的 Tavily |
| ✅ | 9 步自动验收 | writing_check.sh + Typst/LaTeX 编译 |
| ✅ | 取消信号贯穿 | asyncio.Event + asyncio.wait |
| ✅ | Agent 记忆压缩的安全切割 | _find_safe_preserve_point 三段兜底 |
| ⚠️ | HIL 6 决策 | 数据模型已实现,工作流未接 |
| ⚠️ | Evaluator Shadow Mode | 仅 Agent 基类里有 TODO |
| ⚠️ | Feedback Rerun | Writer 后 Coder 的反馈注入未实现 |
| ⚠️ | RAG 知识库 | 配置项存在,核心检索逻辑未实现 |
| ⚠️ | Fallback Hand Off | 基础重试机制已有,自动切备用模型未实现 |
| ⚠️ | 英文支持(美赛) | 模板已就绪,Skill 描述未英化 |
| ❌ | 多语言 R / MATLAB | README 列了未做 |
| ❌ | Benchmark | README 列了未做 |
最关键的 3 个未完成项:
- HIL 工作流集成——这是让 Agent 从”工具”走向”协作伙伴”的关键。数据模型已实现(
schemas/A2A.py),只差把 pause/resume 接到 workflow 的关键节点上。 - RAG 知识库检索逻辑——
docs/md/网络环境极差时的MathModelAgent配置过程.md这类实战文档如果能被 RAG 检索到,会大幅降低用户冷启动成本。 - Fallback Hand Off 自动化——目前是手动配置,自动切备用模型的逻辑没写。
15. 与同类项目的对比#
数学建模类的自动化项目,我之前深拆过的有:
- OpenScholar(AkariAsai/OpenScholar ↗)——学术研究问答,不是数学建模竞赛
- Pi Agent Harness(earendil-works/pi ↗)——通用终端编码 Agent Harness,数学建模只是它的应用场景之一
- DeepScientist——科研操作系统,一类相似场景
- HyperFrames——HTML/CSS → MP4,完全不同领域
MathModelAgent 的独特定位:
| 维度 | OpenScholar | Pi | MathModelAgent |
|---|---|---|---|
| 定位 | ScholarQA | 通用 Coding Agent | 数学建模竞赛 |
| SKILL/Harness | 自研 | 自研 Pi | Harness+SKILL |
| 多 Agent | 否 | 单 Agent + 扩展 | 4 Agent 串行 |
| 学术专用 | 强(45M 论文) | 弱 | 强(17 套模板) |
| 桌面版 | 否 | 否 | 有(Electron) |
| Code Interpreter | 否 | E2B 集成 | 本地 Jupyter + E2B/Daytona |
| HIL | 否 | 否 | 数据模型已建 |
MathModelAgent 是”高度垂直场景 + Harness+SKILL 架构”的典型样本——它不需要做通用 Agent,只做数学建模,但做得很深。
16. 后记:为什么这件事值得做#
数学建模竞赛从 1992 年开始,30 多年了。它的形式——“3 天 3 夜,一队 3 人,一篇论文”——一直不变。不是因为它最合理,而是因为它是最容易组织的一种”团队限时高压测试”。
但 30 年里变了很多的事:
- 1992 年的选手,要查文献只能去图书馆
- 2025 年的选手,可以问 LLM”ARIMA 和 LSTM 在能源预测哪个好”
- 2030 年的选手,可能只需要按一个按钮,Agent 就跑出了论文
jihe520/MathModelAgent 在做的是把按钮按下去之前的所有复杂度,封装成 SKILL。它不是要替代选手,它是要让选手把时间花在模型选择 + 创新思路 + 表达打磨上,而不是花在”装环境 + 写代码 + 排版论文”上。
最后作者在 README 写的两句话我特别喜欢:
感谢开源的 latex 模板,我在此基础上转化为 typst 模板
此 SKILL 是一个基础模板,你可以基于此构建更适合你自己的 MathModel SKILL
它把”工具”做成了”生态”——17 套模板是基础,你可以在它上面加你自己的领域知识、你自己学校的评分偏好、你自己积累的图表风格。
项目链接:github.com/jihe520/MathModelAgent ↗
姊妹项目:github.com/jihe520/sci-box ↗(科研图表 & 流程图 SKILL)
作者:jihe520(开源两年,MCM/ICM 出身)
在线体验:mathmodel.top/home ↗
如果你也在做数学建模、自动化 Agent、或者”SKILL 取代 Harness”这条路线,这个仓库值得 clone 下来仔细读一遍 backend/app/core/agents/agent.py 的 302 行——那是整个项目最浓缩的工程精华。