📘 原文信息
- 标题:Full-Pipeline Inference Optimization for MiMo-V2.5 Series: Pushing Hybrid SWA Efficiency to the Limit
- 作者:Xiaomi MiMo Team
- 发布日期:2026-05-30
- 原文链接:https://mimo.xiaomi.com/zh/blog/mimo-v2-5-inference ↗
一、为什么这篇值得读?#
大模型进入”百万 token 上下文 + 多模态”时代后,推理系统的瓶颈早已从单卡 FLOPS 转向 KVCache 容量、跨层数据搬运、PD 流水线调度和缓存命中。小米 MiMo 团队在 2026-05-30 发布的这篇工程长文,第一次把 Hybrid SWA(混合滑动窗口注意力)+ MoE + 多模态 三种架构的端到端推理优化讲得相当系统——它不是讲单点 Trick,而是讲一整套”理论优势如何不被实现细节吃掉”的方法论。
本文按原文章节做一次重述与解读,重点是:
- Hybrid SWA 的”理论效率”到底有多少?(第 1 节)
- KVCache 系统怎么为 SWA 重构?(第 2 节)
- GCache 这个自研分布式缓存为什么关键?(第 2.2 节)
- LLM-Router 怎么调度才能让命中率与吞吐都不掉?(第 3 节)
- Prefill / Decode 各自的关键优化是什么?(第 4、5 节)
- 多模态 Encoder 怎么从 15 QPS 翻到 30 QPS?(第 6 节)
二、MiMo-V2.5 系列架构速览#
MiMo-V2.5 系列包含两个模型(MiMo-V2.5 / MiMo-V2.5-Pro),三个架构特征叠加:
| 特性 | 作用 |
|---|---|
| Hybrid Sliding Window Attention (Hybrid SWA) | 大部分层用 SWA 局部窗口,少量层保留 Full Attention,KVCache 容量与计算量都接近 Full Attention 的 1/7 |
| 稀疏 MoE 激活 | 单 token 只激活部分专家,总参数量大但单次推理 FLOPs 小 |
| 多模态 Encoder | 同一基座支持视觉、音频、视频理解 |
作者一上来就抛出核心矛盾:强推理需要长程依赖 → 算力和 KVCache 都吃不消。Hybrid SWA 在理论上”近线性 + 保留长程依赖”,但落地时还有 KVCache 命中率、prefix matching、Full/SWA 语义一致性、多级存储数据搬运、分布式缓存同步、PD 流水线等一系列问题需要解。
下面我们就按文章顺序看每一步。
三、Hybrid SWA 的理论效率上界#
3.1 计算分析#
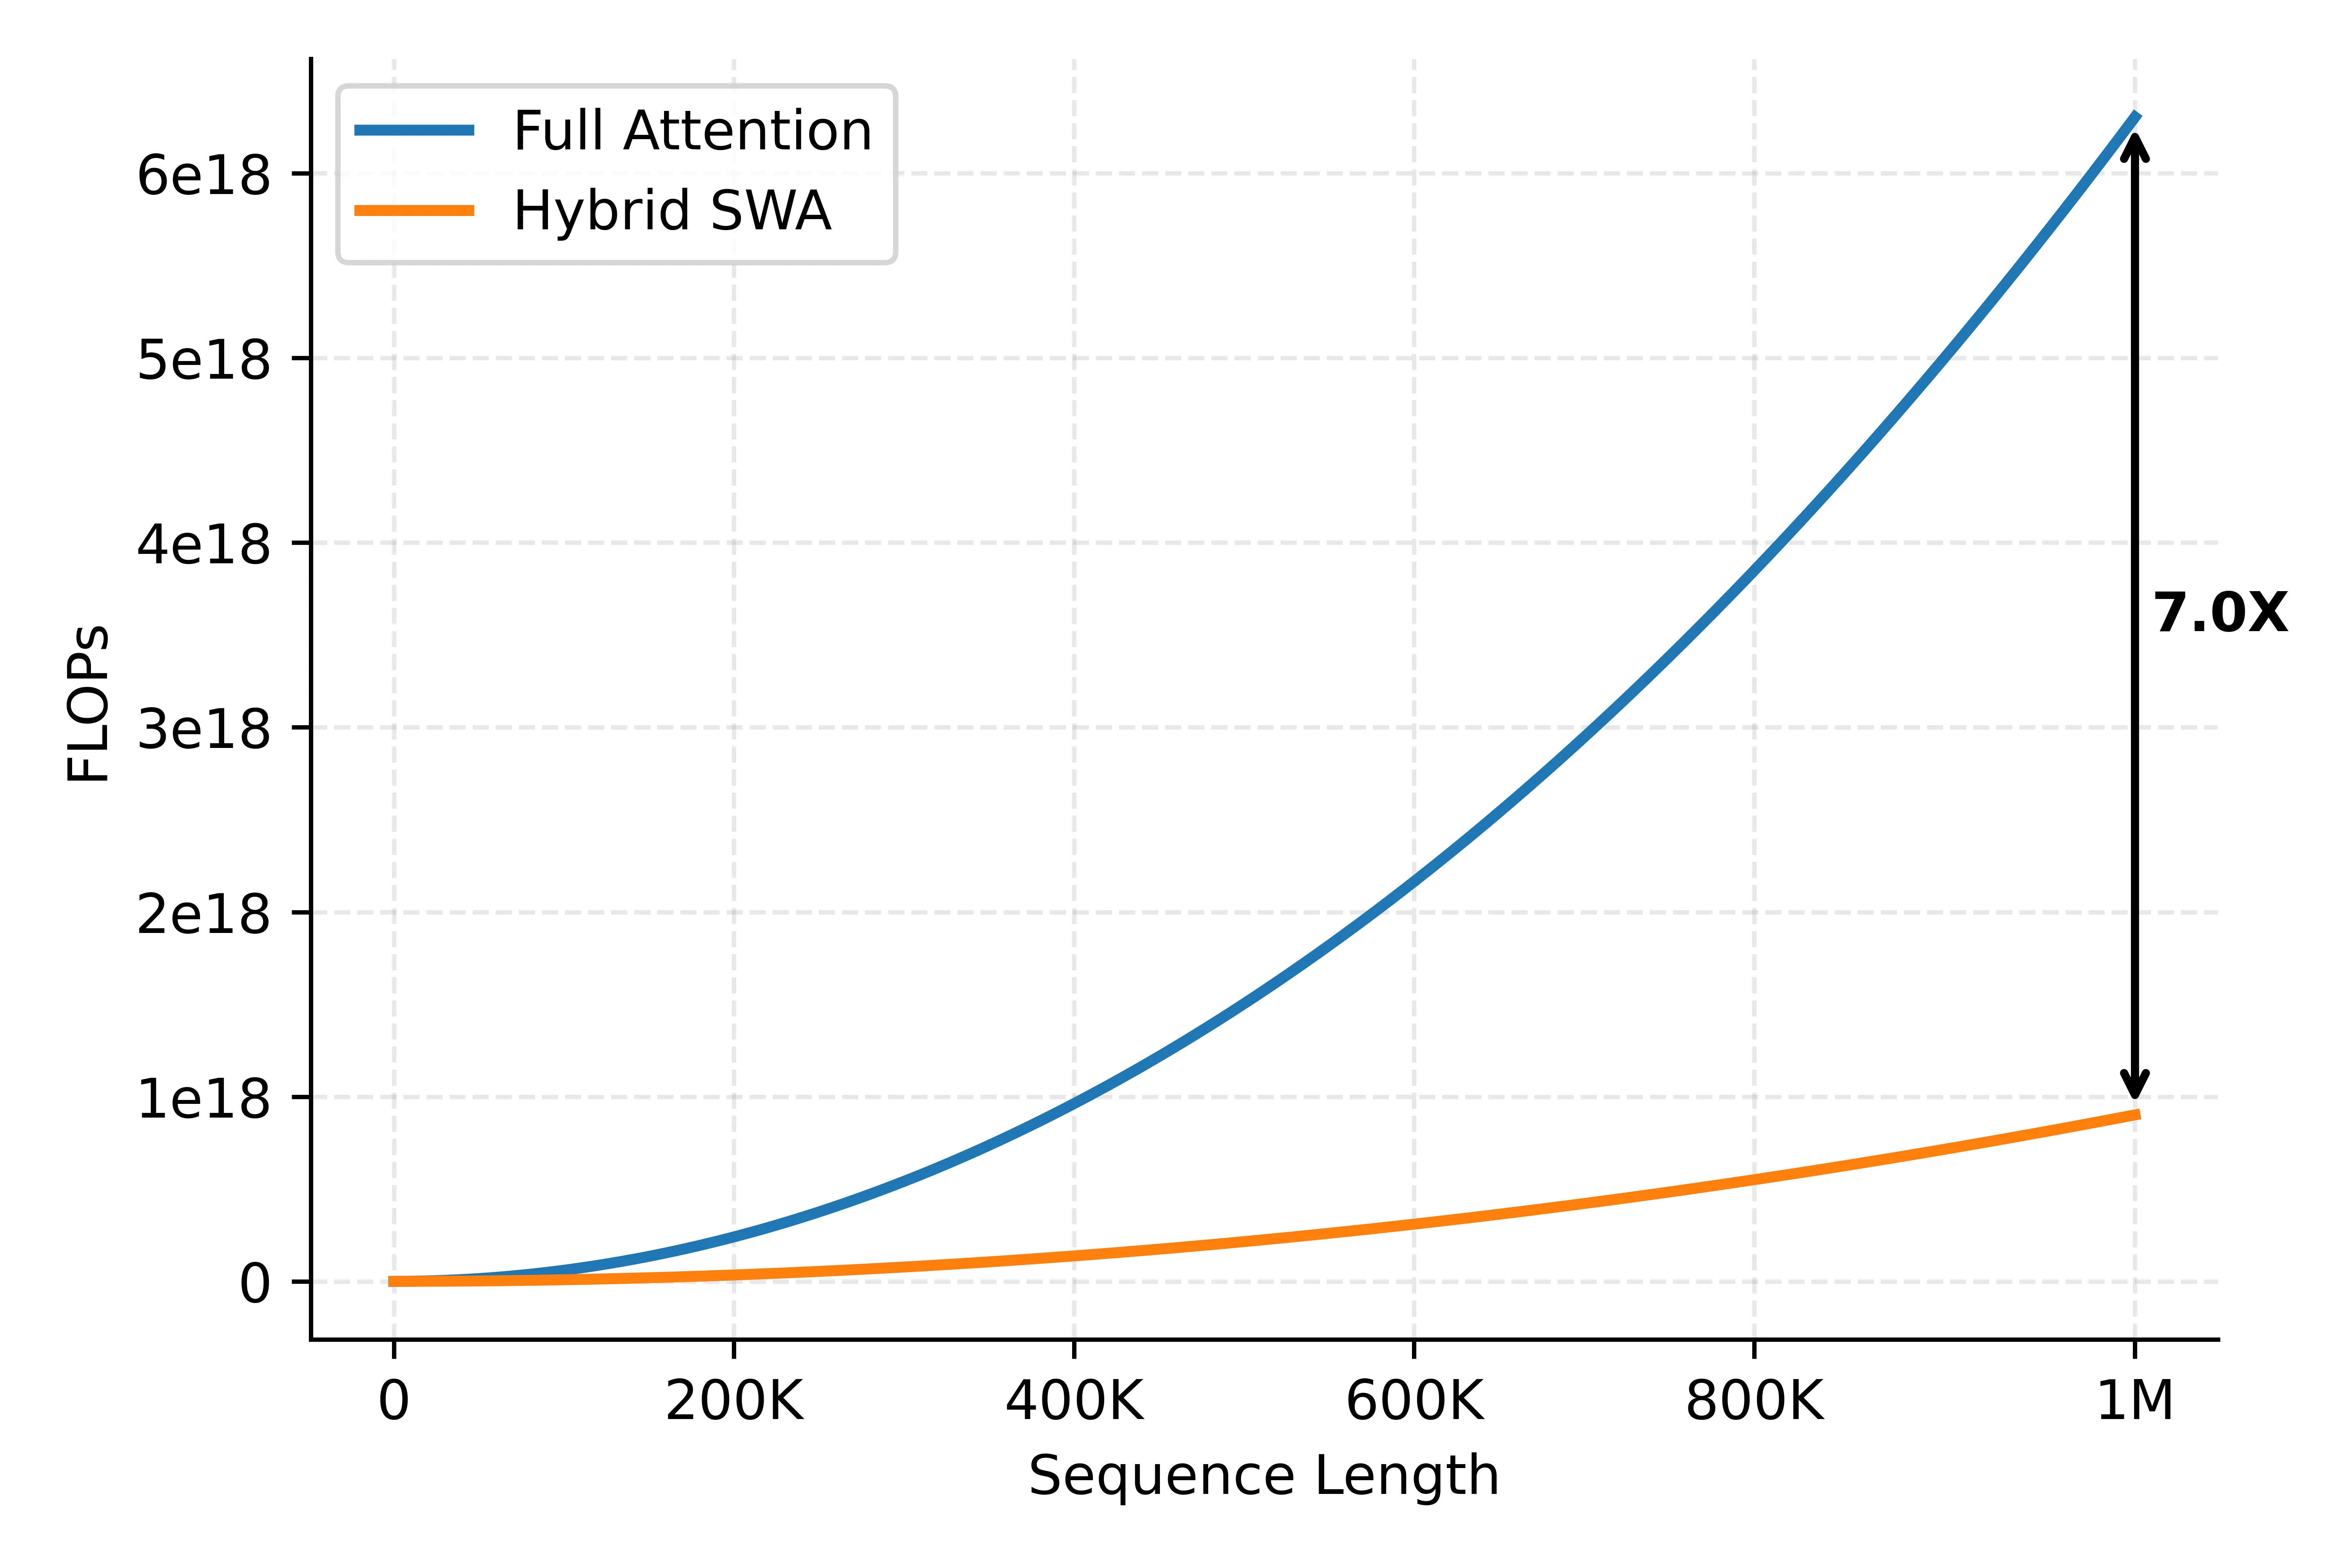
以 MiMo-V2.5-Pro 为例,70 层 = 10 层 Full Attention + 60 层 SWA,window=128。SWA 层占 6/7,所以:
Hybrid SWA 架构总 attention 计算量 ≈ Full Attention 的 1/7
在 Chunked Prefill 场景下,Prefill 阶段是 compute-bound,这一比例直接换算成 Prefill 成本的下降。
3.2 KVCache 存储分析#
SWA 层只需要保留窗口内 KV,不需要保留全序列 KV。Decode 阶段是 memory-bound,延迟与”模型参数 + KVCache 读出的总字节数”成正比。在长序列下,KVCache 远大于模型参数,所以 KVCache 缩小 1/7 ≈ Decode 成本缩小 1/7。
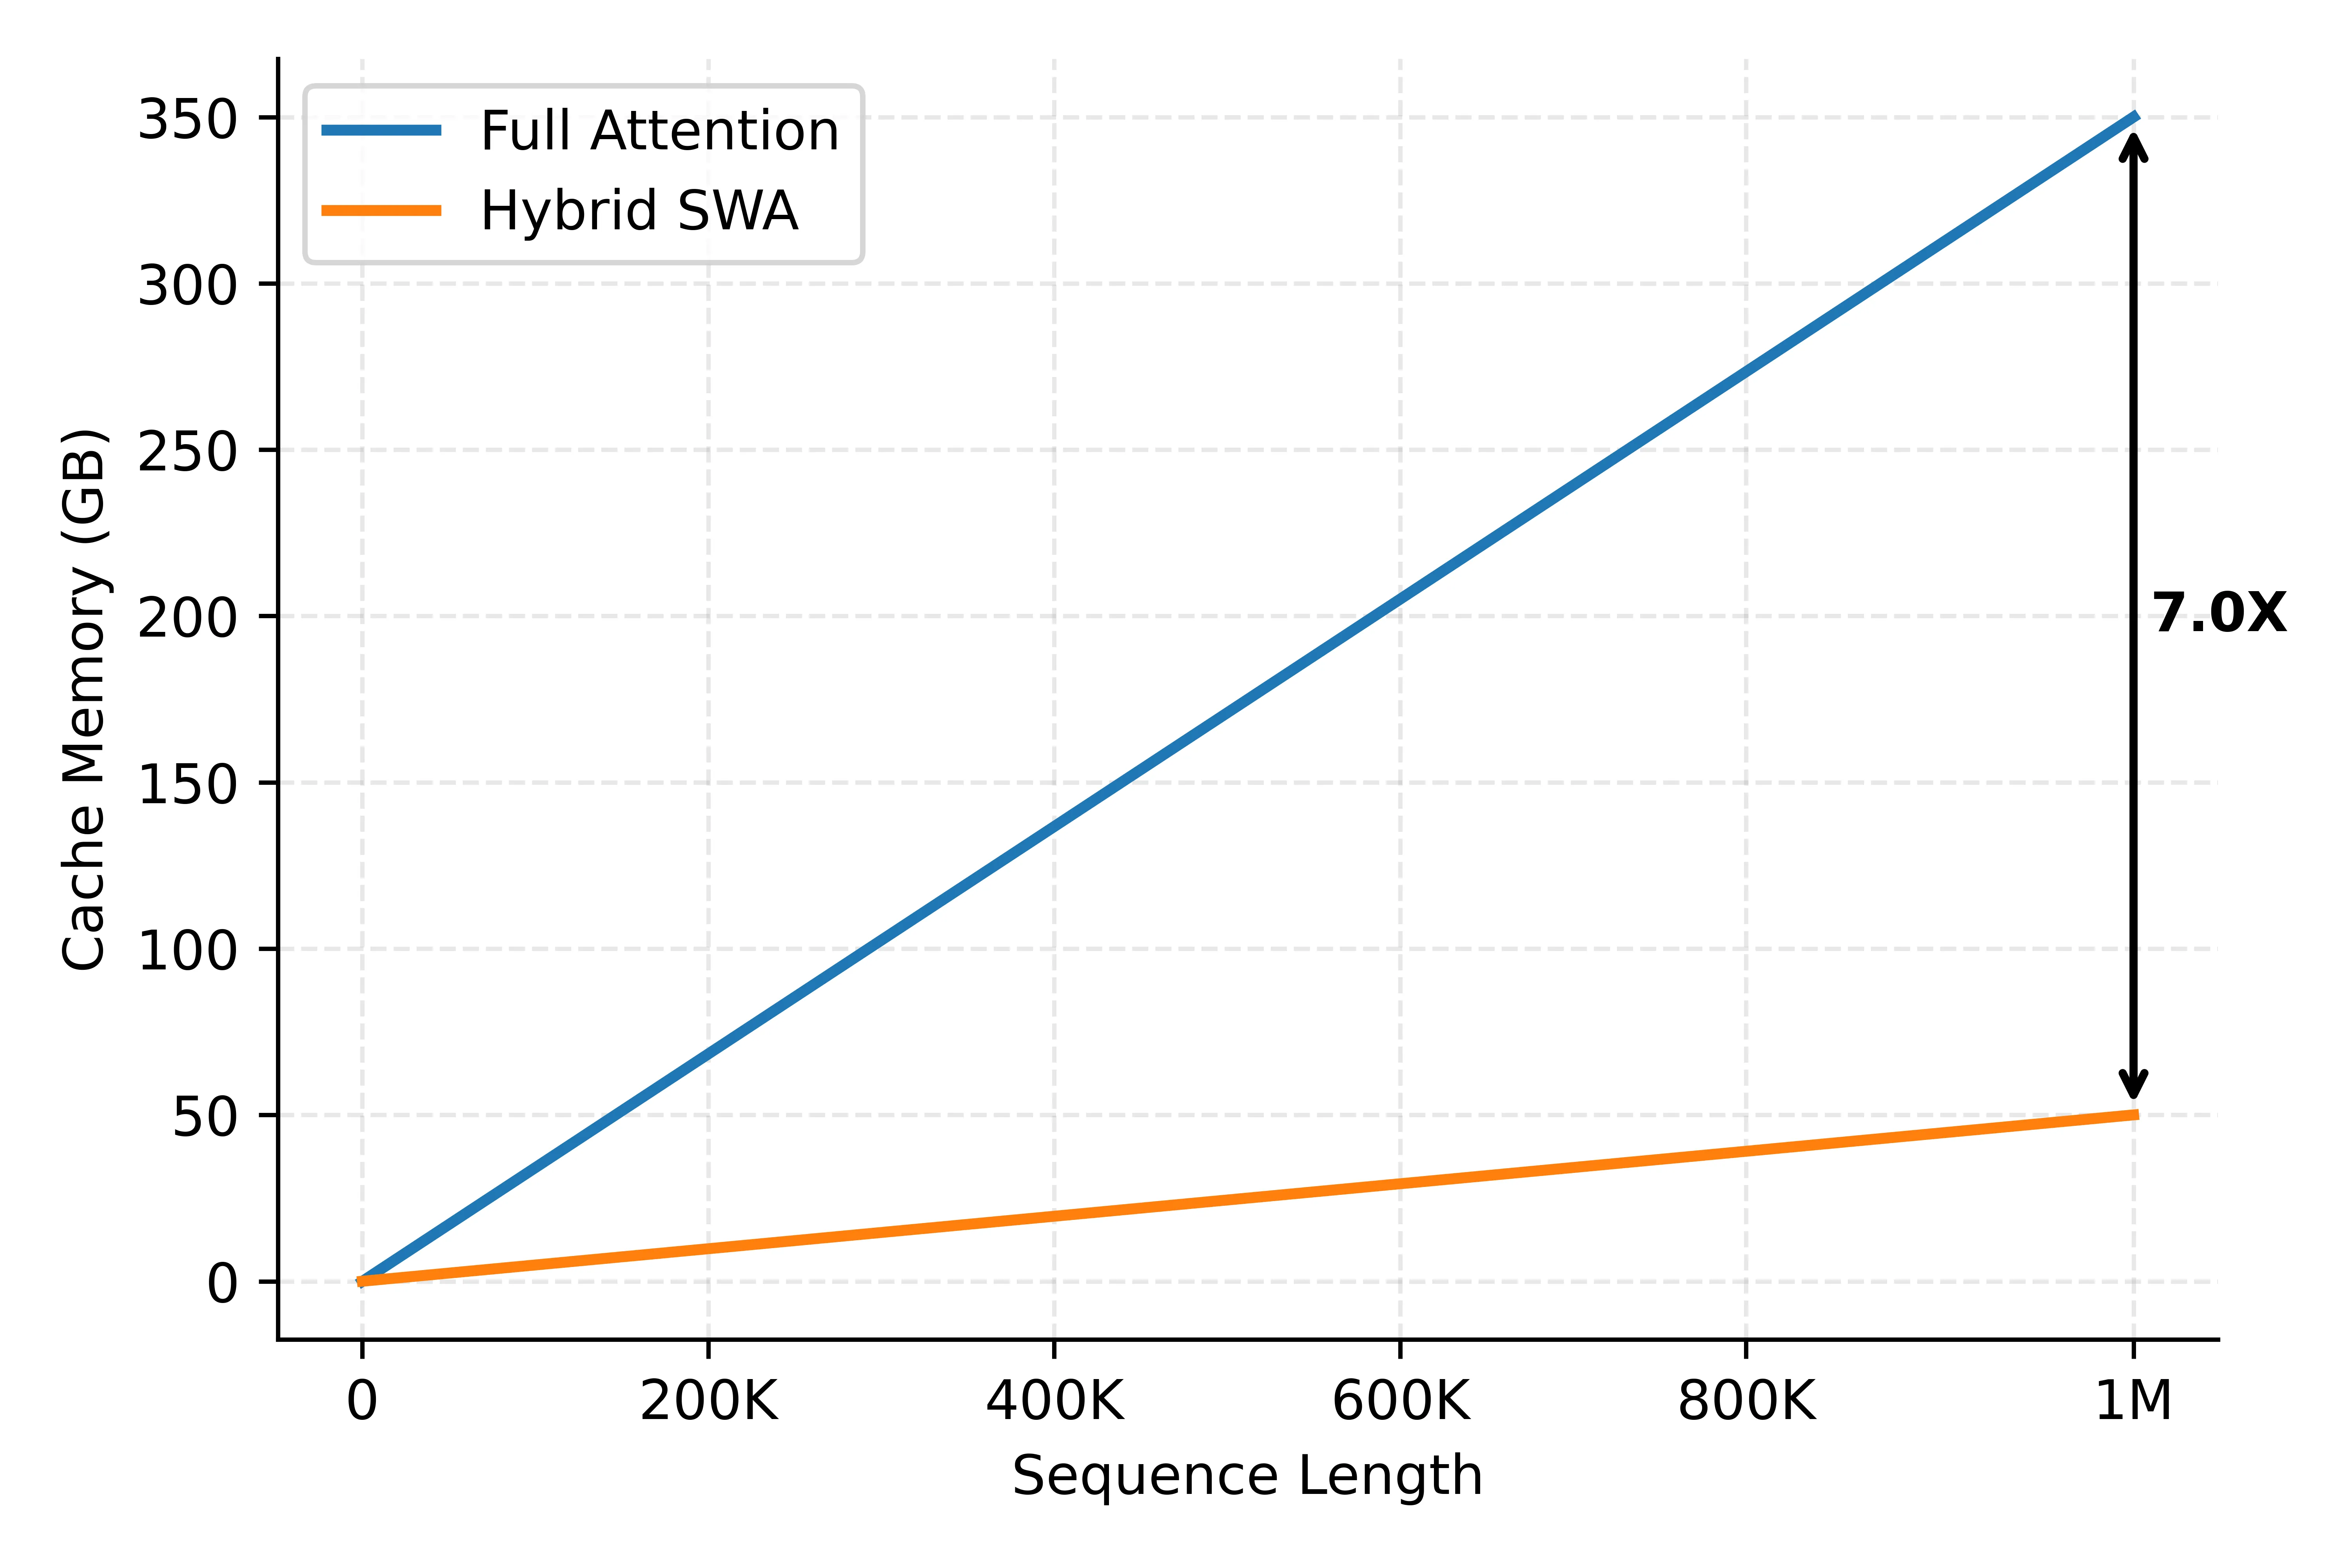
横比同代模型,MiMo-V2.5-Pro 与 MiMo-V2.5 在 KVCache 效率上排名第二,仅次于 DeepSeek-V4-Pro / V4-Flash:
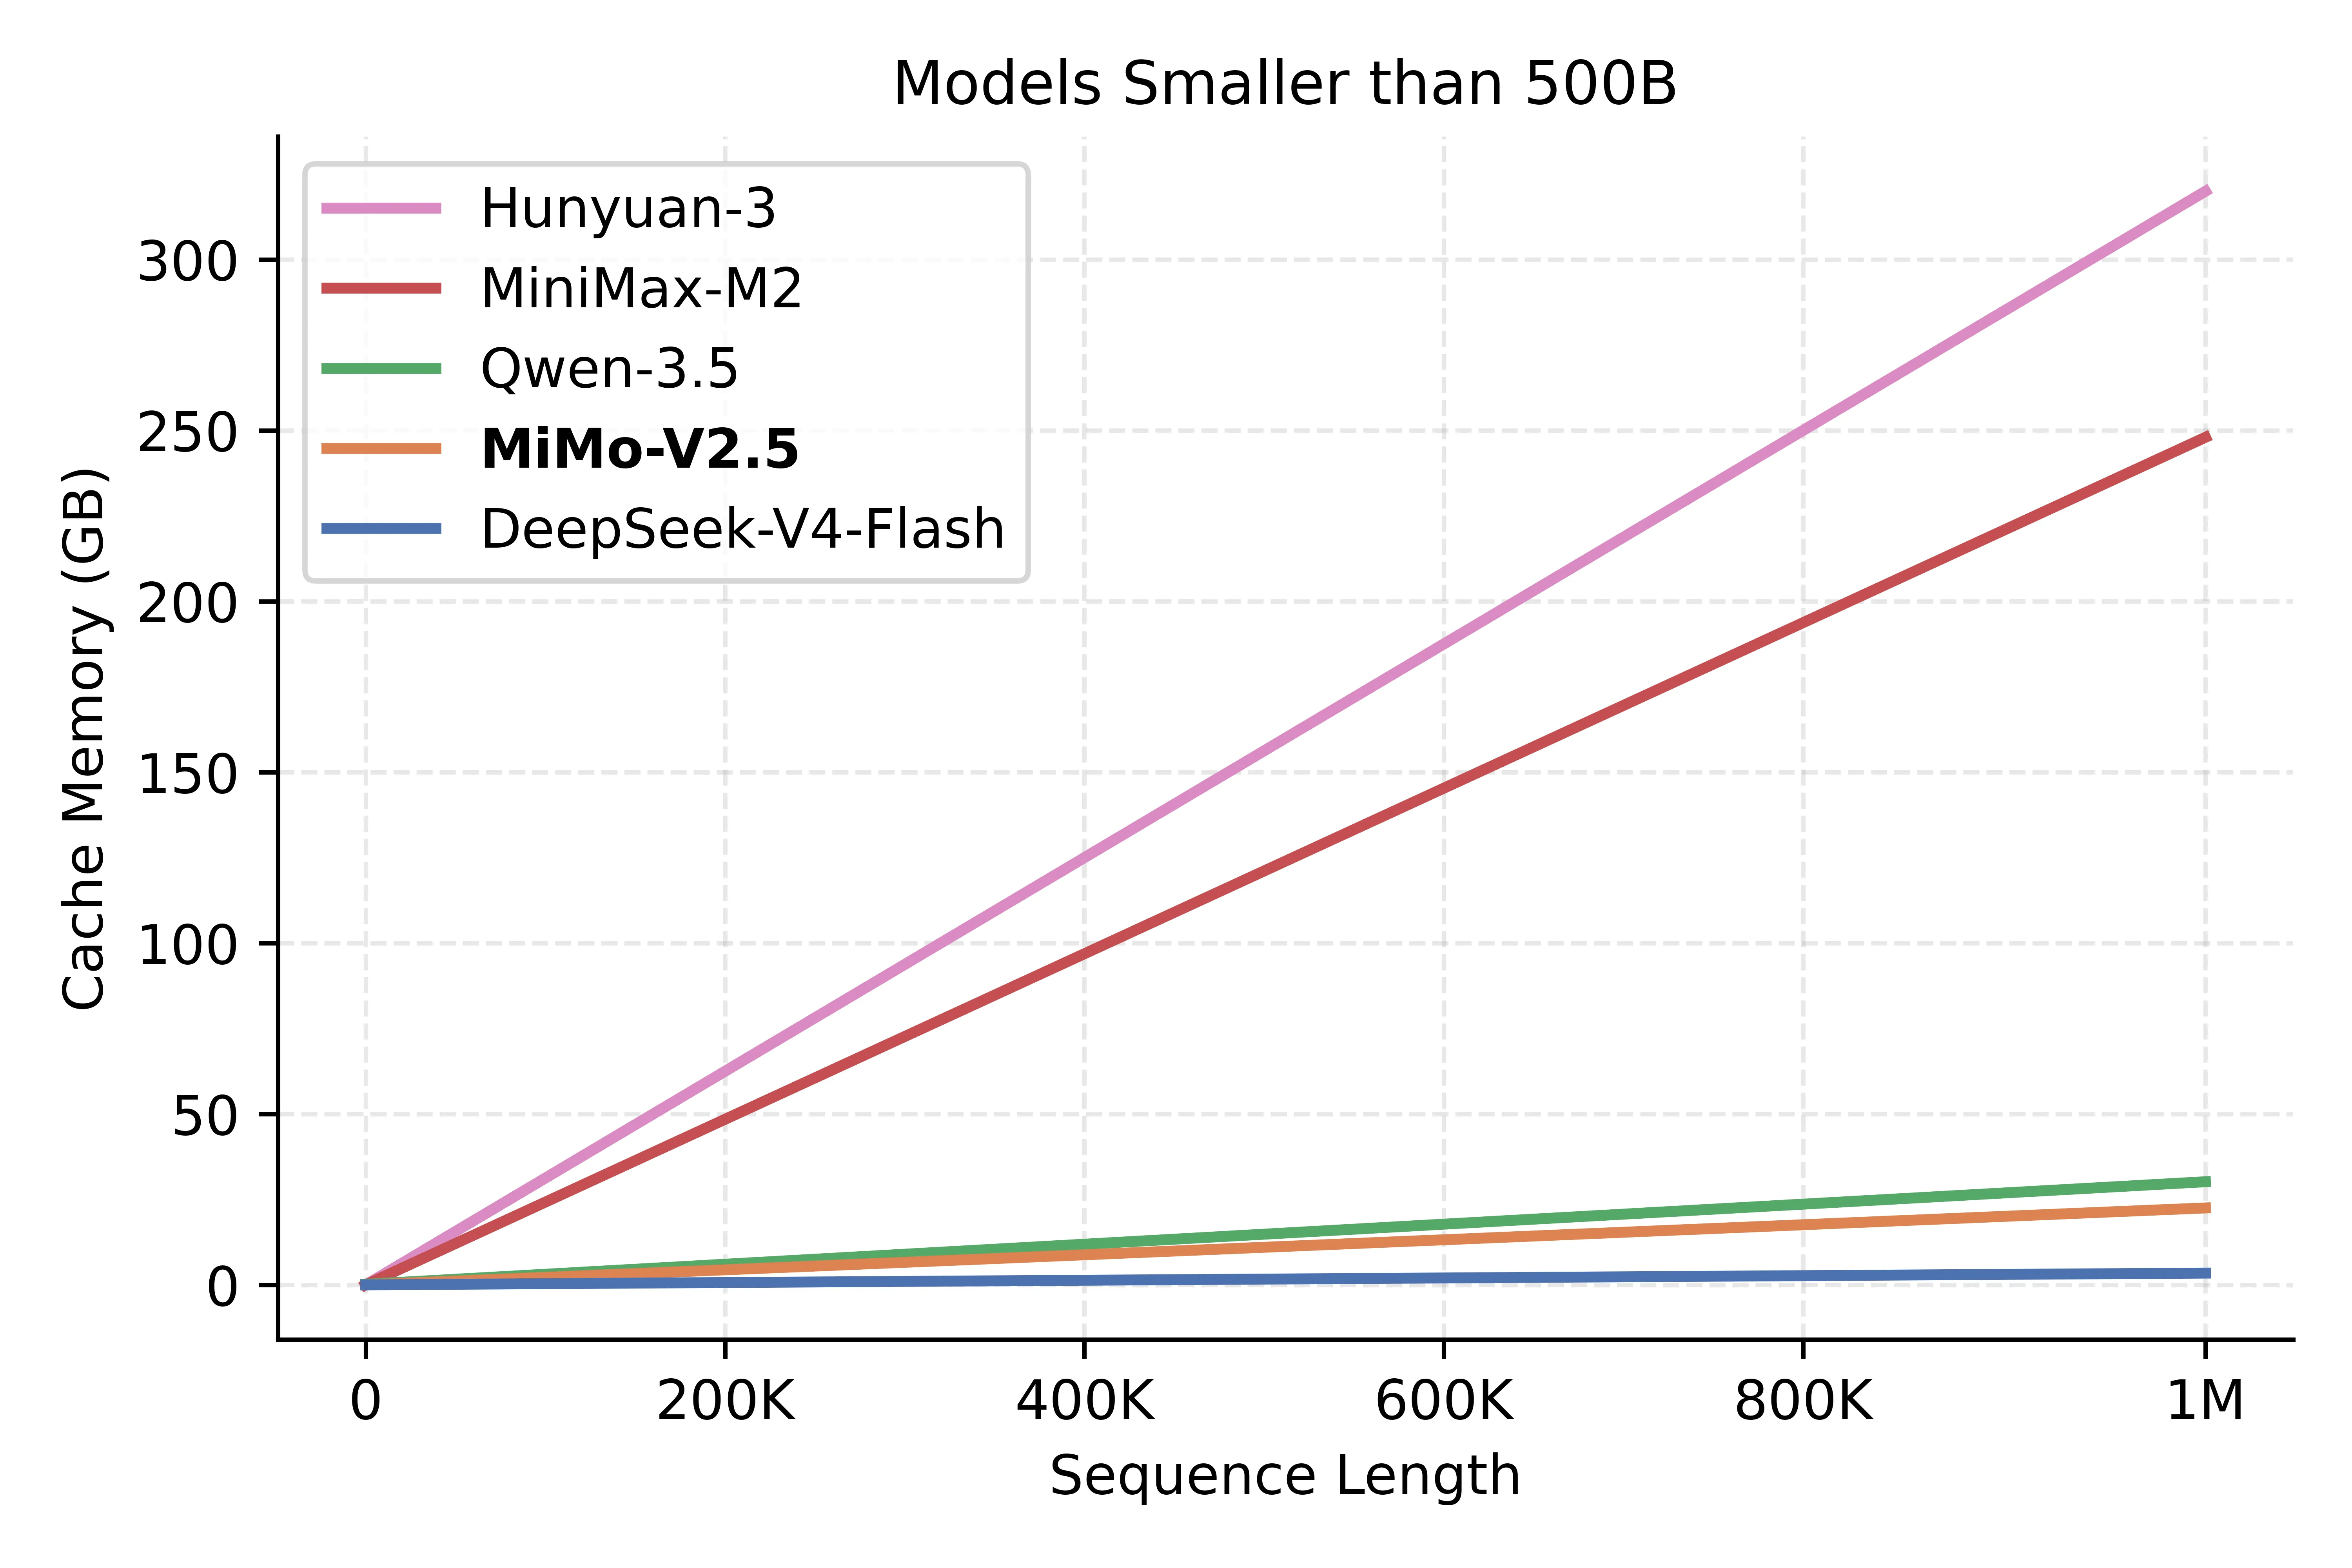
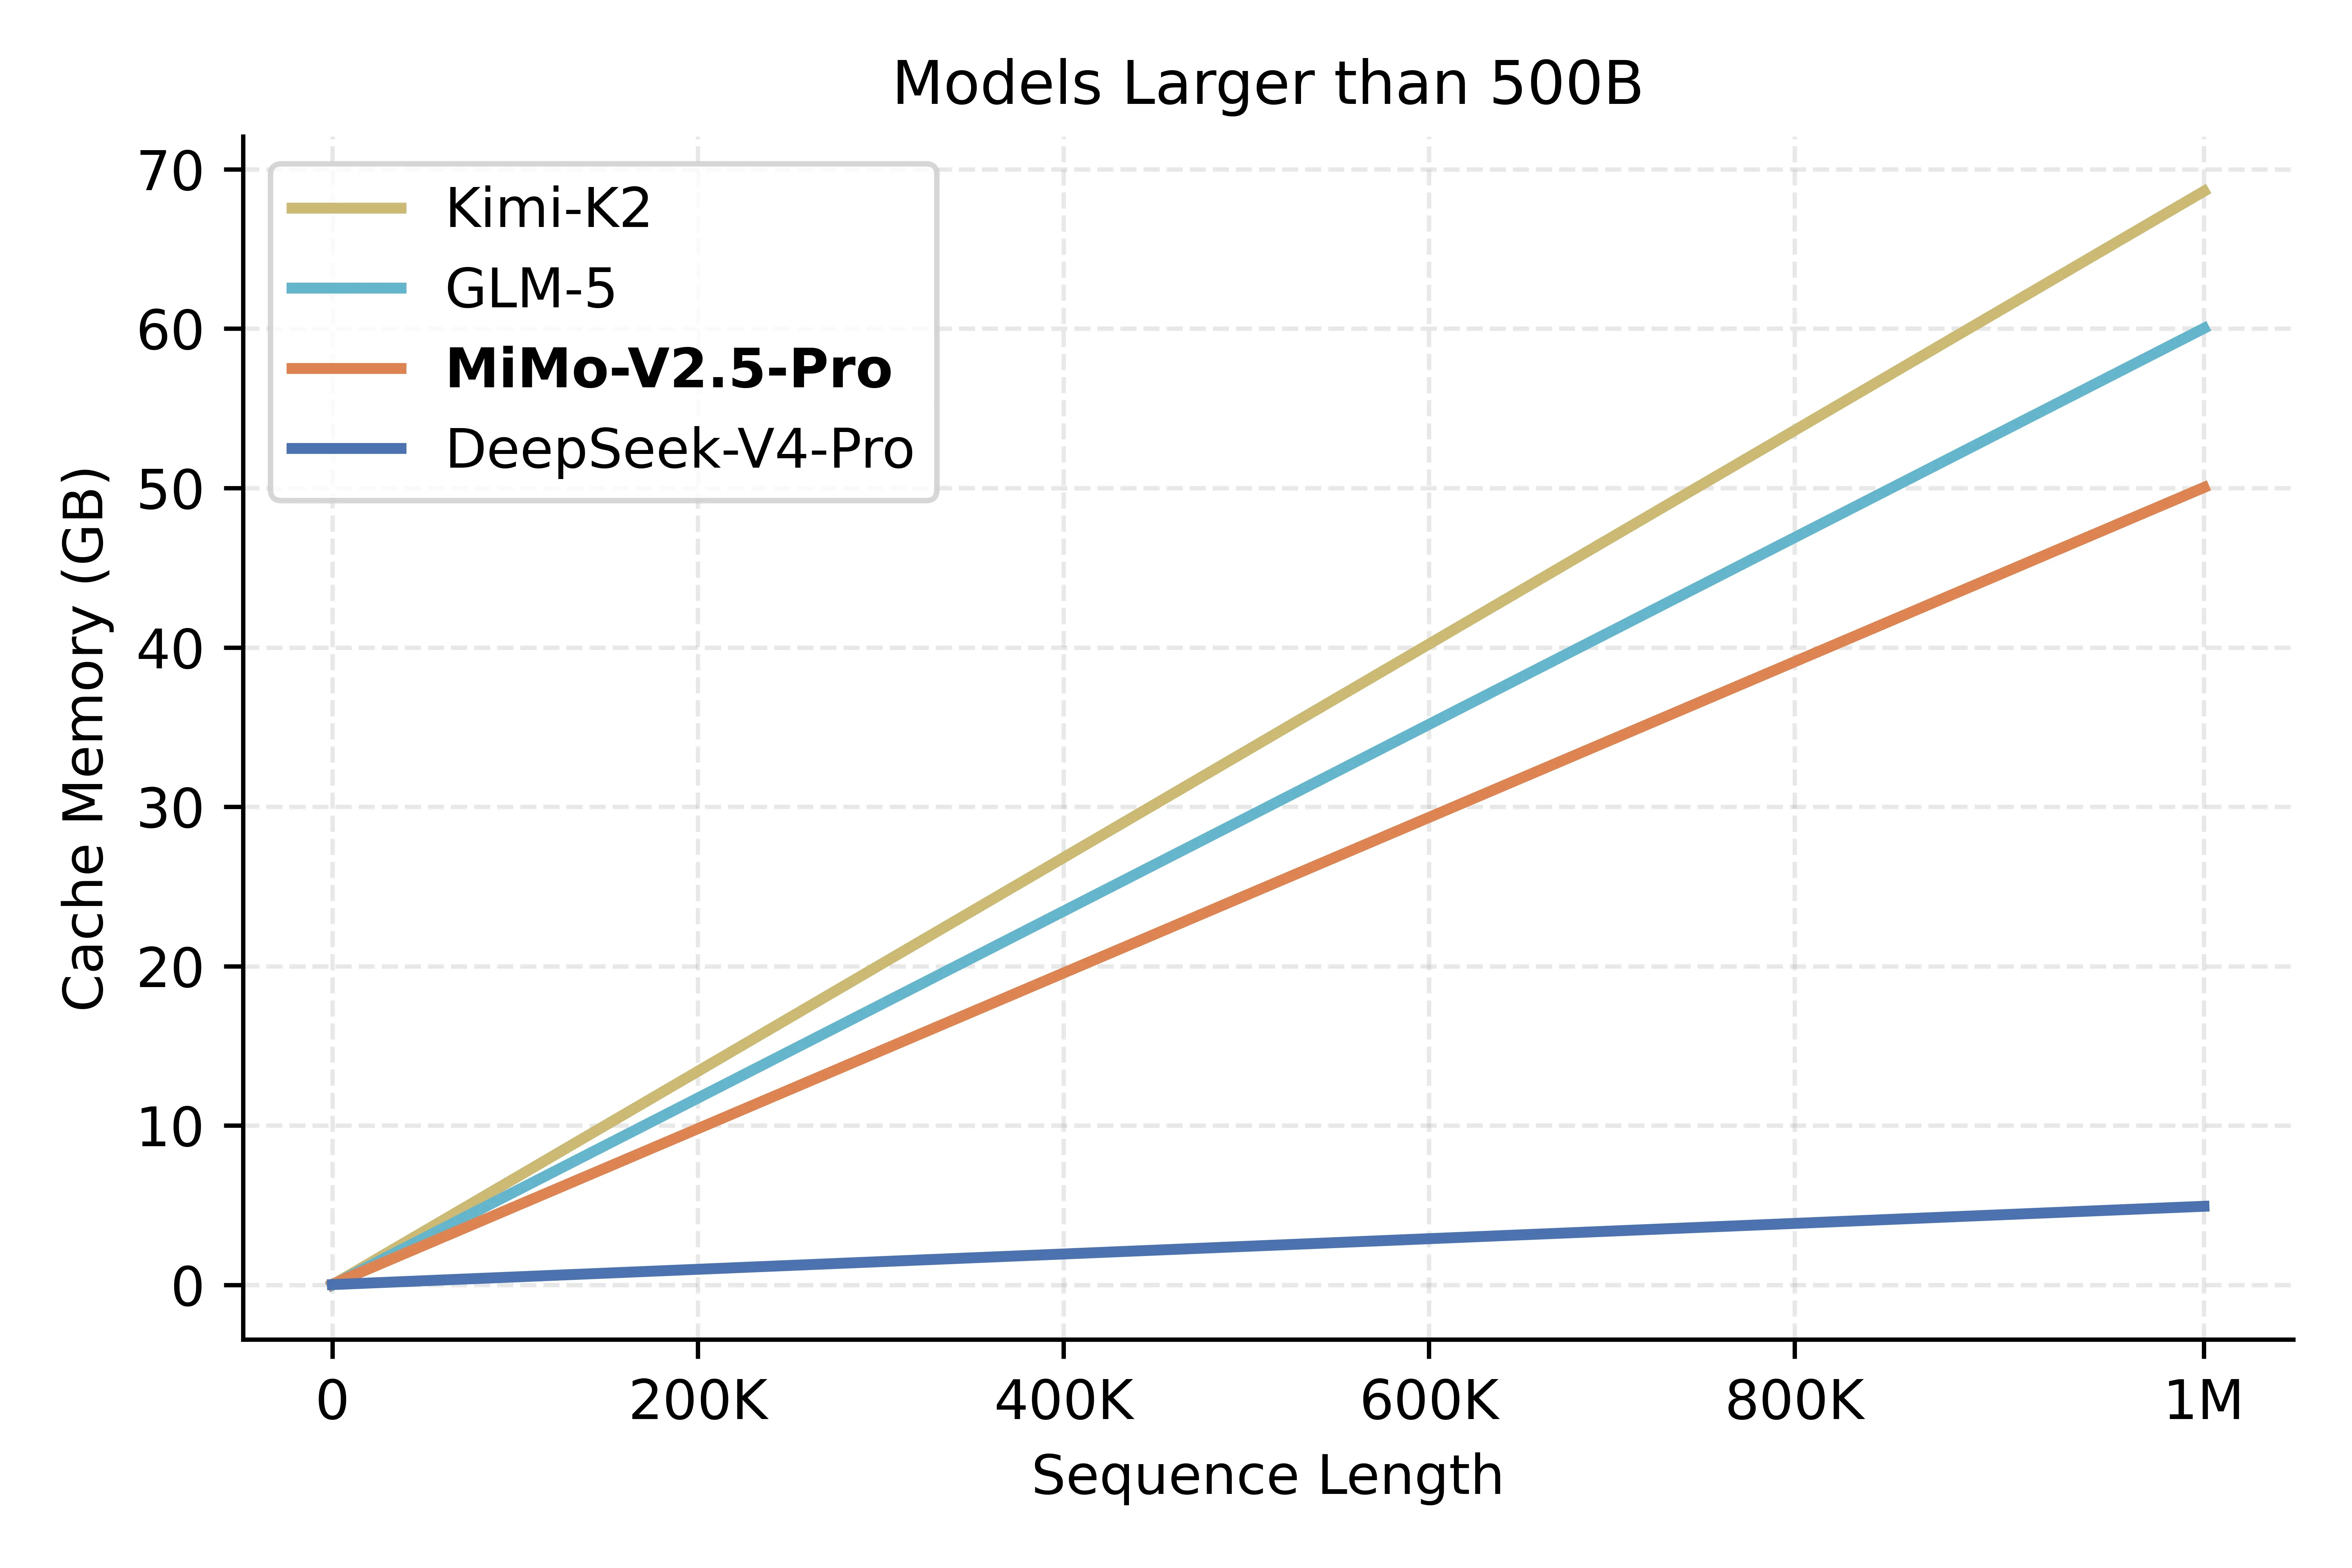
注意:实际成本差异不会严格等于 KVCache 比例,因为还有与序列长度无关的固定开销;但趋势是”序列越长,Hybrid SWA 优势越大”。
💡 小吴笔记:这里的”1/7”是个非常重要的锚点。后面所有 KVCache / 调度 / EP 优化的目标,本质上都是在不破坏正确性的前提下,把这个 1/7 真正吃下来。
四、KVCache 系统重构——把 Hybrid SWA 装进生产#
MiMo 是最早采用 Hybrid SWA 的模型之一,但当时主流开源推理框架和缓存系统对 SWA 的支持是残缺的——SGLang v0.5.5 的 HiCache 要么不支持 SWA,要么为了兼容性把全量 KVCache 都存起来。所以团队自己重写了一套。
4.1 SWA KVCache 双池设计#
Hybrid SWA 的存储冲突点在于:Full 层需要 O(N) KV,SWA 层只需要 O(W) KV,如果用同一个 pool,GPU 显存分配必然是 O(N),SWA 的窗口稀疏性就被白白浪费了。
团队把 KVCache 在物理层拆成两个独立 pool:
| Pool | 大小约束 | 用途 |
|---|---|---|
| Full KV pool | O(N) | Full Attention 层用 |
| SWA KV pool | O(W) | SWA 层用,按窗口独立淘汰 |
逻辑层对外暴露统一的 sequence view,prefix tree / scheduler / 传输协议都基于”Full Attention 索引”为权威,附带 Full → SWA 的映射做透明的分层存储。请求准入时同时校验 Full 和 SWA 的容量;跨层数据搬运只走 SWA mask,不浪费带宽。
效果:KVCache 容量效率提升约 7×,刚好对应理论上的 1/7。
4.2 分层 KVCache 预取#
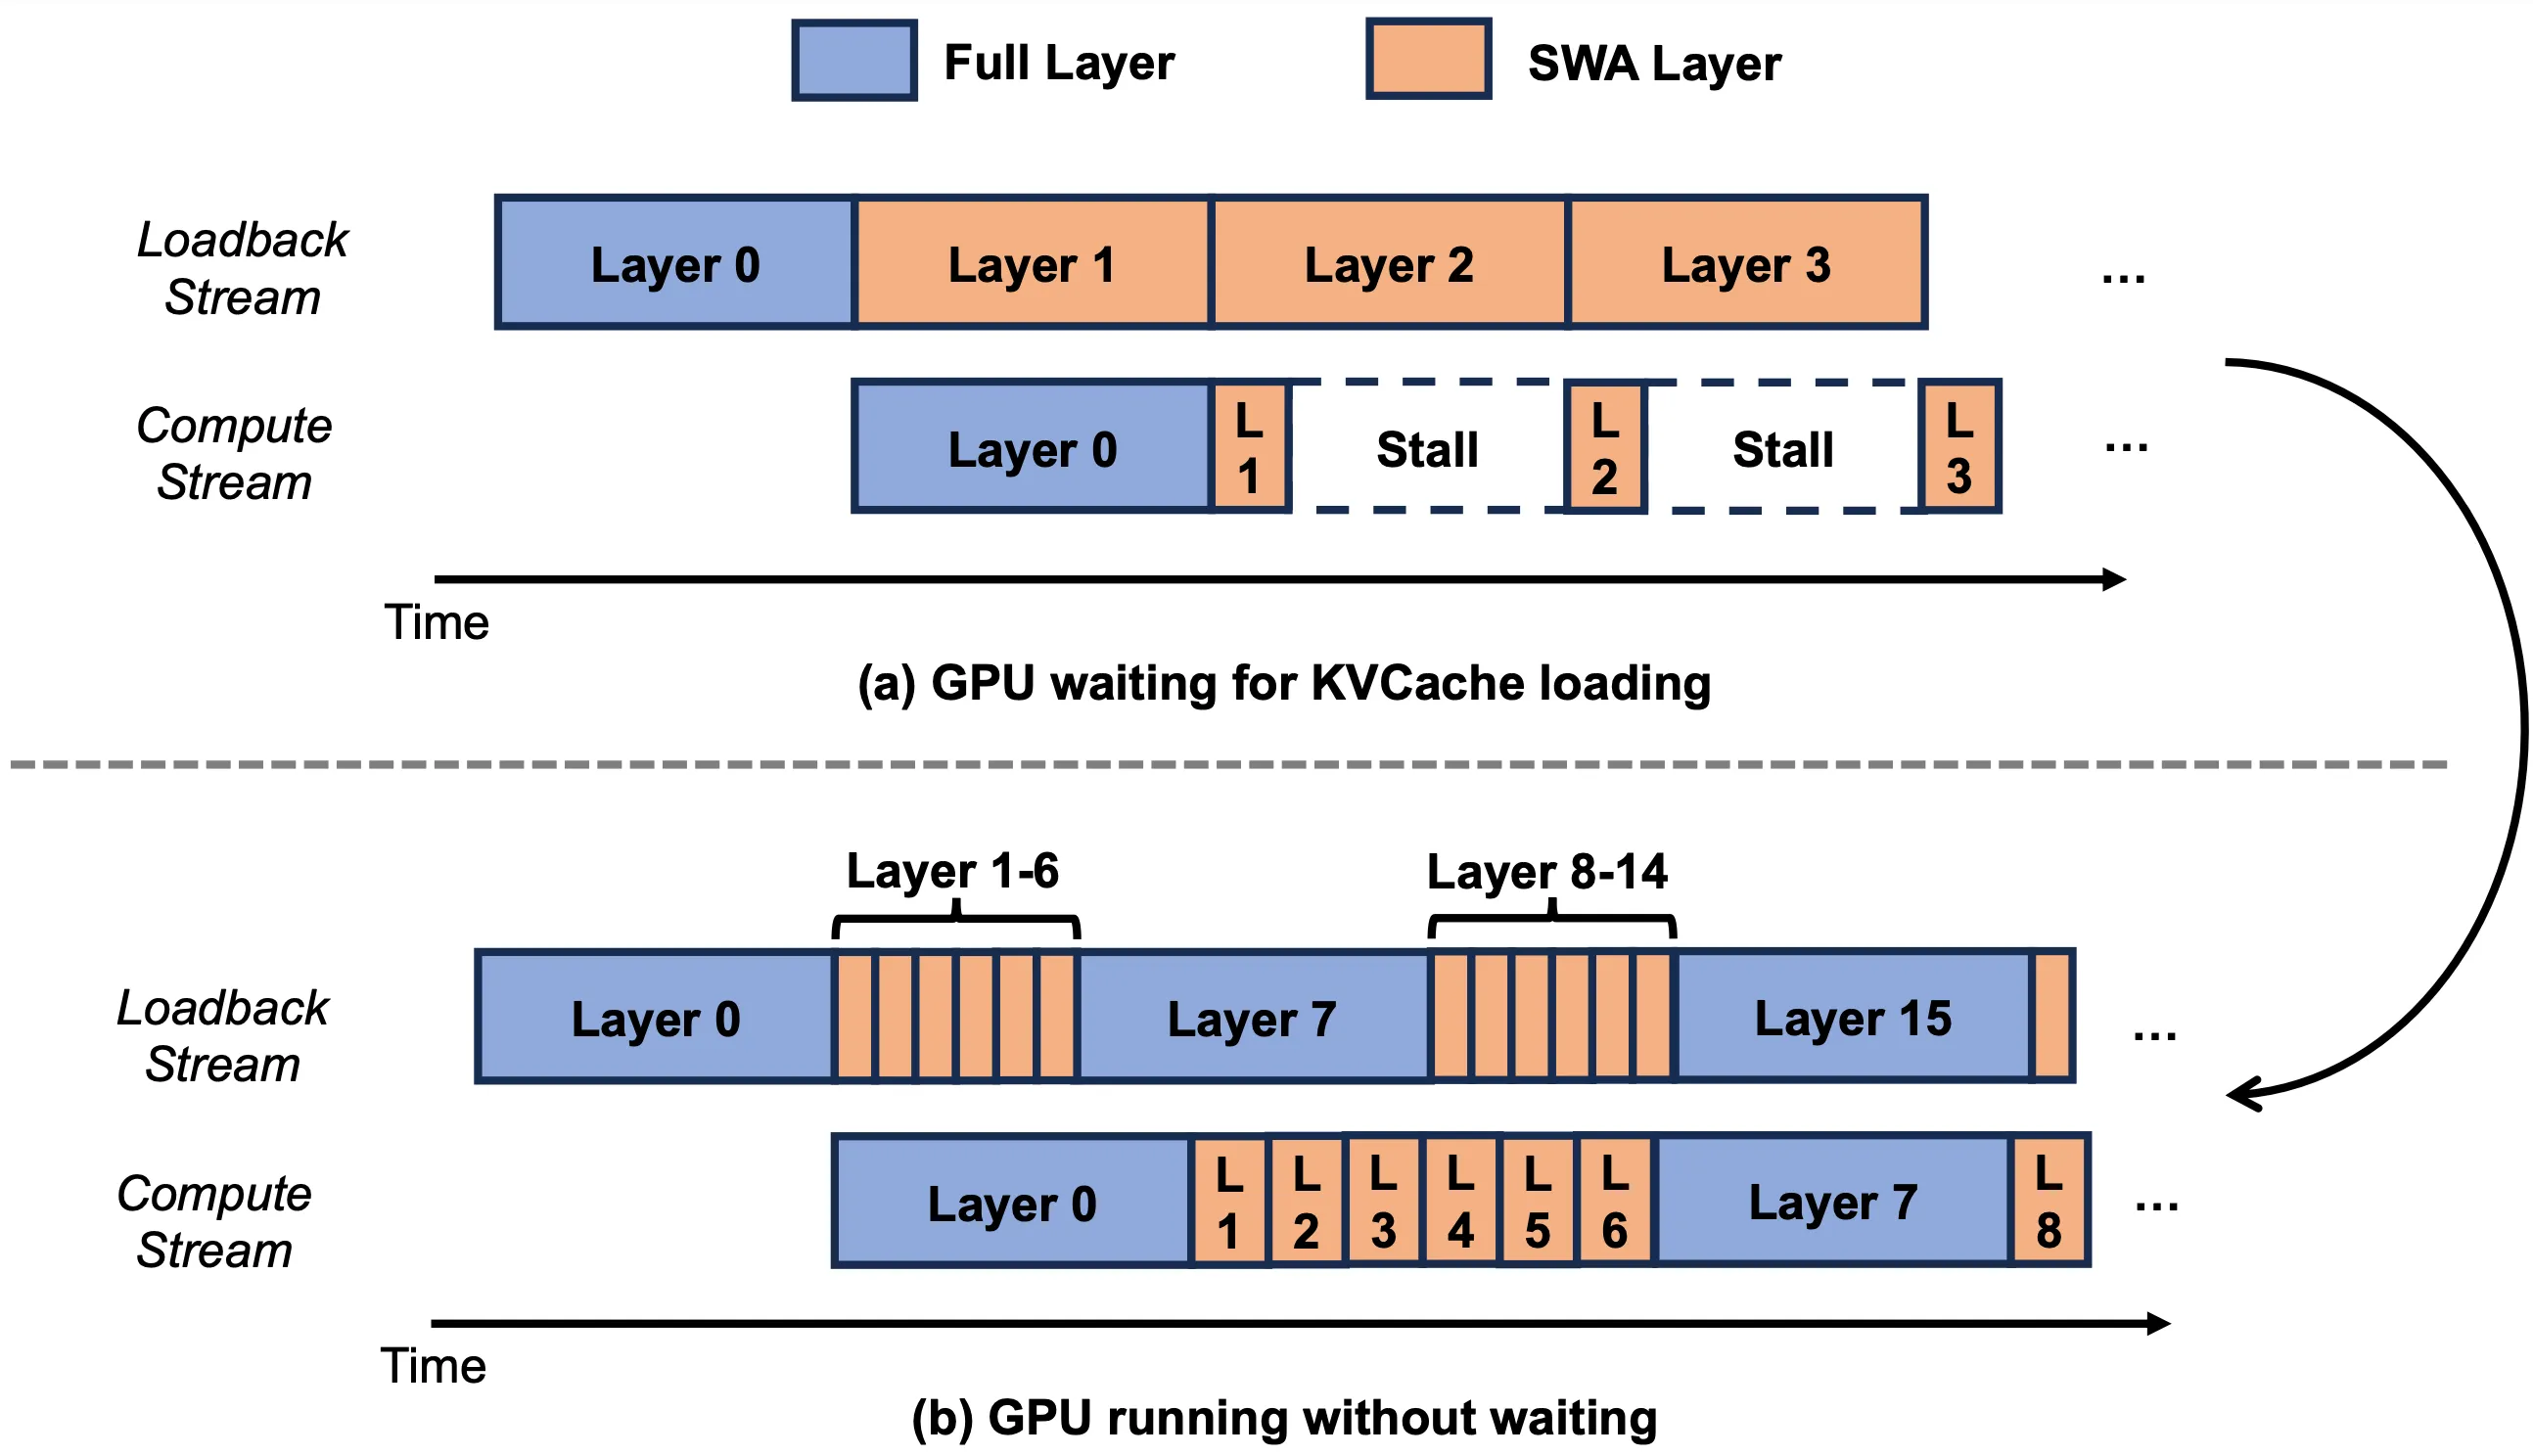
SWA 窗口小 = 预取数据量小 = 容易和计算几乎完全重叠。Layerwise Scheduling 让 Host-to-Device 的 KVCache 预取和计算在层级粒度上完全流水,缓存读取的等待时间趋近于 0。
4.3 SWA 感知的前缀缓存树#
传统 RadixAttention 假设”token 序列相同 → KV 相同”,这个假设在 Full Attention 下成立,但 Hybrid SWA 下不成立:
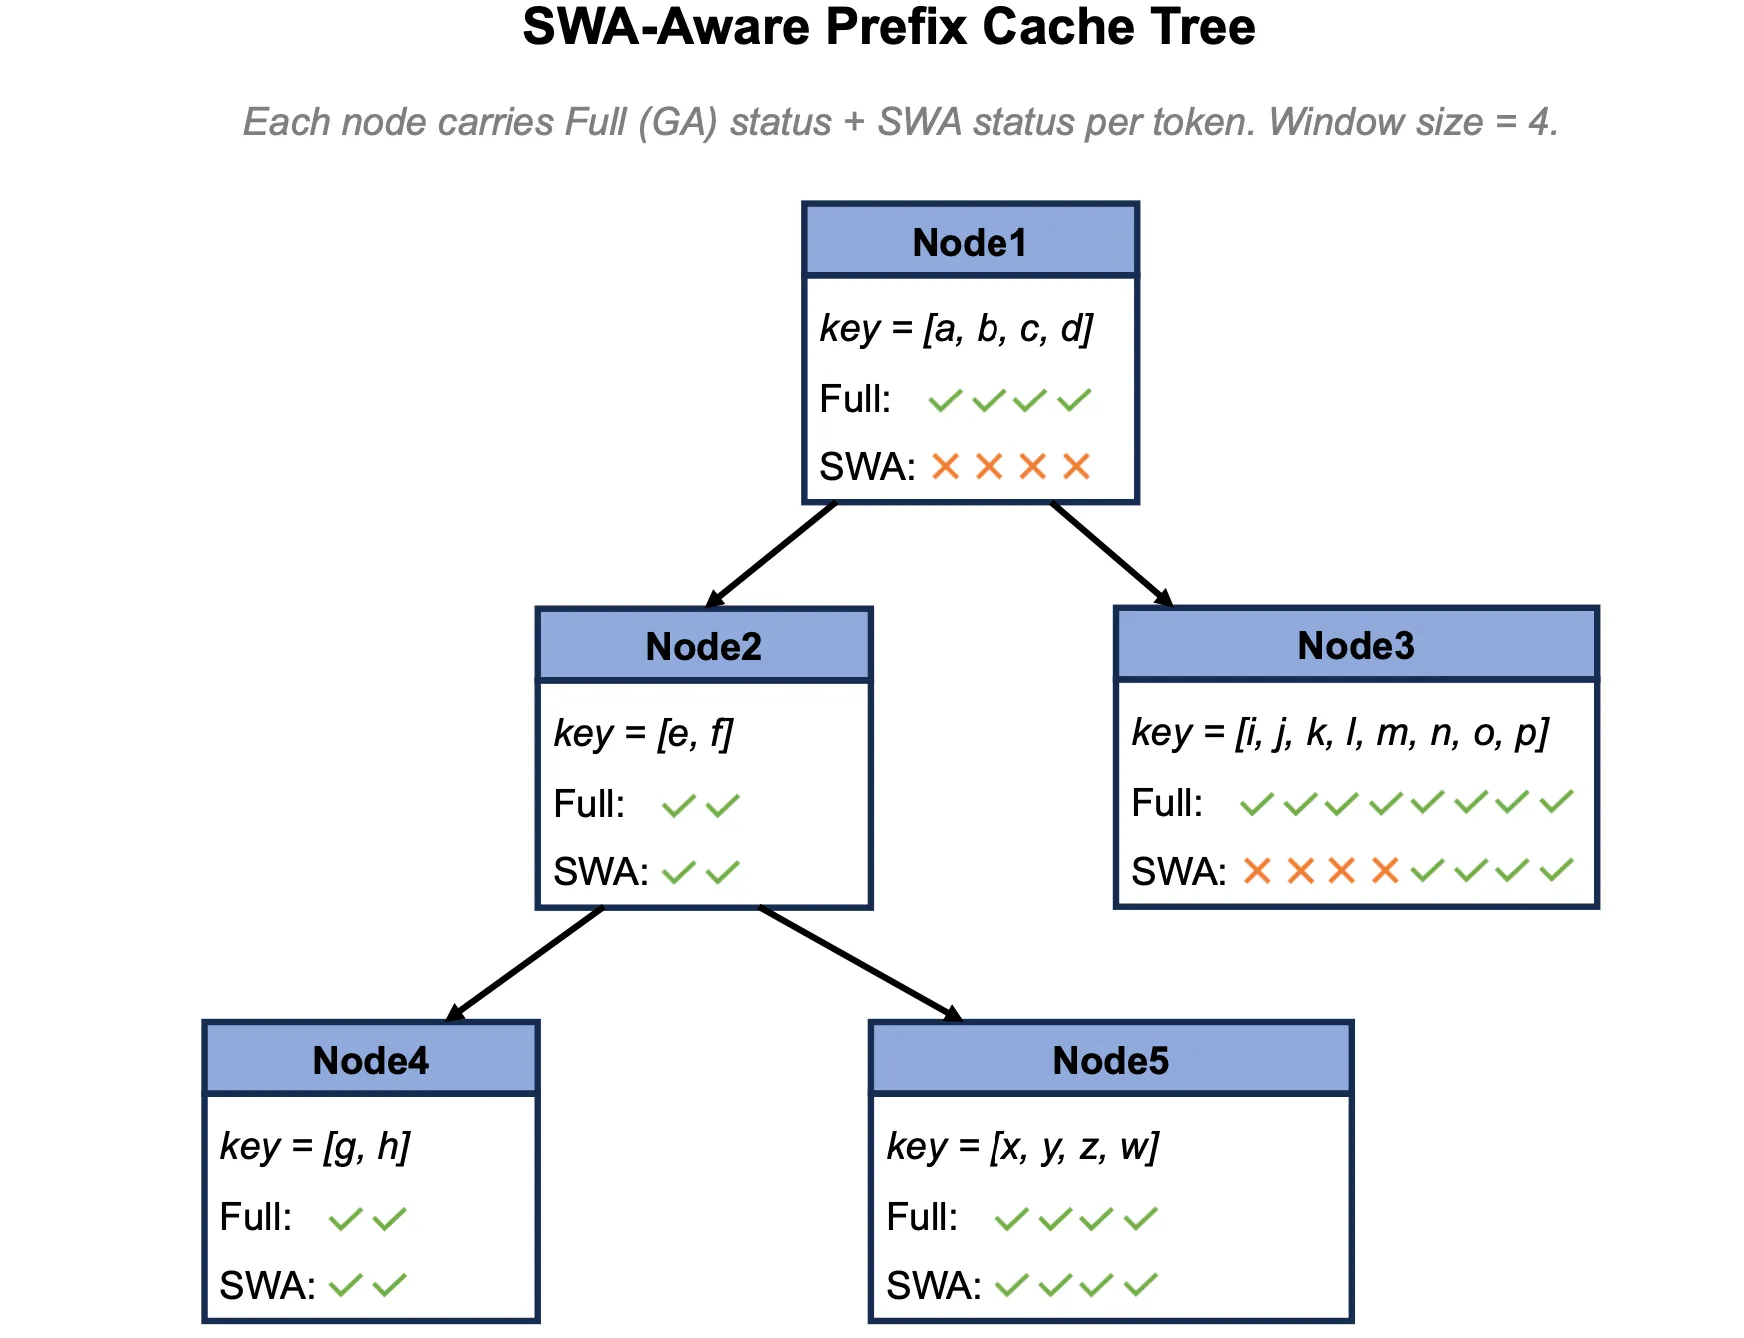
逻辑上前缀树节点的”长度”可以远大于 SWA 窗口,节点也会随请求合并/分裂/删除而变化。即使逻辑上一个节点仍代表完整 token 序列,对应的 SWA KV 可能只剩尾巴一段,甚至已经被淘汰。
如果仍然按”token 相等 → 命中”做调度,scheduler 拿到的就是”伪命中”——后续 attention 计算读到的是失效 / 被覆写的 slot,直接影响模型正确性。
团队把前缀树语义改了三点:
- 匹配规则升级为”窗口安全长度”:除了 token 相等,尾部 W 个 token 必须在 SWA pool 里还有效 slot。匹配长度被裁剪到这个新边界。
- 淘汰与请求生命周期绑定:长 Prefill 阶段、请求结束、Decode 每生成 N 个 token,都触发一次”出窗 SWA 释放”。
- 节点携带双索引:每个节点记录 Full Attention 段索引(决定逻辑顺序,参与 Full 层计算) + SWA 段映射(决定窗口安全性)。Full 段和 SWA 段可以独立淘汰。
为什么这很重要? SWA 把 KV 体积压到 1/7 是”容量级”收益,命中率是”复用级”收益。两者叠加才能真正降低 Prefill 成本曲线。“窗口安全长度”规则会让原始 token 命中率略降,但在相同存储预算下能容纳的 token 数翻了几倍,effective hit rate 大幅提升。
4.4 KVCache 命中率优化#
三层 HiCache(device / host / storage)都改成 SWA 感知后,每层各自维护”哪些位置有有效 SWA”。但异步流水线、跨部署缓存不一致、跨会话前缀长度差异,会让 Full Attention cache 和 SWA 索引在层与层之间不同步。一旦 Full 命中而 SWA miss,匹配长度会被严重裁剪,导致重算膨胀、SWA 优化效果大打折扣。
团队针对三种”层间不一致”做了主动修复:
- Device 完整,Host 缺失:在节点合并 / Prefill 完成等时机检查 SWA 占用 delta,在 host 端补 slot,异步 D2H 把 device SWA KV 写过去
- Host 完整,Device 缺失:等下次 H2D 传输自然对齐,无需主动修复
- 高频序列 L3 前缀被驱逐:访问 L1/L2 时周期性回查 L3,防止 storage 端按 LRU 提前淘汰了”机器级高频前缀”
- 中短序列 SWA 保留策略:在固定长度位置保留较密集的 SWA KV,虽然 SWA 在总 KV 中比例上升,但能直接利好”多用户共享系统 prompt”这类场景
效果:主流高质量框架下,服务端 KVCache 命中率平均 93%,重度用户 ≥95%。
五、GCache:自研高性能分布式缓存#
GCache 是小米存储团队为推理场景定制的高性能通用缓存系统。它既是模型分发的存储产品,也是 L3 KVCache。
5.1 架构设计#
几个关键设计:
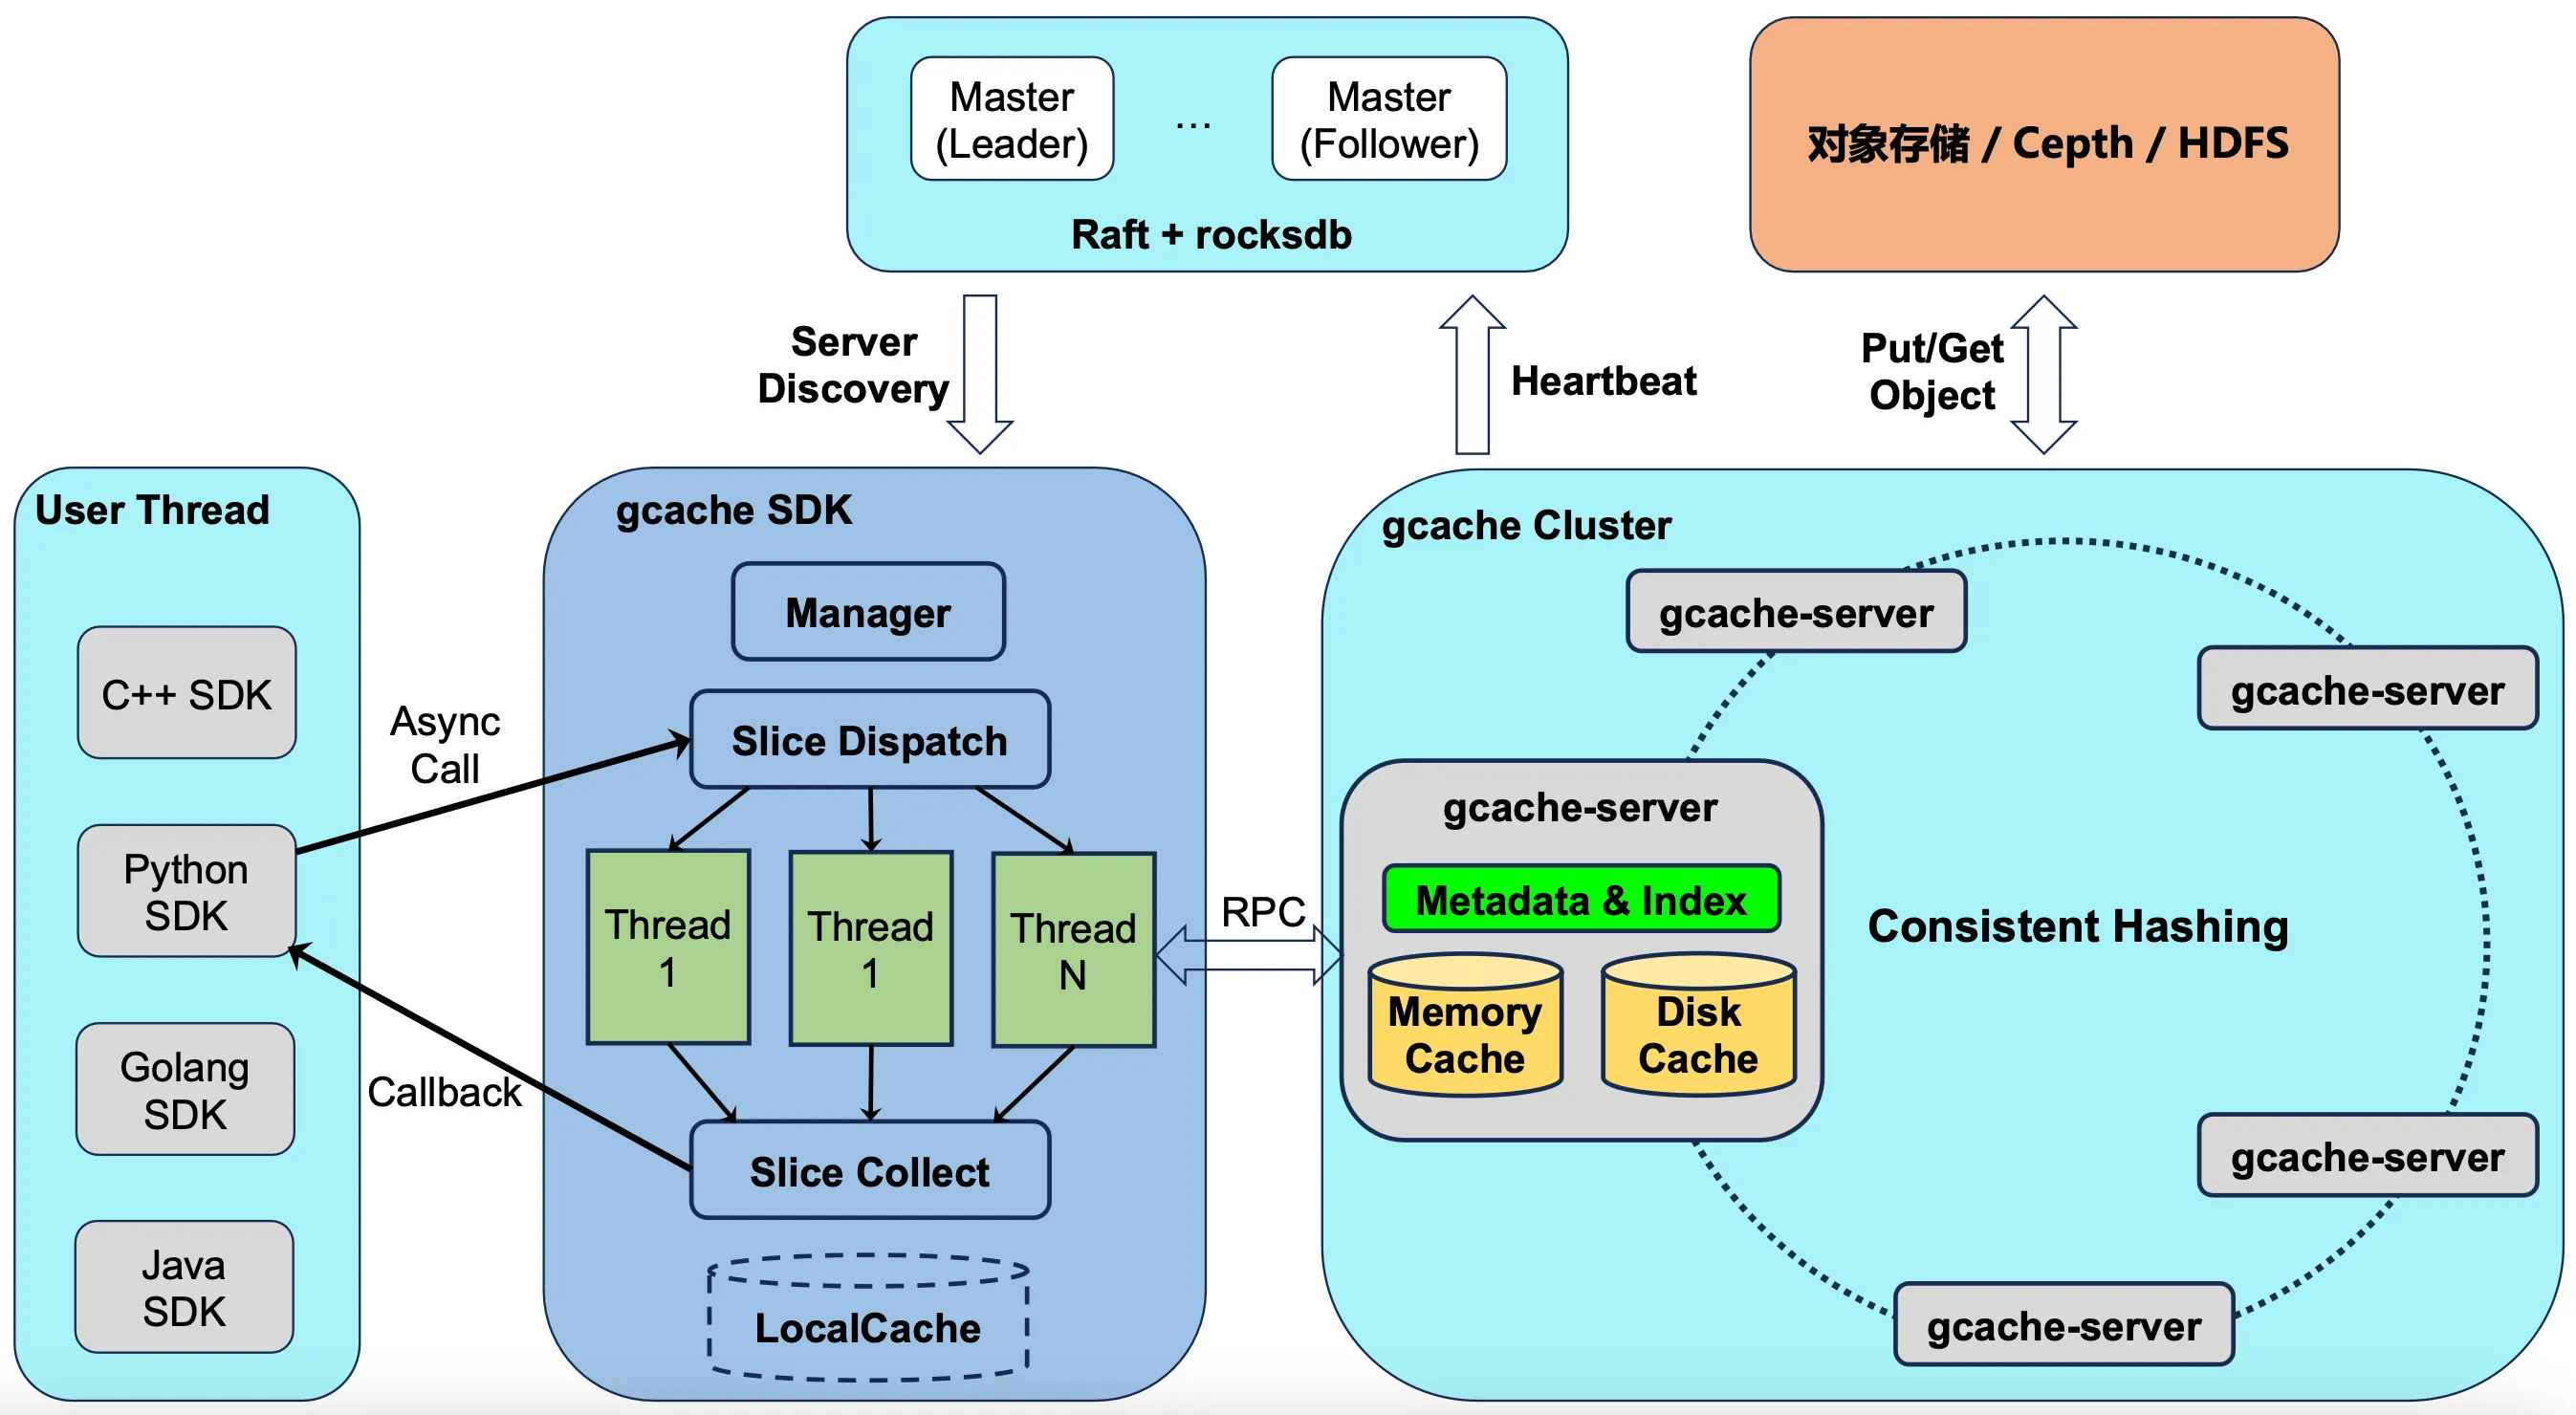
- 去中心化元数据:用一致性哈希直接定位存储位置,集群可以无限水平扩展
- Master 只管心跳 / 服务发现:Raft 高可用,但 IO 路径不经过 Master
- 服务端内存 + 磁盘双级缓存:内存冷数据自动落盘,磁盘热数据自动回提——对”长空闲但偶发访问”的会话场景特别友好
- 共享内存持久化:服务重启不丢缓存;扩缩容也不丢
- 多语言 SDK + 专用 IO 线程:不占用户线程,IO 切片控制在 RDMA 友好区间,回调粒度灵活(KV / batch / CUDA stream 级别)
5.2 网络优化#
主流 GPU 机器配 8×400G NIC,但即便 PD 分离部署,开源推理框架也常常打不满带宽——行业里甚至开始呼吁”降配 NIC 规格”。
GCache 的做法是 优先占用 GPU NIC 而非前端 NIC,并在通信模块里做 NUMA binding、same-rail affinity 等优化。基准测试结果:
| 场景 | 单进程吞吐 | 延迟 |
|---|---|---|
| 1MB IO 大小 RDMA 读 | 170 GB/s | 280 μs |
| GDR 场景 | ~350 GB/s | — |
对推理框架通信来说绰绰有余。
5.3 成本与可靠性#
- 零额外存储成本:与 GPU 机器共部署,吃 Prefill / Decode 节点的富余内存 + 内置 NVMe SSD
- 高故障率 = 必须做容错:上线以来几乎每天都有机器故障,团队做了三件事:① 大量容错逻辑加固;② 一致性哈希 + 会话 ID 预分组,让关联会话分散到不同节点缩小故障半径;③ 利用底层平台硬件检测做主动发现和自动迁移
- 单机即可单副本:因为容错做得到位,不需要多副本冗余换可用性 → 成本进一步下降
💡 小吴笔记:GCache 的故事告诉我们一个普适规律:“共部署 + 强容错” = 极低单位成本。同样的逻辑也适用于 vLLM / SGLang 社区在做的 LMCache。
六、调度优化:LLM-Router#
SGLang 社区早期 router 服务没有跨实例共享状态,单点故障会直接导致 KVCache 退化。MiMo 自研了 LLM-Router:基于 Redis 集中存储的、可弹性伸缩的无状态调度器,彻底消除单点故障导致的缓存退化。
6.1 KVCache + 负载亲和调度#
HiCache 对 L2 命中率极度敏感——L2 miss 就必须同步等 L3 取回。Router 端在多个 Prefill 实例里做”命中优先 + 负载均衡”的调度:
score(worker) = matchWeight × prefix_match_percentage − normalized_load部署后效果:
- L2 命中率提升 ~25%
- 单节点输入吞吐提升 ~30%
6.2 TTFT 优化#
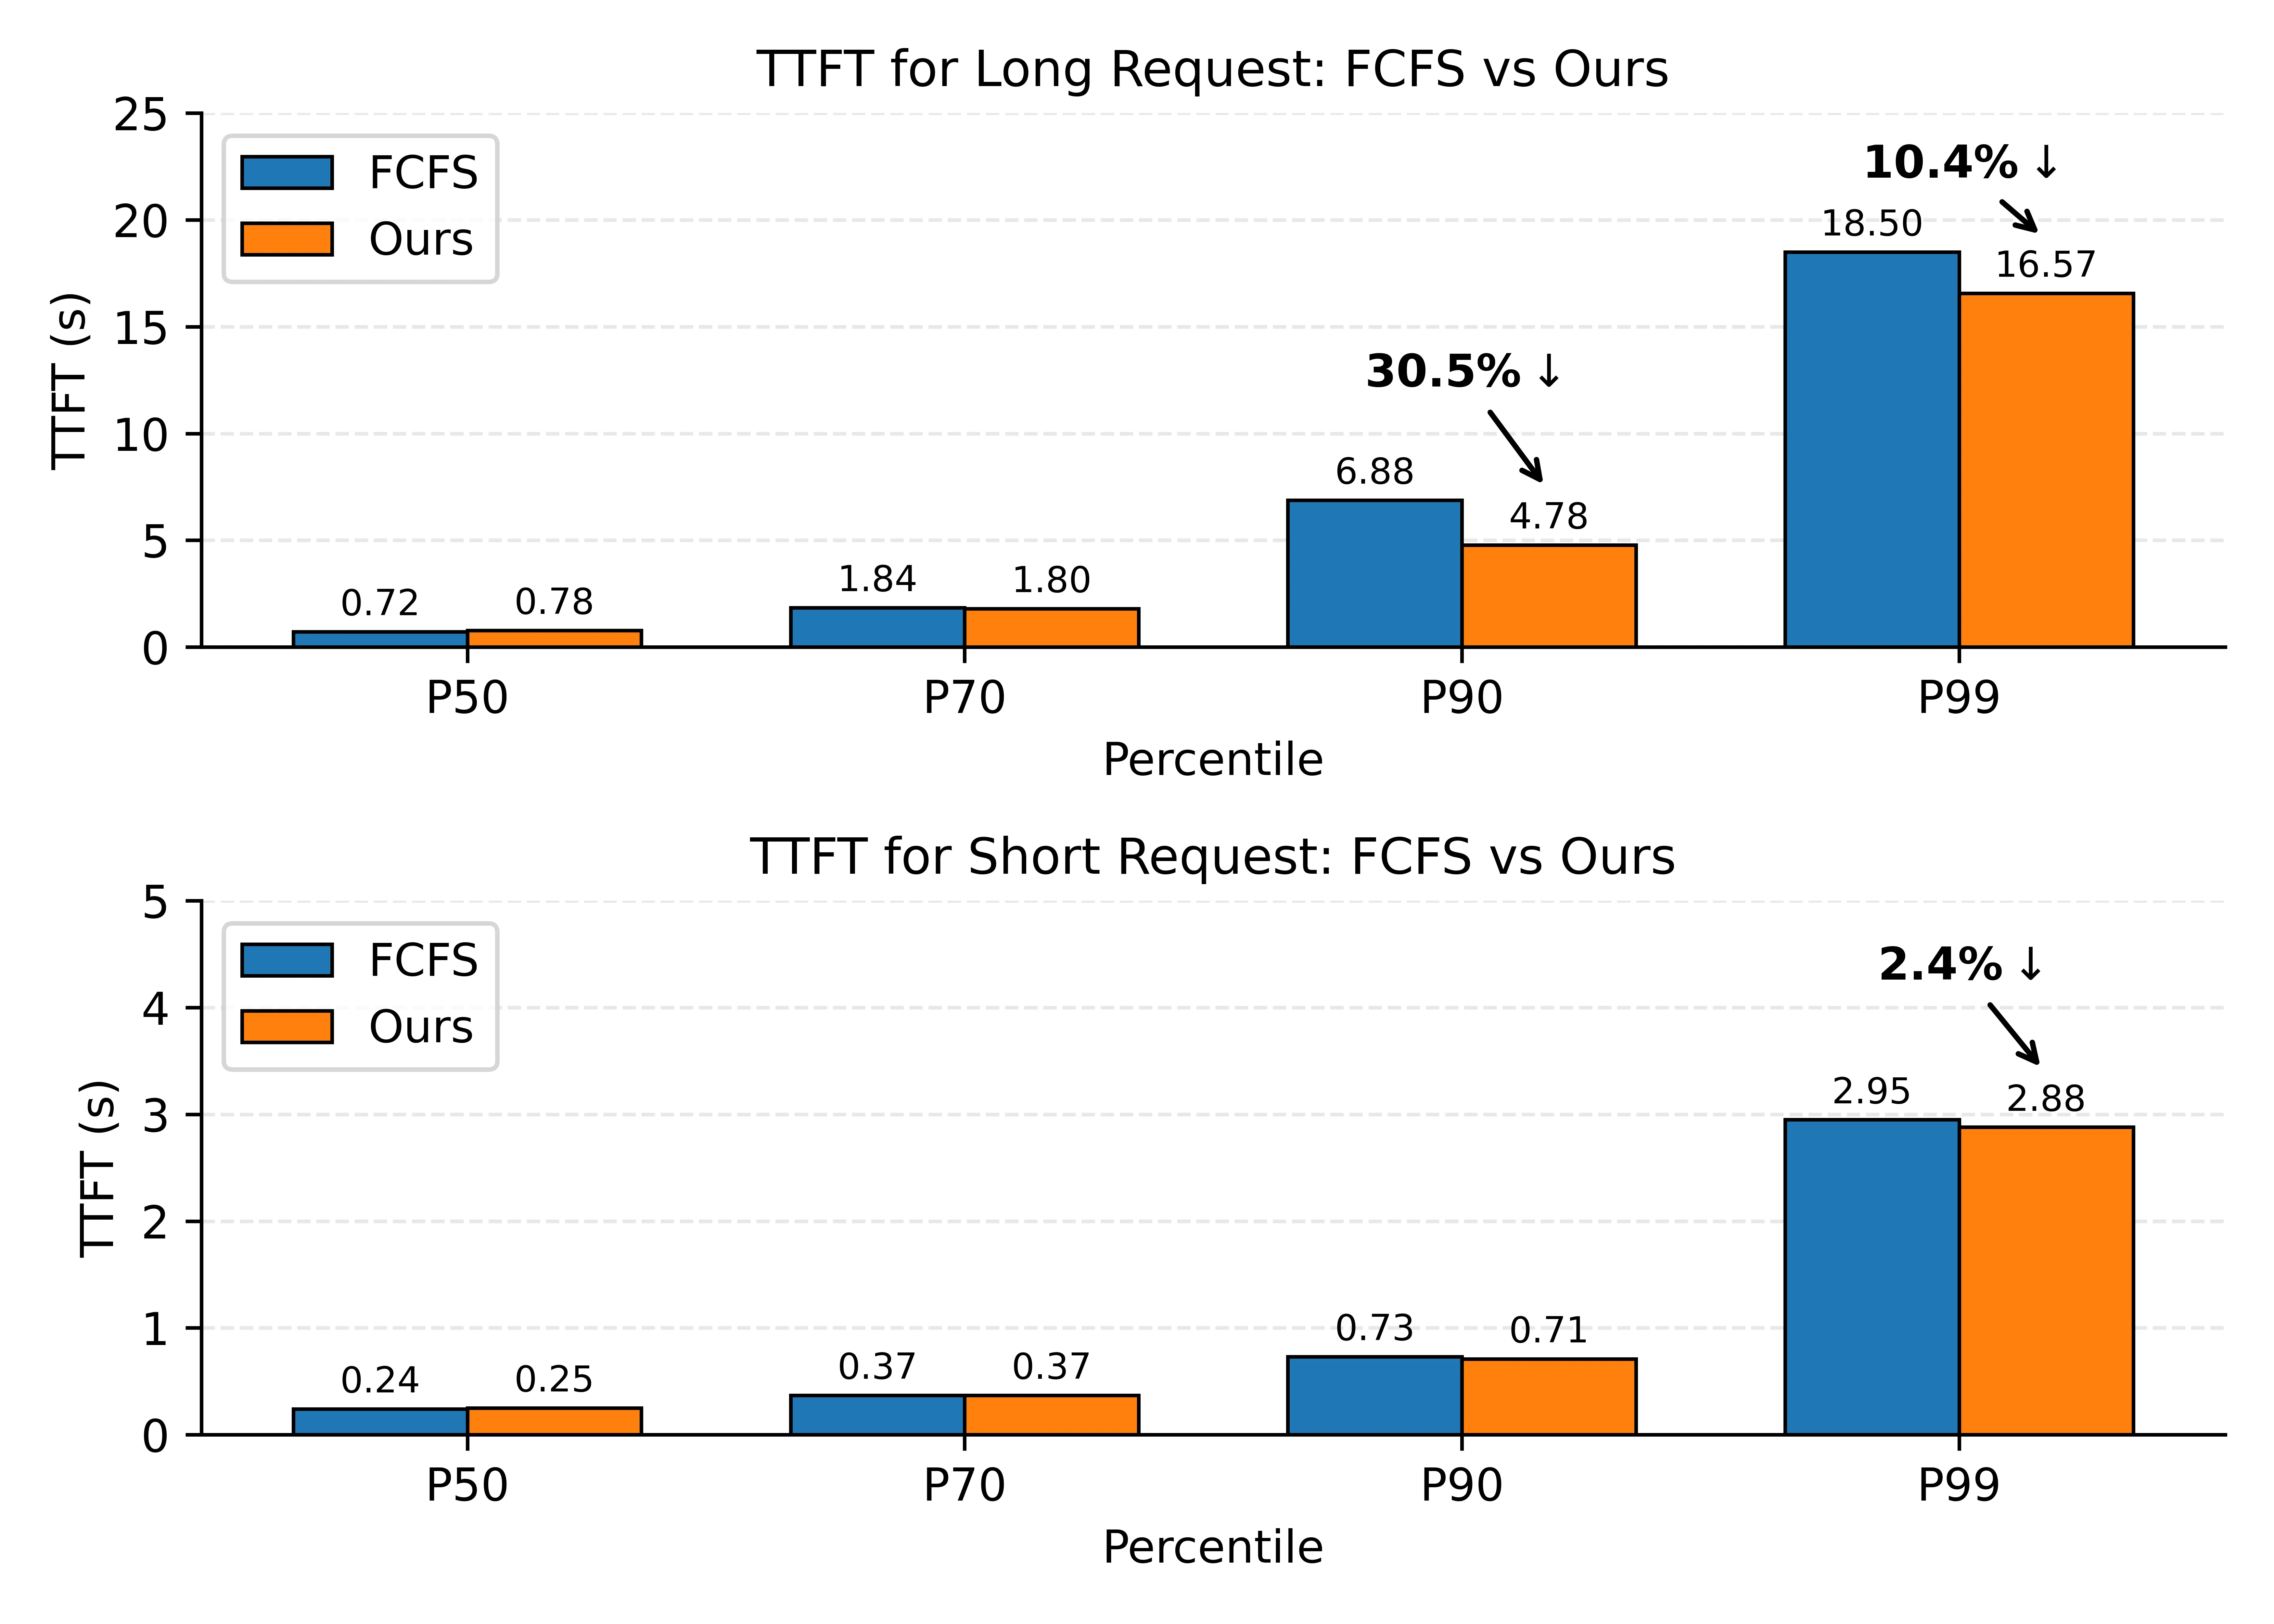
排队时,传统 FCFS 不区分”高 cache 命中、低算力”和”低 cache 命中、高算力”两类请求。结果是 cache 友好的请求被慢请求阻塞,TTFT P99 异常高,平均吞吐被拖垮。
新策略:优先调度 uncached token 数少的请求,并加等待时间惩罚避免饥饿。效果:
- 长请求 TTFT P90 最多下降 30%
- 短请求 TTFT 几乎不变(不受影响)
七、Prefill 优化#
7.1 并行配置:EP 减半,端到端 +40%#
理论 EP 越小越好——跨机通信少、DP 实例少、Moe 负载更均衡。但 EP 受限于 GPU 显存(要装下模型参数 + KVCache)。
过去因为 SWA 也得存全量 KVCache,EP 被迫开大;现在 SWA pool 只存窗口内 token,EP 可以直接砍到原来一半,端到端性能提升约 40%。后续还在探索 PP 进一步缩小 EP 的空间。
7.2 长度分桶策略#
MiMo-V2.5 在 Chunked Prefill 固定 16K 计算块下,前缀越长吞吐越差:
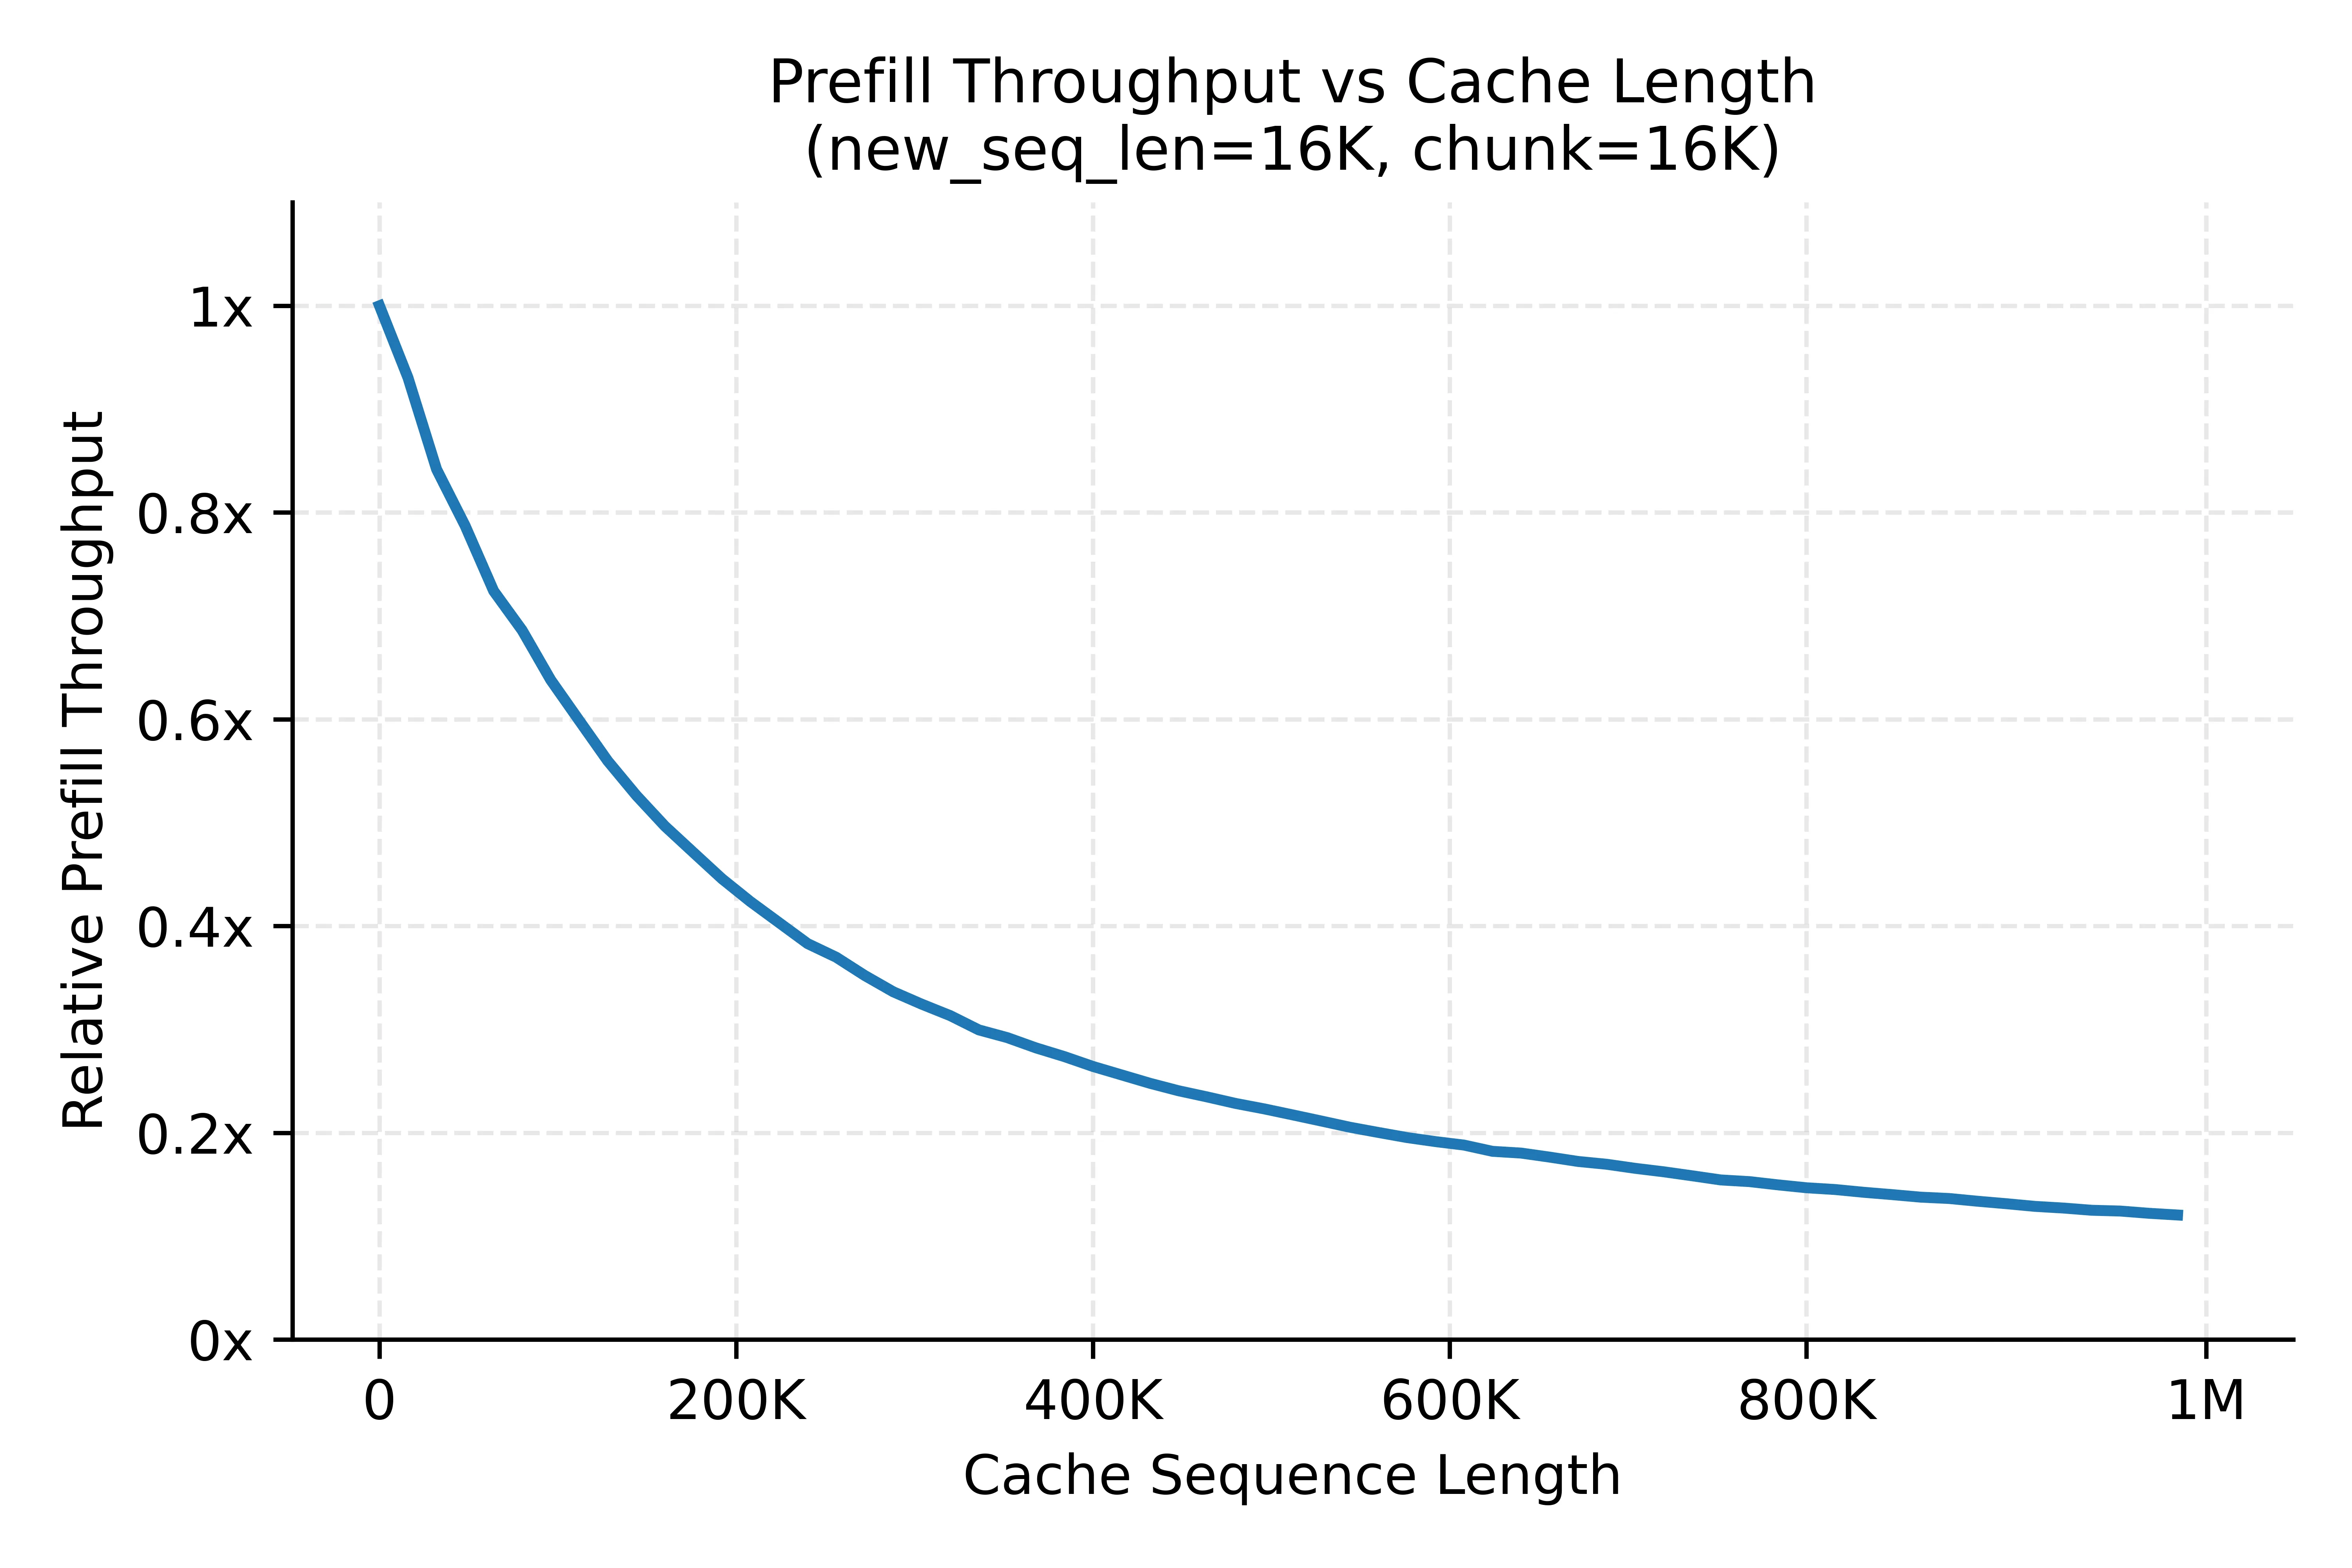
Agent 场景下超长请求大多来自多轮对话 + 大段 prefix 缓存。短请求被长请求拖慢的两种典型场景:
- DP-Attention 同步:每层 attention 后多 DP 要做 collective 通信再进 MoE,跨 DP 长短不一就会等
- Chunked Prefill 干扰:同 chunk 内短前缀被长前缀拖慢
解决方案:三档长度分桶(0–64K / 64K–256K / 256K–1M),把同档请求聚到同一 bucket 计算。生产 Prefill 平均吞吐显著提升。团队还在探索更细粒度的动态分桶。
7.3 MoE 负载均衡#
由于预训练阶段就引入了负载均衡训练目标,推理时各层专家路由已经比较均匀——平均每层 expert load factor(均值/最大值)约 0.85。团队目前 没有引入任何 expert load balancing 策略,只持续监控该指标。
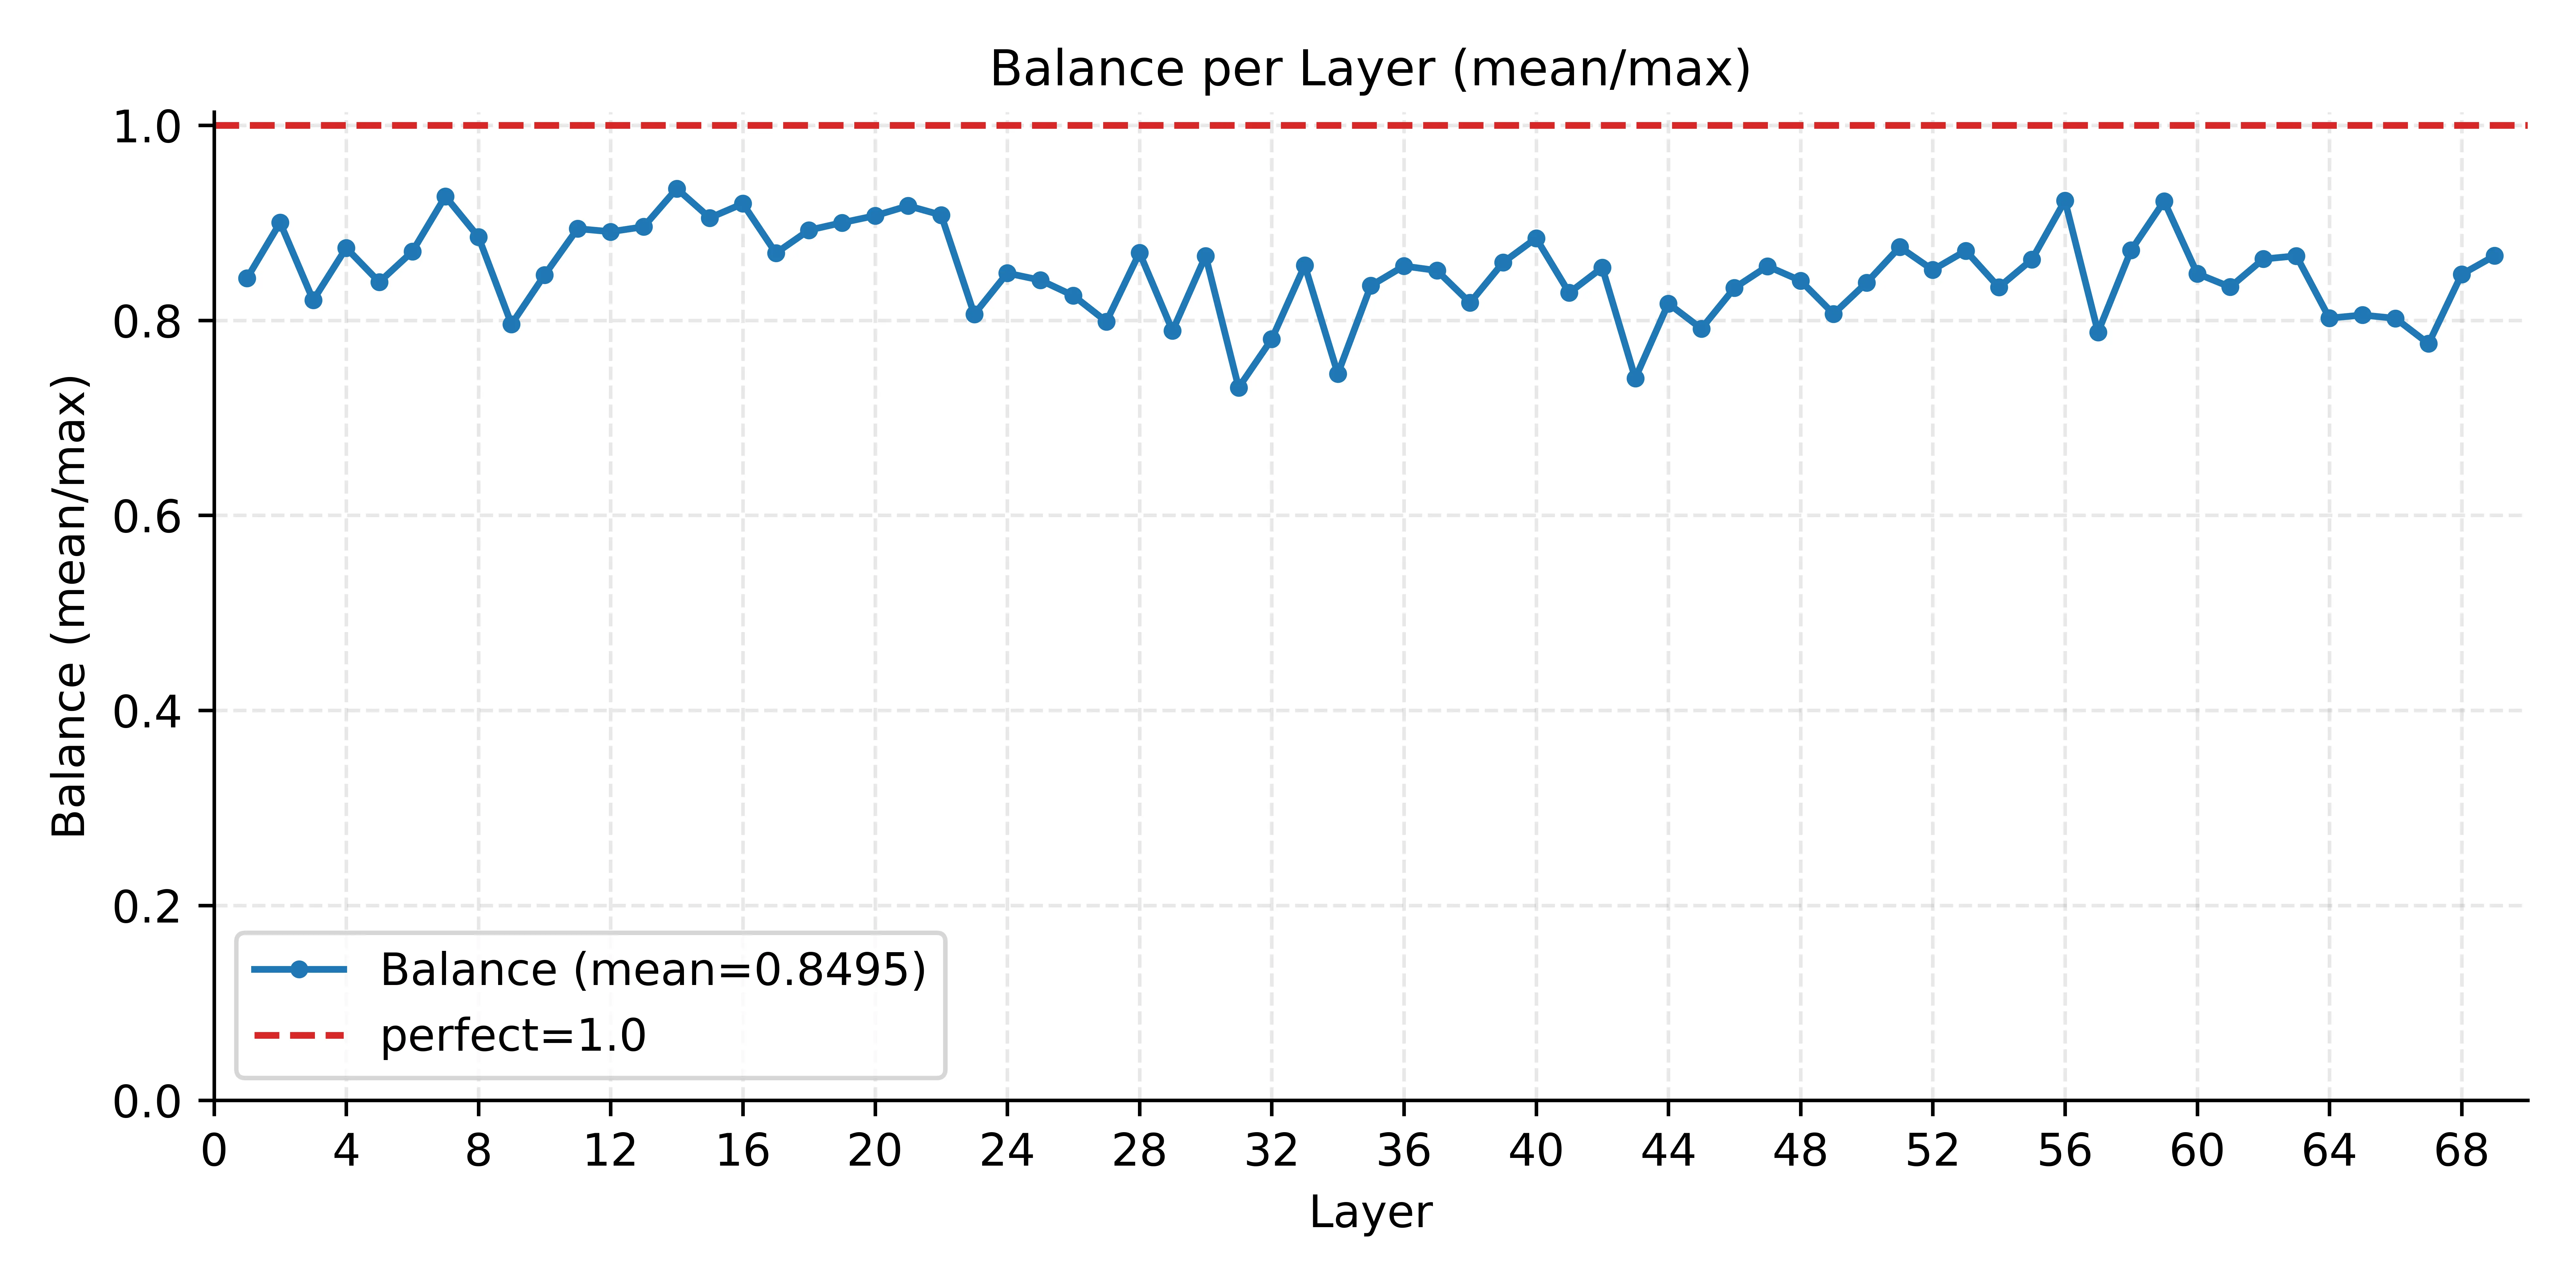
💡 小吴笔记:很多 MoE 推理优化的”标准动作”在这里反而被简化了——“训练阶段把不均衡解决掉,推理阶段就能省下 LB 策略开销”,是一个值得借鉴的设计哲学。
7.4 修一个隐藏的 NUMA 坑#
部分 Ubuntu 的 numa_balancing 内核参数与 SGLang 的 numa-node 配置冲突,会在计算 kernel 之间随机插入大空隙。多机多卡下,rank 之间步调不一致,每次 collective 通信都被最慢 rank 拖累。关掉 numa_balancing 后端到端性能提升约 10%——典型的”找到一个 10% 提升只需要关一个开关”的工程经验。
八、Decode 优化#
8.1 GPU 显存优化#
Agent 场景下多轮对话让 context 不断增长,KVCache 显存成为 decode 瓶颈。三个改动:
- Decode KVCache 启用 SWA → 单卡有效容量 ~5×
- PD 分离预分配改到 CPU:把请求准入时的 KVCache 预分配从 GPU 显存挪到 CPU 内存,decode 真正开始时再上 GPU
- CUDA Graph 显存调优:减少浪费,进一步扩大 KVCache 容量
8.2 MTP 优化#
MiMo-V2.5 原生支持 3 层 MTP(Multi-Token Prediction)加速 decode,但 prefill 阶段没开 MTP。结果 decode 前 128 个 token 的 MTP 层 KVCache 全部失效,预测接受率极低。Agent 场景输出又短,这一限制把 MTP 的有效加速基本废掉了。
修复:Prefill 阶段也开 MTP,并针对 HiCache L2/L3 做专门适配。效果:
| 区间 | 加速比 |
|---|---|
| 0–128 token | 2.3× |
| 128–256 token | 1.5× |
九、多模态推理优化#
基于 SGLang v0.5.7 的 EPD 拆解,团队做了一系列工程优化和稳定性修复,Encoder 吞吐翻倍,P90 延迟反而下降:
| 指标 | 优化前 | 优化后 |
|---|---|---|
| QPS | 15 | 30 |
| 平均延迟 | 78.39 ms | 80.28 ms |
| P90 延迟 | 100.76 ms | 82.94 ms |
9.1 架构优化#
- 多模态 embedding 传输与推理 overlap:prefill scheduler 主循环中支持 embedding 在 TP rank 之间异步复制,与 prefill 推理并行
- Encoder Data Parallel:Encoder 模型小,TP>1 反而掉性能;改成 TP=1 + DP,单机 8 卡部署运维更简单
- 跨请求 Encoder 批处理:EPD Encoder Server 按模态聚合并发请求,多请求的 image / audio 合并成一个 forward 再拆分,直接解决”按请求编码 GPU 利用率低”问题
9.2 预处理优化#
- 图像预处理上 GPU:大图 resize / normalize / patchify 走 CPU 会显著抬升端到端延迟,搬上 GPU 后 CPU 不再卡
- 并行下载 + 解码:多进程下载 + PIL 解码,避免串行下载和 GIL 竞争
- 下载与 forward 解耦:原来下载和推理串行(无论批内还是批间),GPU 都在等下载;用消息队列解耦,批内下载与推理并行
- 视频并行解码:把帧抽取索引均分成 N 段,每段起一个独立 VideoDecoder 并行解码,1 小时视频端到端 Encoder 延迟从 156s 降到 23s
9.3 缓存优化#
- Encoder 一致性哈希:多 Encoder 场景下,prefill 轮询选 Encoder 会拉低多模态缓存命中。改成一致哈希,缓存命中 +30%
- 节点内 Embedding 共享:用共享内存让同节点多 Encoder GPU 共享多模态缓存
十、总结与启示#
回头看,MiMo-V2.5 系列的推理效率不是靠”某一个突破”,而是 Hybrid SWA + MoE + 多模态在每一层都被协同优化 才拿下来的:
- 架构层:Hybrid SWA 给了 1/7 的理论上限
- 系统层:KVCache 双池 + SWA 感知前缀树 + GCache 把这个上限兑现到生产
- 调度层:LLM-Router 的 cache-affinity + TTFT 优化让 P90 不爆
- 流水线层:EP 减半 + 长度分桶 + MTP Prefill 把 Prefill/Decode 两段都榨干
- 多模态层:EPD 拆解 + 预处理 GPU 化 + 缓存共享让 Encoder 吞吐翻倍
最后一句非常值得记住:
我们是第一个全面覆盖 Hybrid SWA + MoE + 多模态 复合架构的大规模工程实现,并把节省下来的成本以 API 降价的方式反馈给用户。同时,我们已经把一部分优化以 PR 形式回馈到 SGLang 开源社区。
这句话有三层意思:① 这套组合架构的优化”门槛”足够高,没有捷径;② 工程红利最终会反映到 API 价格上;③ 国产大模型推理栈已经在反哺开源社区。
参考资料: