本文基于 2026-09 时点
master分支(minimind-3 主线)的源码分析。项目地址:jingyaogong/minimind ↗。
一、这是个什么项目#
jingyaogong/minimind ↗ 从 2024 年 7 月开仓库,目前 57.5k stars / 7.5k forks,Apache-2.0 协议。它的一句话定位是:
仅用 3 元成本 + 2 小时训练时间(单张 3090),从零训练出一个参数量约 64M、体积约为 GPT-3 的 1/2700 的中文对话模型。
但真正让它在一众”toy LLM”项目里拉开差距的,不是”小”,而是全:
| 维度 | 覆盖内容 |
|---|---|
| 模型结构 | Dense + MoE 双版本,主线对齐 Qwen3 / Qwen3-MoE 生态 |
| 训练全流程 | Pretrain → SFT → LoRA → 知识蒸馏 → DPO(RLHF)→ PPO / GRPO / CISPO(RLAIF)→ Agentic RL |
| 周边能力 | Tokenizer 训练、Tool Calling、自适应思考(<think>)、YaRN 长文外推、断点续训、DDP 多卡 |
| 工程接口 | OpenAI 兼容 API、Streamlit WebUI、llama.cpp / vllm / ollama 兼容转换 |
更关键的一条原则是:所有核心算法全部用原生 PyTorch 从零实现,不依赖 trl / peft 等框架的高层接口。整个仓库核心代码只有约 4300 行,每一个算法都能逐行读完。这使它成为目前中文社区里最完整的”LLM 全流程最小复现”教材。
先看代码结构,后面所有章节按这张图展开:
minimind/
├── model/
│   ├── model_minimind.py      # 287 行:整个模型结构(全部核心)
│   ├── model_lora.py          # 65 行:LoRA 实现与合并
│   ├── tokenizer.json         # 6400 词表(BPE + ByteLevel)
│   └── tokenizer_config.json  # chat_template 在这里
├── dataset/
│   └── lm_dataset.py          # 5 个 Dataset:Pretrain/SFT/DPO/RLAIF/AgentRL
├── trainer/
│   ├── train_pretrain.py      # 预训练(171 行)
│   ├── train_full_sft.py      # 全参 SFT
│   ├── train_lora.py          # LoRA 微调
│   ├── train_distillation.py  # 知识蒸馏
│   ├── train_dpo.py           # DPO
│   ├── train_ppo.py           # PPO(Actor+Critic+GAE,450 行)
│   ├── train_grpo.py          # GRPO / CISPO
│   ├── train_agent.py         # Agentic RL:多轮工具调用(492 行)
│   ├── rollout_engine.py      # 训推分离抽象层
│   └── trainer_utils.py       # checkpoint / 分布式 / LR 调度
├── scripts/                   # web_demo / serve_openai_api / convert_model / eval_toolcall
└── eval_llm.py # CLI 推理入口项目还有一个官方给出的训练成本账本(单卡 3090,约 1.3 元/小时):
| 阶段 | 数据 | 耗时 | 成本 |
|---|---|---|---|
| Pretrain | pretrain_t2t_mini | ≈1.21h | ≈1.57¥ |
| SFT | sft_t2t_mini | ≈1.10h | ≈1.43¥ |
| Tool Call | 混入 SFT | ≈0.9h | ≈1.17¥ |
| RLAIF | rlaif.jsonl | ≈1.1h | ≈1.43¥ |
即 3 元跑完 Pretrain+SFT 得到一个可用的 Zero 对话模型。下面开始逐层拆解。
二、模型架构:对齐 Qwen3 的极简 Decoder-Only#
2.1 配置一览#
minimind-3 主线配置(MiniMindConfig):
| 项 | 值 | 说明 |
|---|---|---|
| 参数量 | 64M(Dense)/ 198M-A64M(MoE) | MoE 为 4 experts、top-1 |
| vocab_size | 6400 | 极小词表,为小模型量身定制 |
| num_hidden_layers | 8 | 层数 |
| hidden_size (d_model) | 768 | |
| num_attention_heads | 8 | head_dim = 96 |
| num_key_value_heads | 4 | GQA,KV cache 减半 |
| intermediate_size | 1920 | ≈2.5×hidden,向上取整到 64 倍数 |
| max_position_embeddings | 32768 | 训练只用几百,推理靠 YaRN 外推 |
| rope_theta | 1e6 | |
| tie_word_embeddings | True | embedding 与 lm_head 共享 |
| hidden_act | silu | SwiGLU 的一部分 |
整体结构图(Dense 与 MoE):
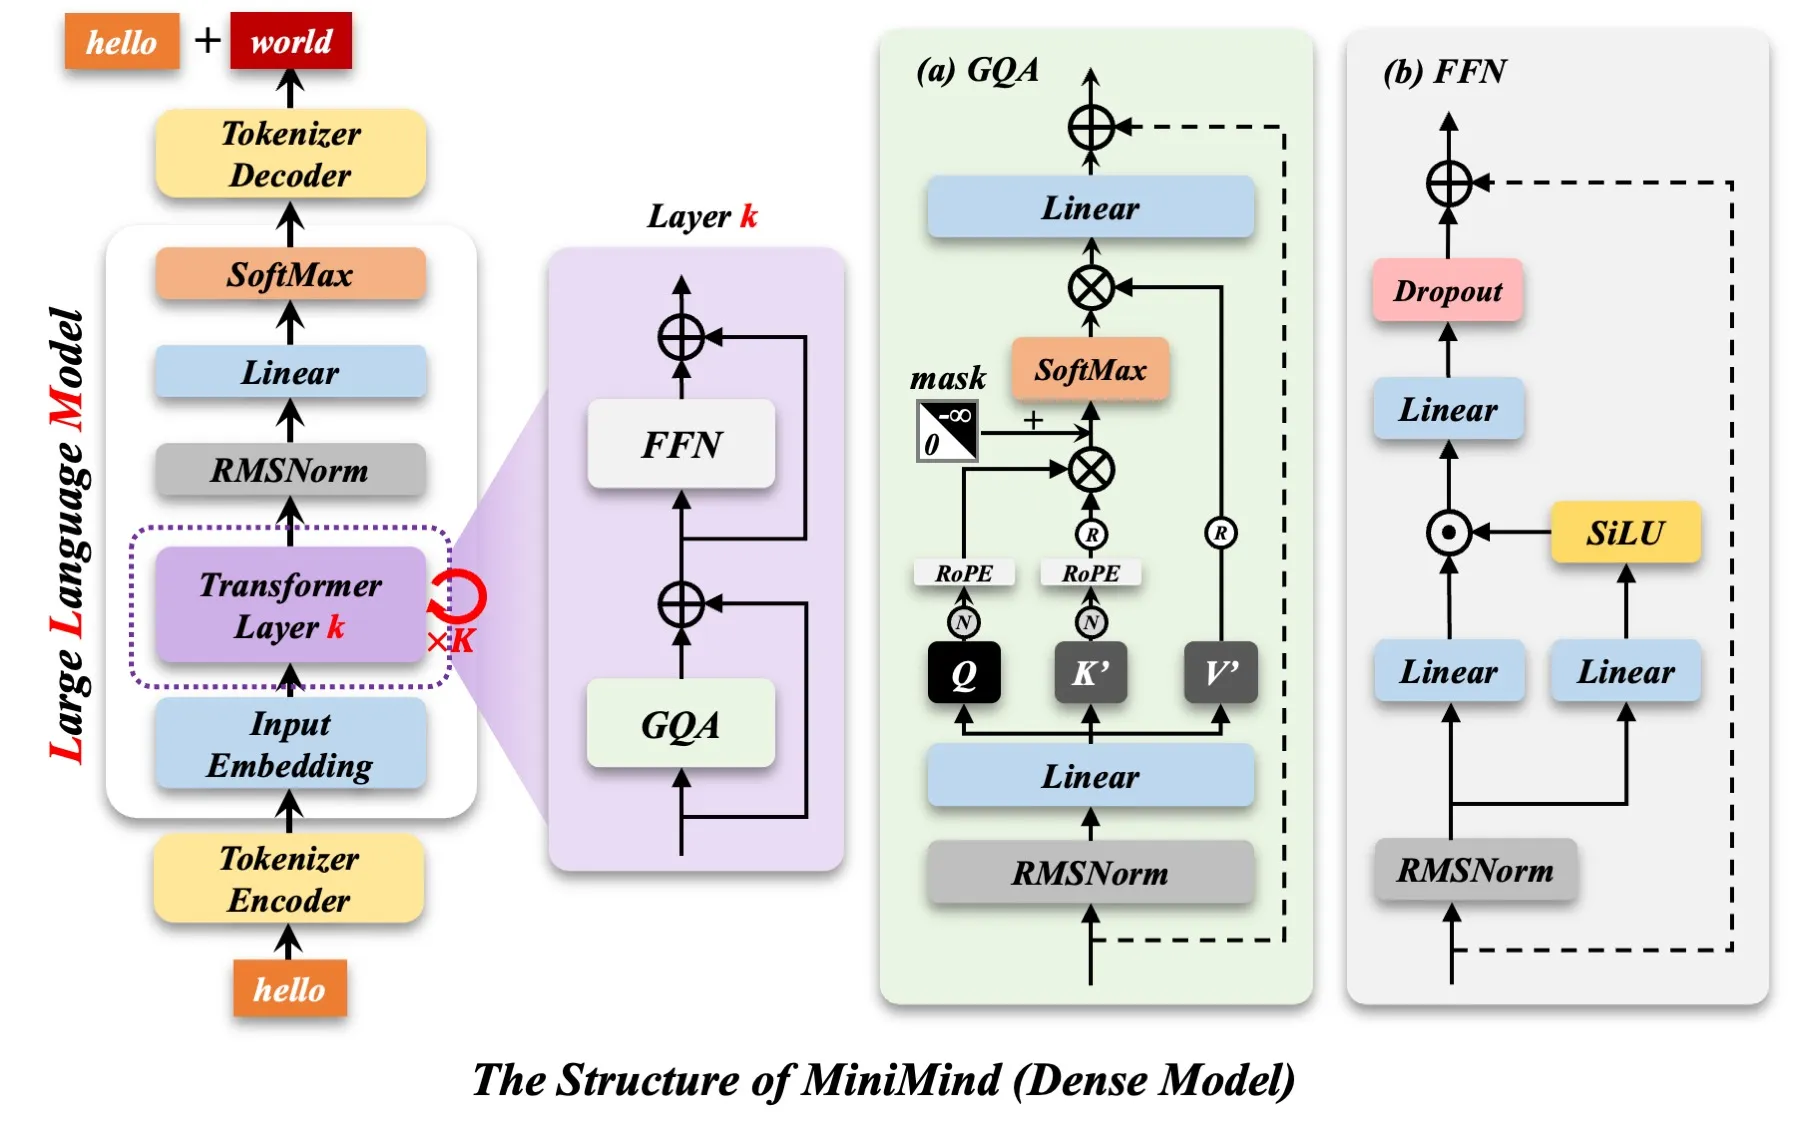
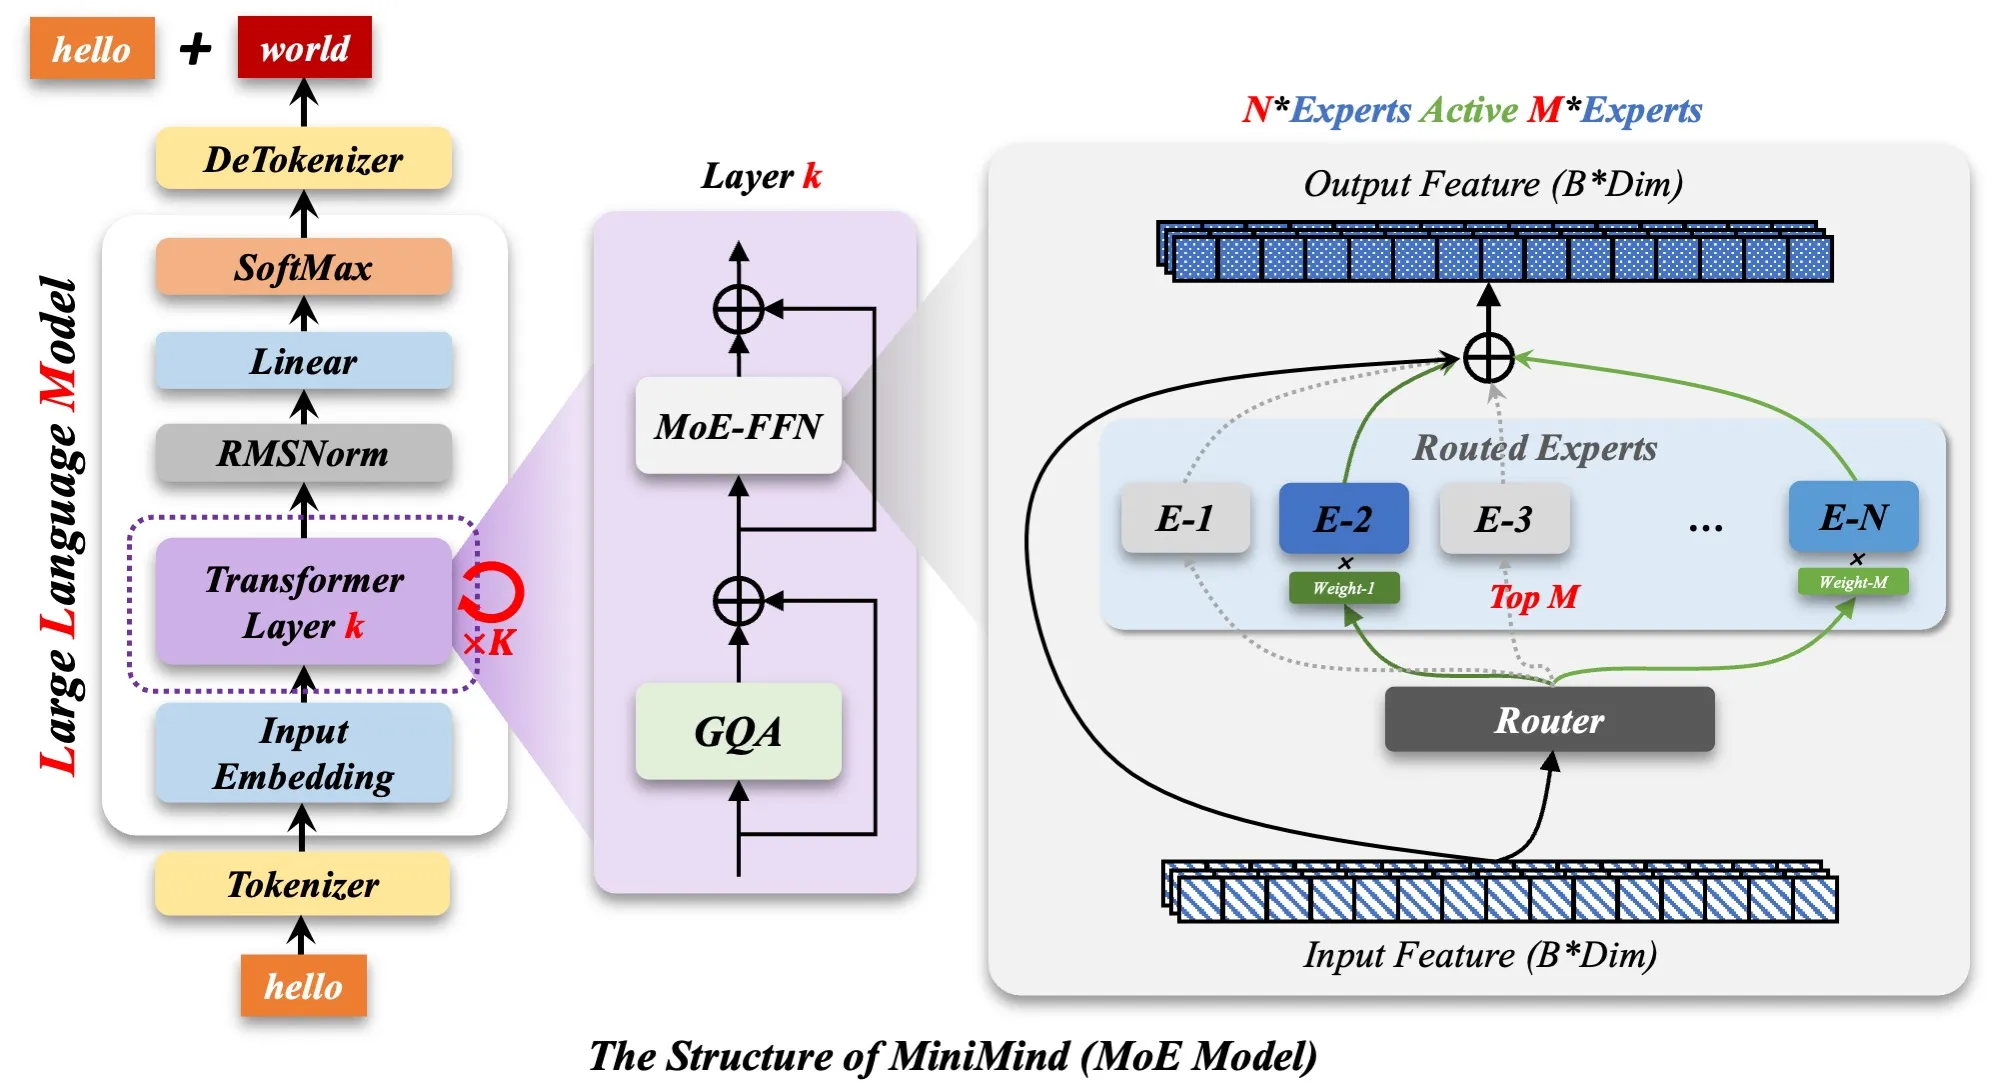
架构选型上完全跟随当前主流(也就是 Qwen3 / Llama 系):Pre-Norm + RMSNorm、SwiGLU、RoPE、GQA。没有任何自创结构——这是刻意为之:结构对齐主流生态,权重才能无缝转换到 transformers / llama.cpp / vllm / ollama。
先手算一遍参数量,感受一下 64M 花在哪了。单层参数:
- Attention:q_proj
768×768+ k_proj768×384+ v_proj768×384+ o_proj768×768≈ 1.77M(GQA 让 k/v 各砍半) - MLP:gate / up / down 三个
768×1920≈ 4.42M - 两个 RMSNorm ≈ 1.5K
单层合计 ≈ 6.19M,8 层 ≈ 49.5M;加词嵌入 6400×768 ≈ 4.9M(tie 之后 lm_head 不再单独计数),总计 ≈54.5M。官方标称 64M 与这个数的差值来自统计口径(是否计 lm_head、buffer 等),量级一致。可以看到一个残酷的事实:64M 的模型里,词嵌入占了近 10%——这就是为什么小模型必须用极小词表(第三节展开)。
2.2 RMSNorm:5 行代码#
class RMSNorm(torch.nn.Module):
    def norm(self, x):
        return x * torch.rsqrt(x.pow(2).mean(-1, keepdim=True) + self.eps)
    def forward(self, x):
return (self.weight * self.norm(x.float())).type_as(x)相比 LayerNorm 去掉了均值中心化,只保留缩放,计算量更小,训练大模型时数值也更稳。注意 forward 里先升 float() 再归一化、最后 .type_as(x) 降回去——这是混合精度训练下的标准防溢出写法。
2.3 RoPE 与 YaRN:位置编码的全部细节#
RoPE 的预计算放在模型初始化时一次性完成(precompute_freqs_cis),forward 里只做查表 + 旋转:
def precompute_freqs_cis(dim, end=32*1024, rope_base=1e6, rope_scaling=None):
    freqs = 1.0 / (rope_base ** (torch.arange(0, dim, 2)[:(dim // 2)].float() / dim))
    if rope_scaling is not None:  # YaRN 外推
        ...
        freqs = freqs * (1 - ramp + ramp / factor)
    t = torch.arange(end, device=freqs.device)
    freqs = torch.outer(t, freqs).float()
    freqs_cos = torch.cat([torch.cos(freqs), torch.cos(freqs)], dim=-1)
    freqs_sin = torch.cat([torch.sin(freqs), torch.sin(freqs)], dim=-1)
return freqs_cos, freqs_sin两个细节值得注意:
rope_theta=1e6。base 越大,各维度的旋转角频率越低,可编码的位置范围越远。训练长度只有几百 token,却把 max_position_embeddings 设到 32768、theta 拉到 1e6,就是给推理期 YaRN 外推留空间。- YaRN 分支。
freqs = freqs * (1 - ramp + ramp / factor)这一行就是 YaRN 的核心:对频率维度做线性斜坡插值——高频维度(编码局部位置)基本不动,低频维度(编码长程位置)压缩 factor 倍,从而免训练把上下文拉长。配置里factor=16, original_max_position_embeddings=2048,即训练 2K、推理可外推到 32K。
旋转的应用是标准的”rotate-half”形式:
def apply_rotary_pos_emb(q, k, cos, sin, unsqueeze_dim=1):
    def rotate_half(x):
        return torch.cat((-x[..., x.shape[-1]//2:], x[..., :x.shape[-1]//2]), dim=-1)
    q_embed = q * cos.unsqueeze(unsqueeze_dim) + rotate_half(q) * sin.unsqueeze(unsqueeze_dim)
...另外 MiniMindModel.forward 里有一段防御性代码:如果检测到 freqs_cos buffer 全零(transformers≥5.x 的 meta device 初始化会丢失非持久化 buffer),就现场重算。这是真实被 issue 打脸后补上的补丁,读源码时能感受到项目是被大量用户实际跑过的。
2.4 Attention:GQA + QK-Norm + 手写/Flash 双路径#
Attention 是模型里最长的单个模块,要点逐个看:
① GQA(Grouped Query Attention):8 个 query 头共享 4 组 KV。推理时 KV cache 直接减半,对长上下文部署意义重大。实现上靠一个朴素的 repeat_kv 把 KV 头复制回 8 份再算注意力:
def repeat_kv(x, n_rep):
    bs, slen, num_kv_heads, head_dim = x.shape
    if n_rep == 1: return x
    return x[:, :, :, None, :].expand(bs, slen, num_kv_heads, n_rep, head_dim) \
.reshape(bs, slen, num_kv_heads * n_rep, head_dim)② QK-Norm:投影之后先过一层 q_norm / k_norm(对 head_dim 做 RMSNorm)再加 RoPE。QK-Norm 能压制 attention logits 的尖峰,是 Qwen3 / Gemma2 等新一代模型的共同选择,对训练稳定性有帮助——在 64M 这种容易训崩的小模型上尤其值得。
③ 双路径注意力:
if self.flash and (seq_len > 1) and (not self.is_causal or past_key_value is None) \
   and (attention_mask is None or torch.all(attention_mask == 1)):
    output = F.scaled_dot_product_attention(xq, xk, xv, is_causal=self.is_causal, ...)
else:
    scores = (xq @ xk.transpose(-2, -1)) / math.sqrt(self.head_dim)
    if self.is_causal:
        scores[:, :, :, -seq_len:] += torch.full((seq_len, seq_len), float("-inf"),
                                                  device=scores.device).triu(1)
    if attention_mask is not None:
        scores += (1.0 - attention_mask.unsqueeze(1).unsqueeze(2)) * -1e9
output = self.attn_dropout(F.softmax(scores.float(), dim=-1).type_as(xq)) @ xvprefill 阶段(整段新序列)走 scaled_dot_product_attention(自动选 FlashAttention / memory-efficient kernel);decode 阶段(seq_len=1 带 KV cache)或有 padding mask 时退回手写实现。条件判断写得非常克制:能走 kernel 就走 kernel,走不了就退化到手写,两条路径的数值语义保持一致。
④ KV cache 就是最朴素的形式:新算出的 k/v 与历史 torch.cat 拼接,use_cache=True 时返回。没有 paged attention、没有量化——那是推理引擎的事,训练框架保持简单。
2.5 SwiGLU 前馈#
class FeedForward(nn.Module):
    def forward(self, x):
return self.down_proj(self.act_fn(self.gate_proj(x)) * self.up_proj(x))gate 分支过 SiLU 激活后与 up 分支逐元素相乘,再经 down 投回 768 维。三个矩阵全部 bias=False——现代 LLM 的共识是线性层 bias 收益约等于零,省参数省麻烦。
2.6 MoE:4 专家 top-1,刻意不做 shared expert#
MOEFeedForward 替换每个 Block 里的 MLP。核心路由逻辑:
x_flat = x.view(-1, hidden_dim)
scores = F.softmax(self.gate(x_flat), dim=-1)
topk_weight, topk_idx = torch.topk(scores, k=self.config.num_experts_per_tok, dim=-1)
if self.config.norm_topk_prob:
    topk_weight = topk_weight / (topk_weight.sum(dim=-1, keepdim=True) + 1e-20)
y = torch.zeros_like(x_flat)
for i, expert in enumerate(self.experts):
    mask = (topk_idx == i)
    if mask.any():
        token_idx = mask.any(dim=-1).nonzero().flatten()
        weight = topk_weight[mask].view(-1, 1)
        y.index_add_(0, token_idx, (expert(x_flat[token_idx]) * weight).to(y.dtype))
    elif self.training:
y[0, 0] += 0 * sum(p.sum() for p in expert.parameters())三个值得学的点:
- 按专家分桶再前向(token 先按
topk_idx聚到各专家),这是原生 PyTorch 能做到的最朴素实现,不需要任何自定义 kernel。 elif self.training: y[0,0] += 0 * sum(params)——某个专家在一个 batch 里没被路由到时,给它造一个值为 0 但梯度连通的假项。否则 DDP 会因为”有参数没参与 backward”直接报错。这个技巧在任何原生 MoE 实现里都会遇到。- 辅助负载均衡损失放在
MiniMindModel.forward里汇总:aux_loss = (load * scores.mean(0)).sum() * num_experts * coef,即”路由频率 × 平均路由概率”的内积——鼓励各专家被均匀使用,系数默认 5e-4,相对主损失小到几乎不影响拟合,但足以防止塌缩到单专家。
README 里还有一段很实在的说明:4 experts / top-1 的原生实现比同激活参数的 dense 模型慢约 50%——因为 token 分桶带来的 kernel 启停与调度开销。“MoE 更快”只在有 fused kernel(Triton/DeepSpeed-MoE/Megatron)加持时才成立,这个项目选择保留原生普适性,接受这个折中。
2.7 输出层与 generate()#
MiniMindForCausalLM 用 tie_word_embeddings=True 把 lm_head.weight 和 embed_tokens.weight 指到同一块内存——对 6400 词表是 4.9M 参数的节省,对小模型相当于白赚 8% 参数预算。
generate() 也是手写的完整采样循环,把 temperature / top_k / top_p / repetition_penalty / batch 级 finished 控制 / streamer 流式输出全部塞进 30 行:
for _ in range(max_new_tokens):
    outputs = self.forward(input_ids[:, past_len:], attention_mask, past_key_values, use_cache=True)
    logits = outputs.logits[:, -1, :] / temperature
    # repetition penalty:对已出现 token,正分除惩罚、负分乘惩罚
    # top_k:第 k 大值以下的 logits 置 -inf
    # top_p:按概率降序累加,超过 p 的尾部置 -inf
    next_token = torch.multinomial(torch.softmax(logits, dim=-1), num_samples=1) if do_sample \
                 else torch.argmax(logits, dim=-1, keepdim=True)
    finished |= next_token.squeeze(-1).eq(eos_token_id)
if finished.all(): break注意已结束的序列会被强制填 eos_token_id 而不是提前退出,这样 batch 内所有序列形状保持一致,不需要 ragged 处理——简单粗暴但有效。
三、Tokenizer:6400 词表的取舍#
词表对比(来自项目 README):
| Tokenizer | 词表大小 | 来源 |
|---|---|---|
| Qwen2 | 151,643 | 阿里云 |
| ChatGLM | 151,329 | 智谱 |
| Llama 3 | 128,000 | Meta |
| Yi | 64,000 | 01.AI |
| Mistral | 32,000 | Mistral AI |
| MiniMind | 6,400 | 自训(BPE + ByteLevel) |
为什么敢用这么小的词表?算一笔账就懂了:词嵌入和输出头都是 vocab × hidden。若用 Qwen2 的 15 万词表,光一个嵌入层就是 151643×768 ≈ 116M——比整个 64M 模型的主体还大一倍。6400 词表下嵌入层仅 4.9M,这才把参数预算留给了真正学能力的层。代价是中文压缩率一般(本项目实测约 1.51.7 字符/token,英文 45 字符/token),但 ByteLevel 兜底保证任何文本都能编解码,不会有生僻字失败。
特殊令牌设计直接服务于后训练能力:
<|im_start|>/<|im_end|>:对话轮次边界(ChatML 风格,id 1/2 同时兼任 bos/eos);- `