当你只输入一个”主题”,从文案、配音、字幕、素材、背景音乐到一条可以直接发抖音的 1080p 短视频,都是在几十秒到几分钟之内跑完——而且每一步都能被单独调用、被单独替换、被单独暂停。
这就是 harry0703/MoneyPrinterTurbo ↗ 在做的事:把”AI 短视频生成”这个听上去很玄学的命题,落到一条可以白盒调试的工程流水线上。
这篇文章会带你从顶层架构、Provider 抽象、流水线六个工位、任务状态机、WebUI/API/CLI 三端、到工程亮点与可改进点,把这个 ~15K 行 Python 的项目拆透。读完你应该能回答:
- 为什么它用 19 个 LLM Provider 却没有写 19 段
if-else? - 为什么
edge-tts路径默认不需要跑 Whisper? - 为什么素材下载用 24h SHA-256 缓存 + md5 文件去重?
- 为什么它的任务可以”跑到一半停下来”再续跑?
一、项目概览:把短视频流水线拆成可拼装的积木#
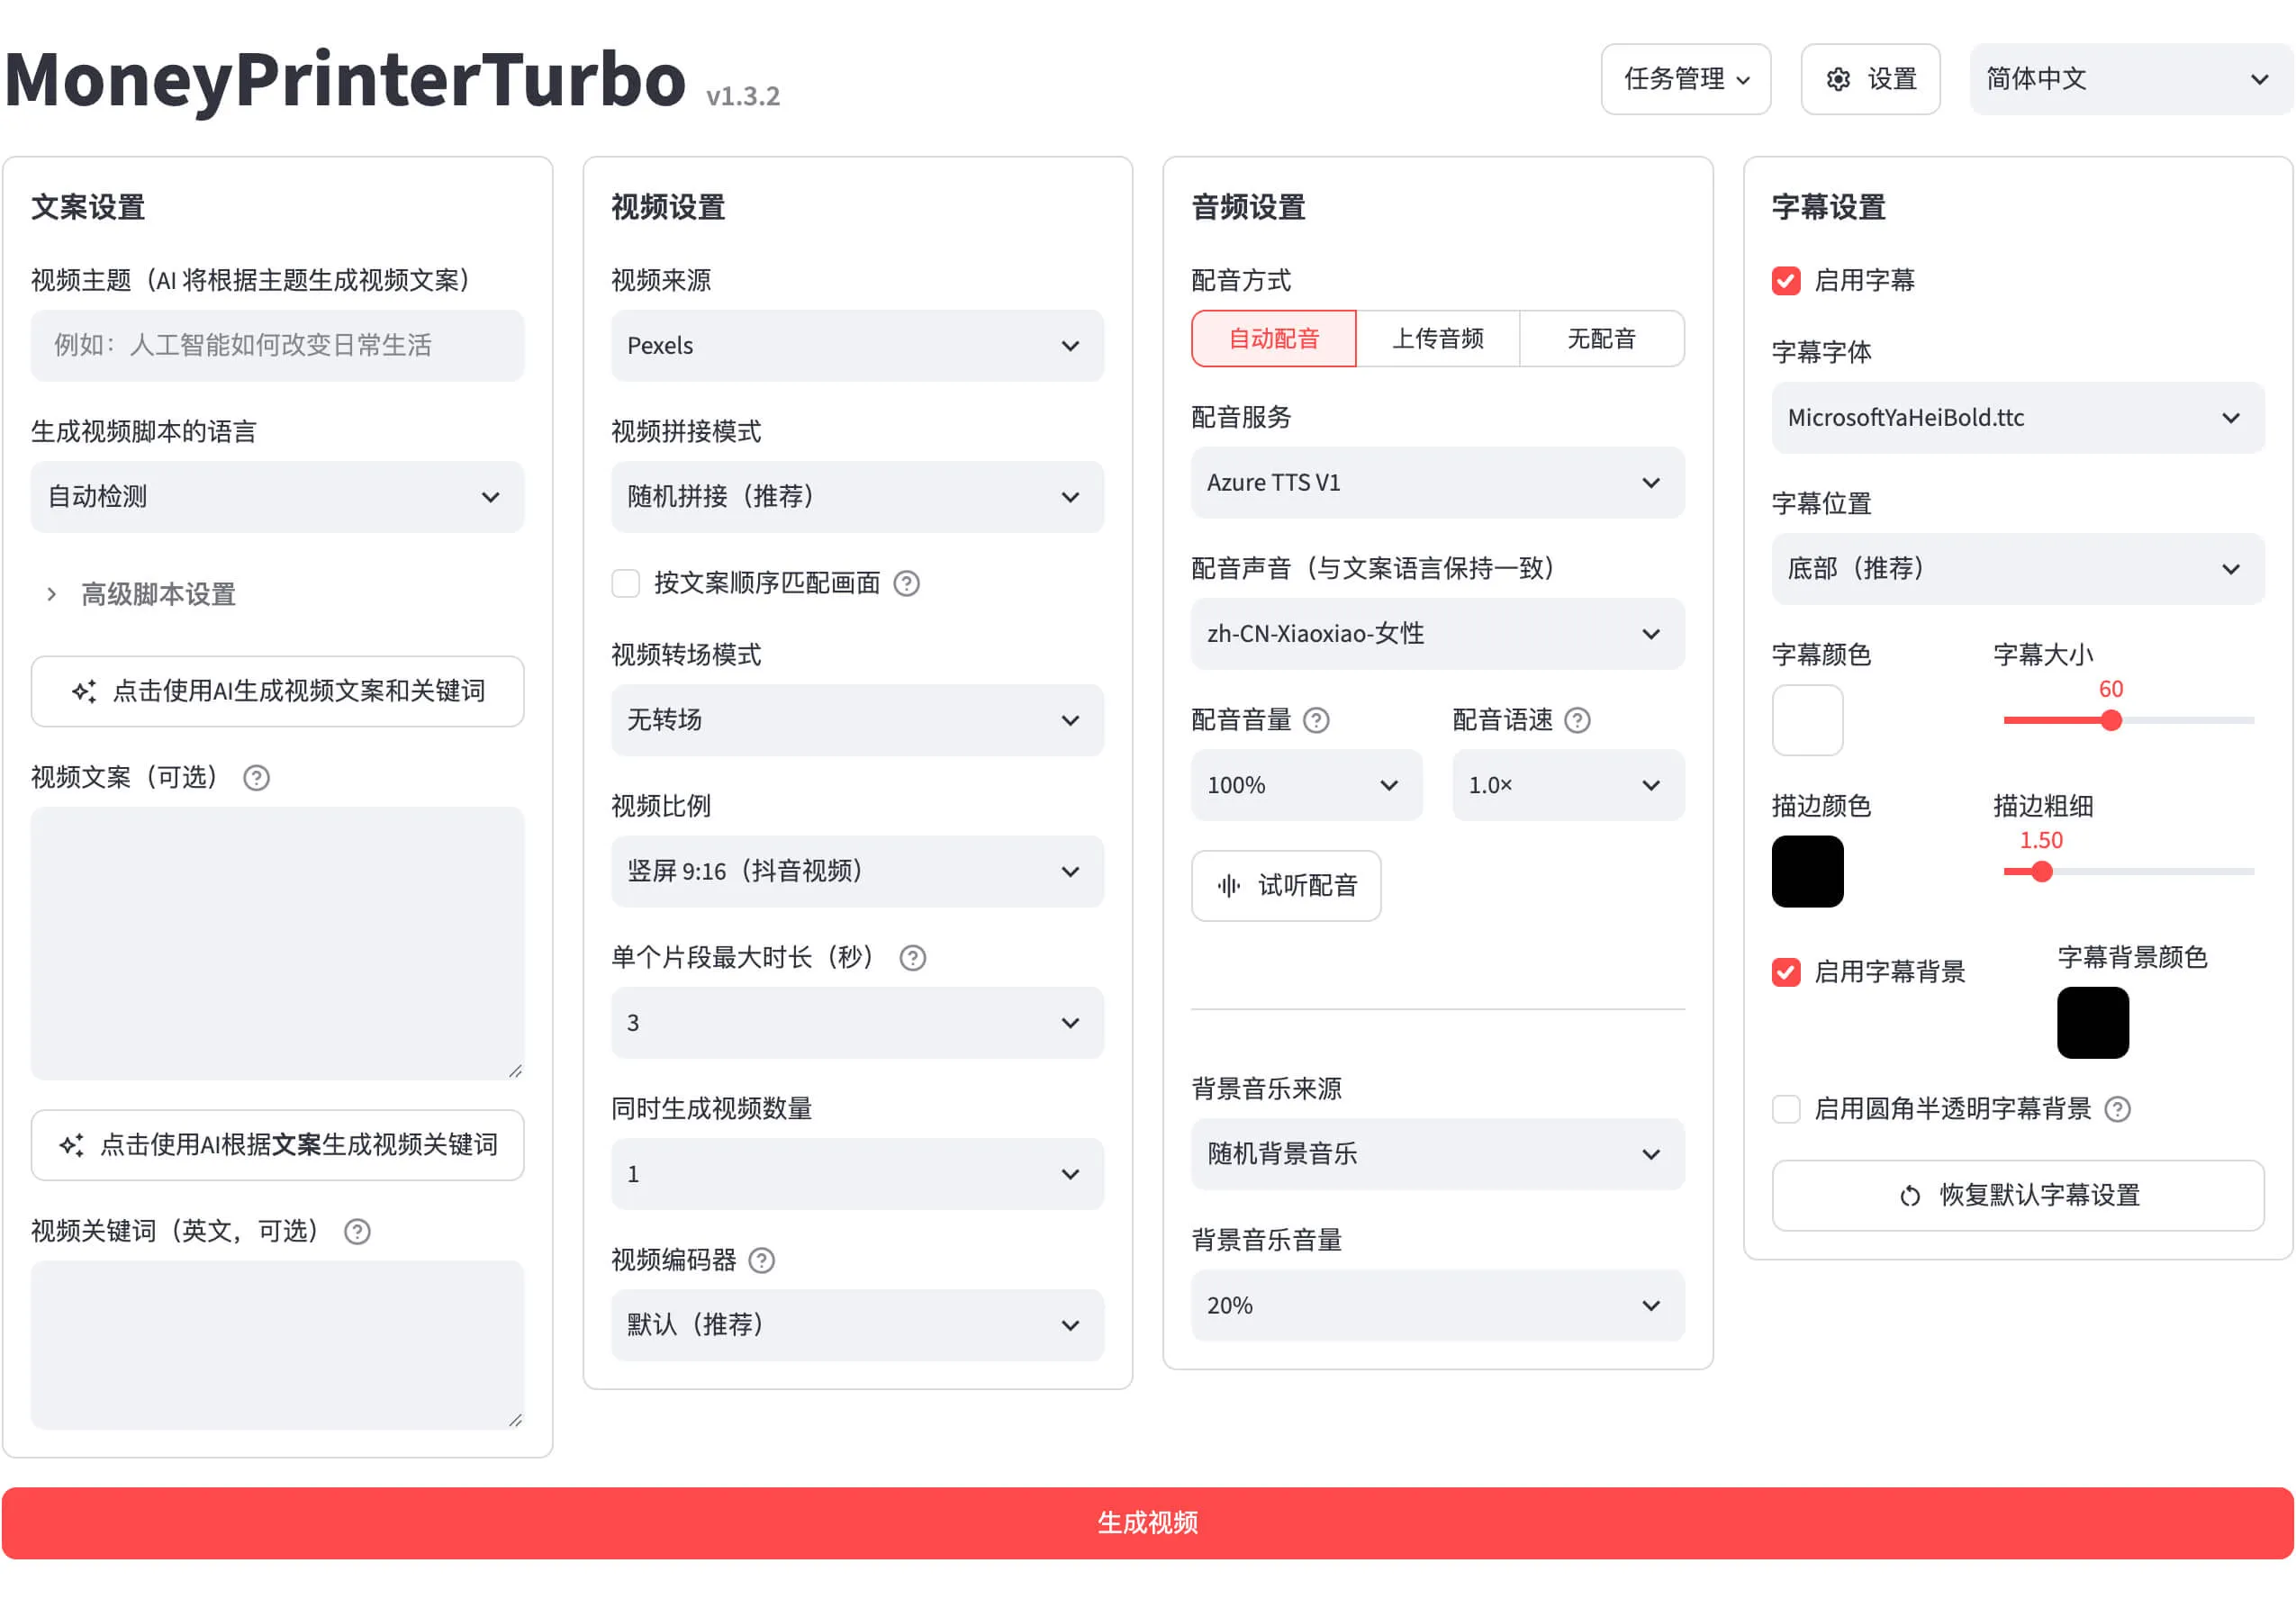
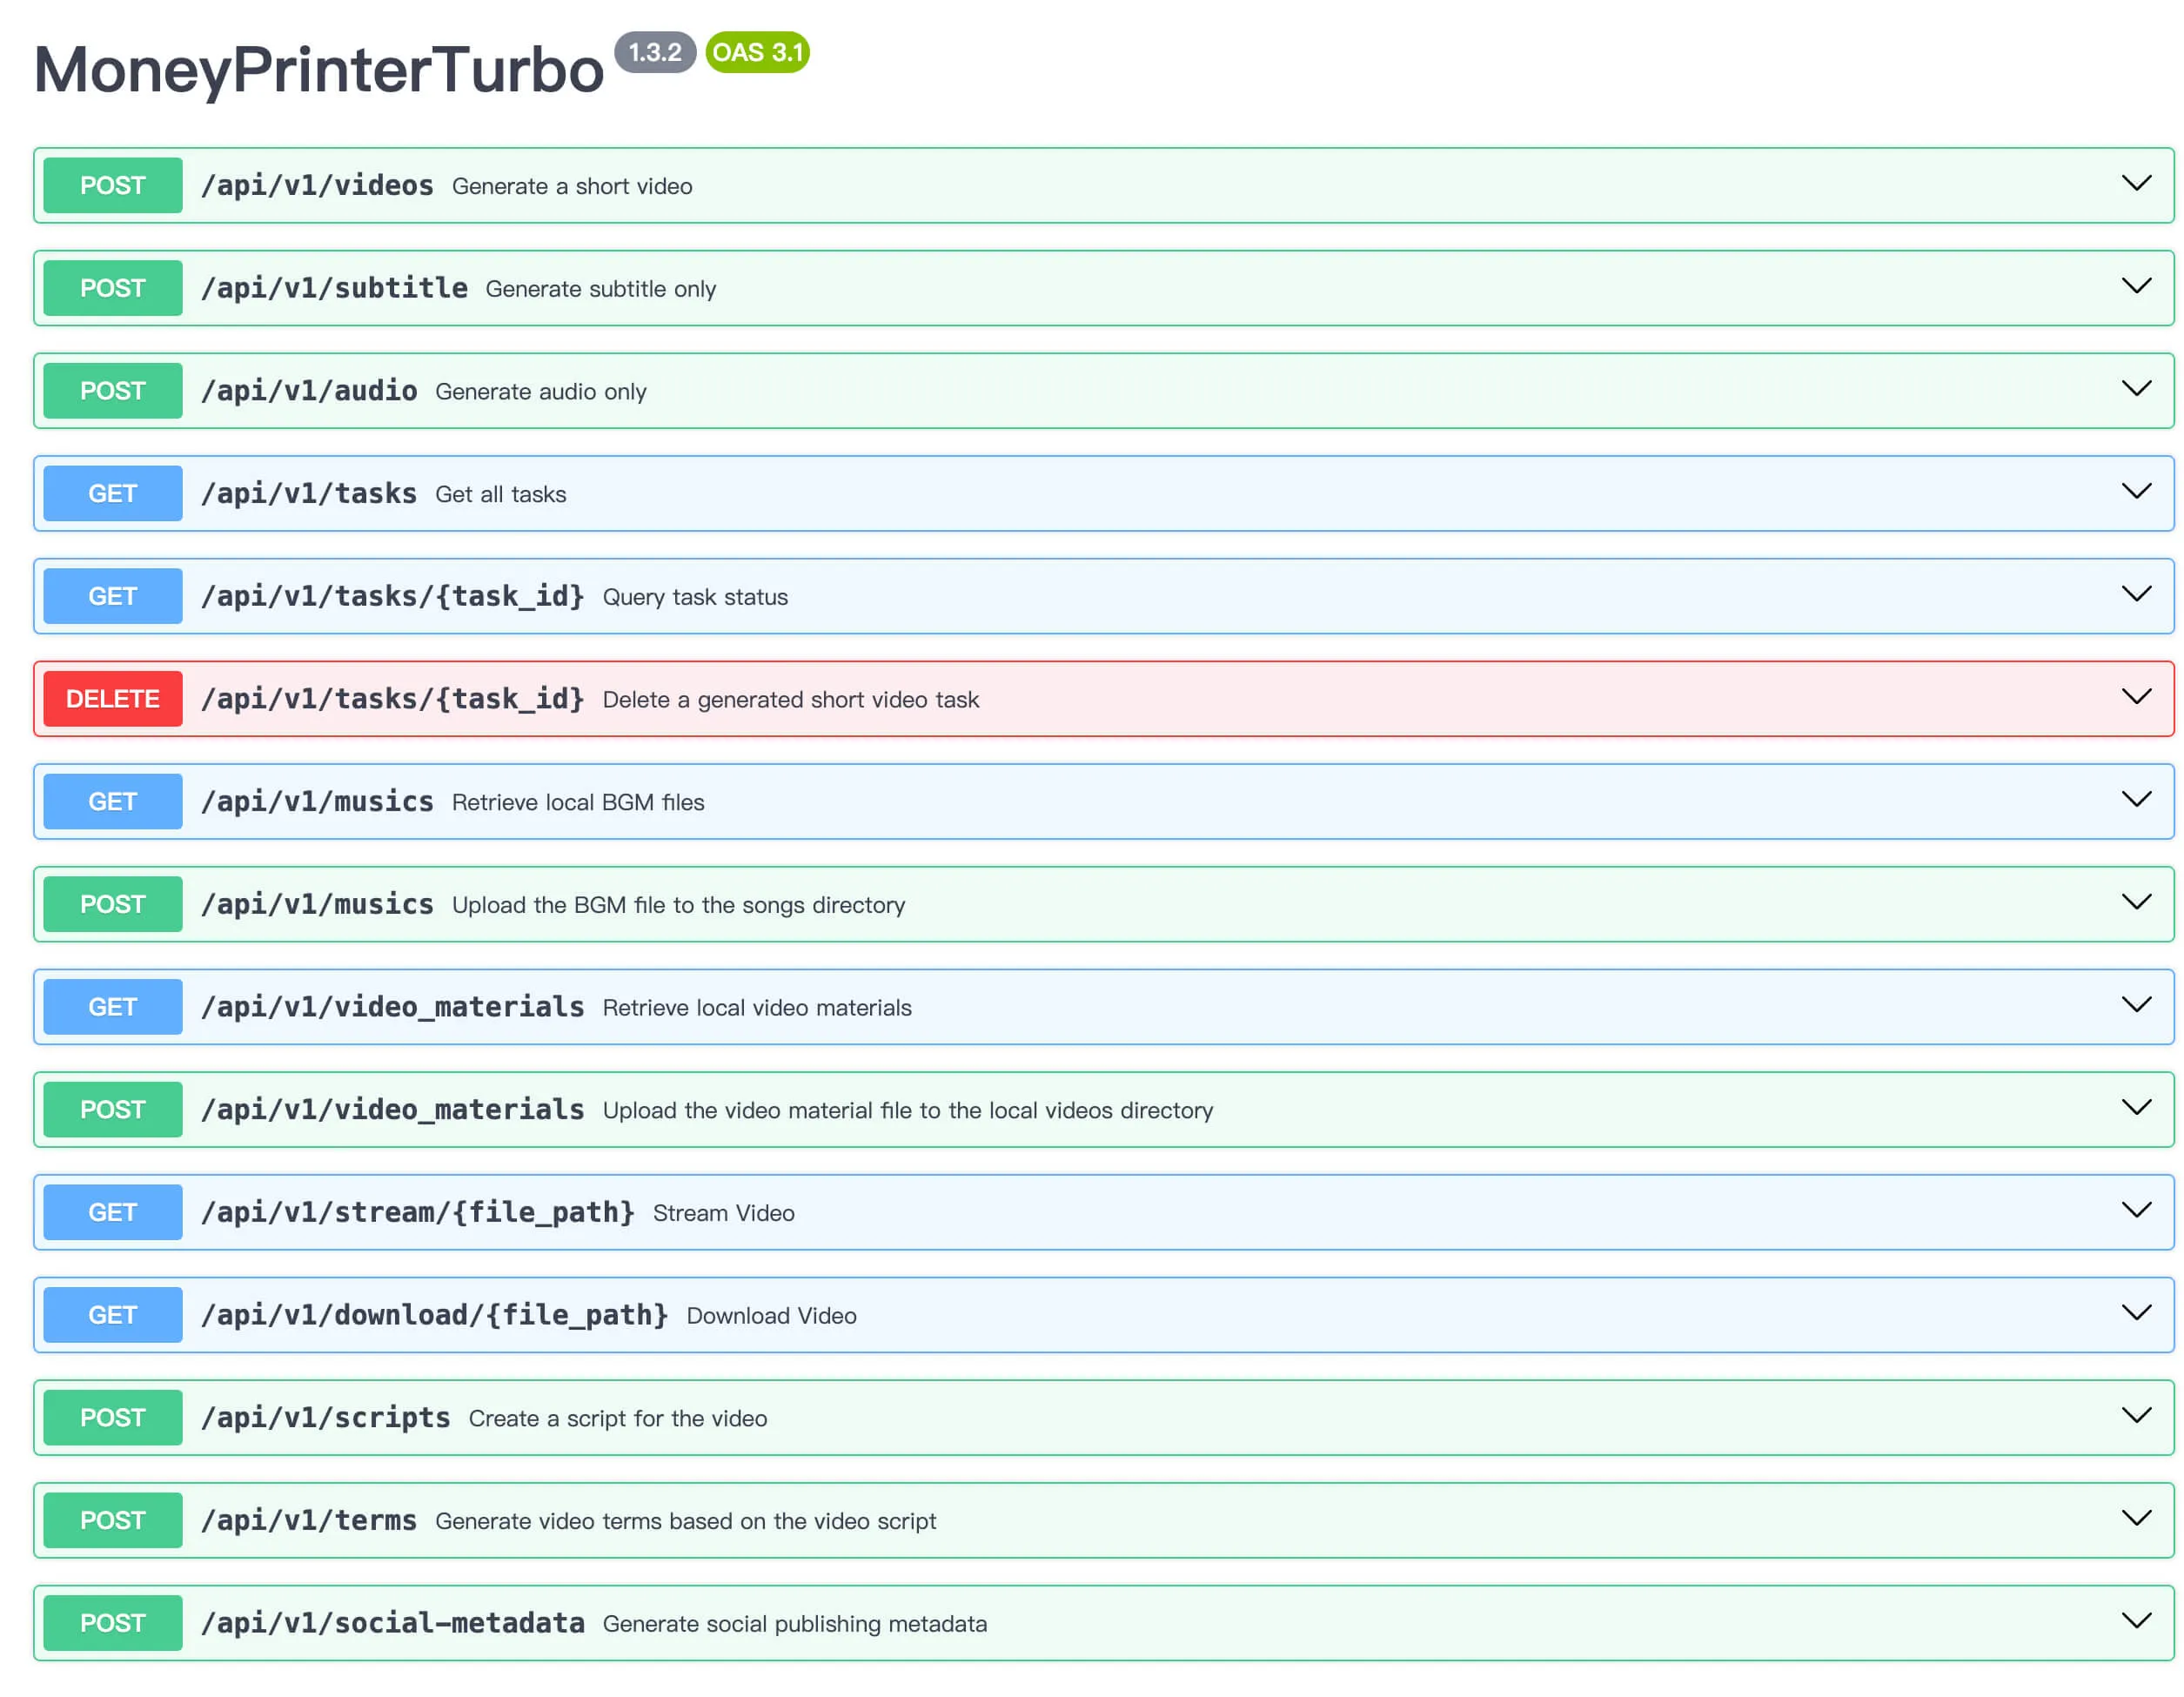
MoneyPrinterTurbo v1.3.4,Python ≥ 3.11,FastAPI + Streamlit 双端,约 15K 行 Python
1.1 一句话定位#
输入主题 → 一键产出可发布的短视频
具体地:用户在 WebUI/API/CLI 任一入口提交一个 video_subject,由一条可中断的编排器串起「脚本 → 素材 → 配音 → 字幕 → 视频合成 → 背景音乐 → 跨平台发布」七个工位。
1.2 技术栈#
| 维度 | 选型 | 来源 |
|---|---|---|
| API 框架 | FastAPI 0.136 + Uvicorn 0.32 | app/asgi.py、app/router.py |
| WebUI | Streamlit 1.59.1 + streamlit-tour | webui/Main.py:54 |
| LLM SDK | openai 2.24 + dashscope 1.20 + google-genai 2.11 + litellm 1.86 | app/services/llm.py |
| 视频合成 | moviepy 2.2.1 + Pillow + numpy | app/services/video.py |
| TTS | edge-tts、Azure Speech SDK、SiliconFlow、Gemini、MiMo、MiniMax、ElevenLabs、Chatterbox | app/services/voice.py |
| 字幕 | faster-whisper 1.1.0 | app/services/subtitle.py |
| 状态后端 | redis 5.2(可选,缺省走内存) | app/services/state.py |
| 日志 | loguru | app/utils/logging_utils.py |
| 部署 | Docker(python:3.11-slim-bullseye + ffmpeg) | Dockerfile |
主依赖已迁移到 pyproject.toml + uv.lock,requirements.txt 只作兼容备份。Dockerfile 还把 PIP_USE_OFFICIAL 和 DOCKER_BUILD_MIRROR 写成可构建参数,方便 GHCR runner 切换国内镜像。
1.3 三层架构#
┌──────────────────────────────────────────────────────┐
│  CLI / WebUI / API 客户端                             │
│  cli.py   webui/Main.py   任何 HTTP/REST 客户端       │
└──────────┬───────────────┬──────────────────────────┘
           │ argparse      │ HTTP
           ▼               ▼
┌──────────────────────────────────────────────────────┐
│  表现层入口(FastAPI 路由)                            │
│  app/router.py → app/controllers/v1/{llm,video}.py   │
└──────────┬───────────────────────────────────────────┘
           │ controllers/manager/{base,memory,redis}_manager.py
           │  封装并发 + 排队
           ▼
┌──────────────────────────────────────────────────────┐
│  任务编排层                                           │
│  app/services/task.py :: start(task_id, params)      │
│  状态机:sm.state (Memory / Redis)                    │
│  产物:app/services/task_artifacts.py                 │
│  缓存:app/services/{cache_manager,material_cache}.py │
└──────────┬───────────────────────────────────────────┘
           ▼
┌──────────────────────────────────────────────────────┐
│  业务服务(流水线上的 7 个工位)                        │
│  llm.py → material.py → voice.py → subtitle.py       │
│  → video.py → bgm.py → upload_post/sonilo/...        │
└──────────────────────────────────────────────────────┘三层最关键的”缝合点”是 app/services/task.py:1275 的 tm.start(task_id, params, stop_at):
def start(task_id, params, stop_at="video"):
    ...
_run_pipeline(task_id, params, stop_at=stop_at, voice_preview=voice_preview)stop_at 是整套设计的精髓——它允许流水线在 script / terms / audio / subtitle / materials / video 任一节点停下来并返回中间产物。所以 /scripts、/terms、/audio、/subtitle 这些 API 端点天然支持”只跑前半段”,不需要再开第二套服务。
二、LLM Provider Registry:19 个 Provider 但没有 19 段 if-else#
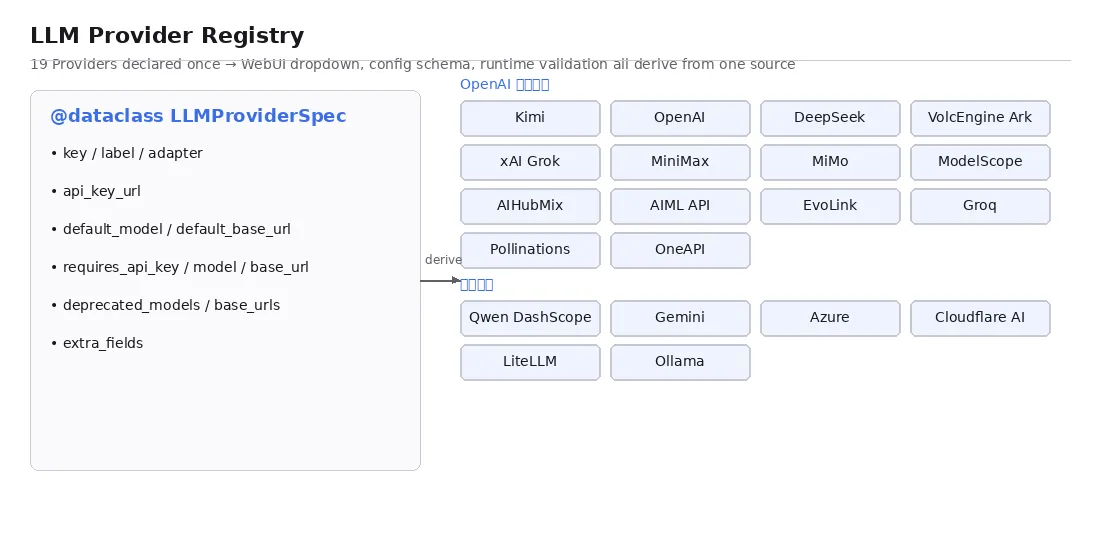
2.1 用一份”声明”描述一个 Provider#
app/models/llm_provider.py:33-49 用 @dataclass(frozen=True, slots=True) 定义 LLMProviderSpec:
@dataclass(frozen=True, slots=True)
class LLMProviderSpec:
    key: str
    label: str
    adapter: str
    api_key_url: str
    default_model: str
    default_base_url: str
    requires_api_key: bool = True
    requires_model_name: bool = False
    requires_base_url: bool = False
    show: bool = True
    deprecated_models: tuple[str, ...] = ()
    deprecated_base_urls: tuple[str, ...] = ()
extra_fields: tuple[str, ...] = ()WebUI 下拉顺序、配置 key、locale 文案、运行时校验,全靠这一份声明推导——这就是经典的 Provider Registry 模式。
2.2 已注册的 19 个 Provider#
| 类别 | Provider |
|---|---|
| OpenAI 兼容统一分支 | Kimi / OpenAI / DeepSeek / VolcEngine Ark(豆包)/ xAI Grok / MiniMax / Xiaomi MiMo / ModelScope / AIHubMix / AIML API / EvoLink / Groq / Pollinations / OneAPI |
| 协议特化适配 | Qwen(DashScope)、Gemini(google-genai)、Azure(AzureOpenAI)、Cloudflare AI Gateway、LiteLLM、ModelScope 流式、Ollama |
落地到代码里:直接 OpenAI 兼容的 Provider 都走
app/services/llm.py:366-404的统一 OpenAI 客户端,差异只在 BaseURL 和鉴权 header;只有真正特殊的(Qwen/Gemini/Azure/Cloudflare/LiteLLM/ModelScope)才走单独适配器分支。
2.3 三个值得抄的设计细节#
① 自动迁移废弃配置(llm_provider.py:81-94)
历史配置里的 gemini-pro / text.pollinations.ai/openai 这类被官方下线的模型/URL,会自动回退到 Registry 默认值,避免旧配置文件”绑死”已下线的模型。
② 校验与默认值分离
每个 Provider 通过 requires_api_key / requires_model_name / requires_base_url / extra_fields 表达校验规则,llm.py:192-212 集中校验;normalize_provider_override(llm_provider.py:280-289)只保留与默认不同的用户值,避免默认值被”硬编码到 config.toml”而失去后续升级能力。
③ 异常清洗
_sanitize_error_message(llm.py:73-85)会把异常中的 user:pass@host 和 ?api_key=… 替换成 *** 再交给 WebUI/日志——用户自定义 base_url 时也不会泄露密码。
2.4 提交瞬间配置快照:长任务不会被中途改配置影响#
_generate_response(llm.py:118)是唯一对外出口,调用方必须传 app_config。原因是 _run_pipeline 跑一条视频可能要几分钟,这期间用户可能在 WebUI 改 Provider。config.py:144-176 的 update_config_nonblocking / snapshot_config_with_pending 会让正在跑的请求锁定提交瞬间的快照,跑完再接受新值——一致性即用。
llm.py 对外暴露的能力:
generate_script(...)→ 文案,_max_retries=5、清洗 markdown;generate_terms(...)→ 关键词数组,支持match_script_order;generate_social_metadata(...)→{title, caption, hashtags},4 平台 4 个不同上限,自动剥 code fence、清洗 hashtag、补 fallback(llm.py:830-960)。
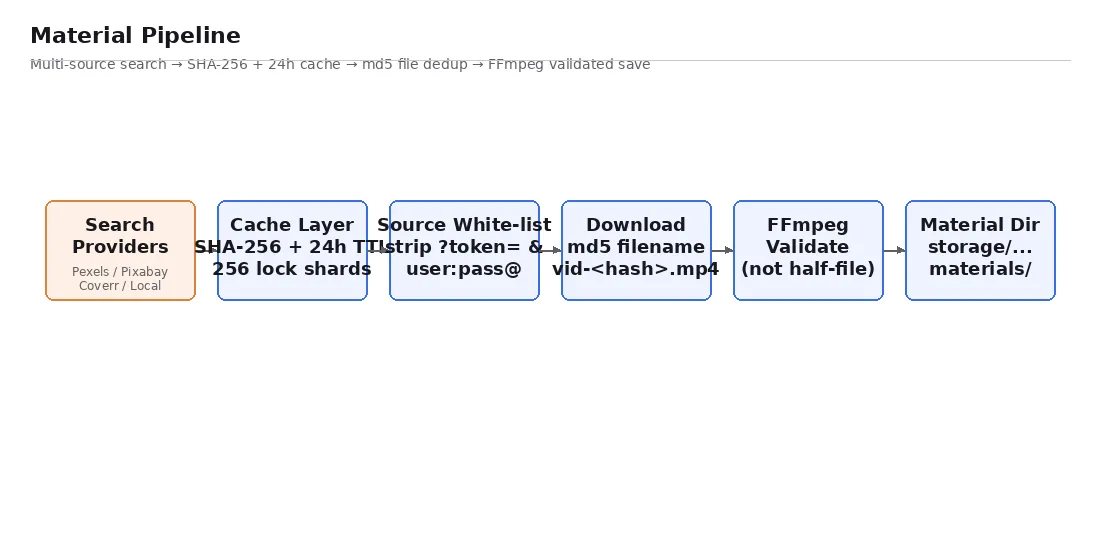
三、素材层:多源 + 24h 缓存 + md5 文件去重#
3.1 视频源#
app/services/material.py:759-777 当前支持的视频源:
pexels→search_videos_pexels(material.py:294)pixabay→search_videos_pixabay(material.py:376)coverr→search_videos_coverr(material.py:502)local→video.preprocess_video(video.py:1287),处理local_videos/下的 mp4/mov/avi/flv/mkv/jpg/jpeg/png;图片会做 Ken Burns 缩放生成 mp4
关于”AI 生成视频”:仓库当前没有内置 Sora/可灵/Veo 这类 AI 视频适配器,
material.py里也没有出现。要补上需要新增search_videos_xxx并在download_videos的if source == "..."分支里挂接。
3.2 搜索结果缓存:SHA-256 + 24h TTL + 256 把锁#
app/services/material_cache.py 的设计要点:
- 缓存键用 SHA-256,TTL 24h(
material_cache.py:13-17); - 锁分片 256 把(
material_cache.py:23-24),避免热点 Key 抖动; - 落盘前对
source_info做白名单构造(material_cache.py:48-72),过滤掉 URL 中的username/password与?token=。
3.3 文件层去重 + 半下载文件防护#
save_video(material.py:606-655)用 URL 去掉 query 后的 md5 作文件名 vid-<hash>.mp4,FFmpeg 校验后才保留——避免半下载文件污染缓存。
3.4 顺序匹配模式#
match_script_order=True 时切换到 _download_videos_by_script_order(material.py:879-987):按”轮询每个关键词的第 N 个候选”下载,避免第一个关键词吞掉整段时间线。配合 3.2 的缓存,重复生成同一主题会越来越快。
四、TTS:用字符串前缀当路由协议#
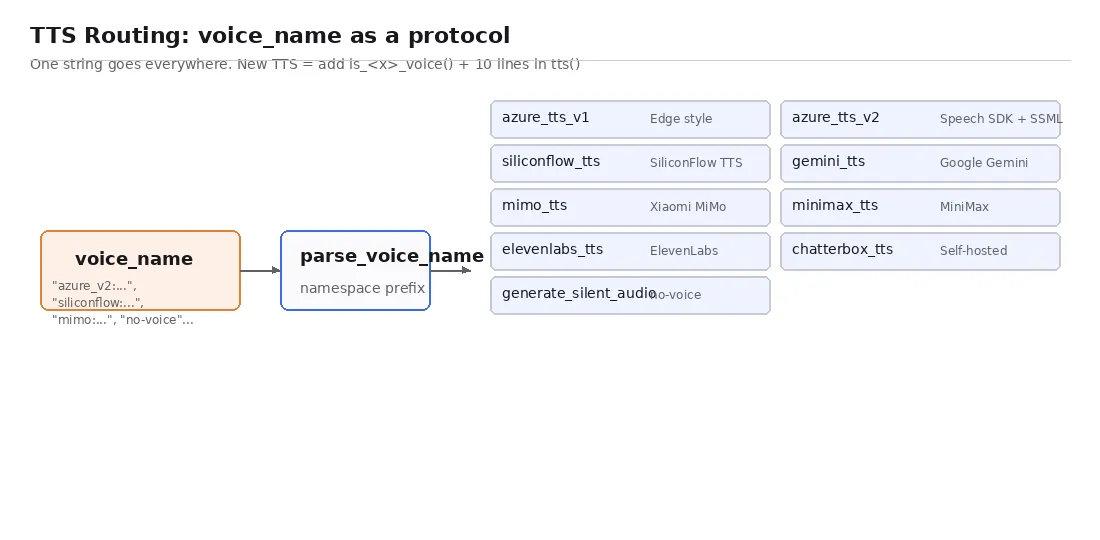
4.1 一份字符串走完所有 TTS#
app/services/voice.py:394-491 的 tts(text, voice_name, ...) 是一处精巧的设计——把所有 TTS 集成用同一种命名规范暴露给前端:
| 前缀 | 含义 | 函数 |
|---|---|---|
zh-CN-XiaoxiaoNeural-Female(无前缀) | Azure v1 edge style | azure_tts_v1 (voice.py:769) |
azure_v2:<voice> | Azure Speech SDK v2 + SSML | azure_tts_v2 (voice.py:990) |
siliconflow:<model>:<voice>-Female/Male | SiliconFlow TTS | siliconflow_tts (voice.py:824) |
gemini:<voice>-Female/Male | Google Gemini TTS | gemini_tts (voice.py:1095) |
mimo:<voice>-Female/Male | Xiaomi MiMo TTS | mimo_tts (voice.py:1221) |
minimax:<voice_id> | MiniMax TTS | minimax_tts (voice.py:1486) |
elevenlabs:<voice_id>:<name> | ElevenLabs | elevenlabs_tts (voice.py:1552) |
chatterbox:<voice>-Female/Male | Chatterbox(自托管) | chatterbox_tts (voice.py:1641) |
no-voice | 静音 + 估算时长 | generate_silent_audio (voice.py:344) |
这种 namespace prefix 的统一设计让 tts() 不需要写一长串 if-else + enum,新加 Provider 只需要新增 is_<x>_voice() 和 tts() 里一段 10 行分支。
parse_voice_name / is_azure_v2_voice 等工具(voice.py:242-280)负责把 WebUI 上选中的”展示名”还原成原始 voice_id。
4.2 三个工程细节#
convert_rate_to_percent(voice.py:492-510):边缘值0.997必须返回"+0%",否则 edge-tts 会抛Invalid rate '0%';0/None直接回退 1.0。- 超时控制:
get_edge_tts_timeout_seconds+_stream_edge_tts_sync_with_timeout(voice.py:636-720),把 stream 放进线程,避免长文 edge-tts 长时间阻塞。 SubMaker兼容层:ensure_legacy_submaker_fields/populate_legacy_submaker_with_full_text(voice.py:525-609)让no-voice模式也能输出与正常模式字段一致的 SubMaker。
五、字幕:edge 优先 + whisper 兜底#
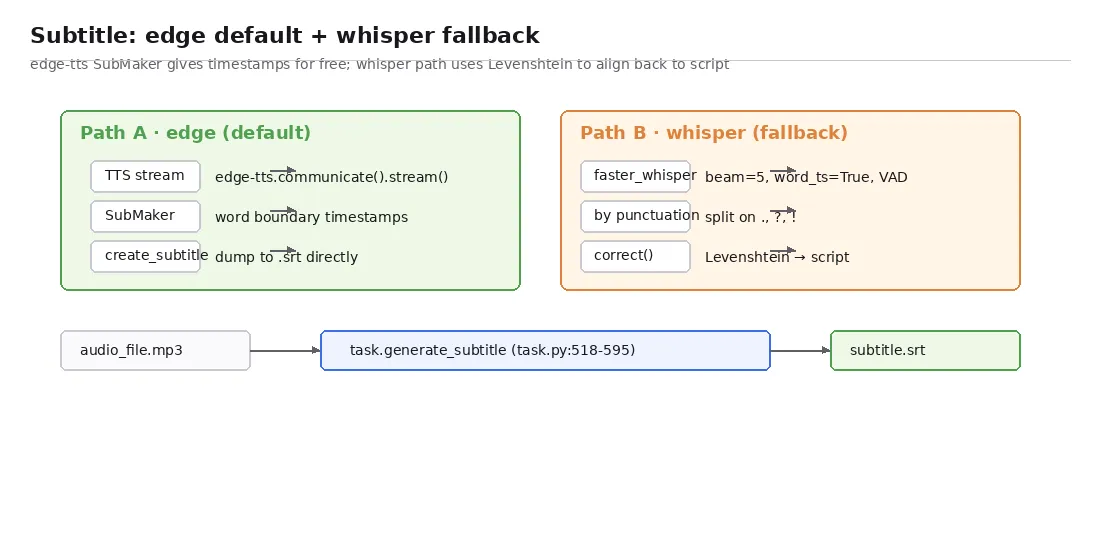
subtitle_provider 配置在 config.app 中,可选 edge 或 whisper(task.py:563-572)。
edge(默认):直接使用 voice.tts 返回的 SubMaker 时间戳。edge-tts.communicate(...).stream() 在朗读过程中会维护 SubMaker,文本和起止时间一一对应;voice.create_subtitle 把它直接 dump 成 SRT(task.py:581-585),节省一次 Whisper 调用。
whisper:用 faster_whisper.WhisperModel(subtitle.py:13-19),参数:
WhisperModel(
    model_size_or_path=model_name,
    beam_size=5,
    word_timestamps=True,
    vad_filter=True,
    vad_parameters={"min_silence_duration_ms": 500},
)按标点断句后,correct(...)(subtitle.py:200-260)用 Levenshtein 距离把 Whisper 输出强行对齐到 video_script,确保字幕文本就是脚本本身,便于导出 / 二次编辑。
注意:Edge 字幕如果文件没有生成,按注释
task.py:587-594不会自动 fallback 到 Whisper——避免在用户不知情时下载数 GB 的模型。这个保守策略值得学习。
文件解析见 subtitle.py:144-195 的 file_to_subtitles,注释里特别提到”末尾字幕没空行会丢”的小 bug 已修。
六、视频合成:MoviePy 流水线 + ExitStack 释放 FFmpeg 子进程#
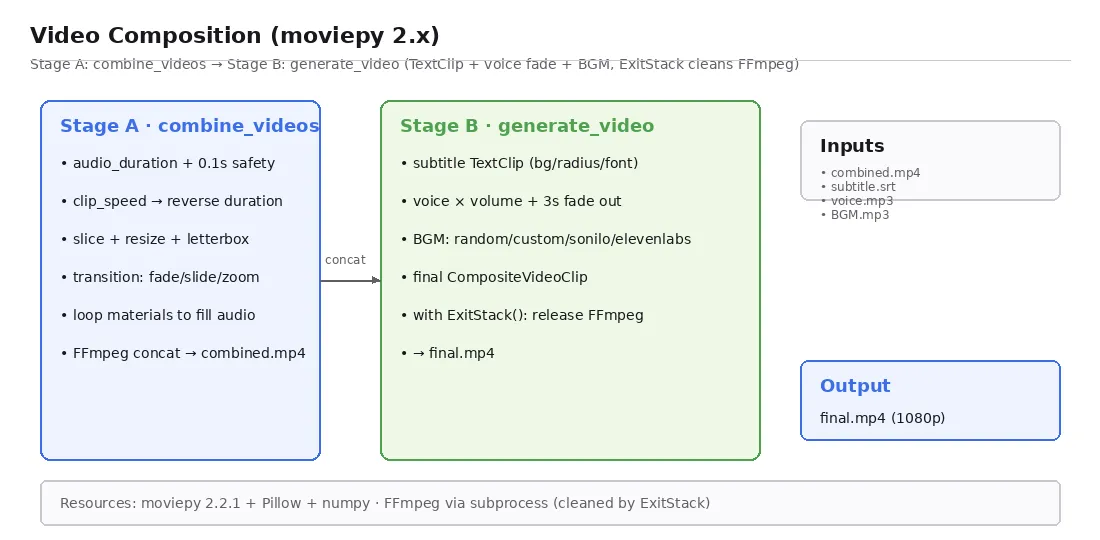
最终合成在 app/services/video.py:971-1280 的 generate_video,结构上分两段。
6.1 段 A:combine_videos(video.py:538-757)—— 拼素材#
- 读
audio_file拿audio_duration后立刻close_clip(audio_clip)(video.py:541-548),避免句柄泄漏; required_video_duration = audio_duration + 0.1s(_VIDEO_DURATION_SAFETY_MARGIN,video.py:63-65),给 FFmpeg 帧率舍入留余量;clip_speed先反推源时长再切(video.py:580-595);- 切片 → resize(保持比例,背景补黑边)→ transition(fade/slide/zoom,
video.py:600-680); - 进度循环利用素材补齐音频时长(
video.py:700-740); - FFmpeg
concat输出combined.mp4。
6.2 段 B:generate_video(video.py:971-1280)—— 加字幕/配音/BGM#
- 字幕 TextClip(背景/圆角/位置/字体,
video.py:1000-1100); - 旁白 × volume + 3s AudioFadeOut(
video.py:1110-1150); - BGM:
random/custom/sonilo/elevenlabs× volume(video.py:1160-1250); - ExitStack 统一释放 FFmpeg 子进程句柄(
video.py:1255-1280)。
ExitStack的使用很关键:moviepy 2.x 的AudioFileClip/VideoFileClip都会 fork FFmpeg 子进程,长视频合成后忘了 close 就会泄漏 fd。这里用with ExitStack() as stack: clip = stack.enter_context(open_clip(...))集中管理生命周期。
6.3 Sonilo & ElevenLabs BGM#
app/services/sonilo.py(328 行):用 LLM 生成一段音乐描述(prompt)后调用 Sonilo API 拉回带商用授权的 BGM,并按视频时长/音量 fade in/out;app/services/elevenlabs_music.py(403 行):ElevenLabs 的 sound effect/music 接口适配,同样走 LLM 生成描述。
两条路径都把”挑 BGM”这件事变成”让 LLM 描述 + 调用音乐 API”,而不是写死规则选曲——更省心也更对题。
七、跨平台发布:upload_post.py + 独立 Slot 限流#

app/services/upload_post.py(136 行)用 concurrent.futures.ThreadPoolExecutor + cross_post_slots = Semaphore(N) 控制并发数(upload_post.py:30-45);任务结束后 Future.add_done_callback 走 _finalize_cross_post_future,统一回写状态。
跨平台被设计成与主流水线解耦:
_run_pipeline跑完合成就把video_paths扔给_run_cross_post_with_slot,立刻释放主任务占用的资源;- 即使某个平台调用失败(鉴权/限流),主流程也已”成品落地”,不会拖垮其他平台;
_mark_task_failed永远只标记主流程的 stage,跨平台的状态走独立的cross_post_state字段。
这一点和我之前写 React Agent 那篇里强调的 “外部副作用必须和核心流程解耦” 是同一个原则——把容易失败、慢、不可控的边界调用扔出主流程外。
八、任务状态机:Redis/内存双后端 + 产物落盘#
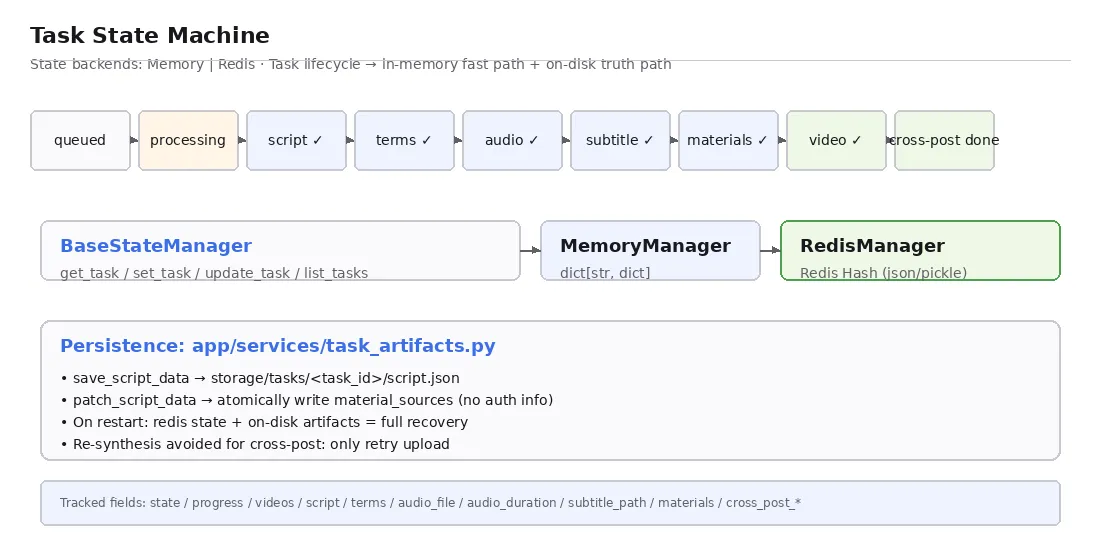
8.1 状态字段#
app/services/state.py:184-198 的 update_task 在每次状态变更时把完整快照写回:
sm.state.update_task(task_id, {
    "state": const.TASK_STATE_PROCESSING,
    "progress": 35,
    "videos": [list of final paths],
    "combined_videos": [list of combined paths],
    "script": "...",
    "terms": ["kw1", "kw2"],
    "audio_file": "/storage/.../audio.mp3",
    "audio_duration": 87.3,
    "subtitle_path": "/storage/.../subtitle.srt",
    "materials": [...],
    "cross_post_state": "...",
    "cross_post_results": {...},
    ...
})一次查询即可拿到完整结果——前端不用串多次请求。
8.2 双后端抽象#
app/controllers/manager/base_manager.py定义BaseStateManager接口(get_task / set_task / update_task / delete_task / list_tasks);memory_manager.py用_tasks: dict[str, dict];redis_manager.py用 Redis Hash 包装pickle/json序列化。
WebUI/API 不感知后端差异——task.py:1109-1110 只调 sm.state.update_task(...)。
8.3 产物落盘#
app/services/task_artifacts.py(96 行):
save_script_data在task.py:331-338把script.json写入storage/tasks/<task_id>/;patch_script_data把白名单化的来源(不含鉴权)原子写到material_sources(task_artifacts.py:79-95);- 任意时刻重启服务,都能从落盘产物 + Redis 状态恢复运行。
这种”内存快路径 + 落盘真路径”的双写设计是单机异步任务的标准答案。MoneyPrinterTurbo 的简化版本还顺手做了 source_info 白名单,避免日志/产物文件二次泄露鉴权信息。
8.4 中断恢复#
recover_interrupted_cross_posts(task.py:784)在服务启动时扫描 Redis,捞起上一次没跑完的跨平台发布任务继续跑——但不会重新合成视频,只会重试上传。这就是”把昂贵的合成和便宜的上传解耦”的好处。
九、WebUI:Streamlit 4335 行#
webui/Main.py(4335 行)承担了所有 UI 逻辑,有几个工程亮点:
streamlit-tour:首次进入会弹一个引导浮层,把多步表单拆给新手;- 多页路由:用
st.sidebar.selectbox切到「短视频生成 / 混合视频 / 多语言 / 设置」等子页面; - 本地化:从
webui/i18n/*.json拉中英文字典,按用户浏览器语言切换; - 实时任务进度:调用
/tasks/{id}轮询,状态变化时刷新面板(用st.empty()复用容器)。
WebUI 与 API 的耦合点是”完全 HTTP”——不直接 import 后端代码,部署时甚至可以把后端部署到云端,WebUI 部署到本地,反过来也行。
十、可借鉴 & 可改进#
10.1 值得借鉴#
- Provider Registry + namespace prefix:把”配置即代码”做到极致,新增 Provider 只需要改一份声明 + 一段分支。
stop_at控制流水线阶段:天然支持”只跑前半段”,等于一个 API 同时实现了完整的合成 + 脚本预览 + 字幕预览 + 配音试听——把工位变成了可独立调用的原子操作。- 提交瞬间配置快照:长任务不会被中途改配置影响,这种”任务开始 = 锁定”的设计值得在所有 AI 工作流里抄。
- exit stack 释放 FFmpeg 子进程:moviepy/ffmpeg 这类重资源 IO 必须集中管理生命周期。
- source_info 白名单:日志/产物文件里不存鉴权信息,二次泄露风险降到最低。
- 跨平台与主流程解耦:用 Semaphore 限流 + 独立 Future 状态字段,慢/不可控的副作用永远不会拖垮核心流程。
10.2 可改进#
- 当前仍是单机优先:
state.py的 Redis 后端虽然支持,但task.py的_run_pipeline是单进程内_run_in_threadpool,CPU 密集的合成阶段会占满单核。生产化时建议把合成切成 Celery/RQ worker,API 只负责编排。 - MoviePy 的可替代性:MoviePy 2.x 仍然在 fork FFmpeg 做合成,吞吐和稳定性都不如直接调
ffmpeg-python或pyav。对 1080p/2K 短视频无感,对 5 分钟以上中长视频需要替换。 - 缺乏可观测性:除了 loguru 输出,缺少 Prometheus metrics、链路 trace、任务慢调用排行。WebUI 也只展示”进度 %“,看不到”哪个工位慢”。
- AI 视频源:当前 100% 依赖第三方素材库(Pexels/Pixabay/Coverr),
material.py没有 Sora/可灵/Veo 适配器。要补上这一层,需要新增search_videos_xxx并在download_videos的if source == "..."分支挂接。 - 没有任务取消的硬中断:
/tasks/{id}取消走的是”软停止”(stop_at之后自然退出),CPU 密集合成期间无法立刻打断。
十一、写在最后#
MoneyPrinterTurbo 给我的最大启发是:AI 应用的工程难度,不在模型,而在把”模型输出”和”传统多媒体管线”嫁接在一起时,那些看似不起眼的生命周期管理、并发控制、配置快照、产物落盘。
模型可以换,框架可以换,TTS 可以换,字幕可以换;但这些工程骨架——Provider Registry、可中断流水线、双写状态机、ExitStack 释放、外部副作用解耦——换不换都能用。
这也是为什么我在做完 TapSpot ↗ 之后会被这个项目吸引:它用同样的”把多个边界服务串成一条线”思路,但难度高了不止一个量级——因为每个工位背后都是”分钟级 + GB 级 IO + 不可重入”的真实工程。
如果你也在做类似的多模态 AI 工作流(视频 / 语音 / 图像 / 文档),强烈建议把它的 app/services/task.py 拆出来读一遍——你会看到一个 AI 流水线在生产化时到底要面对哪些”看不见的复杂性”。
附录:关键源码定位速查#
| 模块 | 关键文件 / 行号 |
|---|---|
| 流水线编排 | app/services/task.py:1014 (_run_pipeline)、task.py:1275 (start) |
| LLM Provider Registry | app/models/llm_provider.py:33-49、55-237 |
| LLM 适配器 | app/services/llm.py:118 (_generate_response)、192-212、366-404 |
| 素材下载 | app/services/material.py:606-655 (save_video)、759-777 (download_videos) |
| 素材缓存 | app/services/material_cache.py:13-24、48-72 |
| 字幕 | app/services/subtitle.py:67-72、200-260 (correct) |
| TTS 路由 | app/services/voice.py:242-491、824-1641 |
| 视频合成 | app/services/video.py:538-757 (combine_videos)、971-1280 (generate_video) |
| BGM | app/services/bgm.py、sonilo.py、elevenlabs_music.py |
| 跨平台 | app/services/upload_post.py:30-45、task.py:784 (recover_interrupted_cross_posts) |
| 状态机 | app/services/state.py:184-198、app/controllers/manager/* |
| 产物落盘 | app/services/task_artifacts.py:24-95 |
| WebUI | webui/Main.py |
📘 项目信息
- 仓库:harry0703/MoneyPrinterTurbo ↗
- 版本:v1.3.4
- License:MIT
- 作者:harry0703(同步开发的 MangoDisk ↗ 也是一个有意思的项目,macOS/Windows 开源磁盘清理工具)