一、OpenShell 让我重新想了一遍「AI agent 到底该有多少权限」#
NVIDIA 在 2026 年 7 月正式开源的 OpenShell(版本 0.1.x),是这个月最让我眼前一亮的项目。它的 README 第一句话直接砸过来:
“OpenShell is the safe, private runtime for fleets of autonomous AI agents. Agents are most useful when they can read files, install packages, call APIs, and use credentials. OpenShell gives them that capability without giving them unrestricted access to your data, secrets, or network.”
翻译过来:AI agent 最有用的地方是它能读文件、装包、调 API、用凭据;OpenShell 让 agent 拥有这些能力但不被授予对数据/secret/网络的完全访问。
这句话背后藏着一个工程现实:2025-2026 年所有 AI agent 框架的真正痛点不是「能不能让 agent 做事」,而是「agent 做事时怎么不让它做错事」。
我之前拆过的几个项目:
- PageIndex:reasoning-based RAG,解决”找到相关段落”
- hey:HTTP 负载生成,解决”快速测试服务”
- cs341-illinois/coursebook:系统编程教材,解决”C 字节流心智”
这些项目的心智都集中在「怎么让 agent 更能干」。OpenShell 反过来了——它的全部心智集中在「怎么让 agent 安全地干」。这条主线的工程差异非常大:
| 维度 | 其他 AI agent 框架 | OpenShell |
|---|---|---|
| 默认信任 | agent 是友好的,加个 sandbox 兜底 | agent 是不可信的,只有显式 allow 才能动 |
| 凭据可见性 | agent 拿到 API key 自己用 | agent 看不到凭据,supervisor 注入到 approved endpoints |
| 网络出口 | 默认放开,过滤敏感 host | 默认 deny all,policy 显式 allow 才能出网 |
| 策略变更 | 修改 YAML 直接生效 | 形式化验证风险,Finding 阻断自动批准 |
| 失联行为 | agent 继续跑 | supervisor 失联 → agent 被冻结(fail-closed) |
这种”信任分三层”的工程设计,是 OpenShell 整个项目最硬的核心心智。我读完整个仓库的架构文档后,把这两条主线画给你看。
二、先看项目长什么样#
git clone 下来 46MB,主仓库 40 个 Rust crates(全部 openshell-* 命名,职责分离做得极其干净):
OpenShell/
├── crates/
│   ├── openshell-core                  ← 核心抽象
│   ├── openshell-gateway               ← 控制面
│   ├── openshell-supervisor            ← 可信决策
│   ├── openshell-sandbox               ← 不可信侧
│   ├── openshell-sandbox-backend       ← sandbox 后端抽象
│   ├── openshell-policy                ← 策略引擎
│   ├── openshell-policy-schema         ← policy.toml schema
│   ├── openshell-prover                ← 形式化验证(独立可发布)
│   ├── openshell-driver-{docker,podman,kubernetes,vm,mxc,vault,db-credstore,kubernetes-secrets}  ← 8 个 driver
│   ├── openshell-extension-core        ← 扩展接口
│   ├── openshell-isolation-interface   ← 隔离接口
│   ├── openshell-cli / -tui / -server  ← 三种界面
│   ├── openshell-sdk                   ← SDK
│   ├── openshell-conformance           ← 一致性测试
│   ├── openshell-ocsf / -otel          ← OCSF 审计 + OpenTelemetry
│   └── ...
├── docs/
│   ├── about/architecture.mdx          ← 三层架构总图
│   ├── how-it-works/{gateways,sandboxes,policies,providers}/
│   └── security/, kubernetes/, sdk/
├── rfc/                                ← 公开 RFC(设计评审文档)
├── proto/                              ← protobuf 定义(Sandbox Protocol)
├── python/ + sdk/                      ← Python SDK + 多语言 SDK
├── providers/                          ← 凭据提供方插件
├── fern/                               ← Fern 文档源码
└── flake.nix + mise.toml + Cargo.toml ← Rust 1.94,Apache-2.0,NVIDIA 官方维护我看完架构后立刻意识到:OpenShell 是「一个 Rust 写的安全操作系统 + 三个可换 driver 后端」的工程产物,40 个 crate 不是「过度工程」,而是把”信任分层 + 接口隔离 + 后端可换”做到底的必然结果。
Cargo.toml 的依赖也透露了工程深度:
tokio = { version = "1.43", features = ["full"] }            # 异步运行时
tonic / prost                                            # gRPC + protobuf(Sandbox Protocol)
axum = { version = "0.8", features = ["ws"] }              # HTTP 服务 + WebSocket
rustls = { ... features = ["aws_lc_rs"] }                   # TLS 用 AWS-LC
clap = { version = "4.5", features = ["derive", "env"] }    # CLI
miette / thiserror                                       # 错误处理
ratatui = "0.26" # TUI 终端 UI没有 LLM SDK 依赖(没有 openai / anthropic crate)。OpenShell 不直接调 LLM——它是 LLM agent 的运行时,不是 LLM client。LLM agent 通过 MCP 接入。
三、核心心智 1:信任分三层,每层做一件事#
docs/about/architecture.mdx 第一节就把三层架构讲透了。我把它画成一张图:
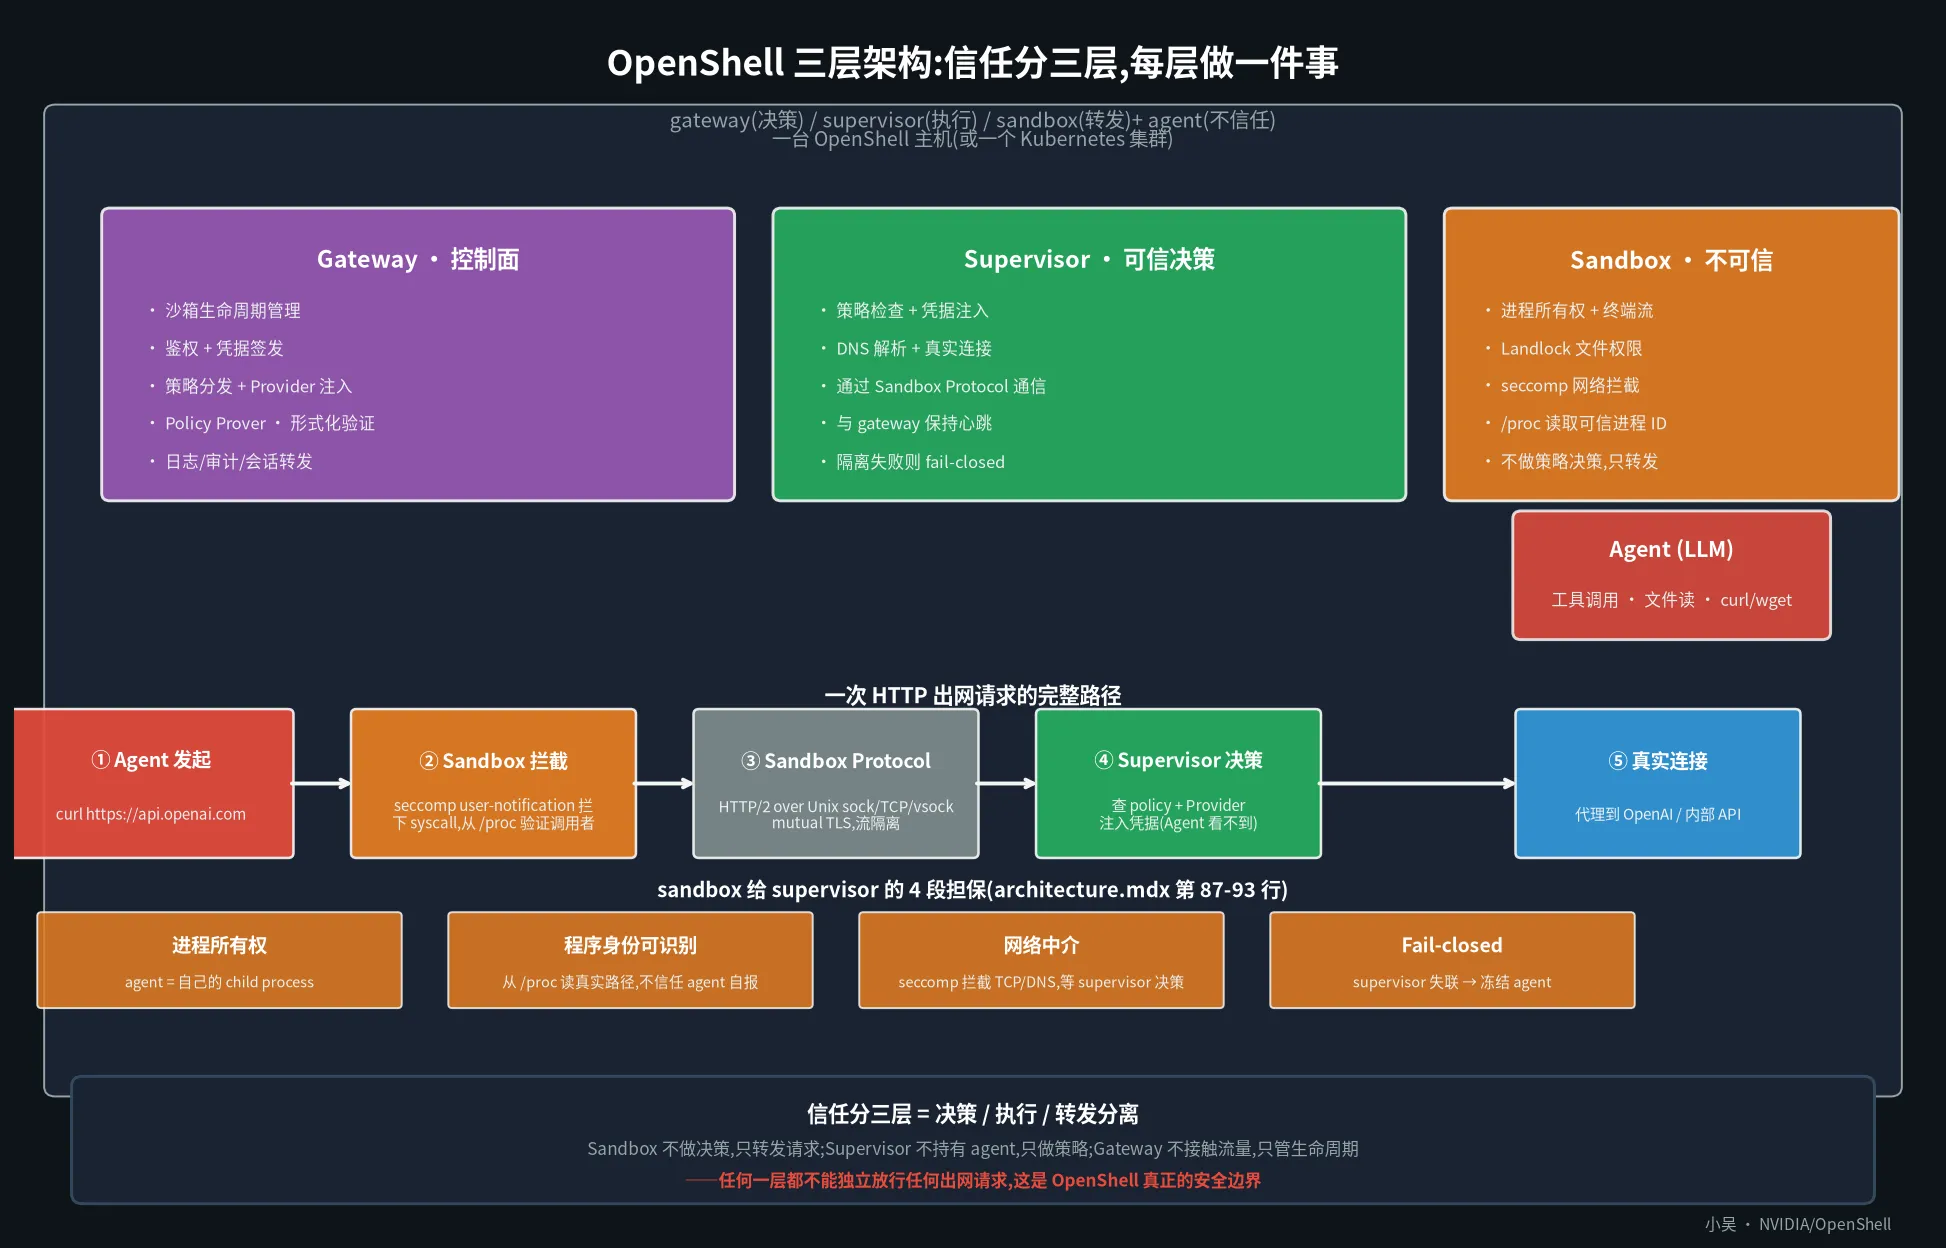
这张图把 OpenShell 整个系统的”决策链”展示清楚了。让我顺着图讲。
3.1 三层 = 决策 / 执行 / 转发#
OpenShell 把”agent 跑起来”这件事拆成三层:
- Gateway(控制面)——
crates/openshell-gateway/。负责:沙箱生命周期管理、鉴权、凭据签发、策略分发、Provider 注入、Policy Prover 运行、日志审计。Gateway 不接触 agent 的实际流量——它只管”谁可以做什么”。 - Supervisor(可信决策)——
crates/openshell-supervisor/。负责:策略检查、凭据注入、DNS 解析、真实连接、Sandbox Protocol 通信、心跳维持、失败关闭。Supervisor 持有所有 agent 的请求流转权限——它看 agent 想干什么,policy 允许才真连出去。 - Sandbox(不可信)——
crates/openshell-sandbox/。负责:agent 进程所有权、Landlock 文件权限、seccomp 网络拦截、可信进程 ID 识别。Sandbox 不做策略决策,只把 agent 的请求”中转”给 Supervisor——这是它最关键的属性。
我读完后的关键收获是:这三层不是「三个模块」,而是「三种信任级别」。
- Gateway 是「我相信它能签凭据」
- Supervisor 是「我相信它能决策」
- Sandbox 是「我不相信它能做决策,所以它不能做决策」
这不是工程洁癖,是 zero-trust 的实际落地——把”决策权”和”执行权”分开,让任何一层都不能独立放行任何出网请求。
3.2 Sandbox 给 Supervisor 的 4 段担保#
架构文档列出了 sandbox 提供的 4 段关键担保(architecture.mdx 第 87-93 行),我直接画在图里了:
| 担保 | sandbox 怎么实现 | supervisor 拿到什么 |
|---|---|---|
| 进程所有权 | agent 是 sandbox 的 owned child process | 能 wait/attach/signal/exec 真实进程 |
| 程序身份可识别 | 从 /proc 读可信数据,不信任 agent 自报 | 拿到每个请求的真实程序路径 |
| 网络中介 | seccomp user-notification 拦下 TCP/DNS,等 supervisor 决策 | 每个出网请求都是”挂起等决策”状态 |
| Fail-closed | 启动时 sandbox 等待 supervisor 确认,supervisor 失联则冻结 agent | ”要么连得上,要么 agent 停” |
第 3 条「网络中介」是 OpenShell 最硬的工程实现——它是 Linux 内核级的 seccomp user notification (kernel 5.0+ 特性)。当 agent 调 connect(),sandbox 的 seccomp filter 不会让它直接执行,而是把 syscall 挂起,通过 ioctl 发个通知给 supervisor,supervisor 查 policy、决定放不放行,agent 在 syscall 里阻塞等待。
这和我之前拆过的任何 AI agent 框架都不一样——其他 agent 在用户态做 “HTTP allowlist”,OpenShell 在 kernel 态做 syscall gate。kernel 级拦截让 agent 没法绕过——即使 agent 自己改了 DNS、加了 proxy、加了 raw socket,出不去就是出不去。
3.3 一次 HTTP 请求的 5 步路径#
图里画了 agent curl https://api.openai.com 的完整流程:
- Agent 发起——LLM 触发 curl,内部
connect()系统调用 - Sandbox 拦截——seccomp user-notification 把 syscall 挂起,从
/proc验证调用者 - Sandbox Protocol——通过 HTTP/2 over Unix socket / TCP / vsock 发到 supervisor(mTLS 鉴权)
- Supervisor 决策——查 policy,匹配 Provider 注入 OpenAI API key(agent 看不到 key 本身)
- 真实连接——supervisor 替 agent 真正连到
api.openai.com,relay 数据
关键不变量:
- Agent 永远看不到 API key(凭据只在 supervisor 内存里)
- Agent 永远不能绕过 supervisor 直连外网(seccomp + 外部 network fence 双重拦截)
- 任何失败都 fail-closed(失联 = 冻结)
四、核心心智 2:Policy Prover — 形式化验证策略变更#
OpenShell 的第二条硬核心智是「在策略生效前,用形式化验证找出潜在风险」。
架构文档里的原话:
“Before a policy change is approved, OpenShell uses formal verification to flag risky new access it would grant, such as reaching a new host with credentials or calling a new API method, so those changes wait for human review.”
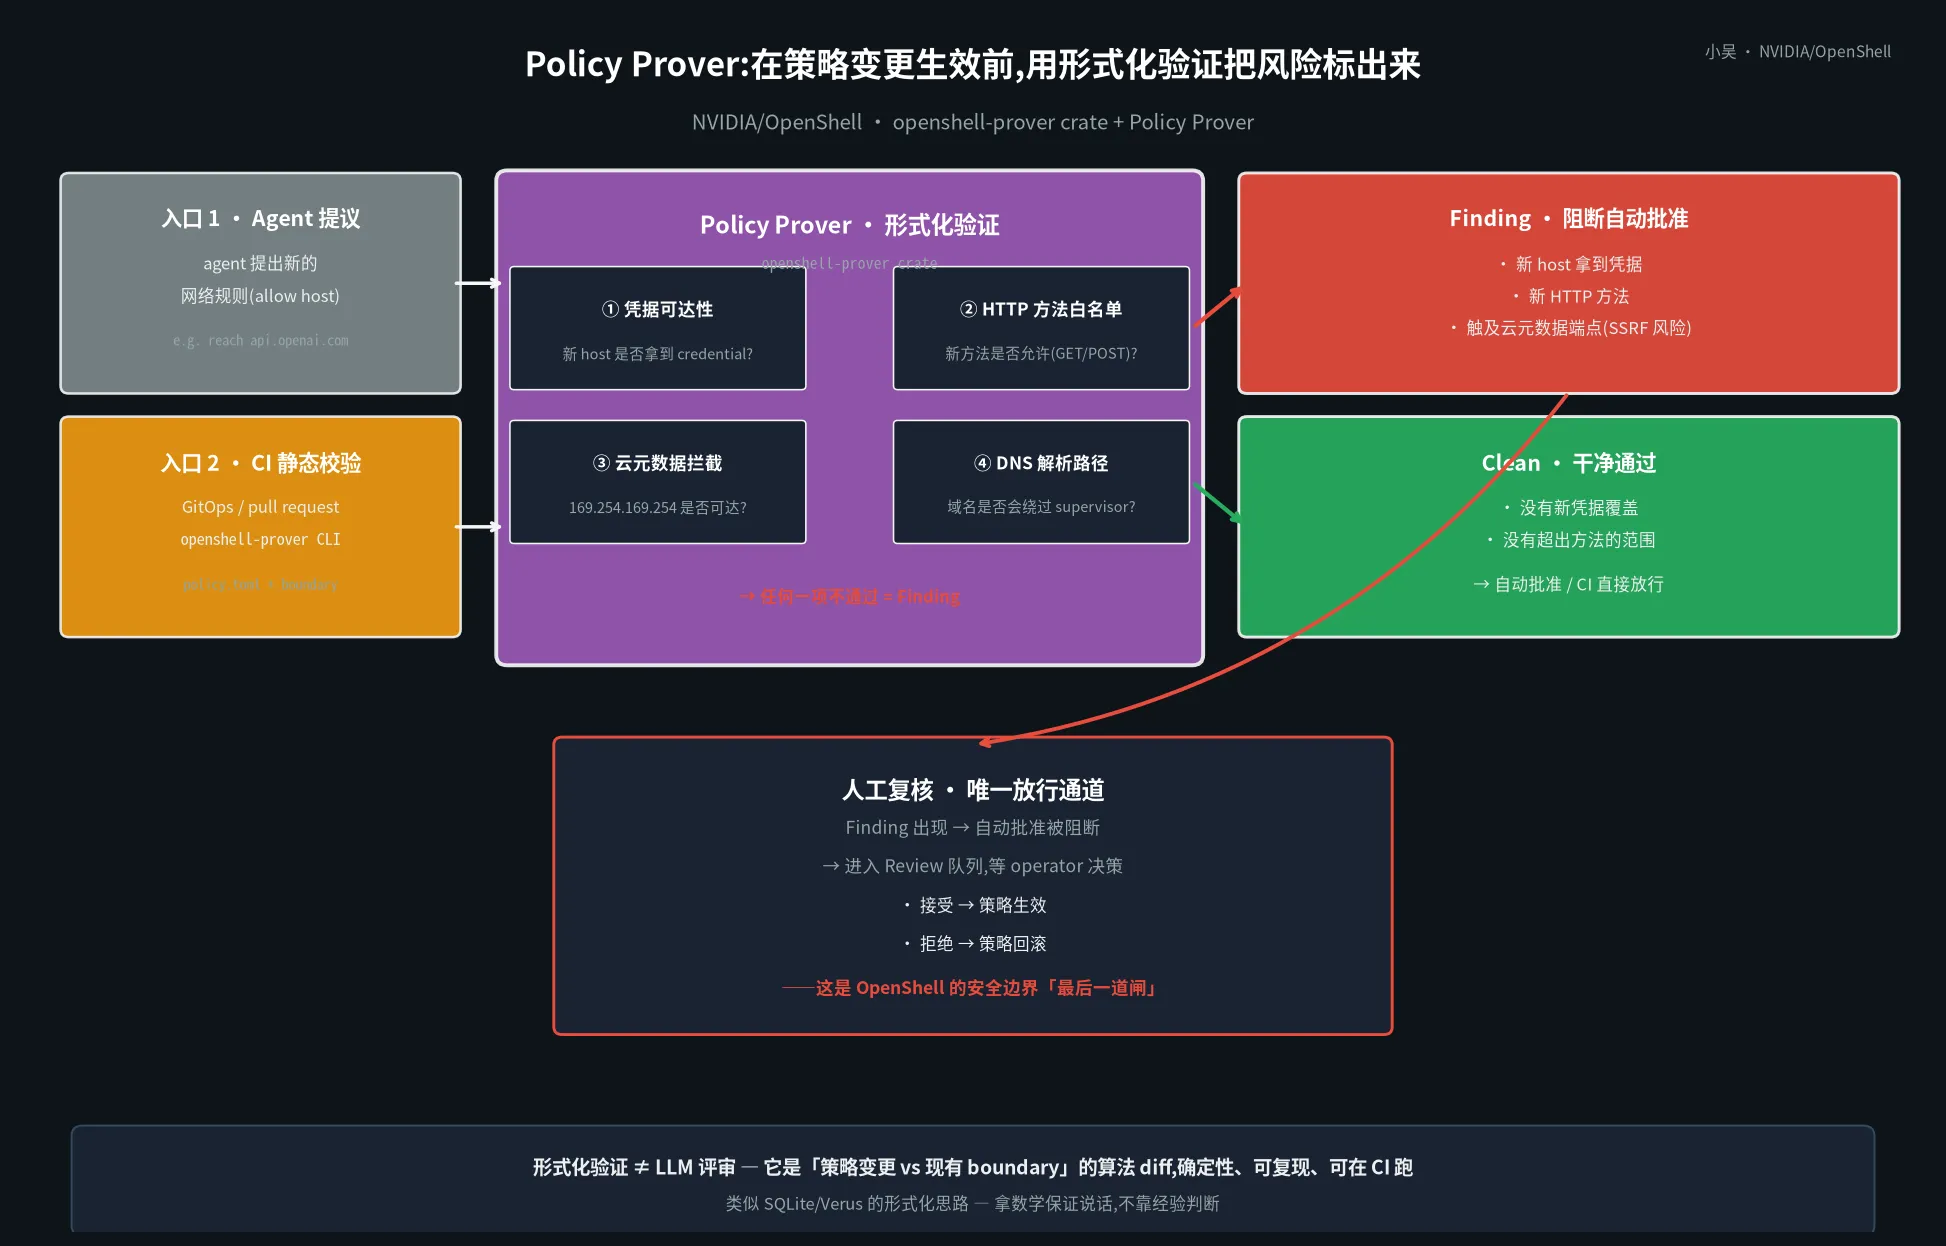
我把这条流程画成下面这张图:
4.1 两个入口:Agent 提议 / CI 校验#
Policy Prover 有两条进入路径:
- 入口 1:Agent 提议——当 agent 想新增一个网络规则(比如”我想 reach
api.openai.com”),gateway 在落地前让 prover 跑一次 - 入口 2:CI 静态校验——运维改
policy.toml提交 PR 时,在 CI 里跑openshell-proverCLI 单独校验(openshell-provercrate 是独立可发布的,不依赖整个 gateway)
后者是 OpenShell 工程化最强的体现——prover 不只是”运行时决策工具”,它是可在 CI 跑的独立可执行文件。这意味着你可以把 policy 变更像代码一样 review + 测试,形式化验证成了 GitOps 流水线的一部分。
4.2 4 个核心检查#
openshell-prover 内部对策略变更做 4 个核心检查:
- 凭据可达性——新 host 是否会拿到 credential?如果有,风险标记
- HTTP 方法白名单——新方法(GET/POST/PUT/DELETE/…)是否超出 policy 范围?
- 云元数据拦截——
169.254.169.254是否可达?(SSRF 经典目标,AWS/GCP/Azure 元数据服务) - DNS 解析路径——新域名是否会绕过 supervisor 直接解析?
这 4 个检查覆盖了”agent 出网”最常见的 4 类安全风险。其中第 3 条特别硬核——OpenShell 默认 deny 所有出网,包括云元数据端点。这是 SSRF 攻击的根,太多生产事故源于”agent 拿到了云元数据 → IAM 凭据 → 控制整个云账户”。OpenShell 把这层风险提到 prover 层用算法挡住。
4.3 决策:阻断 vs 放行#
prover 的输出是确定性的(不是 LLM 评审):
- Finding(阻断)——任何一项检查不通过 → 自动批准被阻断 → 进入人工 Review 队列
- Clean(放行)——所有检查通过 → 自动批准或 CI 直接放行
Finding 不是”错误”,而是”需要人类决策的信号”。prover 的工程价值在于:它把所有需要人类判断的情况 提前到策略变更生效前,而不是等到 agent 真出网时再发现。
4.4 形式化验证 ≠ LLM 评审#
这一点必须强调:Policy Prover 是形式化方法,不是 LLM-as-judge。
- LLM 评审:问 GPT-4「这个策略变更安全吗」——概率性、不可复现、token 烧钱
- 形式化验证:拿 policy + boundary 做算法 diff——确定性、可复现、可在 CI 跑
OpenShell 把 SQLite / Verus 的形式化思路引入到策略层——拿数学保证说话,不靠经验判断。这种思路在 AI agent 领域非常稀缺,大多数 agent 框架都是 LLM-as-judge。
五、Fail-closed:OpenShell 的最后一道闸#
我读完整个仓库后,把 OpenShell 的”安全边界”归成 3 道闸:
- 网络 fence(物理层)——outer network fence 拒绝 workload 容器/VM 的所有 egress,只允许连 supervisor
- seccomp user-notification(系统调用层)——agent 每次出网都先挂起,等 supervisor 决策
- Fail-closed(连接层)——supervisor 失联 → sandbox 冻结 agent → 不让 agent 失控
第三道闸尤其值得讲,因为它是唯一一个应对「内部组件被攻破」场景的设计:
“Fail closed. Holds launch until the supervisor confirms, and freezes the agent if the connection drops.”
翻译:launch 时 sandbox 等 supervisor 确认才放行 agent;运行时 supervisor 失联 → sandbox 冻结 agent。
这是 zero-trust 的硬核实现——即使 supervisor 自己被攻破了,只要它失联,sandbox 就会冻结 agent。supervisor 必须持续保持「健康+在场」状态才能让 agent 跑。
我把这条和数据库的 STONITH (shoot the other node in the head) 类比了一下——STONITH 是集群里”宁可节点死掉也别带病运行”,OpenShell 的 fail-closed 是”宁可 agent 死掉也别在失控中继续运行”。安全系统的本质是「让错误的代价 > 让正确继续的收益」。
六、Provider 抽象:为什么 OpenShell 不内置 API 凭据#
openshell-providers/ + docs/how-it-works/providers/overview.mdx 这块是 OpenShell 第二个被低估的设计。
OpenShell 的策略里只引用 Provider 的「服务名」,不直接持有 API key:
# policy.toml(简化示意)
[network.allow]
host = "api.openai.com"
provider = "openai-prod" # ← 引用,不是 inline真正的 key 存在 vault / kubernetes-secret / db-credstore / AWS Secrets Manager 里,supervisor 在请求被 policy 允许后,才去 provider 后端拿 key 注入到 outbound request。
这条设计解决了 AI agent 框架里一个非常现实的痛点:
凭据应该和 agent 代码分离,不然 key 泄漏 = 灾难。
我看完后,把这条归成 OpenShell 的第 3 条核心心智——「凭据不传给 agent,凭据由 supervisor 在 outbound 时注入」。这和 HashiCorp Vault 的 dynamic secrets 是一个思路,但 OpenShell 把它推到了「每次请求都临时注入」级别。
七、横向对比:OpenShell 和其他 agent 安全方案#
我读完代码后,把 OpenShell 和当前主流的 agent 安全方案做了横向对比:
| 方案 | 隔离层级 | 凭据隔离 | 形式化验证 | Linux 内核级 | 出错行为 |
|---|---|---|---|---|---|
| OpenShell | 三层(gw/sup/sb)+ 8 driver | Provider 注入,agent 看不到 | ✅ prover crate | seccomp user-notification | fail-closed |
| Docker -cap-add | 单层容器 | env 注入 | ❌ | namespace | 默认继续 |
| gVisor | 单层(用户态内核) | env 注入 | ❌ | 用户态拦截 syscall | 默认继续 |
| Firecracker | 单层 microVM | env 注入 | ❌ | 虚拟化隔离 | 默认继续 |
| E2B / Daytona | 单层容器 + API | env 注入 | ❌ | namespace | 默认继续 |
| LangChain Sandbox | 单层 Python sandbox | env 注入 | ❌ | OS-level | 默认继续 |
OpenShell 在**「隔离层级数 + 形式化验证 + Linux 内核级拦截」**这三个维度上是当前唯一同时拿满分的方案。
但 OpenShell 不是万能的,它的 trade-off 是:
- 启动延迟高——三层架构 + mTLS + provider 注入,首次 sandbox 启动比纯容器慢
- 运维复杂度高——需要单独维护 gateway / supervisor 进程,不能像 Docker 一样
docker run - Driver 依赖——生产环境要么用 docker / podman,要么上 kubernetes / microVM,小项目用 OpenShell 是 overkill
如果你只是想给 LLM agent 套个 sandbox 跑实验,Docker + restricted capability + readonly filesystem 已经够。如果你在生产环境跑”agent fleet”且有正式安全审计需求,OpenShell 是当前唯一靠谱的开源方案。
八、读源码学到的 5 件事#
8.1 把”决策 / 执行 / 转发”分三层,是 zero-trust 的硬核实现#
OpenShell 不是”加一个 sandbox 给 agent”——它是把”agent 做什么”这件事拆成三层的责任。每层独立可审计、独立可替换、独立失败。
8.2 seccomp user-notification 是被低估的 Linux 特性#
sync_file_range / userfaultfd / io_uring 这些”新 syscall 机制”通常被当成性能优化工具,但 OpenShell 把 seccomp user-notification 用成了安全机制——让 supervisor 在 syscall 挂起时介入决策。这条思路可以推广到:
- 数据库代理(Database proxy 用 seccomp 拦截 query,proxy 层加 WHERE 限制)
- LLM 推理网关(用 seccomp 拦截 agent 的 token I/O,gateway 层做 token 计费 / 限额)
- 文件传输网关(用 seccomp 拦截 read,扫描层做 DLP 检查)
8.3 Provider 抽象 = 不要把凭据塞进 agent 代码#
OpenShell 的 Provider 不只是「从 Vault 取 key」——它把「服务名」和「真实凭据」彻底解耦。这意味着同一份 policy 在 dev / staging / prod 可以引用不同的 Provider,但策略逻辑完全不变。
这条思路在多云 / 多环境 / 多团队的 agent 系统里非常关键。
8.4 形式化验证 ≠ LLM-as-judge#
OpenShell 把「策略变更是否安全」从 LLM 判断改成了算法 diff——deterministic / reproducible / CI-friendly。这是 AI agent 领域少见的工程化态度——大多数 agent 框架还在用 LLM 自己评审 LLM 输出。
8.5 Fail-closed 是 zero-trust 的最后一道闸#
OpenShell 的 sandbox 在 supervisor 失联时冻结 agent,而不是继续放行。这和数据库的 STONITH、Redis 的 protected-mode、Kubernetes 的 node taint 是同一思路——安全系统的本质是「宁可停掉也别继续错」。
九、可复用方法论:读”安全/内核”类 Rust 项目的正确姿势#
读完 OpenShell,我把读”安全/内核类 Rust 项目”的方法论总结成 4 步,和读普通业务代码不一样:
- 先看
docs/about/architecture.mdx——这类项目通常有详细的架构文档,看完架构再看代码会快 10 倍 - 找”信任分层”的边界——OpenShell 的 sandbox/supervisor/gateway 三层是信任边界,任何代码改动都要先回答”它影响哪个边界”
- 看 driver/interface 抽象——
openshell-isolation-interface是关键接口,后端(Docker/Podman/Kubernetes/VM)都通过它接入。理解 interface = 理解整个扩展机制 - 看 “fail mode”——这类项目的关键不是”happy path 怎么走”,而是”出错时怎么办”。OpenShell 的
fail-closed是关键心智
这套方法论也适用于读 RustSBI / Tailscale / Cloudflare Pingora 等”安全/网络/基础设施”类 Rust 项目。
十、写在最后#
NVIDIA/OpenShell 不是一个”完美”的项目——它的 driver 还在演化(8 种 driver 并不都 production-ready)、prover 的检查覆盖还不全、三层架构带来运维复杂度。但它做对了一件事:
把”AI agent 做事”这件事的所有不变量,提到 kernel 级 + 形式化验证层做强制保证。
这是 2026 年 AI agent 框架少见的工程态度——其他 agent 框架都在比”谁能让 agent 更强”,OpenShell 在比”谁能让 agent 在安全的边界内更强”。
读它能让你想清楚 3 件事:
- agent 的权限边界由谁决定? ——OpenShell 的答案是”policy + supervisor,不是 agent 自己”
- agent 出错时应该 fail-open 还是 fail-closed? ——OpenShell 的答案是”宁可冻结也别继续错”
- agent 的凭据应该和代码绑死还是分离? ——OpenShell 的答案是”Provider 抽象,运行时注入”
参考与引文#
本文涉及的所有引用都来自 NVIDIA/OpenShell 仓库本身,以下是我精读过的核心文件:
docs/about/architecture.mdx(主要架构文档)—— 三层架构 + 4 段担保 + Sandbox Protocoldocs/about/overview.mdx—— 项目定位 + Kernel-level enforcement + Formally verified policy changesdocs/how-it-works/gateways/overview.mdx—— Gateway 控制面职责docs/how-it-works/sandboxes/overview.mdx—— Sandbox 不可信侧职责docs/how-it-works/sandboxes/runtimes.mdx—— 4 种 runtime(Docker/Podman/Kubernetes/VM)docs/how-it-works/policies/overview.mdx—— 策略语言总览docs/how-it-works/policies/prover.mdx—— 形式化验证docs/how-it-works/providers/overview.mdx—— Provider 抽象docs/security/best-practices.mdx—— 安全最佳实践crates/openshell-prover/—— 形式化验证 crate(独立可发布)crates/openshell-policy/—— 策略引擎crates/openshell-supervisor/+openshell-sandbox/—— 三层架构的核心Cargo.toml(workspace)—— Rust 1.94,Apache-2.0,NVIDIA 官方维护README.md—— 项目自述
仓库地址:github.com/NVIDIA/OpenShell ↗
当前版本:0.1.x / License Apache-2.0 / 维护者 NVIDIA Corporation & Affiliates
关于配图:本文两张图都是用 matplotlib 重新画的——
img1-3tier.png是三层架构 + 网络请求流链路图,展示 gateway / supervisor / sandbox 三层的信任边界和 agent → sandbox → supervisor → 外网的完整路径;img2-policy-prover.png是 Policy Prover 形式化验证链路图,展示策略变更如何被算法 diff 找出风险。原仓库docs/images/里有 3 张官方 SVG,但我的重画目的是把”三层信任边界”和”形式化验证流程”这两个工程核心可视化讲出来。