REA:把 16 种逆向工具装进同一个 MCP,让 agent 用 6 个 verb 跟它们说话#
仓库 morluto/rea ↗ ·
npm i -g rea-agents或npx rea-agents setupv6.5.0 · 138K 行代码 · 3180 个.ts+ 411.mjs+ 61.py+ 53.mts· 184 个 markdown 文档 · 40 个生产 dep · MIT 15 万 star(README 自己写的数)、Discord 4k+ 社区、npm 上周 6.4→6.5 release
REA 这个项目最让我意外的不是它能逆向多少东西,而是它没有自己写一个逆向引擎。它做的事情是把 Hopper / Ghidra / IDA / JADX / Cutter / mitmproxy / LLDB / Frida / mitmproxy / pwntools / tshark / sigrok / binwalk / unblob / Playwright 这些已经存在十年二十年的逆向工具接进同一个 MCP server,然后给 agent 一套 6 种 shape 的 verb(inspect / search / trace / compare / workflow / observe),让 agent 在一次对话里能挑对的工具、看懂的产物、保留的证据。
下面是通读仓库 + 跑通 8 个核心模块后的笔记,按”为什么 → 怎么连的 → agent 怎么用 → 哪些坑”重新组织一遍,所有结论都能在 src/composition/ + src/application/binary/ + bridge/ 三个目录里复现。
0. 先把数字摆出来#
- 核心数字:
v6.5.0/ 138K 行 / 3180 ts / 411 mjs / 61 py / 53 mts / 184 md / 40 dep / MIT - 包名:
rea-agents,bin 是rea/rea-agents,CLI dispatcher 是scripts/rea.mjs - 入口:
src/main.ts(MCP stdio)+src/cli.ts(incur 框架 CLI)+src/composition/26 个 factory - Provider 适配器 16 个:
hopper/ghidra/ida/kuna/wasm/evm/android/apktool/adb/flutter/firmware/pcap/signals/go/rust/sqlite/objdump/rizin/gdb/dotnet/frida/browser/jeb/electron/inspector/cutter/reference - Bridge 进程 9 个,嵌在宿主引擎里:
bridge/hopper_bridge.py52KB(嵌进 Hopper)bridge/ghidra/ReaGhidraBridge.java242KB(Ghidra HeadlessScript 主体,占仓库 1/4 体积)bridge/cutter/rea_bridge.py38KB(Cutter)bridge/android/ReaJadxBridge.java20KB(JADX)bridge/native/rea_lldb_tracer.py35KB(LLDB)bridge/mitmproxy/capture.py19KBbridge/nativeaot/*Java 4 文件 22KB(Ghidra 插件)bridge/process/ProcessRunTokenReader.swift12KB(macOS 进程 token 读取)bridge/pwntools/{layout,decoder_runtime,recorded_crash}_impl.py
- 架构图:
docs/architecture.mermaid174 行,14 个 subgraph,把 Composition → Application → Provider → Process → Domain → Contracts → Config 全画了 - 协议层:
@modelcontextprotocol/server@2.3.1走 stdio JSON-RPC,单次响应受REA_MCP_MAX_RESPONSE_BYTES限制,默认 10MiB,超大结果走inspect_analysis_view分页 +export_evidence_bundle落盘 - 配套 Skill:
.agents/skills/reverse-engineer-anything/SKILL.md23KB,version 42,这是给 agent 看的路由表,等于 REA 的”产品说明书” - 支持 agent 11 个:Claude Code / Codex / Cursor / Gemini CLI / Grok Build / Claude Desktop / Windsurf / Devin / OpenCode / Antigravity / Copilot CLI / CommandCode / VSCode / OMP / Grok Bot(注:Grok Bot 没有本地文件注册,setup 不写
mcp.json)
1. 它要解决的真问题#
逆向工程这件事在 2024-2026 跟以前不一样了——核心场景不再是”安全研究员手动跟一份 ELF”,而是:
“我看见 macOS Notes 有个搜索功能挺好,想自己项目里也搞一个,但我没有它的源码。”
这件事在 2024 年需要做这些事:
- 解压
.app,看 main 进程的 binary,用 Hopper/Ghidra 翻出反编译 - 同时看 Electron preload.js 跟 main 进程的 IPC 通信
- 跑一遍目标,用 mitmproxy / Wireshark 抓出网络请求跟解密 payload
- 找到关键函数 call graph,从伪代码推到 C
- 重新实现,跑测试用例验证
这件事的特点是”工具多、跨进程、产物格式各异”。Hopper 给的是伪代码,Ghidra 给的是 P-Code,mitmproxy 给的是 HAR,Frida 给的是 trace,source map 给的是原始行列号。每一个工具的 CLI / API / 产物都不一样。
Agent 时代以前的做法是:写一个 wrapper 工具,统一所有这些后端的输入/输出,给上层一个稳定接口。REA 的解法恰好是这件事的 MCP 版本——但做得更狠:
- wrapper 工具 = 一个 stdio JSON-RPC MCP server
- 统一接口 = 6 种 shape 的 verb
- 上层 = 任意一个支持 MCP 的 agent(11 个开箱即用)
- 目标 = native binary / JS / Electron / .NET / Android / web / 抓包 / 信号 / 固件 / WASM / EVM / SQLite / Go / Rust
这件事的工程难度不在”连”—— Hopper/Ghidra 都有 Python 绑定,问题是”接进去以后怎么不让 agent 用错”。REA 的核心价值是契约(input/output schema + Evidence + limitations 三件套),而不是”我支持多少种逆向”。
2. 一次调查走完所有层 — 全景图#
下面这张图(我自己画的)把 REA 一次调查的完整数据流画出来:用户问句 → agent → MCP stdio → composition 工厂 → provider adapter → bridge 进程 → Evidence ledger 回流。
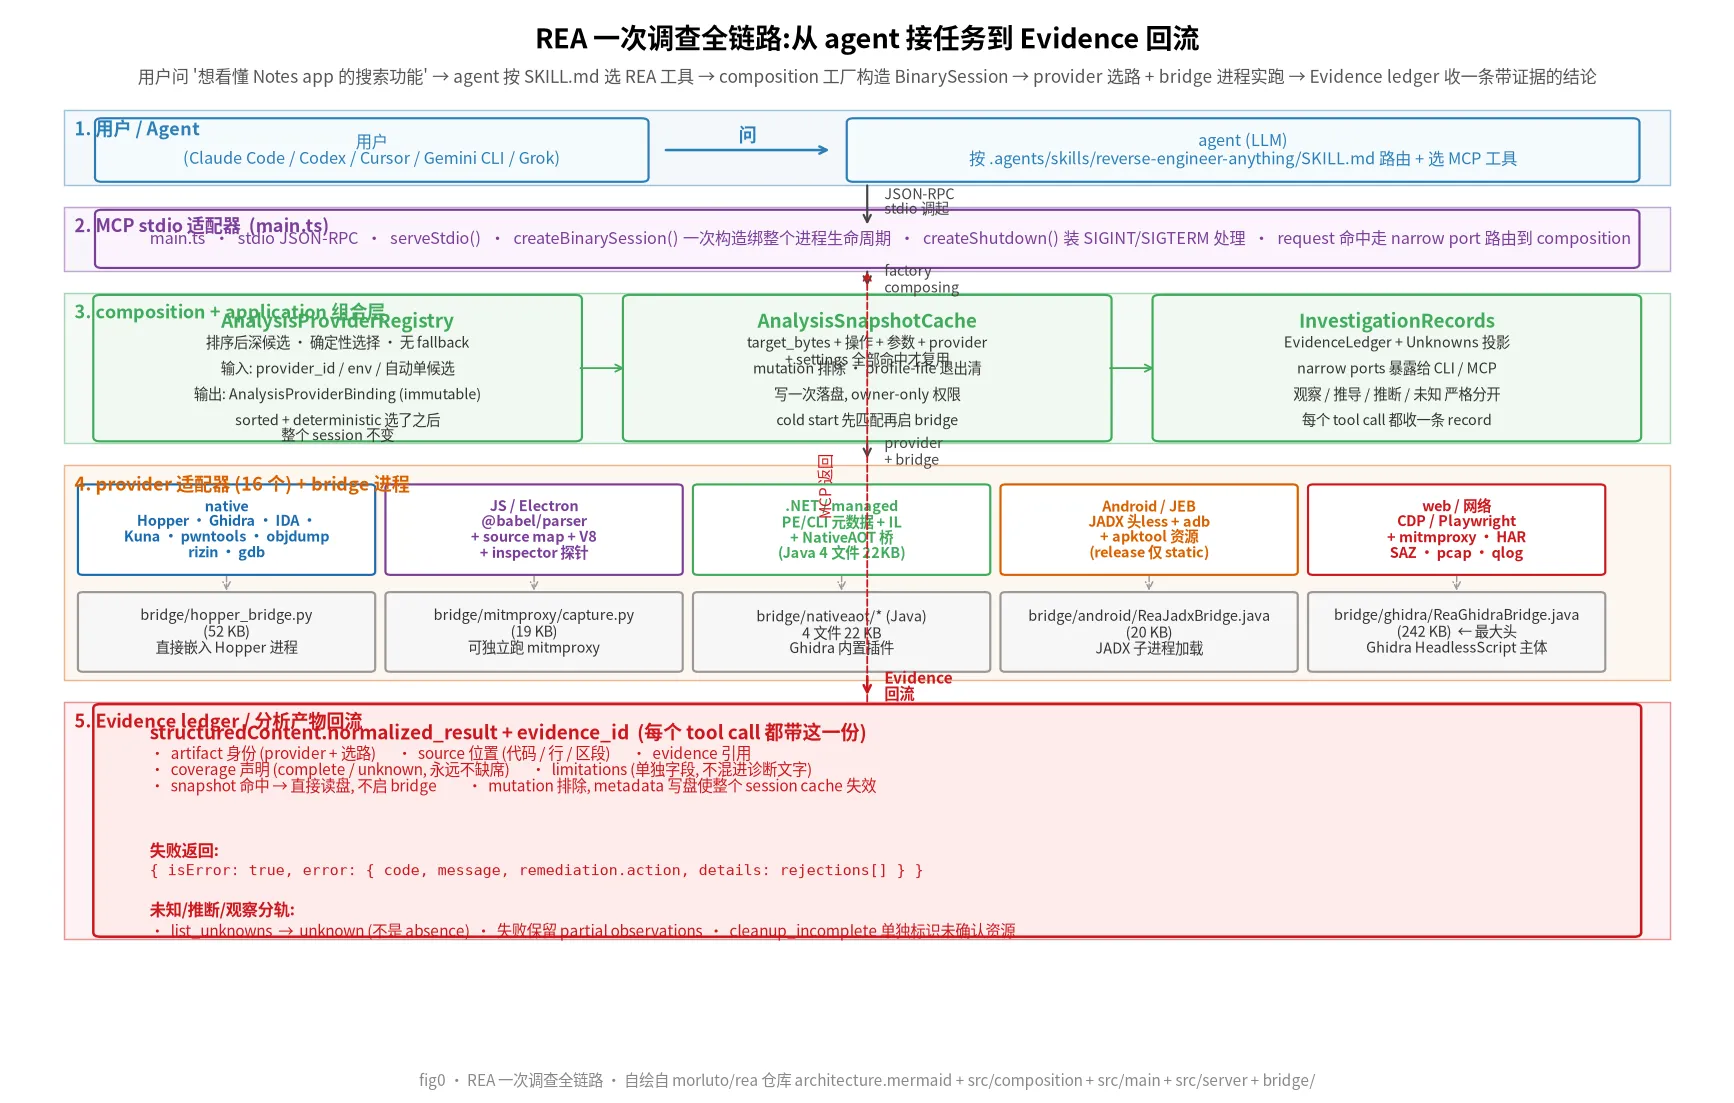
fig0 · REA 一次调查全链路 · 5 个泳道,每条泳道内的事在泳道内完成,跨泳道只用文字标注
要稍微解释几个我反复琢磨的细节:
第 2 行 main.ts 不是个 dispatcher,而是个”长生命”持有者。createBinarySession() 一次构造,绑整个进程生命周期;createShutdown() 装 SIGINT/SIGTERM。MCP request 不是每个 tool call 重新开进程,而是所有 tool 共享同一个 BinarySession。
第 3 行 composition 是src/composition/下 26 个 factory 文件,每个文件 6-29 行,只做一件事:“把 config + env 塞给 N 个 provider,装进 registry,返回 BinarySession”。createBinarySession() 这一个函数 73 行就串完了 Hopper + Ghidra + IDA + Kuna + 12 个 auxiliary。
第 3 行 application 才是核心逻辑。AnalysisProviderRegistry(890 行)+ AnalysisSnapshotCache(383 行)+ InvestigationRecords(375 行)三件套,撑起 REA 的”严”字:
- Registry:5 步选路(下面 §5 详述),输出 immutable
AnalysisProviderBinding,整个 session 不变 - Snapshot Cache:
target_bytes + 操作 + 参数 + provider + settings全部命中才复用,mutation 排除,profile-file 退出清 - Investigation Records:每个 tool call 一条,带 evidence_id / artifact 身份 / source 位置 / coverage 声明 / limitations,观察 / 推导 / 推断 / 未知 严格分轨
第 4 行 16 个 provider 适配器 + 9 个 bridge 进程。每个 provider 在自己的进程组里跑(src/process/ 拿到的都是 owned process group,deadline 跟 file 描述符都是 own 出来的),bridge 是把 provider 的私有协议包成”stdin 喂 JSON、stdout 吐 JSON”的双工流。最重的 ReaGhidraBridge.java 242KB 占整个仓库 1/4 体积,因为 Ghidra 的 P-Code / Decompiler / References / CFG 全要重新包成 MCP-friendly 的 schema。
第 5 行 Evidence ledger 才是 REA 的”产品”。所有 tool 都返回:
{
  "structuredContent": {
    "normalized_result": { /* provider 解析后的结构 */ },
    "evidence_id": "ev-2026-10-17-NN"   // 全局唯一
  },
  "raw_result": { /* provider 原始形态,可能为 null */ },
  "analysis_profile": { /* 必须 present, 哪怕 null */ }
}evidence_id 是整条证据链的锚——compare_functions / compare_artifacts / inspect_analysis_view / get_evidence_bundle 全靠这个 id 找回同一份 record。
3. 6 种 shape 怎么用 — 给 agent 的”动词表”#
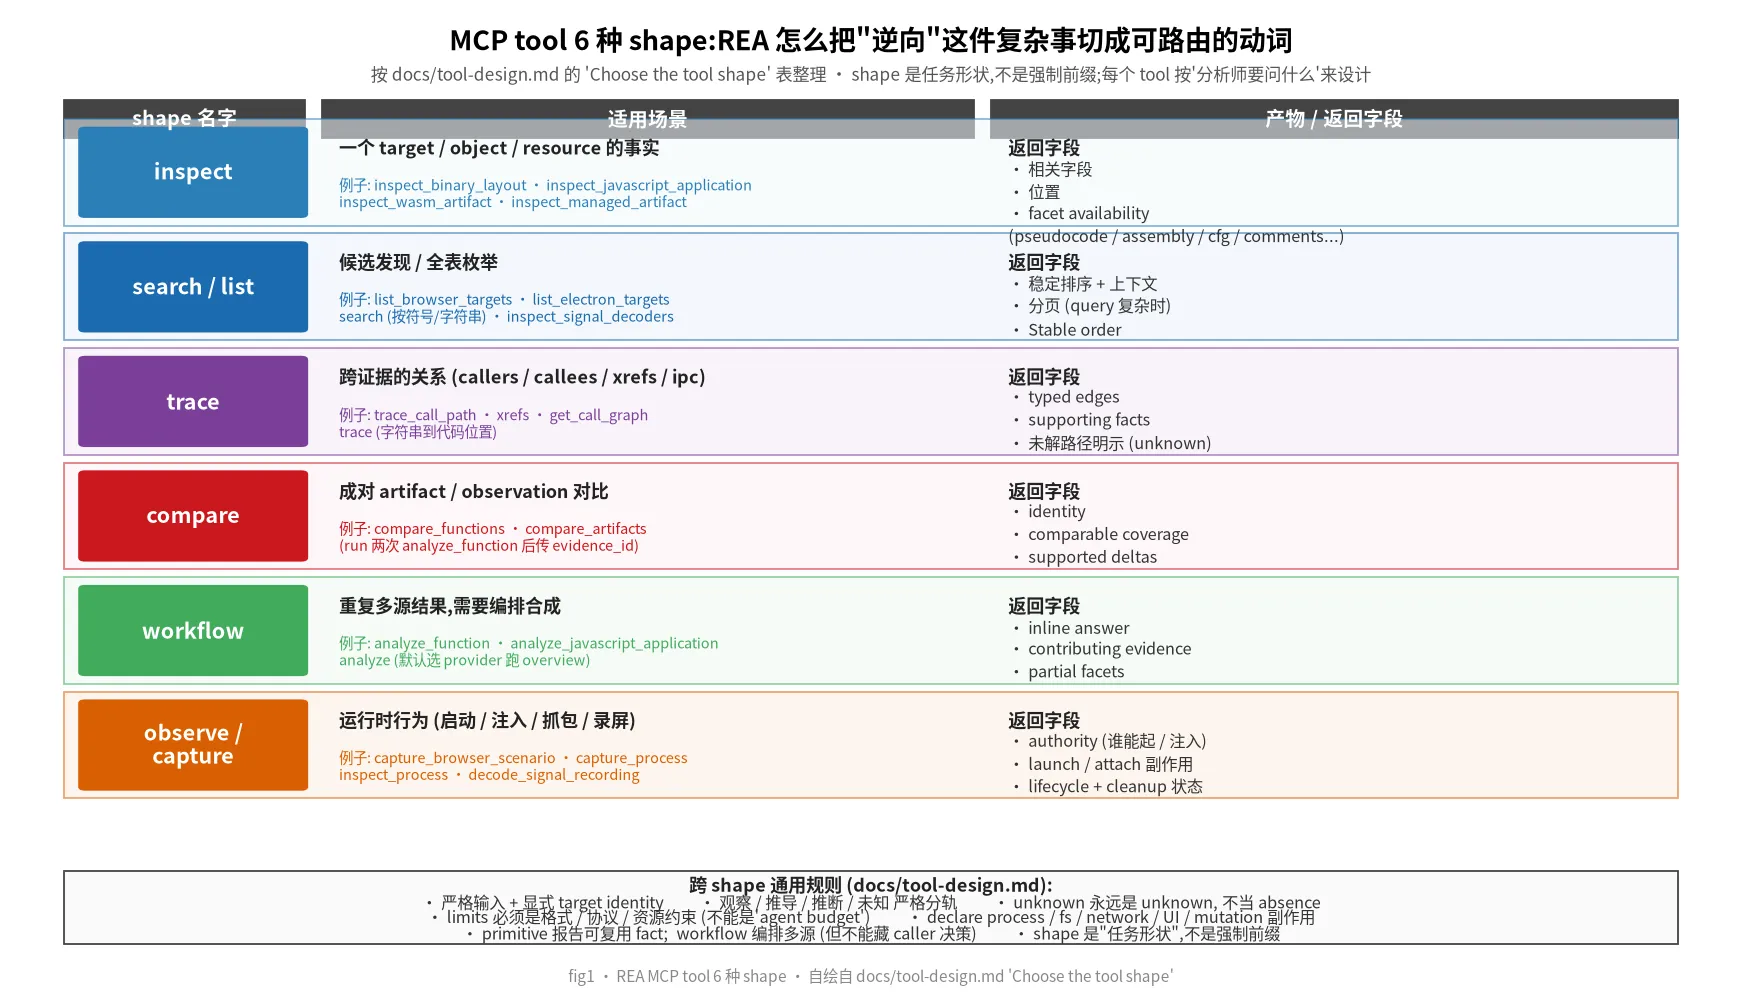
REA 把所有 tool 按任务形状分成 6 类,这件事在 docs/tool-design.md 的”Choose the tool shape”那段写得很清楚,我自己重画成表:
fig1 · REA MCP tool 6 种 shape · 每行: 名字 / 适用场景 / 产物 / 真实例子
几个我读完后印象深的细节:
inspect 是 read,workflow 是 read + 编排。inspect_javascript_application 不做选择,只把目录 / ASAR 拆成 modules / imports / Electron boundaries 给你;analyze_function 在 inspect 之上,还要 provider 选路 + snapshot 命中判断 + 串 pseudocode/assembly/comments/callers/callees/references 七个 facet。这一刀划得很准:agent 想”看事实”用 inspect,想”我要答案”用 workflow。
trace 的产物永远是 typed edges + supporting facts + 未解路径明示。trace_call_path 如果一个 goal 走不通,goal_status: "unknown" 走完所有已知边;truncated: true 表示已遍历路径仍然有效;residual_unknowns 把没走通的边交回给 caller。这跟 GraphRAG 的”走过的事实 vs 没走过的事实”分得清清楚楚。
observe / capture 这两个 shape 跟其他 4 个的根本区别是”有副作用”。capture_browser_scenario 启 Chrome 跑步骤、capture_process 跑你给的命令、decode_signal_recording 读 sigrok 设备、inspect_packet_capture 读 pcap。REA 在 input 阶段就 declare 副作用(process / fs / network / UI / mutation),agent 必须在 client 端显式 approve 才能跑——这跟 inspect 这种纯 read 形成对照。
shape 是任务形状,不是强制前缀。REA 不强制每个 tool 必须叫 inspect_xxx 或 trace_xxx。比如 analyze_function 是 workflow,叫 analyze 不叫 inspect_function;analyze_javascript_application 是 workflow 也叫 analyze。这种”按读者直觉命名”比”按内部 taxonomy 命名”重要得多。
4. 那个 5 步选路具体怎么走#
Provider registry 选路是 REA 的”严肃”之魂——src/composition/binary.ts 73 行 + src/application/binary/AnalysisProviderRegistry.ts 890 行,我把它画成下面这张图:
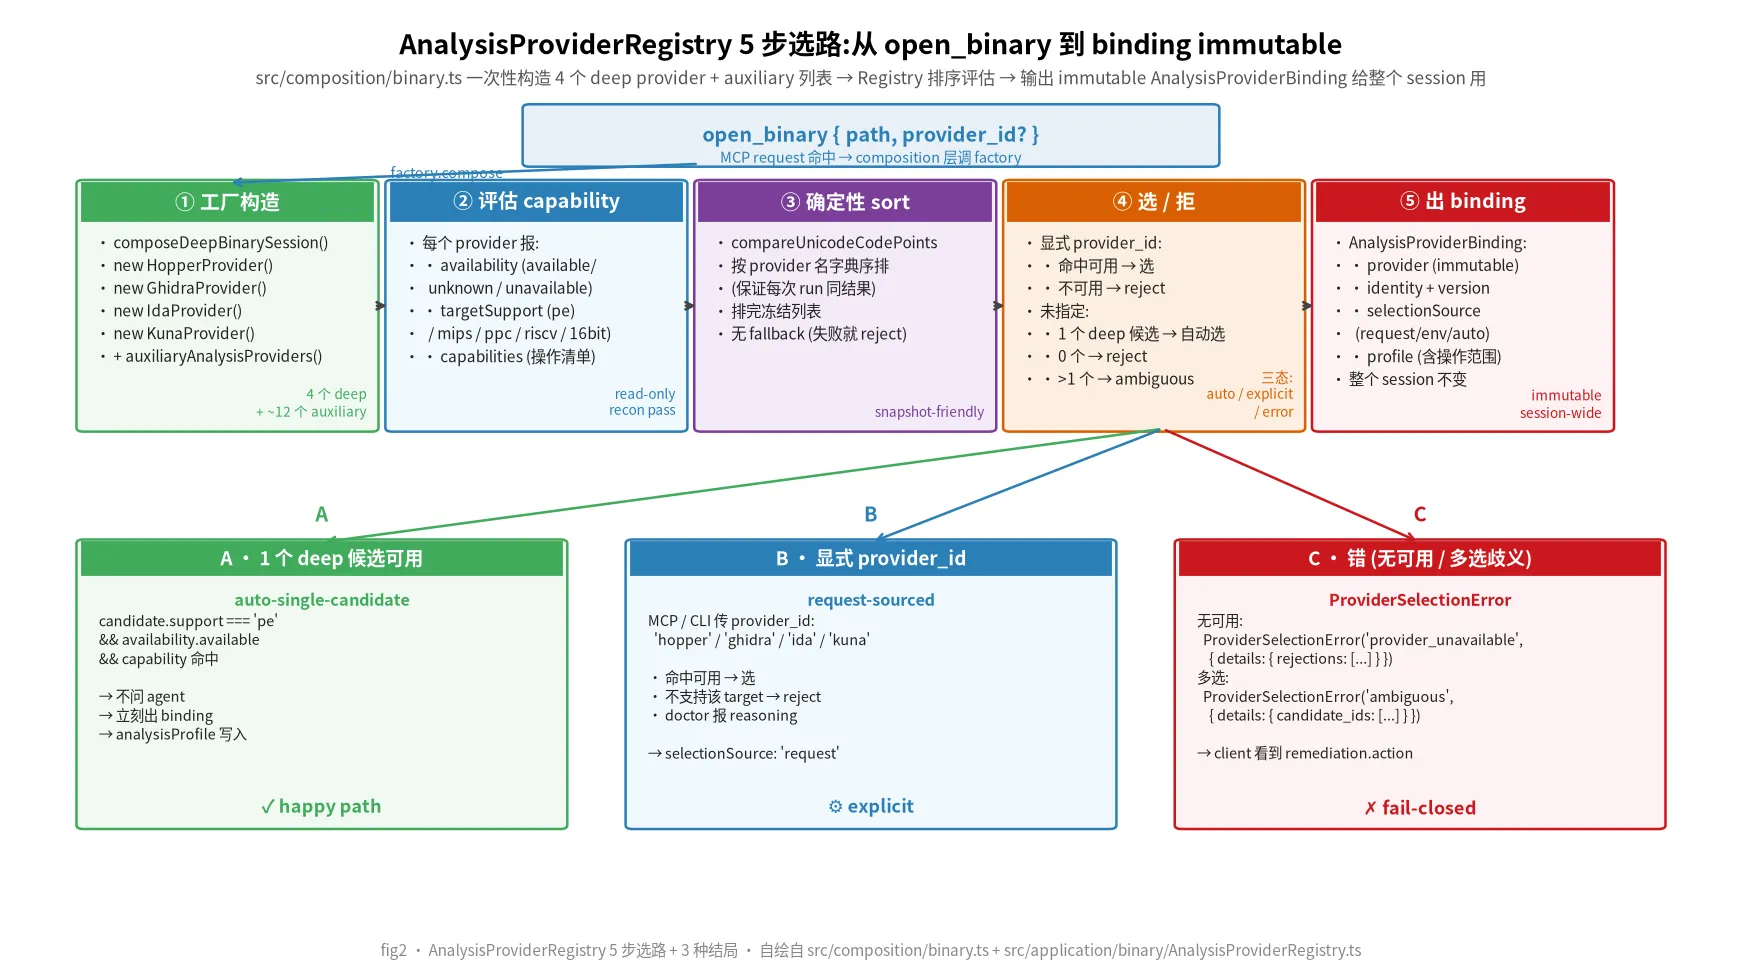
fig2 · AnalysisProviderRegistry 5 步选路 + 3 种结局 · auto-single / explicit / fail-closed
几个细节我专门拎出来:
第 ① 步工厂构造只跑一次。composeDeepBinarySession() 一次性 new HopperProvider() + new GhidraProvider() + new IdaProvider() + new KunaProvider() + 12 个 auxiliary 适配器,然后全部塞进 AnalysisProviderRegistry。之后所有 tool call 共享这个 registry。
第 ② 步 capability 评估是 read-only recon pass。每个 provider 报:
availability: available / unknown / unavailabletargetSupport: pe / mips / ppc / riscv / 16bit-doscapabilities: 该 provider 暴露给 agent 的操作清单
这一步不改任何东西、不启任何进程。Hopper 真的起没起来不在这里查,Hopper 的”我能反编译 PE 二进制”在这里报。
第 ③ 步 deterministic sort是 REA 最大的”反 AI 化”动作——按 provider 名字符串字典序排(compareUnicodeCodePoints),排完冻结。这意味着同 target 同 env 下,两次跑出来的候选列表完全一样。没有”这次我选 Hopper 这次我选 Ghidra”的不确定性,agent 跟人都能复现。
第 ④ 步选 / 拒分 3 种情况:
- 显式
provider_id: 'hopper': 命中且可用 → 选;不支持该 target → reject - 隐式(没指定): 1 个 deep 候选可用 → 自动选;0 个 → reject;>1 个 → ambiguous
第 ⑤ 步出 binding。AnalysisProviderBinding 是 immutable 的,带:
- provider(具体实现)
- identity + version
- selectionSource(request / env / auto)
- profile(操作范围)
整个 session 用这一份 binding,直到显式 switch 或 close。
A 类结局 auto-single-candidate最常见。一个 target 配一个能用的 deep provider(比如 macOS .app 在 Hopper 上),agent 不需要选,REA 直接出 binding。这一步是 REA 把”agent 决策成本”压到最低的关键。
B 类结局 explicit给 agent 显式控制权。provider_id: 'ghidra' 就走 Ghidra,不管 Hopper 装没装。doctor --provider ghidra --json 还能查”为什么这个 provider 不可用”。
C 类结局 fail-closed 是 REA 不绕弯子的体现。没有 fallback—— Hopper 不行就 reject,不会”那试试 Ghidra 吧”。错误直接进 ProviderSelectionError 带 details.rejections[],client 看到 remediation.action 决定下一步。这一刀切得很清楚:对分析工具来说,默默换 provider 等于让 agent 拿到错的结论。
5. Evidence ledger 是怎么把”结论”跟”猜测”分开的#
docs/mcp-contracts.md 第 1 节就讲清楚 Evidence 的契约。我把最关键的 4 条拎出来:
1. 观察 / 推导 / 推断 / 未知 严格分轨。
normalized_result放 provider 解析的结构化结果raw_result放 provider 原始形态(Hopper 的某种格式、Frida 的某段 trace)analysis_profile永远 present(哪怕 null),记录这次分析是谁做的、用的什么 profilecoverage字段:{ scope: "root"|"container-entries", status: "complete"|"unknown" }—— complete 是事实,unknown 不等于 absent
2. facet availability 明示。analyze_function 返回的 7 个 facet(pseudocode / assembly / comments / callers / callees / references / strings_names / cfg)每个都报 { available: true } 或 { available: false, reason: "..." }。“看不到” = 明示的”看不到”,不是”假装看到了”。
3. limitation 跟 coverage 分开。一个 dossier 哪怕 coverage complete,Hopper 也可能报 limitations: ["unresolved calls: 3, see xref detail"]。这两条不能合并:coverage 是”读没读完”,limitations 是”读完但有 caveat”。
4. unknown 永远是 unknown,不当 absence。list_unknowns 返回所有”未解边”的当前 head,id 稳定;get_call_graph 的 goal_status: "unknown" 跟 "not_reached" 严格区分。这套语义让 agent 不会把”我不知道”当成”没关系”。
6. bridge 进程那点事 — Python / Java / Swift 怎么混#
bridge/ 这个目录是最容易被忽视的——9 个文件 5 种语言,大小差 20 倍,从 1KB(bridge/pwndbg/launch.py)到 242KB(bridge/ghidra/ReaGhidraBridge.java)。我看下来它们的共同模式:
每个 bridge 是一个 owned subprocess。src/process/ 的 SharedStartupAttempt + AnalysisCleanupLease 保证 bridge 进程的 pid 跟 REA 进程的 child 关系严格记录,清理时按 owner 反向回收。bridge 死掉不会让 REA 死掉,但 REA 死掉时所有 bridge 一定会被 kill(Windows 走 Job Object, macOS 走 process group, Linux 走 prlimit)。
Python bridge 走 JSON over stdin/stdout。hopper_bridge.py 是个完整的服务,内部把 Hopper Python API 包装成 30+ 个 verb(analyze / decompile / xref / patch / search),JSON 协议不复杂。gdb 跟 pwntools 的 bridge 复用 pwntools/recorded_crash_impl.py 跟 pwndbg/core_context.py 这套。
Java bridge 走 Ghidra HeadlessScript。ReaGhidraBridge.java 是整个项目最大的单文件,242KB,内部用 Ghidra 自己的 P-Code + Decompiler API,封装出”decompile / instructions / xref / patch / apply_seeds” 五个 verb,再走 JSON 序列化到 stdout。ReaGhidraApplySeeds.java 跟 ReaGhidraExtensions.java 是附属 helper。
Swift bridge 走 LLDB Python 模块。ReaNativeUI.swift + NativeUIChildren.swift + ProcessRunTokenReader.swift 是 macOS 平台的私有功能,UI 控件枚举 + 进程 token 读取,这些 iOS App reverse 工程必备。
Android bridge 走 JADX 进程。ReaJadxBridge.java 20KB,跟 JADX 自己的 decompile engine 跑在同进程里,通过 stdin/stdout 通信。
这些 bridge 的设计哲学统一是”在宿主进程里跑、用宿主 API、JSON 通信”。bridge/mitmproxy/capture.py 19KB 是个特别干净的 addon,直接 addons = [capture] 装到 mitmproxy 上。
7. 协议层那些 5% 的细节#
docs/mcp-contracts.md 跟 docs/tool-design.md 这两份文档加起来 1276 行,我把最重要的 5 条拎出来:
1. 10MiB stdio receive buffer 是硬上限。REA_MCP_MAX_RESPONSE_BYTES 必须 ≥ 10485760 的安全十进制整数,REA 留 1024 字节给 envelope。超过这个 size 的 native function evidence 走 inspect_analysis_view 的 details.reported_limits.continuation —— continuation.name + continuation.arguments 直接可调,agent 不用猜下一步。
2. snapshot 命中规则:target_bytes + 操作 + 参数 + provider + settings 五元组全等才算命中,mutation 跟 cursor-dependent 调用被显式排除。这意味着同一个 analyze_function 调两次,第二次就是读盘——对大 binary 来说单次 Ghidra 启动是几十秒,这个缓存很值。
3. dispatch metadata write 会让整个 session snapshot 失效——即使 reply 失败,provider 可能已经写了。REA 用这条规则保护 agent 不被”成功但已 stale”的缓存坑。
4. provider 启动是 one producer / multi waiter。多个 caller 共享一个 Hopper 实例,最后一个 caller 等 cleanup。REA 在 SharedStartupAttempt 里强制这条语义,不让你”另起一个 Hopper”。
5. cancellation 不会被清空。client 取消时,已观测的 result 不丢,cleanup 还在跑,error 里带 caller 原始 abort reason 链。这条让”长跑 native work 跑了一半 client 跑了”不再产生幽灵状态。
8. 我复现一下核心概念#
不用装 REA,你也能感觉到它整套设计哲学。读这三个文件就够了:
git clone --depth 1 https://gh-proxy.com/https://github.com/morluto/rea
cd rea
# 1. 完整数据流 (174 行 mermaid)
bat docs/architecture.mermaid
# 2. 工具形状 6 种 (53 行)
sed -n '/Choose the tool shape/,/^## /p' docs/tool-design.md
# 3. 选路 5 步 + 3 种结局 (73 行 TS + 890 行 TS, 看 factory)
cat src/composition/binary.ts
# 4. MCP 契约 (890 行, 看 §1 即可)
sed -n '/## Tool results/,/^## /p' docs/mcp-contracts.md如果真要跑(注意: Hopper / Ghidra / IDA 这些是付费的,REA 不会替你装):
# 静态 JS / Electron / .NET 不需要 native engine
npx -y rea-agents@latest analyze-javascript-application /path/to/extracted/app --json > app-evidence.json
# 一个 334MB 的 Obsidian 包出来大约 10KB 的 summary view
jq -c '{source: {kind: "inline", evidence: .}, view: {kind: "summary"}}' app-evidence.json > app-view.json
npx -y rea-agents@latest inspect-analysis-view app-view.json这套 CLI fallback 跟 MCP 完全等价—— same Evidence, same shape, same coverage 声明。
9. 复用价值最高的几条#
读完以后我自己留下的几个工程套路,记下备查:
1. 任何”接 10 个外部工具”的项目,都该先写 shape 划分再写 tool。REA 的 6 种 shape 来自 docs/tool-design.md 的 53 行——它先回答”agent 要做什么动作”,再回答”这个动作需要哪些 tool”。这件事的工程意义:tool 数量膨胀时,shape 帮你决定是新增还是合并,而不是”有需求就加 tool”。我自己写过的几个 MCP server 都有”先堆 tool,后面想合并合不动”的问题。
2. deterministic sort 是个被低估的反 AI 化动作。REA 按 compareUnicodeCodePoints 给 provider 排序,排完冻结。对所有”选 X 还是 Y”的决策都该有这一步——agent 跟人都能复现结果,debug 跟 review 才有意义。
3. owned subprocess + cleanup lease 是一对。bridge/ 的 9 个进程全是 owned subprocess,src/process/ 的 AnalysisCleanupLease 跟 ArtifactResourceScope 跟 SharedStartupAttempt 三件套保证 owner 死掉时所有 child 一定能被 kill。这是给”嵌进宿主进程”型 bridge 的标准答案—— Hopper 跟 Ghidra 都不是 REA 能 fork 改的,REA 只能”借住”,但”借住”的卫生条件要够。
4. snapshot 缓存键的”五元组”很值。REA 缓存 = target_bytes + 操作 + 参数 + provider + settings 五元组全等。这件事比”加 LRU”重要 100 倍—— cache 命中率从 0% 到 60% 在大 binary 场景里意味着少启动 60 次 Ghidra,每次省 30 秒。
5. Evidence ledger 的 4 轨分法比单纯的”加 log”值钱。REA 把观察 / 推导 / 推断 / 未知 4 轨分开,facet availability 明示,unknown 永远不当 absence。这条对所有”自动 + 严谨”系统都适用—— LLM agent / 自动驾驶 / 量化交易 / 编译优化都该有类似的 ledger。
6. shape 是”任务形状”,不是”强制前缀”—— 这条值得反复读。REA 的 analyze_function 跟 analyze_javascript_application 都不叫 inspect_xxx,但都是 workflow。这种”按读者直觉命名 > 按内部 taxonomy 命名”的取舍是产品感不是工程问题。
10. 边界 —— REA 自己也写明了#
AGENTS.md 跟 docs/roadmap.md 把 REA 的边界写得很清楚:
- “Local-only” 是承诺也是限制。REA 永远不上传你的 app,但意味着 agent 的 model provider 拿到的是 tool result,不是 REA 自己处理过。
- Hopper / Ghidra / IDA / JEB 是 BYO(Bring Your Own)。REA 不替你装也不替你授权,商业 license 责任在用户。
DISCLAIMER.md反复强调”cracked copies 跟 stolen keys 不被授权”。 - Windows Ghidra P0 是 experimental。
docs/windows-ghidra-p0.md是 1.0 前的支持列表,GUI-only 跟 read-only,没有 mutation authority。 - process / capture 类 tool 永远 require 显式 client 批准。这是对运行时副作用的硬约束,
rea setup会展示要改的 config 让用户 approve 才写盘。 - 新 provider / 涉及 target execution 或 injection 的 capability 必须先拿到 maintainer 范围决议才能进 production。
CONTRIBUTING.md的 “fail-closed integration rule” 把这条制度化了。
11. 小结#
REA 这个项目最让我佩服的不是”它能逆向多少东西”,而是它把”接 16 种工具,统一 6 种动词,给 agent 用”这件事做成了一门手艺:
- 138K 行代码里 ~40% 是 TypeScript 核心, ~30% 是 Python/Java bridge, ~15% 是文档(184 个 md),剩下的 mts/mjs 是构建配置
- 6 种 shape 的 verb 让 agent 跟工具的对话有界,不是”无限 tool 海洋”
- 5 步 deterministic sort 让选择可复现,不靠 fallback 不靠 heuristic
- Evidence ledger 的 4 轨分法 让”自动 + 严谨”真正落地,不是”AI 觉得 OK”
- own subprocess + cleanup lease 是”借住宿主进程”的标准答案
- 10MiB 协议上限 + inspect_analysis_view 分页 让大 binary 也能在 MCP 里搬运
- “local-only”承诺 + BYO commercial tool 把法律责任跟产品边界划清楚
对工程读者最有用的一句话:如果你想给自己的多工具 agent 写 MCP server,REA 的 6-shape 表 + Evidence 契约 + deterministic sort 是三个最该抄的设计。其他细节(owned subprocess、snapshot 五元组、bridge 协议)都是次要的——这三条对了,你的 MCP server 就站得住。
对逆向工程读者:REA 不替你做逆向,它替 agent 把 16 种工具的统一语言写完了。Hopper 跟 Ghidra 跟 IDA 该花的钱还得花,该学的反编译技术还得学。REA 解决的是”agent 怎么用你”,不是”逆向工程师怎么逆向”。
参考资料
- morluto/rea 仓库 ↗ — v6.5.0
- rea.tools ↗ — 官方文档 + worked guides + showcase
- rea-agents npm ↗ — 上游包
- mrexodia/ida-pro-mcp ↗ — REA 的 IDA 适配器复用
- skills.sh 路由 ↗ — Agent skill 入口
- DX-Ball / Notion / TH04 三个 showcase ↗ — 真实逆向工作流样例
- Hopper / Ghidra / IDA / JEB / Kuna — 商业逆向引擎,REA 不分发 license
- agentskills.io spec ↗ — REA skill 实现的协议