仓库:github.com/morluto/rea ↗ · 官网:rea.tools ↗ · MIT · v6.4.0 · 1,527 个 TS 文件 / 约 31 万行 / 53 篇 docs 90K star,最近发版 2026-10-11,Trending 长期在榜。
先看一组数字:1,527 个 TypeScript 文件、31 万行代码、30 个 bridge 文件、53 篇文档——这还不包括 9 个内嵌的逆向工具(Hopper / Ghidra / IDA / mitmproxy / JADX / pwntools / pwndbg / Playwright / Wakaru),它们是 REA 调用的”外部引擎”,REA 只负责把它们讲成同一套接口。
REA 的全名是 Reverse Engineer Anything,定位只有一句话——“让 AI agent 能像调函数一样去逆向二进制、Electron、APK、.NET、WASM、EVM、网站、网络抓包”。能反向从应用里学到一个 feature 的实现方式,然后给出证据,帮人复刻或者理解。
我之前拆过的 Pi / litellm / raddebugger 都是”把一类工具收编成一个门面”的思路,REA 是把这条路走到了头——一个 CLI 进程,既能 npx rea-agents setup 帮 Claude Code / Codex / Cursor 注册 MCP,也能 npx rea-agents analyze-javascript-application /path/to/app --json 直接当命令用,背后是同一份 session、同一份 Evidence、同一套 Provider 选择算法。
下面这几章是读完入口、Composition 层、Provider Registry、Session、Bridge、JS 数据流之后,我觉得最值得抄的几个判断。不是 31 万行的事无巨细,而是”它做了什么选择,代价是什么”。
一、REA 在解决什么”很烦的问题”#
如果你跟一个 AI agent 说”看一下 Spotify 桌面版里那个 EQ 是怎么实现的”,它要么让你贴代码(没有),要么让你装 Hopper(你不想)、要么装作懂(它不懂)。这是一个典型的”AI + 逆向”卡点:模型不擅长调系统级工具,系统级工具不擅长跟模型说话。
REA 的解法是给模型一个统一的、把十几种工具扁平化的接口层。模型调一个 analyze_javascript_application(path),REA 自己去识别这是 Electron、纯 JS bundle、还是 minified,然后选合适的引擎、把切片/反编译/参考线打包成 JSON 回来——每条都带 evidence(行号、源文件指针、引用的字符串),model 看完就能写。
但统一不是免费的。Hopper 是 macOS GUI 反编译器,跑在你 Python 线程里;Ghidra 是 Java 写的 headless analyzer,要起一整个 JVM;pwntools 是你 BYO 的 Python 库;mitmproxy 抓包文件是 tnetstring 格式——这五个东西写代码的人都不一样,数据结构、生命周期、错误模式全不一样。REA 要做的事,是让 agent 完全感受不到这些差异,而让 REA 内部的每一种差异都被显式建模。
下面这张图是 REA 自己画的”investigation flow”,我把它放在最前面,是因为它把”谁做什么”画得比 README 里的文字清晰十倍:
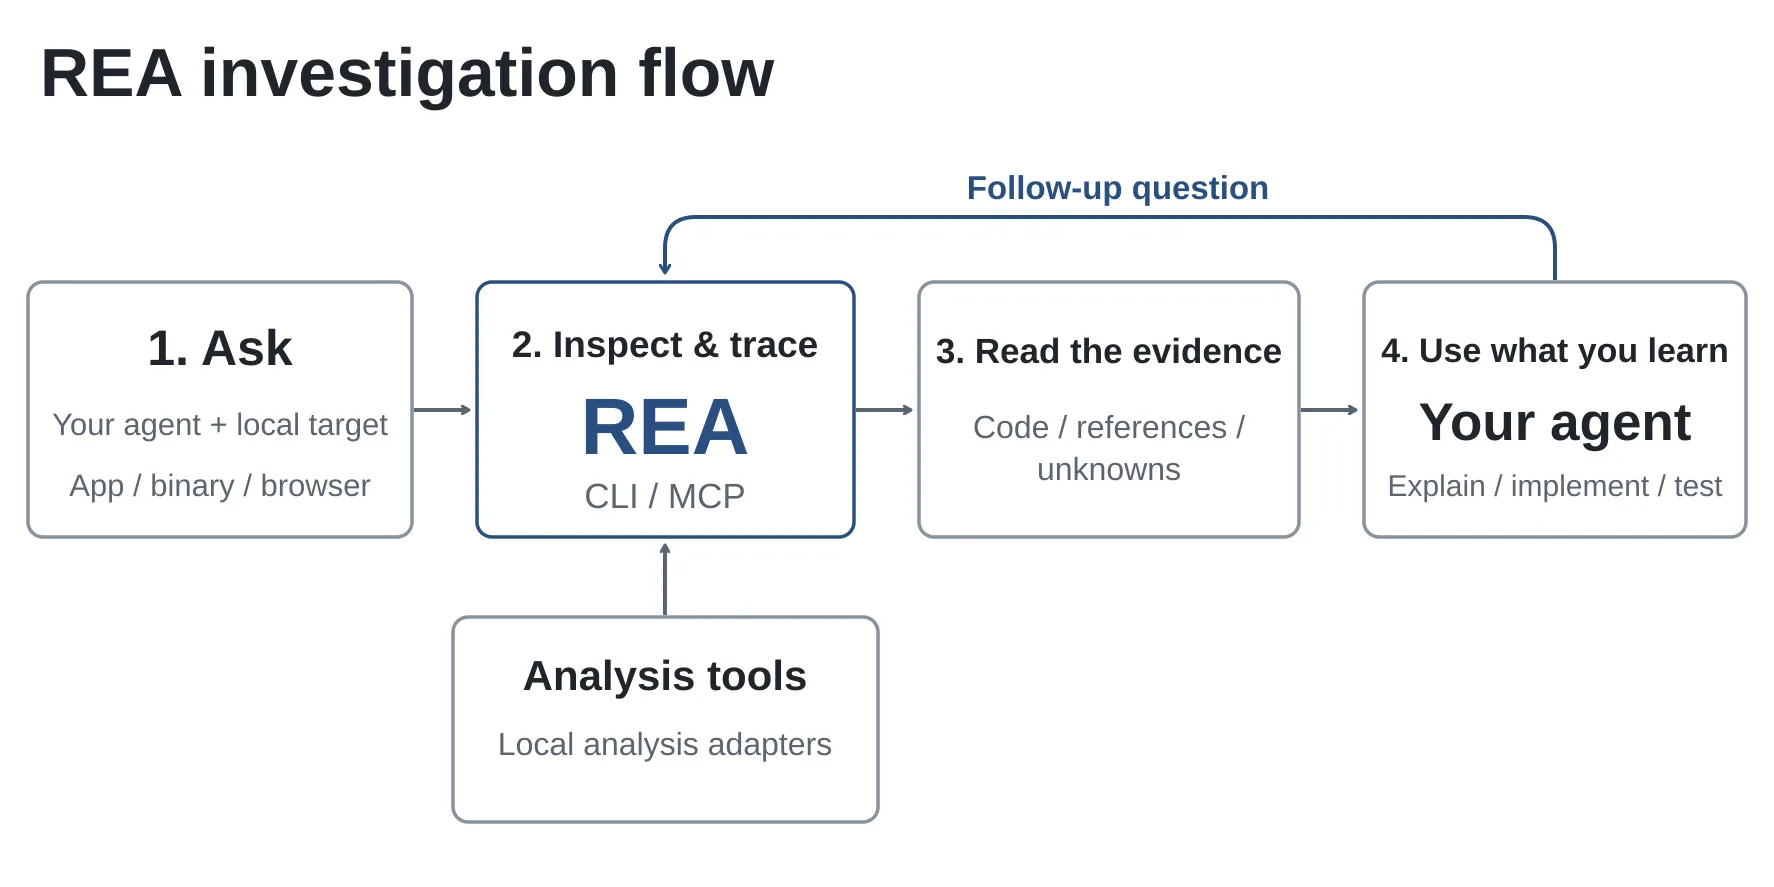
REA 网站的原图:agent 问一个本地目标 → REA 通过本地适配器检查/追踪 → 拿回 code / references / unknowns → 写解释 / 写实现 / 跑测试。
接下来,我要从 REA 自己的架构讲起,讲它怎么把”十几个外部工具的协议差异”压成”一份入口 + 一套共享 session”。
二、入口只有两个,但装配点只有一个#
REA 进程级的入口其实是三个文件,各管一摊:
src/main.ts— MCP stdio 适配器。长生命周期,起一次,跟 Claude Code 之类的 agent 一直对话到 EOF。src/cli.ts— 一次性 CLI 适配器。rea setup、rea analyze-javascript-application ... --json、各种rea doctor走这条。scripts/rea.mjs— argv 路由器。rea --mcp走 main,其它走 cli;还要负责在 Termux 上把PLAYWRIGHT_BROWSERS_PATH显式设对(因为 Playwright 默认不认识android平台)。
这三个文件看起来是三套独立入口,但实际只有一份装配。src/composition/ 下面每个 provider 一份 xxx.ts,提供 createXxxSession(config, logger, env) 这样的工厂函数,MCP 入口和 CLI 入口都调同一份。src/composition/binary.ts 是个典型:
export const createBinarySession = (config, logger, env): BinarySession => {
  const hopper = new HopperProvider(config, logger, env);
  const ghidra = new GhidraProvider(config, logger, env);
  const ida    = new IdaProvider(config, env);
  return composeBinarySession(
    new AnalysisProviderRegistry([hopper, ghidra, ida], config.analysisProvider),
    auxiliaryAnalysisProviderDeclarations(env)
      .map(d => new LazyAnalysisProvider(d)),
  );
};注释里就一句话:“The sole production wiring point, so both adapters share identical provider selection, profile, lifecycle, and Evidence semantics.”——这一行价值千金。
我画了一张比 mermaid 清晰一点的图,把这套共享关系画出来:
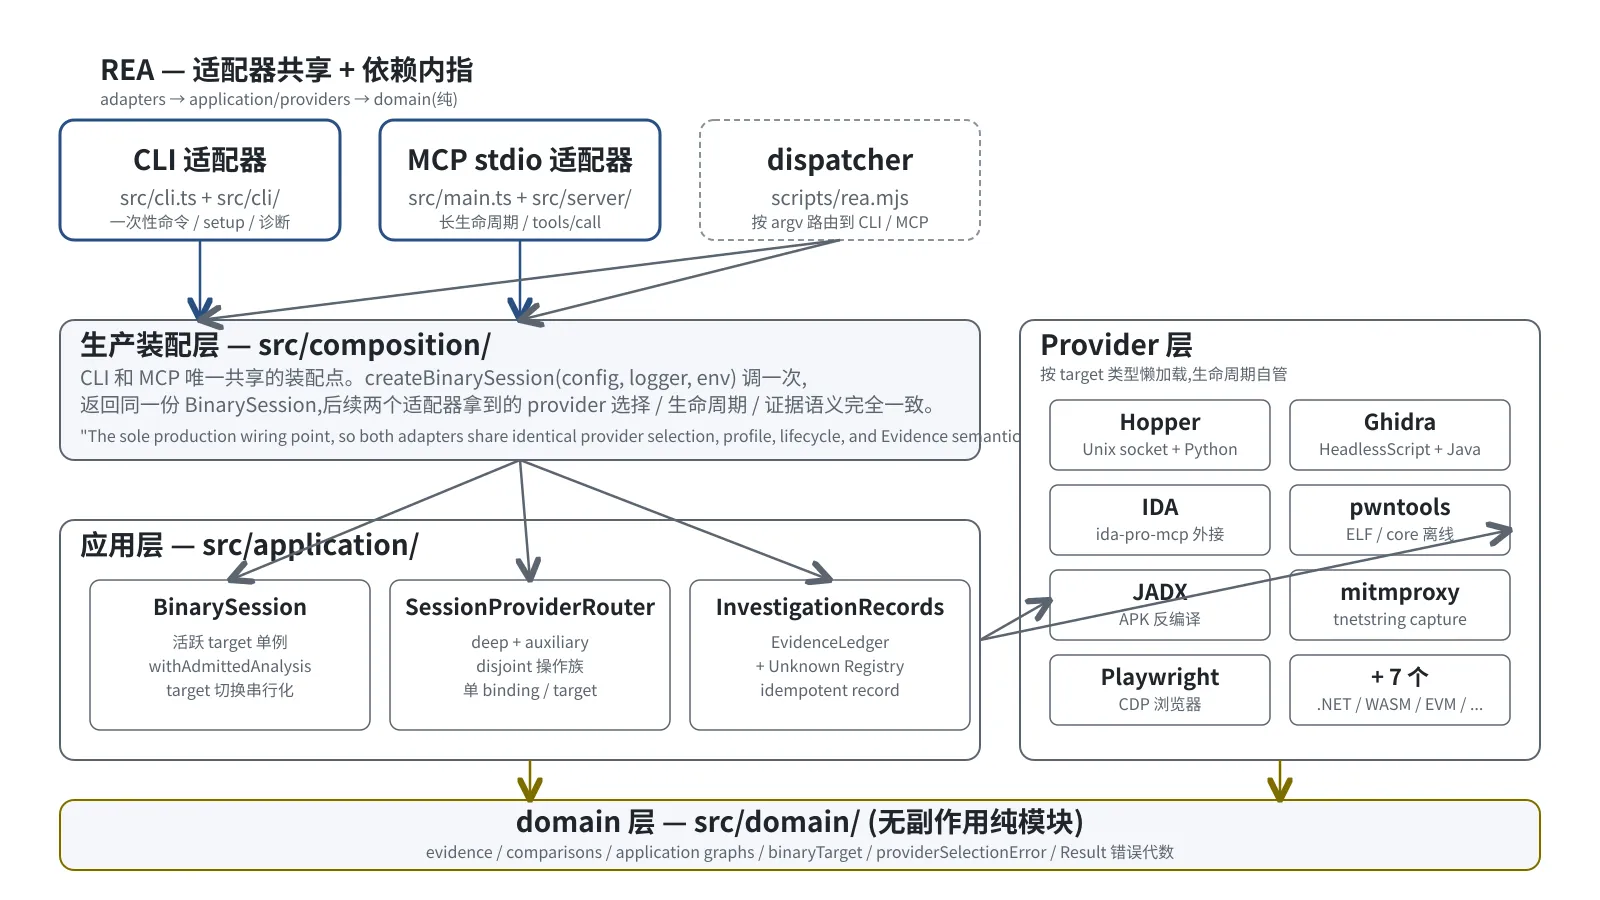
你会看到几个关键的”约束”被显式建模:
- 依赖只能向内。
domain/是无副作用纯模块,所有 provider / 适配器 / 应用层都可以引用它,但反过来不行。ProcessCapture/GhidraProvider/BrowserProvider这些外部世界,只能被application/和composition/调,不能反向指cli/。 - Composition 极薄。
src/composition/全部加起来 537 行,只做一件事——把 provider 构造好,塞进AnalysisProviderRegistry和LazyAnalysisProvider,组装出BinarySession。它不启动任何引擎,不读任何文件,只是把对象 new 出来。 - CLI 和 MCP 都从 Composition 拉同一份 session。MCP 入口在进程开始时拉一次,持有整个生命周期;CLI 入口每次命令拉一次,跑完销毁。但”provider 选谁”这件事的逻辑,只活在一个地方——
AnalysisProviderRegistry。
这种”一个装配点 + 多个适配器”的模式,在 Pi Agent Harness / litellm 里我都见过。REA 的特殊之处在于它不只是一份 runtime,还真的把这条规矩写进了 AGENTS.md:
“Dependencies flow inward: domain semantics and contracts, provider adapters, shared application workflows, then CLI/MCP adapters. Keep engine protocols and provider-specific code out of domain/application layers.”
换句话说,新加一个 provider,代码必须往 src/<provider>/ 塞,不能塞进 src/cli/、不能塞进 src/server/。这条规矩让 31 万行 TS 在 6.4 之前的 6.3 / 6.2 / 6.1 / 6.0 里都没崩。
三、Provider 怎么选——“没有 fallback”是一条核心规矩#
接下来我要讲 REA 最值钱的一个设计选择。
想象一下:用户说”分析这个 Mach-O”,而 Hopper 没装、Ghidra 装了。普通工具的写法是”try Hopper,失败就 Ghidra,再失败就报错”。REA 不这么干。它的 AnalysisProviderRegistry 在构造时就做四件事:
constructor(providers, defaultSelector = "auto") {
  // 1. 验证 id 格式 (zod schema)
  // 2. 拒绝重复 id
  // 3. 验证每个 capability 的 provider 元组 == identity
  // 4. 拒绝同一 operation 被声明两次
  ...
  this.#providers = Object.freeze(
    [...providers].sort((a, b) => compareUnicodeCodePoints(
      a.identity().id, b.identity().id,
    ))
  );
}把入参按 Unicode code point 排序、冻结、存进 Map。这一步的目的不是”选 Hopper 还是 Ghidra”,而是让注册顺序不影响选择。换句话说,谁先 new 谁后 new 都一样,MCP 启动拿到的排序和 CLI 启动拿到的排序也必然一样——这让”为什么选了 Hopper”这件事可解释、可复现。
selection 算法本身是确定性的(deterministic),不是”fallback”:
- 1 个 candidate 支持这个 target → 直接 binding。
- 多个 candidate + 用户显式指定
providerId→ 按 id 选。 - 多个 candidate +
auto→ 选第一个可用的(因为已经按 code point 排序了,所以是确定的)。 - 0 个 candidate → 直接抛
ProviderSelectionError,不兜底。
这一条”No fallback, no guessing”是 REA 6.x 系列明确写在 AGENTS.md 里的硬规矩,理由是:让错误早暴露,而不是悄悄降级。如果你的 Hopper license 过期了,REA 不会”自动切到 Ghidra”——它会告诉你”Hopper 不可用,可选的是 X 和 Y,要么装 Hopper 要么显式指定 G”-。
我画了这张图,把选择算法按步骤拆开:
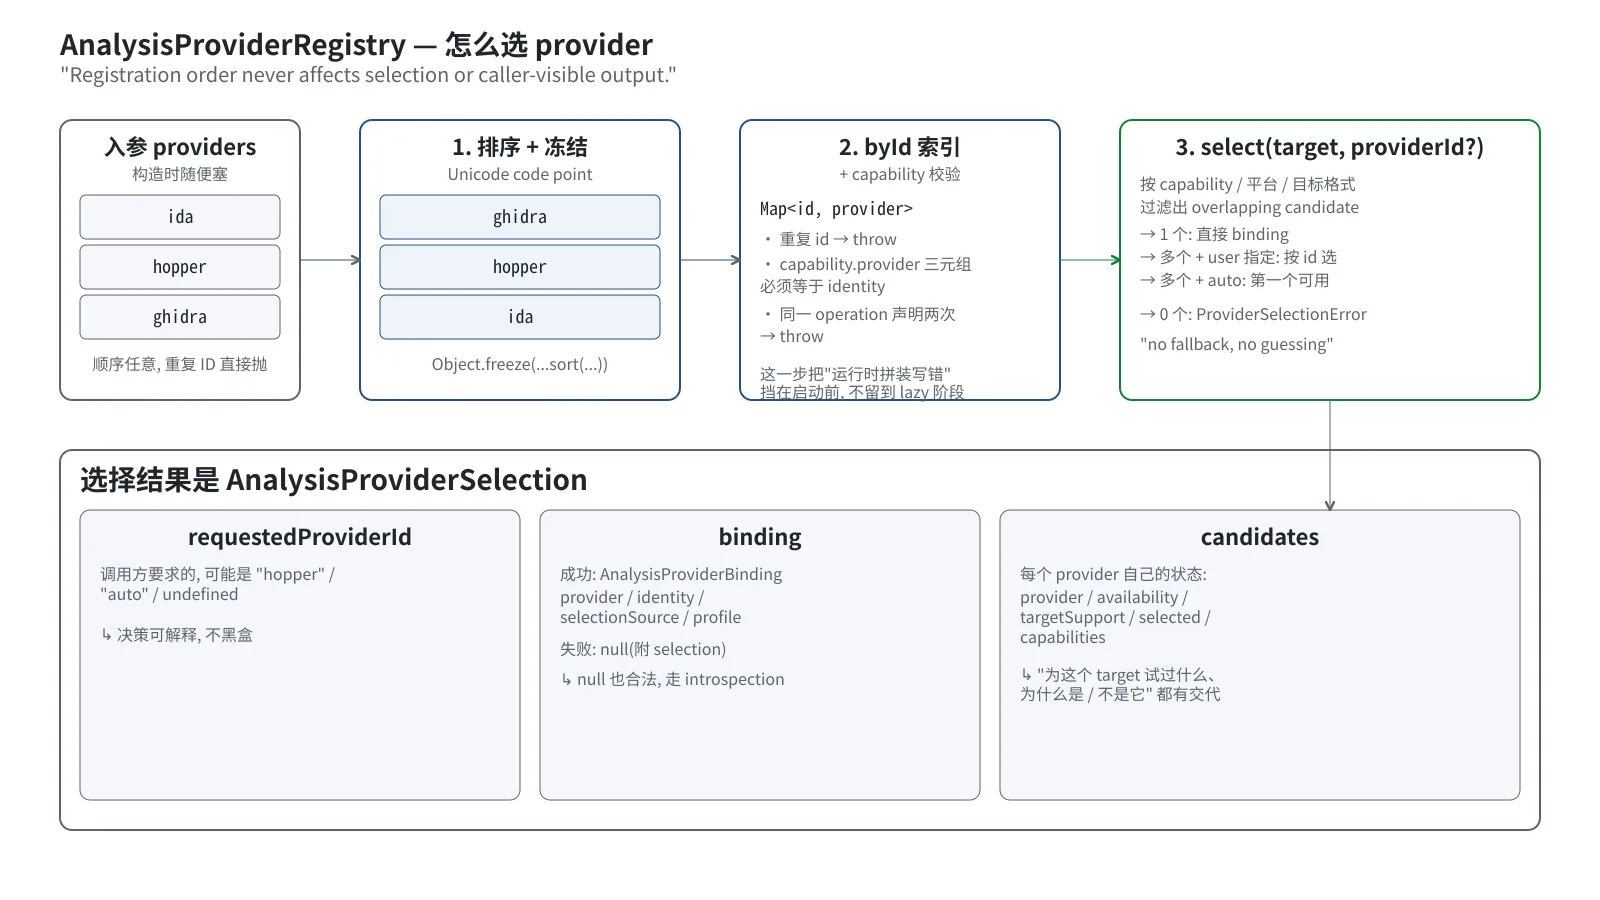
跟这条规矩配套的还有一件事:AnalysisProviderSelection 这个返回结构永远包含所有 candidate 的状态——每个 provider 的 availability、targetSupport、capabilities、是否被选中,都摆在台面上。失败的时候告诉你”试过什么、为什么没选它”,而不是一句”找不到 provider”。
SessionProviderRouter 在 registry 之上再叠一层:它把”deep provider”(Hopper / Ghidra / IDA,只能选一个)和”auxiliary provider”(WASM / EVM / .NET,可以并存)切开,跑断言保证两者的 operation 不重叠——也就是说,你不可能同时声明 Hopper 和 LazyAnalysisProvider 都能干 “decompile”,一旦声明重叠,启动时就抛。
这种”启动期就拒掉”的设计,在 Pi / litellm 也常见,但 REA 把它写得更狠:不是抛 warning,是抛 TypeError,进程根本起不来。这对 31 万行 TS 来说,是少有的几个”靠严格性换维护性”的选择。
四、三座桥,三种完全不同的进程边界#
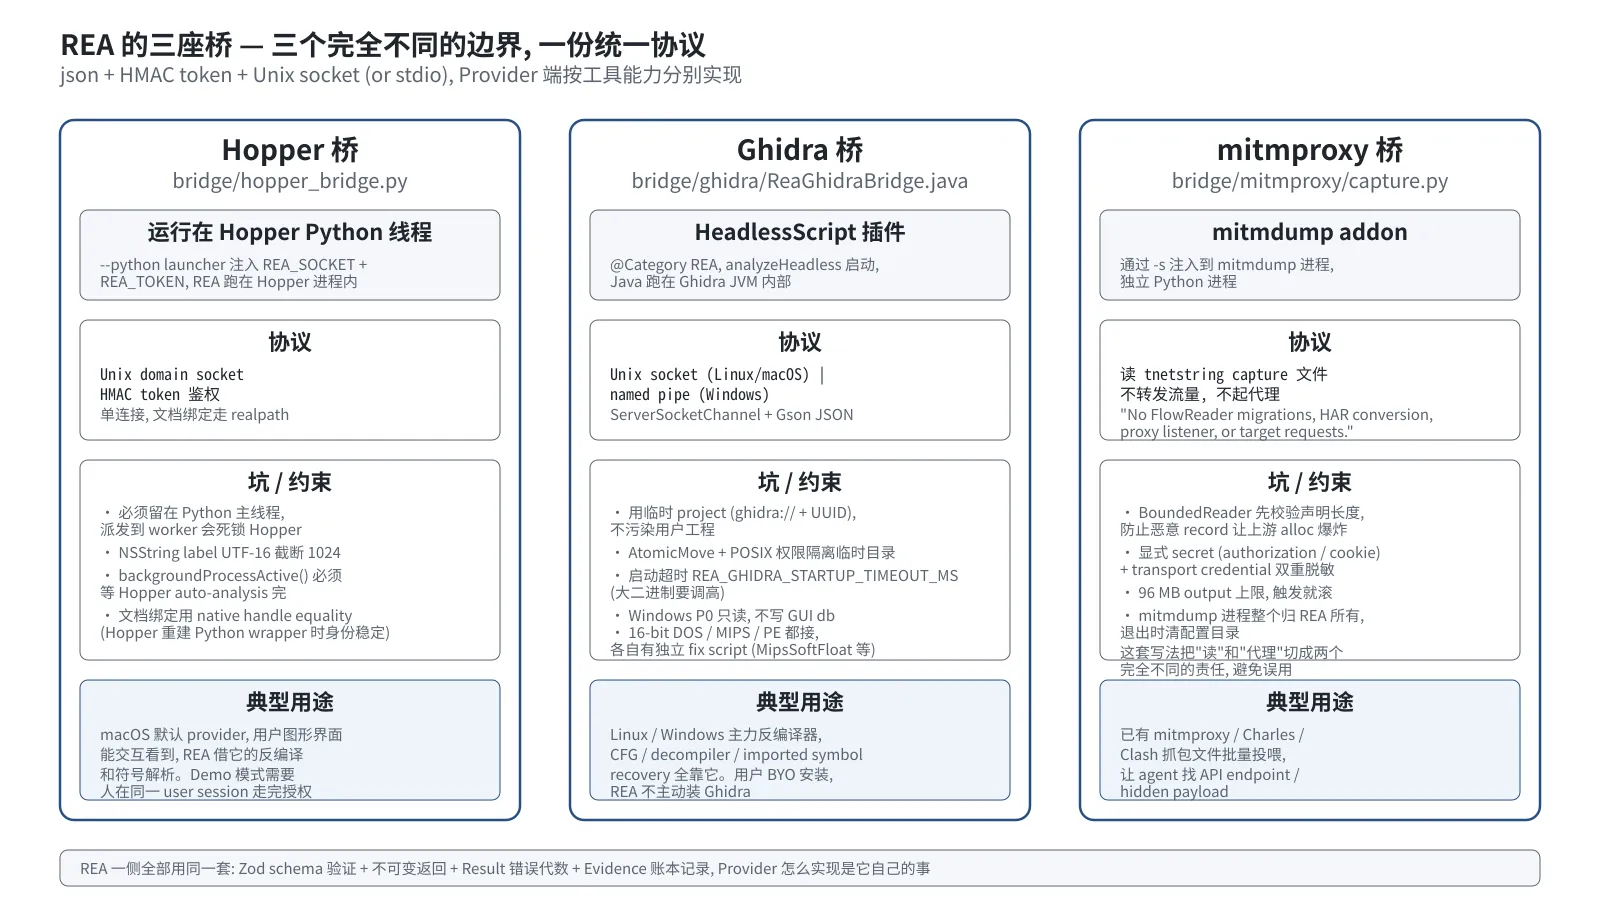
REA 里最让我花时间看的不是 TypeScript,是 bridge/ 目录——三座桥,三种完全不同的进程边界:
bridge/hopper_bridge.py— 跑在 Hopper 进程内的 Python 适配器。bridge/ghidra/ReaGhidraBridge.java— 跑在 Ghidra 进程内的 Java HeadlessScript 插件。bridge/mitmproxy/capture.py— 跑在 独立 mitmdump 进程里的 Python addon。
这三个东西如果让一个人写,他大概率会选一种”我熟悉的协议”(比如 stdio JSON)然后硬塞。REA 选了让每个 bridge 走它最自然的协议,然后在 TS 侧统一接。
我画了张三列对比图,把三座桥的边界、协议、坑、用途一次性摆出来:
挑三个我觉得写得最有”工程感”的细节:
Hopper 桥(bridge/hopper_bridge.py)有一条注释:“Keep all Hopper API access on this thread: moving dispatch to a worker can deadlock Hopper.”——这是个只有踩过坑才会写出来的警告。Hopper 的 Python API 必须在主线程调,因为它的 native handle 不是线程安全的,REA 把这件事写在了文件最顶端。另一处细节是文档绑定:_rea_session_document 用 native handle equality 而不是 Python 对象的 == 来比,因为 Hopper 会重建 Python wrapper,只有 native handle 是稳定的。
Ghidra 桥(ReaGhidraBridge.java)走 Unix domain socket(Linux/macOS)或 named pipe(Windows),ServerSocketChannel 加上 Gson 序列化。临时工程目录用 ghidra:// + UUID 起一个临时 project,从不污染用户工程;AtomicMove + POSIX 权限隔离避免别处读到临时文件;启动超时由 REA_GHIDRA_STARTUP_TIMEOUT_MS 控制,因为大二进制要起几分钟,默认值不够。Windows 上的 Ghidra P0 还是只读——这条规矩写进 AGENTS.md 是为了避免有人误用 Ghidra 写 GUI db 把用户的工程搞坏。
mitmproxy 桥(capture.py)的注释更直接:“No FlowReader migrations, HAR conversion, proxy listener, or target requests.”——它不是 mitmproxy 那个能代理流量的版本,它只读 mitmdump 抓的 tnetstring 文件,做离线分析。BoundedReader 在读之前先校验声明长度,防止恶意 record 让上游 alloc 爆炸;authorization / cookie / proxy-authorization 显式做 secret 脱敏,再加一遍 transport credential(URL 里的 user:pass@)脱敏,两道关;96 MB output 上限,触发就滚。这套写法的”工程感”在于:它不试图让 mitmproxy 当代理用,而是把”读”和”代理”切成两个完全不同的责任,避免误用。
三座桥的差异如此之大,但 REA 一侧全部用同一套收编:
- Zod schema 验证入参;
- 返回不可变值;
- 错误用
Result错误代数显式报,不用 try/catch 抛; - 每条 evidence 写进 InvestigationRecords 账本,跨调用可查。
也就是说,Provider 怎么实现是它自己的事,Provider 之外的契约是统一的。这跟”plugin architecture”的常见错误(把协议差异塞进接口)刚好相反。
五、JS 数据流追踪,跟普通”AI 读代码”最不一样的地方#
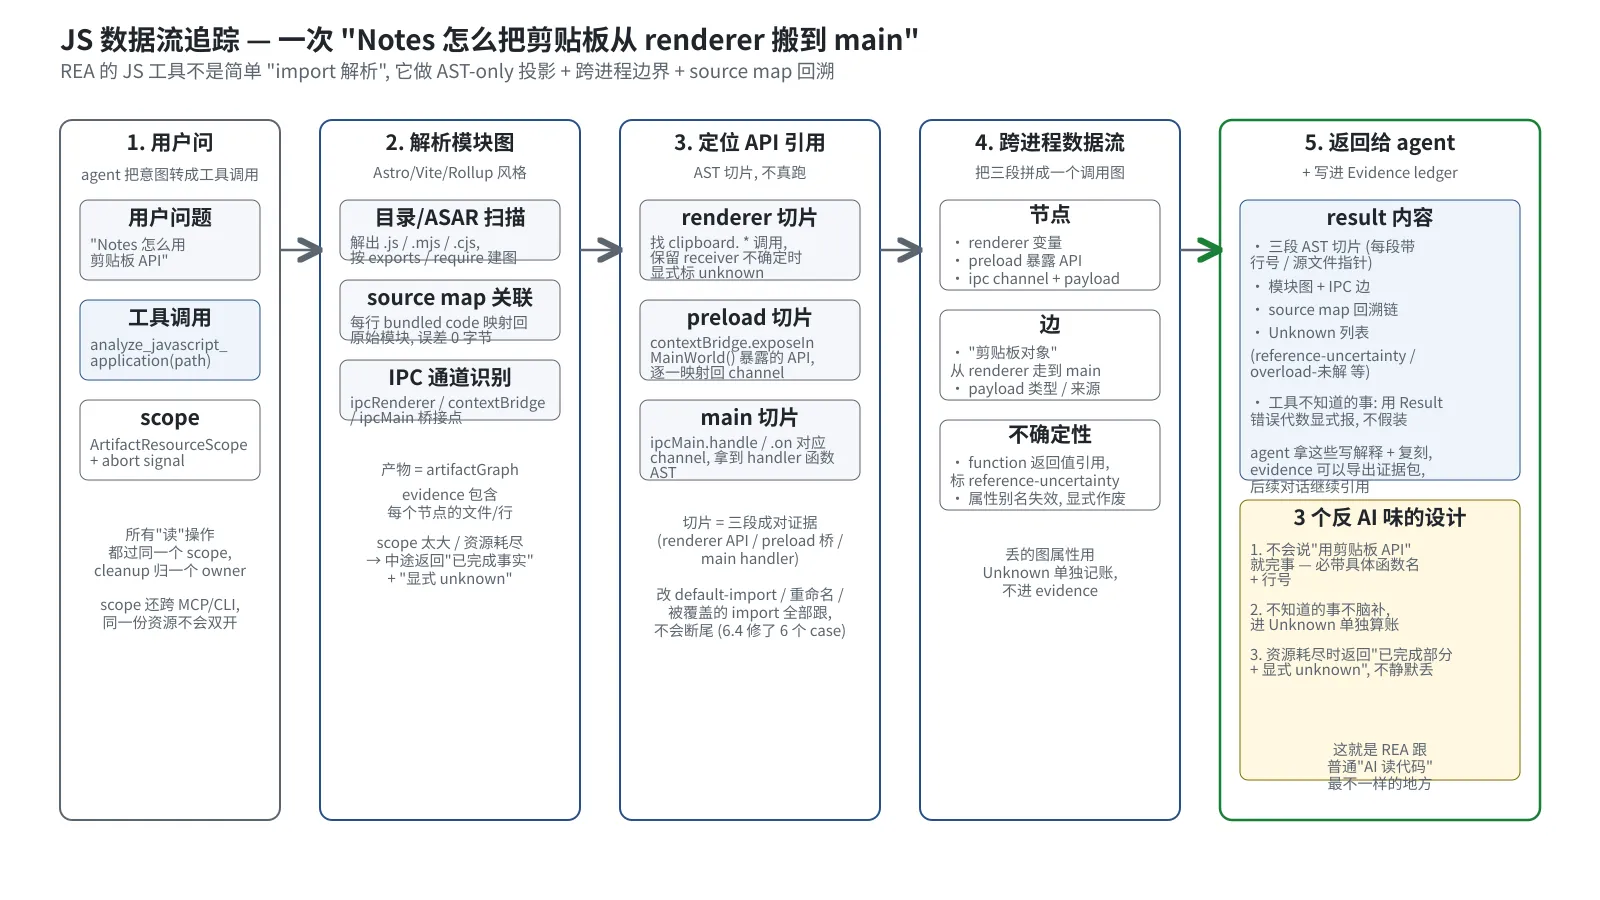
REA 最有用的工具其实是 JavaScript 那套。我从 README 的”Showcases”里拿一个真实的 case——Notion 怎么把剪贴板从 renderer 搬到 main ↗——然后顺着 REA 的工具链追一遍,看它跟”普通 AI 读代码”到底不一样在哪。
第一步,用户说”Notes 怎么用剪贴板 API”,agent 把这个意图转成工具调用 analyze_javascript_application(path)。REA 拿到后,先做”模块图构建”:
- 扫目录/ASAR,识别
.js/.mjs/.cjs; - 按
exports和require关系建图; - 关联 source map,每行 bundled code 都映射回原始模块;
- 识别 IPC 通道:
ipcRenderer/contextBridge/ipcMain的桥接点。
这一步的产物是 artifactGraph,每条边都有文件指针和行号,evidence 自带。
第二步,做 AST-only 切片(关键:不真跑 Electron 进程):
- renderer 切片:找
clipboard.*调用,保留 receiver 的不确定性; - preload 切片:在
contextBridge.exposeInMainWorld()暴露的 API 上一一映射回 channel; - main 切片:在
ipcMain.handle/ipcMain.on对应的 channel 上拿到 handler 函数 AST。
这步的产物是”三段成对证据”——renderer 的 API 引用、preload 的桥接、main 的 handler,三段必须成对才报,任何一段缺失都进 Unknown。
第三步,把三段拼成一个跨进程数据流图:节点是 renderer 变量 / preload 暴露的 API / ipc channel 和 payload;边是数据从 renderer 走到 main 的传递链,带 payload 类型和来源。
我把这次调查画成一张流程图,看 REA 在每一步具体在做什么:
这一套跟普通”AI 读代码”的区别在哪?三个点:
1. 不会说”它用了剪贴板 API”就完事。REA 一定带具体函数名(比如 clipboard.readImage / webContents.startDrag)、行号、源文件指针。模型可以拿这些去写复刻或者解释,而不是泛泛地说”它用了 web API”。
2. 不知道的事不脑补。比如 function returns 的引用,REA 会标 reference-uncertainty;属性别名失效就显式作废;源里的 import 被覆盖就记一条 Unknown。普通 AI 模型读到这里大概率自己脑补出一个值,但 REA 不——它把”不知道”显式建模,跟 evidence 分开。
3. 资源耗尽时不静默丢。JS 分析很重,大 bundle 可能 OOM。REA 6.4 之前,这是用户痛点。6.4 改成了”返回已完成部分 + 显式 unknown”,agent 拿到这份结果能继续工作,而不是拿到一份”看起来正常”但实际少了一半的 JSON。
第三点尤其值得展开。REA 把 JS 分析整个放在独立 Node 进程里跑(javascriptAnalysisWorkerProcess),可配置 heap 和 timeout 限制;一旦到了资源上限,主进程拿到的是”部分结果 + unknown 列表”,不是崩了或者超时。普通 AI 读代码工具通常在主进程里跑 AST,要么成功要么 OOM,没有”部分成功”这个选项。
六、Showcase:TH04 的 16-bit DOS bullet ring 复刻#
REA 的 Showcase 页面 ↗有 3 个完整 case,我推荐你看 TH04(东方 Project 第 4 作)那一个——它把 6.4.0 里 Ghidra 那个”16-bit DOS”的支持写成了一个数学公式。
TH04 是个 PC-98 上的老游戏,主角发射 16 颗子弹,呈环形散开。原文实现里 bullet 的角度是 hardcode 的,但反向工程的目的是把”位置-角度”的数学公式提取出来。REA 用 Ghidra 16-bit DOS 支持把这段 16-bit 汇编读出来,然后用 SVG 把”16 颗子弹、固定 0 模板旋转、玩家方向 40 度、顺时针屏幕坐标”画成一张图:
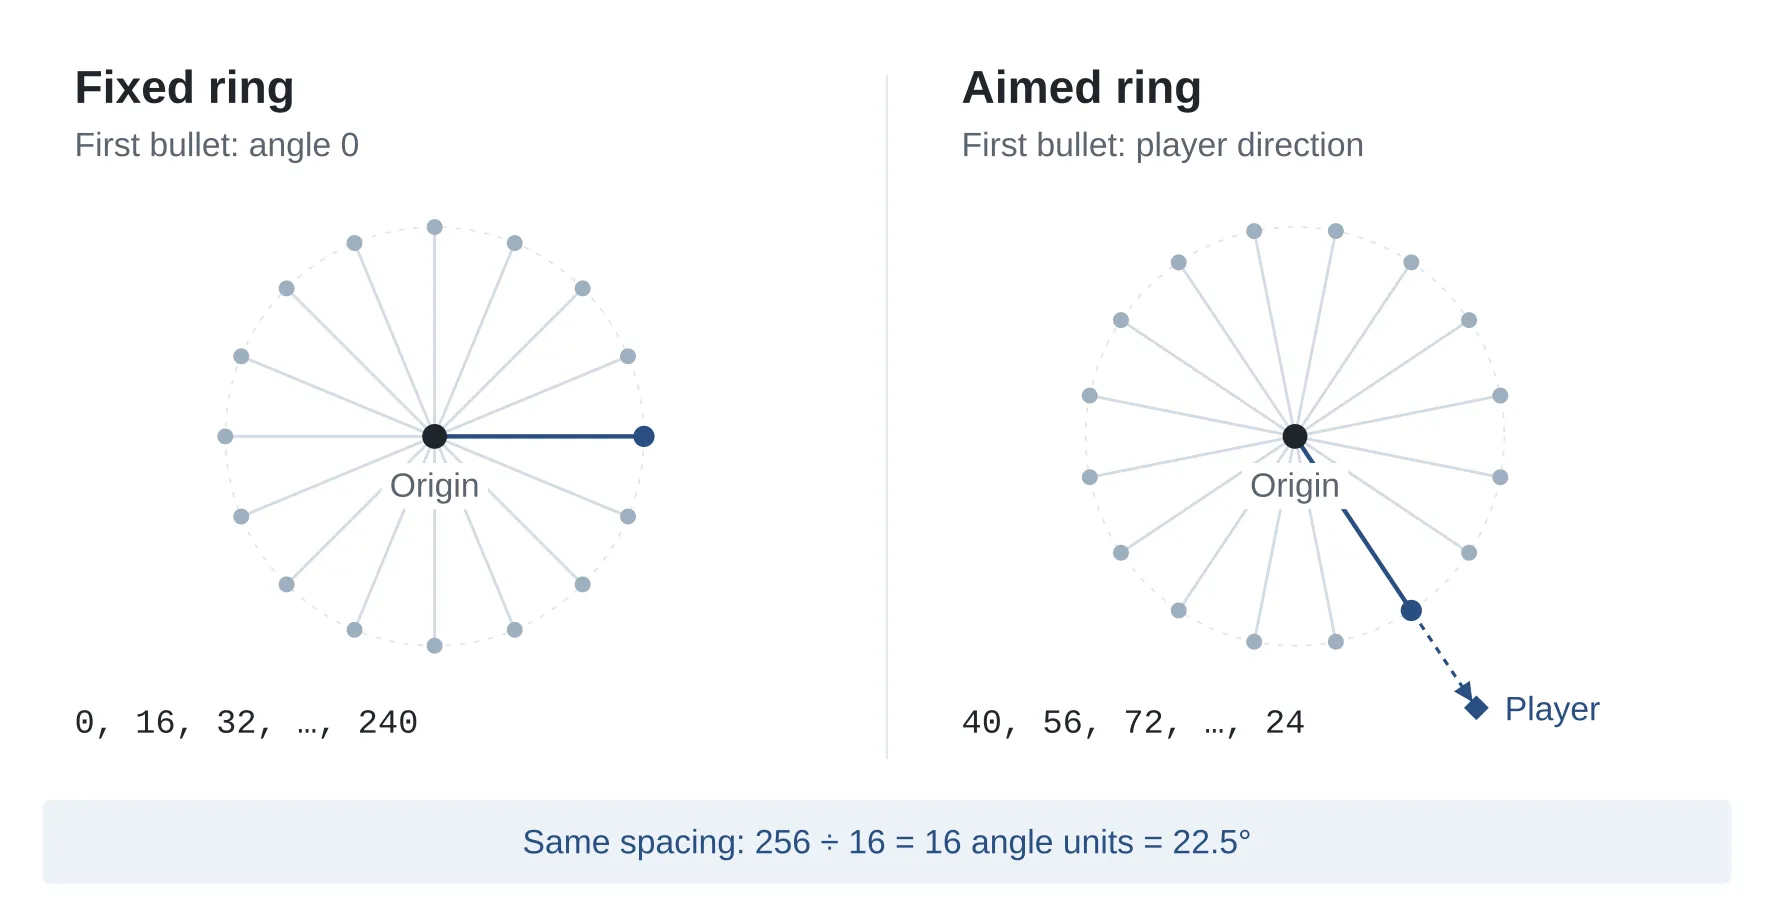
这张图不是 AI 生成的,不是游戏截图,是 REA 从汇编里读出公式,直接用 SVG 画出来的数学图——它说”这是计算结果,不是游戏画面”。
完整 case 里的另一个——DX-Ball 声相定位 ↗——更狠:REA 追到一个声音调用的 position-to-pan helper,把不完整的伪代码翻成 C,3,205 个原 x86 测试用例全部通过,复刻了原函数 63 个编译字节。这个不是读代码,是真正复刻了一个二进制函数。
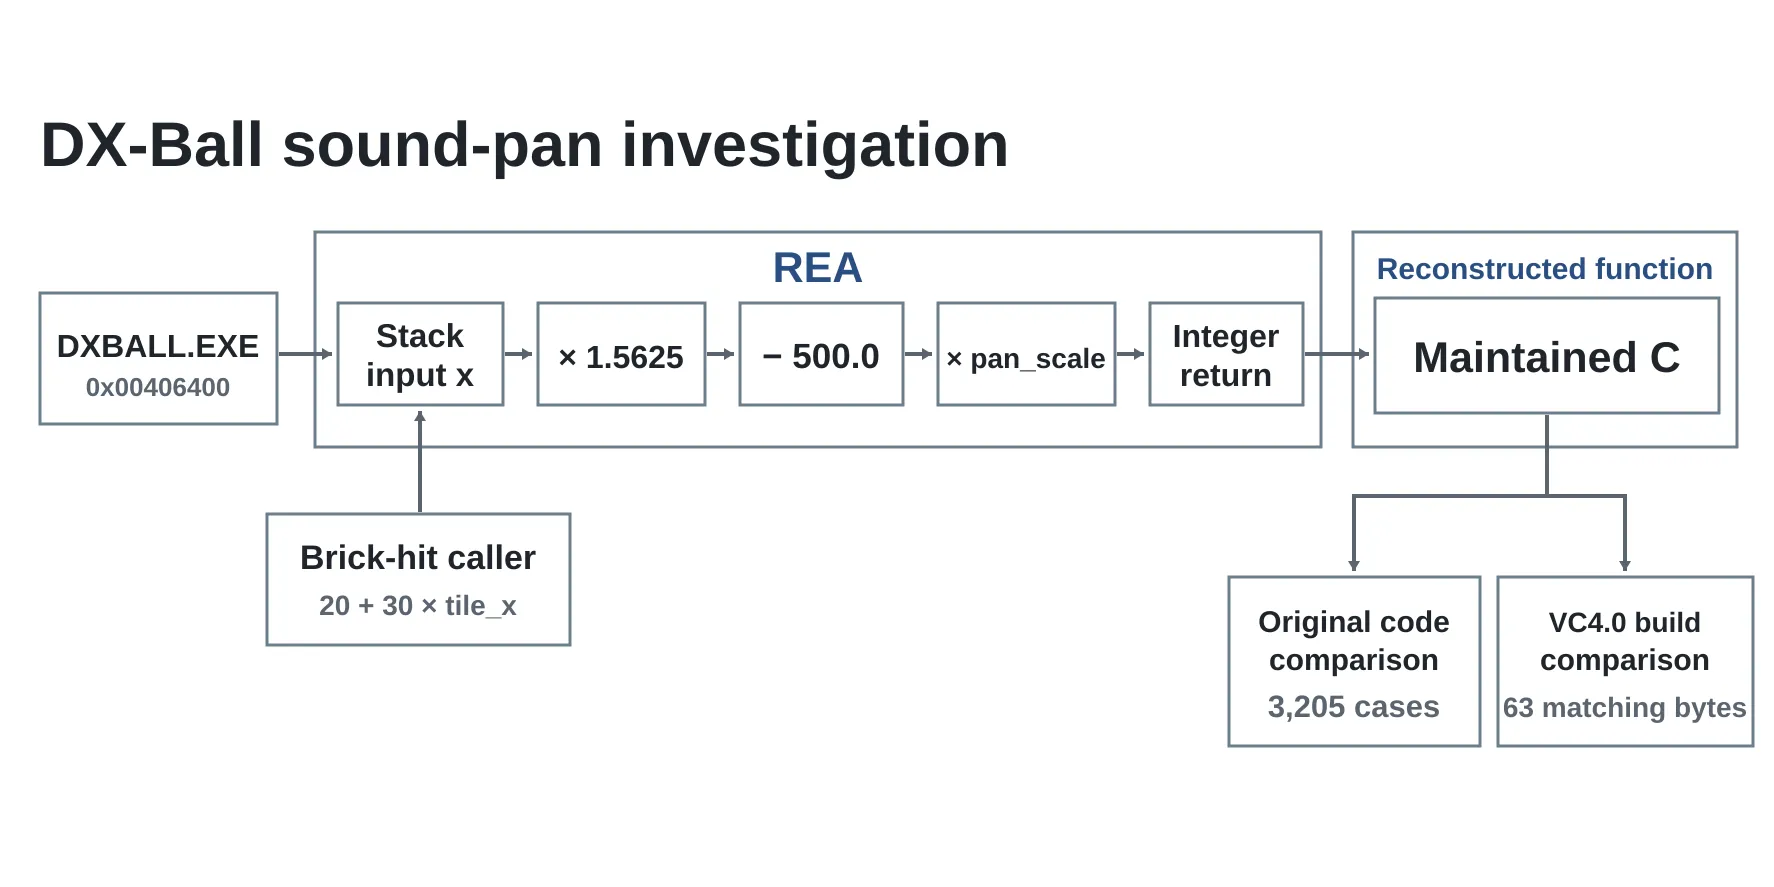
REA 的 showcase 页面把这三个 case 摆在一起:
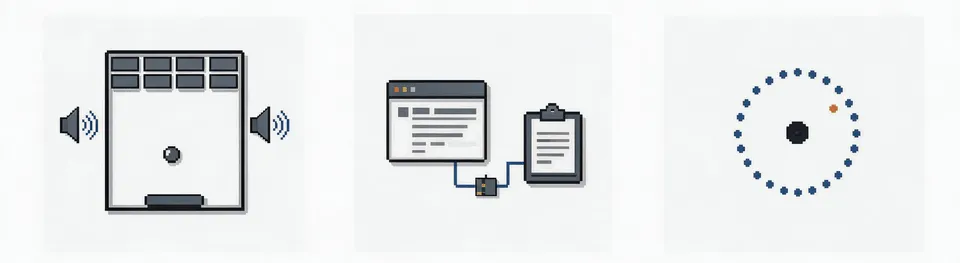
这三个 case 的共同点是:不是给 agent 看的演示,是给逆向工程师看的工件。每个都带 evidence、限制、跟原版的对比。这跟”AI 帮你读代码”的工具演示完全不是一个层级。
七、几个反 AI 味的设计#
写到这,我把 REA 里特别不像 AI 工具的几个设计挑出来,这些是我接下来想在别的地方抄的:
1. Evidence + Unknown 双账本。REA 不只记录”查到了什么”,还单独记”查不到什么”。后者在 UnknownRegistry 里,跟前者的 EvidenceLedger 分开。普通 AI 工具失败时返回 null / [] / 错误字符串,REA 失败时返回”已完成事实 + 显式 unknown”。这两件事不能合并,合并了就丢失”是不是真的不知道”这个信息。
2. Result 错误代数。src/domain/result.ts 自己实现了一个 Result<T, E>,而不是用 throw。所有 provider 返回值都是 Result,成功带数据、失败带 typed error。错误从 provider 一路传到 MCP / CLI,中间不丢类型信息,agent 拿到的错误是结构化的,不是字符串。这跟 litellm / Pi 的错误处理走的是同一条路,REA 多做的是把 error 也带 evidence(比如”Hopper auto-analysis 还没跑完”这种特定错误)。
3. 资源 scope 统一。6.4.0 引入的 ArtifactResourceScope 把”读一个文件”的所有权从入口一直传到最深的 helper,任何子任务拿不到 scope 就根本不知道从哪读。这解决了”哪个 reader 负责 cleanup”这个老问题——以前 REA 6.3 之前的版本,这种 cleanup 责任是约定俗成的,现在强制归一个 owner,跟 litellm 的 CallOptions { cache, observers } 是同一思路,但应用在文件 IO 上。
4. Setup 加 backup。rea setup 会先备份你 agent 的现有配置再改,改完告诉你哪几个文件变了。AGENTS.md 里写:“Configuration changes must be additive and idempotent, with backups.”这是真的写在文档里的硬规矩,不是事后补的免责。
5. 不假设 caller 授权。setup 会显示 planned changes,要求你 approve 才写文件。AGENTS.md 里”installers must not install or upgrade unrelated software”这条直接禁止 REA 帮你顺手装 Homebrew / Node / Java——这跟某些 AI 工具”一键安装全部”完全相反。
6. 跨版本兼容但不神秘化。6.4 改 schema 的时候,从不偷偷加 alias;老的 evidence 拿到新版本如果不再 valid,会显式拒绝,而不是悄悄丢掉。Saved reference graphs: exclusions require their matching pattern and distinguish project-ignored from default-ignored. Re-import graphs missing that provenance. —— 这种写法在 AI 工具里极其罕见。
这些设计加在一起,让 REA 看起来不像”AI 帮你逆向”,更像”一个写得很克制的工程师帮你逆向,只是他的键盘后面有个 model”。
八、没解决的问题,跟有界的地方#
REA 不是万能的。读完它的 53 篇 docs 和 6.4 changelog,我觉得有几个没解决或者主动放弃的边界:
1. Windows Ghidra P0 是只读的。Ghidra Windows 路径上 REA 不能写 GUI db,不能帮你 set_address_name。这不是”我们没做”,是 AGENTS.md 明确写的硬约束:“Windows Ghidra P0 has no mutation authority.”——它宁可少功能,也不冒把用户工程搞坏的风险。
2. Hopper 是 macOS only。Linux / Windows 上 Hopper 跑不起来,REA 自动选 Ghidra / IDA。但这意味着如果你的目标只在 Hopper 上能看(比如某些 macOS private framework),Linux 上你只能换 Ghidra。
3. JavaScript 分析仍然可能 OOM。6.4 加了独立进程 + 资源限制 + 部分结果,但 bundle 太大、或者循环引用太深的时候,REA 仍然会只返回部分。这是它主动选择的:与其 OOM 崩,不如告诉 agent “我看到了 X、Y,没看到 Z”。
4. 很多 provider 要求 BYO。Ghidra / IDA / Hopper / JADX / pwntools / binwalk / unblob / pwndbg,REA 一个都不主动装。rea setup 顶多帮你装 Hopper(Demo 模式需人授权),其它都要你自己装。理由同样写进 AGENTS.md:“Installers must not install or upgrade unrelated software.”
5. 跨 scaffold 不掉点是问题。REA 的 evaluation 框架(src/evaluation/)能拿 agent 跑 case study,但它不评估自己——意思是,RE 帮你写完代码,这个代码在 Claude Code / Cursor / Codex 上的表现差异,REA 不管。它只保证”自己这边结果是 consistent 的”。
最后一个没解决:IDA 的桥接。IdaProvider 用的是 ida-pro-mcp 这个外部服务,REA 自己是消费者,不是 owner。这意味着如果你用的 IDA 版本和 ida-pro-mcp 不兼容,REA 帮不了你,要去上游 issue 报。这一点跟 Hopper / Ghidra / mitmproxy 都不一样——后三个都是 REA 维护的。
九、抄什么,不抄什么#
如果让我从 REA 抄几个东西到别的地方,我会这么选:
会抄的:
- “Composition 装配点唯一,CLI 和 MCP 共用” — 这是 31 万行能维护住的根本。
- “Provider 注册时排序,无 fallback” — 让”为什么选了 X”可解释,这是大多数工具做错的。
- “Evidence + Unknown 双账本” — 普通 AI 工具的致命问题就是”不知道的事装作知道”。
- “Result 错误代数 + Error Projection” — 别用 try/catch 抛,typed error 一路传到 UI。
- “Setup 先 backup,要求 approve 才改文件” — 写在文档里不够,要写进 AGENTS.md。
- “Bridge 不假设协议统一,让每个 provider 走它最自然的协议” — Hopper Python in-process / Ghidra Java headless / mitmproxy stdio 都各走各的,只在 REA 侧统一。
不抄的:
- 1,527 个 TS 文件 / 31 万行这个规模本身 — 绝大多数项目用不到。
windows-ghidra-p0这种强工程取舍 — 普通工具不需要 P0 只读。- “BYO 全部逆向工具” — REA 的做法是用户都得自己装 Hopper / Ghidra / IDA,这对个人开发者友好,对企业部署不友好。
写在最后:REA 6.4 在我看来不是一个”AI 工具”,而是一个把 13 种逆向工具讲成同一套接口的工程债清理器。它真正的价值不是”让 agent 更聪明”,而是”让模型在调用逆向工具的时候,能拿回它能信的 evidence”。
如果你想跑起来,一行命令:
npx rea-agents setup它会帮你注册 MCP + 装 skill + 选 provider。Hopper 需要 macOS,Ghidra / IDA / JADX 自己装——这些它不做,但它会告诉你需要什么。
一些数字:写这篇的时候我对照了
architecture.mermaid(整张图都在那)、docs/cli.md、docs/mcp-contracts.md、docs/tool-design.md、docs/installation.md、CHANGELOG.md,以及src/main.ts/src/cli.ts/src/composition/binary.ts/src/application/binary/{BinarySession,AnalysisProviderRegistry,SessionProviderRouter,BinarySessionComposition}.ts/src/server/{createServer,EvidenceMcpServer,analysisAdmission}.ts/src/application/investigation/InvestigationRecords.ts/bridge/{hopper_bridge.py,ghidra/ReaGhidraBridge.java,mitmproxy/capture.py}的关键入口。项目目录已经从本地删除,如果你想看完整代码,直接去 github.com/morluto/rea ↗ 拉。