深入解析 Sentry:一个错误监控平台怎么把事件从 SDK 送到 PG 与 ClickHouse
💬 评论283M / 8194 py 的 sentry 主干分支,事件 ingest 链路 5 段泳道 + Hybrid Cloud 双 silo + outbox + Taskbroker,看 sentry 怎么把 24.x 之后的数据驻地改造做实。
Sentry 是个值得拆的大仓——代码量摆在那儿(283M / 8194 py / 25.x 主分支),但更重要的是它的”分层”:每一层都只做一件事,边界划得很清楚。
这篇笔记只挑最有学习价值的 4 块:事件 ingest 链路、Hybrid Cloud 双 silo、Outbox 同步、Taskbroker 替代 Celery。其它(告警、symbolicator、profile、replay)按下不表,真要全讲得写一本书。
一、为什么拆 sentry#
最早想读 sentry 是因为好奇”错误监控平台”是怎么把海量事件处理落到 OLAP + OLTP 两套存储里的——光看 SDK 不够,得看 SDK 把事件交给谁、谁把事件存哪儿、怎么保证不丢、怎么保证不重复。
读完才发现 sentry 26.x 这套架构的核心改造不是 ingest,而是 Hybrid Cloud 数据驻地:
Control Silo 单实例写全局账号 / 订阅 / Webhook · Region Silo 多实例写项目分区数据 · 两边各放 Outbox 表 · 用 Kafka 双向同步 · 异步任务走 Taskbroker
这是 sentry 24.x 之后从 monolith 切到 SaaS 形态的关键决策。如果你只看老博客里的 monolith 描述,会以为 sentry 还是个 Django monolith——其实内部已经被切两半了。
二、事件 ingest 链路(5 段泳道)#
先看图,把全貌过一遍:
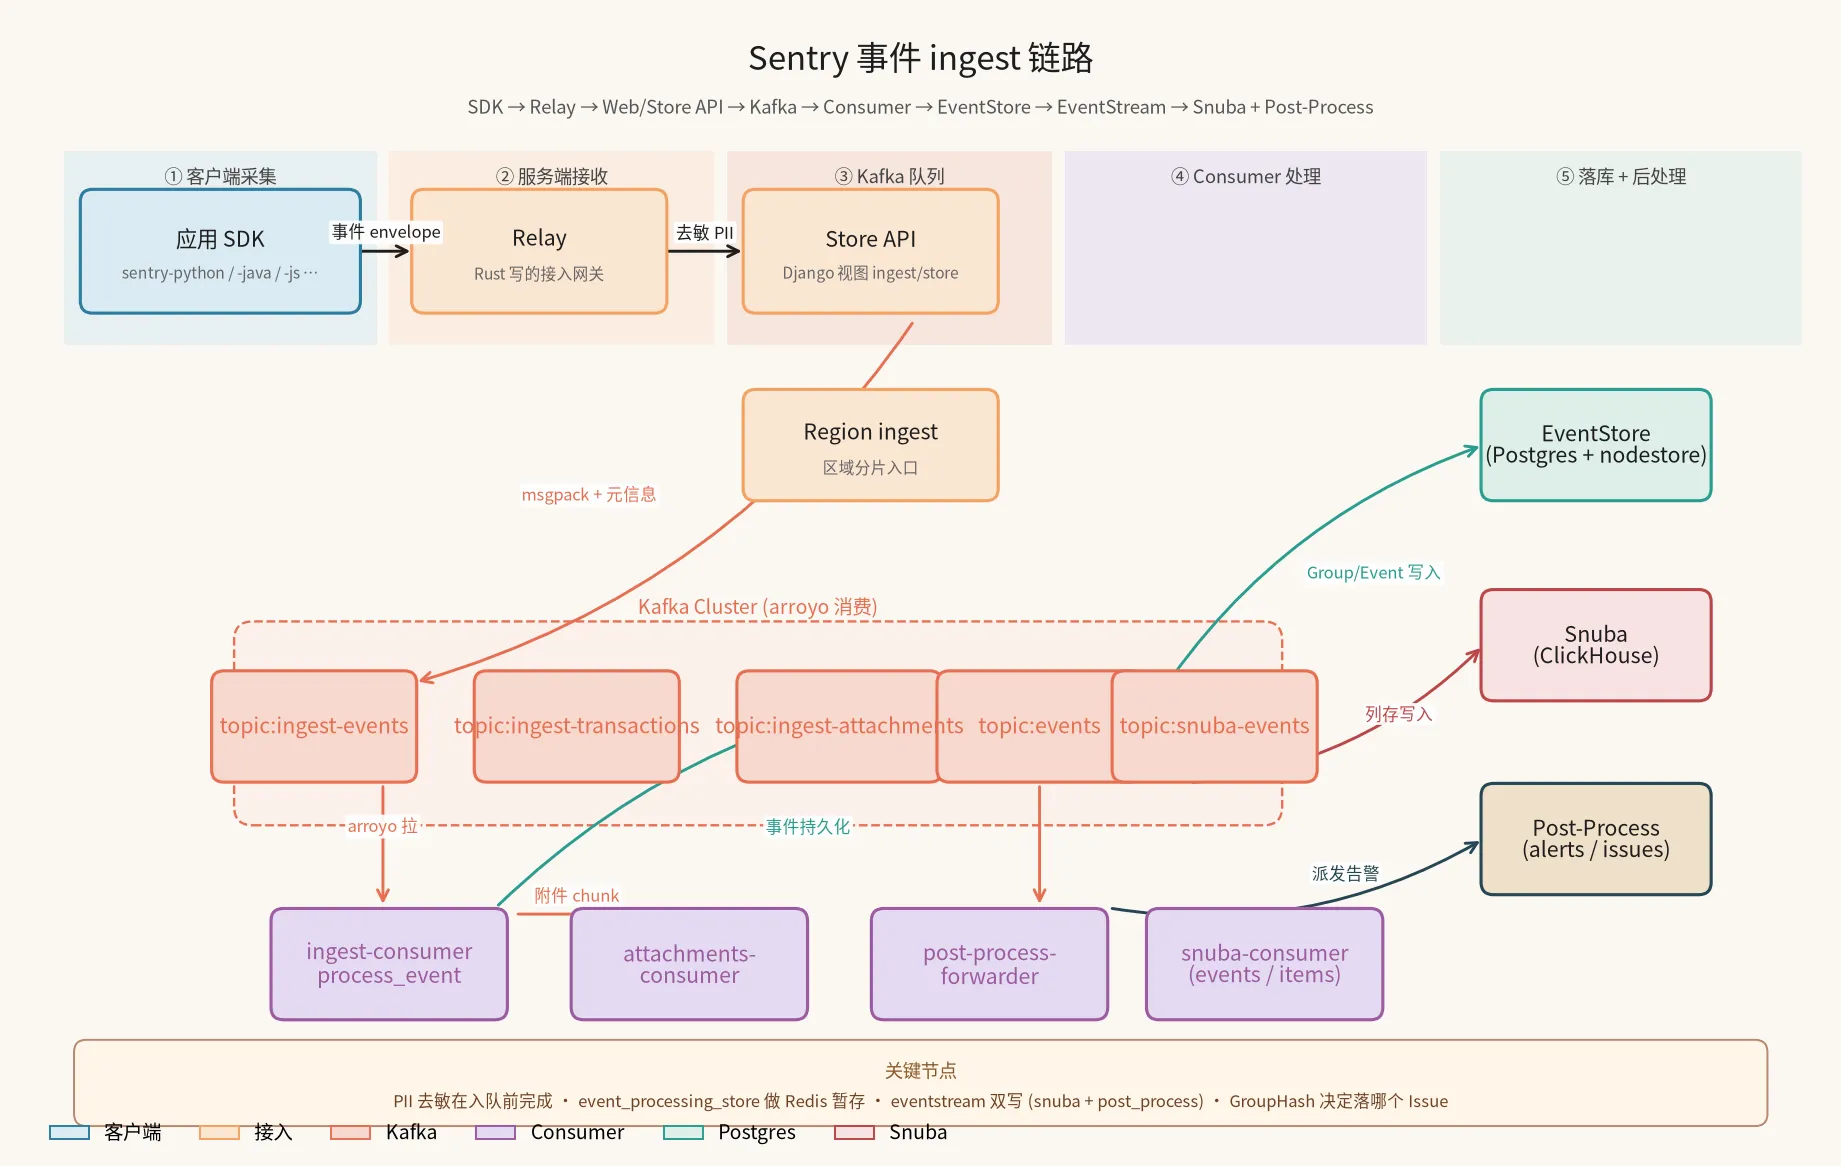
这图把 sentry 一个事件从 SDK 到落库走过的 5 段泳道全画出来了:客户端采集 → 服务端接收 → Kafka 队列 → Consumer 处理 → 落库 + 后处理。下面一段一段说。
1. SDK → Relay → Store API#
SDK 采集到事件后先打 envelope 推到 Relay(sentry 自己用 Rust 写的接入网关,不是 Django)。Relay 做 4 件事:
- PII 去敏:从 project option
sentry:relay_pii_config和 organization option 合并配置(relay/datascrubbing.py的get_pii_config),用 Rust 的pii_strip_event把 password / token / IP / 信用卡字段全替换成占位符; - 采样决策:基于
dynamic_sampling规则决定接不接、要不要客户端采样,目的是给 SaaS 客户控量; - 事件裁剪:超长 stacktrace / breadcrumb 直接砍;
- 批量打包:多个事件打成一个 msgpack 发往 Store API。
到 Store API(Django 视图 ingest/store)已经是干净的事件了。Store API 的核心动作很简单:把 envelope 拆开,错误事件送 topic:ingest-events、事务事件送 topic:ingest-transactions、附件送 topic:ingest-attachments,全部走 msgpack + 元信息格式 (IngestMessage = Mapping[str, Any])。
为啥不直接消费、要先入 Kafka?——一句话:让 PII 去敏尽早完成,事件一旦入队列就是干净的。这样下游所有 consumer(15+ 个,各自服务不同的事)都不用再担心泄露。
2. ingest-consumer → event_processing_store → preprocess_event#
process_event(在 ingest/consumer/processors.py 里)是 ingest 链路的核心:
# 去重 + killswitch + JSON 解析 + Redis 暂存 + 派发
def process_event(consumer_type, message, project, ...):
    payload = message["payload"]
    # 1) memcached 去重(TTL 1 小时)
    if cache.get(f"ev:{project_id}:{event_id}"):
        return  # 已处理过
    # 2) Killswitch(双保险:解析前 + 解析后各一次)
    if killswitch_matches_context("store.load-shed-pipeline-projects", ...):
        return
    # 3) JSON 解析
    data = orjson.loads(payload)
    # 4) Redis 暂存(给下游 async worker 读)
    cache_key = processing_store.store(data)
    # 5) 按事件类型派发:transaction 直接 save_event_transaction.delay;
    #    error 走 preprocess_event; feedback 直接 save_event_feedback
    # 6) 写 dedup_key(1 小时 TTL)
cache.set(deduplication_key, "", CACHE_TIMEOUT)注意三个有意思的细节:
- 去重靠 memcached,TTL 1 小时——源码注释里作者直接吐槽”this code has been ripped from the old python store endpoint … extremely broken”。它不保证严格去重,只保证”good error message for one hour”。这是 sentry 的真实工程取舍:严格去重的成本太高,做”轻去重+幂等消费者”就够了。
- 两次 Killswitch:第一次在 JSON 解析前查(
store.load-shed-pipeline-projects),第二次在解析后查(store.load-shed-parsed-pipeline-projects),两次带不同的 context。当某个组织突然冒出一堆坏事件,运维能秒级掐流量。 - 预处理 ≠ 处理:
preprocess_event干完哈希 / 标签 / 归一化后,才把事件交给process_event(后台 Celery/Taskworker 任务),由它落 Group + Event + 写 nodestore + 写 eventstream。
3. eventstream 双写(Snuba + post_process)#
event_manager.save() 走完入库逻辑后,会调 eventstream.insert(event) 把事件发给 eventstream/kafka/backend.py——这里有个双写:
- 一份走
topic:events→ post-process-forwarder consumer → 触发告警 / 通知 / 派发 webhook; - 一份走
topic:snuba-events→ snuba-consumer → 写到 ClickHouse 给查询层用。
为什么要双写?Postgres 写慢、ClickHouse 写慢、两者节奏不一样——告警要”事件落库后立刻派发”,查询可以容忍秒级。两个 topic 独立消费,各干各的事,谁慢都不会拖另一个。
另外 sentry 26.x 加了 EAP(Events Analytics Platform),事务 / 日志 / profile 用 Protobuf + TraceItem codec 编码,送 topic:snuba_items,跟传统 JSON 事件走不同路径。这就是为啥 eventstream/kafka/backend.py 里同时有 EAP_ITEMS_CODEC: Codec[TraceItem] 和老的 msgpack 编码。
4. Snuba 落 ClickHouse + Postgres 落 Group / Event#
事件落库的最终形态:
- Postgres 存”实体表”:
sentry_groupedmessage(Issue 概念)、sentry_event(事件)、sentry_grouphash(分组指纹)、sentry_message(扁平消息体)。这些是 OLTP,事务一致; - ClickHouse 存”事件体”:堆索引、tags、contexts、性能数据,查询性能 / 漏斗 / 趋势分析全在这里。OLAP,列存只追加。
Sentry 自己写了 src/sentry/snuba/ 这一层,按 dataset 分(错误、事务、functions、profiles、issue_platform、ourlogs …),每一笔事件都路由到对应 dataset + 不同 entity。这是 sentry 的 SQL-HTTP 抽象层,封装了 ClickHouse 的查询接口。
三、Hybrid Cloud:Control Silo + Region Silo#
先看图,理解 sentry 24 之后的核心改造:
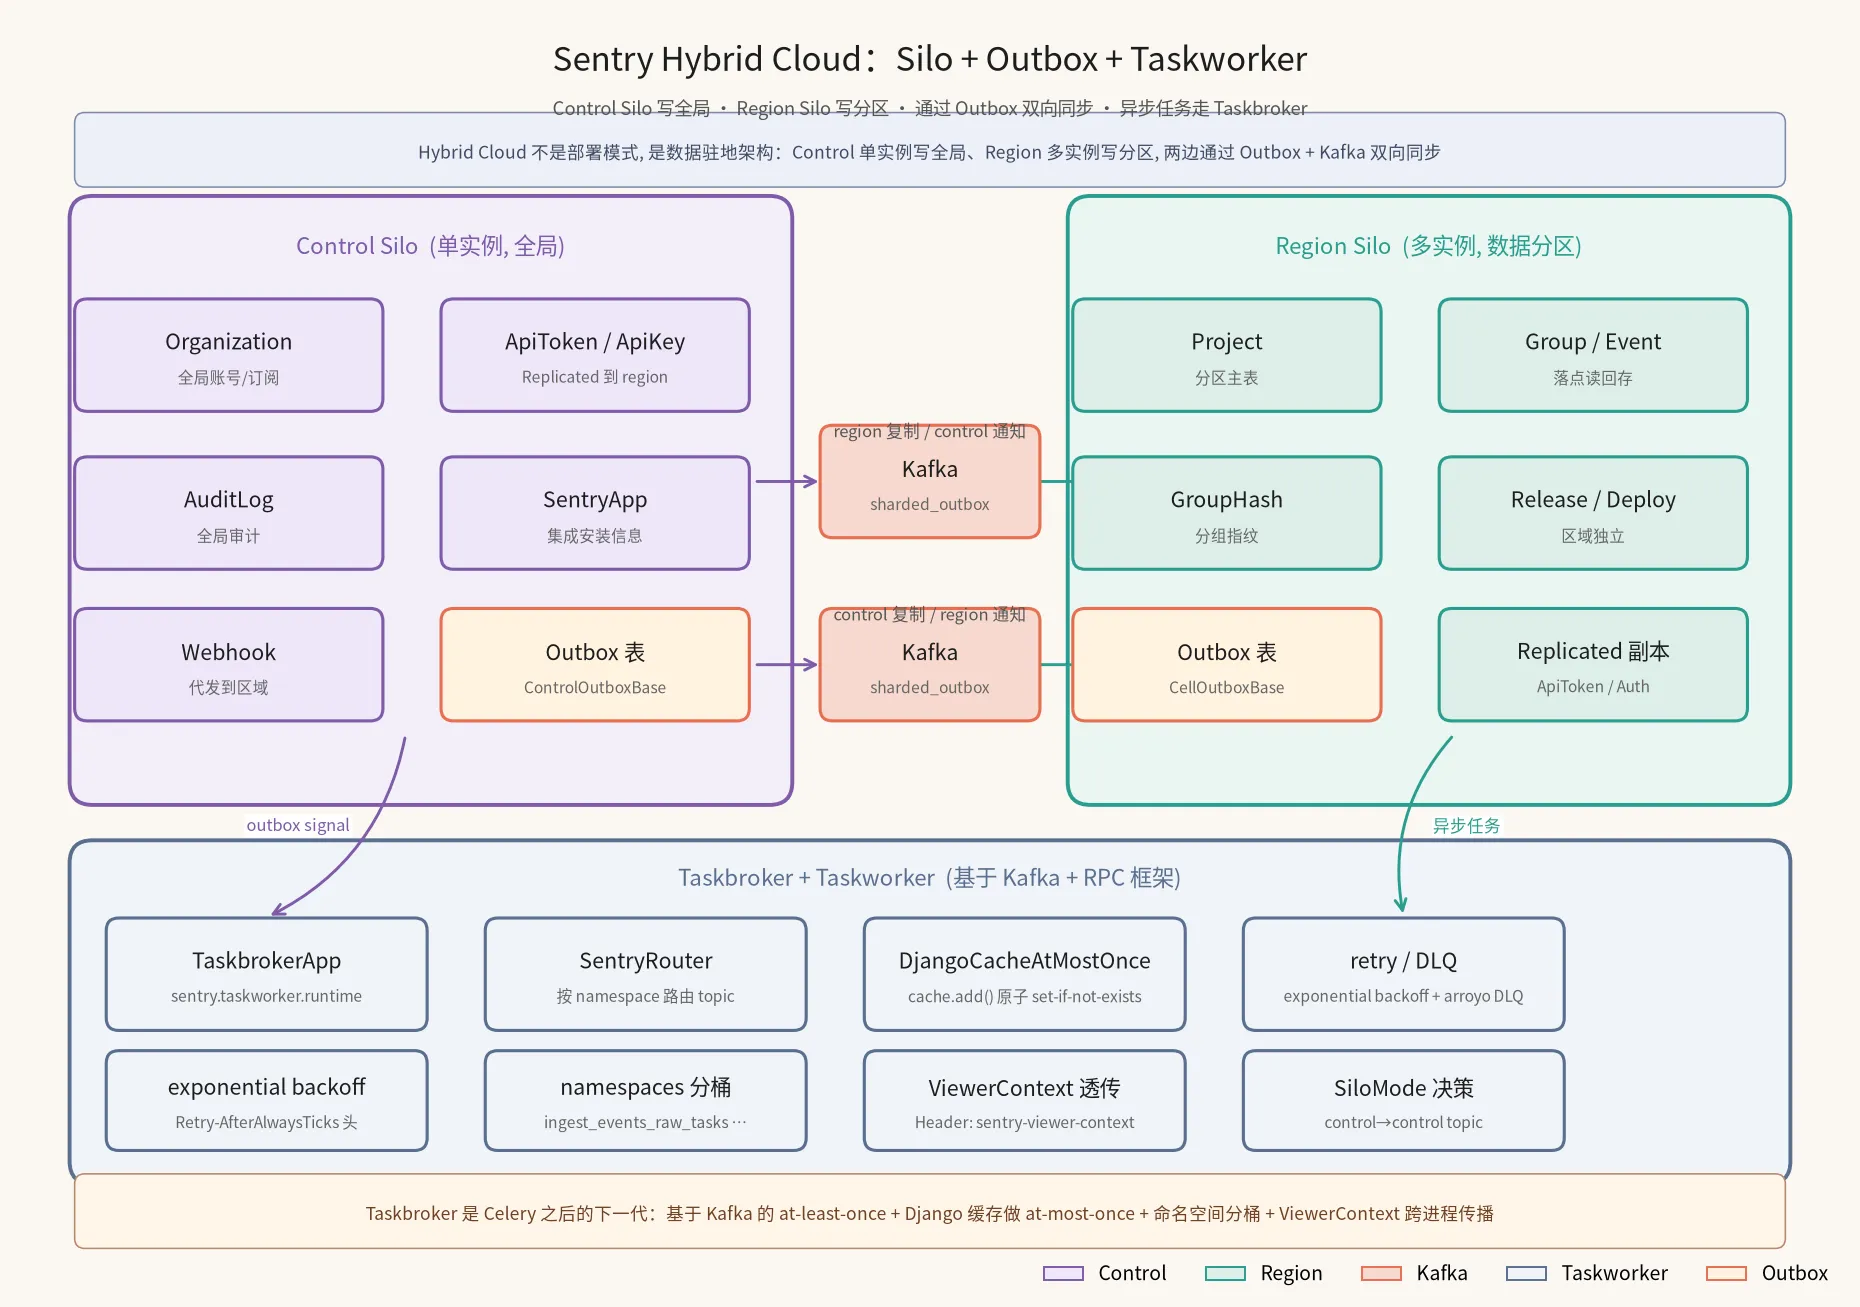
这张图把 sentry 双 silo 模型、outbox 双向 Kafka 同步、Taskworker 八个底层机制全画了。下面重点讲为什么要这么拆。
1. SiloMode:三状态枚举#
# silo/base.py
class SiloMode(Enum):
    MONOLITH = "MONOLITH"   # 自托管:全表都能访问
    CONTROL = "CONTROL"     # SaaS:只写全局账号 / 订阅 / Webhook
CELL = "REGION" # SaaS:只写分区项目 / Issue / Eventsilo 不是部署模式,是数据驻地架构——同一个 sentry 进程,根据 SILO_MODE 配置决定能访问哪些表、能调哪些 API。Sentry 内部有 127 个 model 用 cell_silo_model 或 control_silo_model 装饰器标记:
class Project(Model):
    class Meta:
        app_label = "sentry"
        db_table = "sentry_project"

# 标记为 region silo 独占
class Project(cell_silo_model(...)):
...为什么要拆?
- Organization / ApiToken / Webhook 是”全局只一份”的(一个 Org 一个 Token,不分区域),放 region 就成了多副本同步问题;
- Project / Group / Event / Release 是”按区域切分”的,每个 region 自己存自己,query 时路由到对应 region;
- 互相不可替代:Control 没了 SaaS 没法登录,Region 没了 SaaS 没法收事件。
2. Outbox:两套副本同步机制#
两套 Outbox 类对应两类同步:
# hybridcloud/outbox/signals.py
process_cell_outbox    = Signal()  # ["payload", "object_identifier"]
process_control_outbox = Signal() # ["payload", "cell_name", "object_identifier"]process_cell_outbox:Control → Region 的同步(把 ApiToken 副本、OrganizationMapping 推给 region);process_control_outbox:Region → Control 的同步(把 webhook 事件、组织变更通知回传给 control 统一调度)。
hybridcloud/models/outbox.py 是核心实现。CellOutboxProducingModel 是个 mixin,override save / update / delete:
class CellOutboxProducingModel(Model):
    def save(self, *args, **kwds):
        with self.prepare_outboxes(outbox_before_super=False):
            super().save(*args, **kwds)

    def delete(self, *args, **kwds):
        # 注意 delete 是 outbox_before_super=True, 先写 outbox 再删
        with self.prepare_outboxes(outbox_before_super=True, flush=False):
return super().delete(*args, **kwds)为啥 delete 要 outbox_before_super=True?——原子性保证:如果模型先 delete 再写 outbox,中间崩溃就丢了同步消息;反之,如果 outbox 写失败,delete 会一起回滚。
outbox 表本身也分区(按 shard_identifier,通常是 org_id 或 cell name),所有 outbox 行通过 Kafka topic sharded_outbox 投递:
Control Silo Outbox ──> sharded_outbox ──> Region Silo 订阅 ──> 写 ApiToken 副本
Region Silo Outbox ──> sharded_outbox ──> Control Silo 订阅 ──> 写 Webhook 派发这是 sentry 26 真正在生产跑的双向同步——查 hybridcloud/outbox/category.py 能看到 30 多个 OutboxCategory,从 USER_UPDATE 到 INTEGRATION_UPDATE 到 AUDIT_LOG_EVENT,全有专类。
四、Taskbroker:替换 Celery 的下一代异步任务#
最后一站。sentry 之前的异步任务基于 Celery 处理,25.x 之后换了 Taskbroker——sentry 自己写的一套基于 Kafka 的任务框架。看 taskworker/runtime.py:
app = TaskbrokerApp(
    name="sentry",
    producer_factory=make_producer,
    metrics_class=make_metrics(),
    router_class=SentryRouter(),
    at_most_once_store=DjangoCacheAtMostOnceStore(cache),
    context_hooks=[ViewerContextHook()],
)
app.set_config({
    "rpc_secret": settings.TASKWORKER_SHARED_SECRET,
    "at_most_once_timeout": 60 * 60 * 24,  # 1 天
})为啥换 Celery?
- Celery 用 Redis/RabbitMQ 做 broker,事件 idempotency 全靠消费者自己实现,Sentry 这种重 consumer 场景下到处都要重写一次幂等;
- Celery 跟 silo 模型不搭——同一个 task 在不同 silo 下应该走不同 topic,Celery 的 fanout exchange 模型对这点不友好;
- 跨进程 context(比如 ViewerContext 用于 Web Vitals 关联)Celery 没法透传,只能塞 task 参数。
Taskbroker 怎么解决:
1. SentryRouter:按 namespace 分桶路由#
# taskworker/adapters.py
class SentryRouter(LibraryRouter):
    def route_namespace(self, name: str) -> str:
        # 1) 本地 override(测试 / 灰度)
        if name in _route_overrides:
            return _route_overrides[name]
        # 2) 全局 options override(运维灰度)
        overrides = options.get("taskworker.route.overrides")
        if name in overrides:
            return overrides[name]
        # 3) settings 静态配置
        if name in self._route_map:
            return self._route_map[name]
        # 4) 默认 topic,且根据当前 silo 模式二选一
return self._default_topic_route_map 从 settings.TASKWORKER_ROUTES 读,例如:
TASKWORKER_ROUTES = json.dumps({
    "ingest_events_raw_tasks": "ingest-events-raw",
    "post_process_tasks":         "post-process",
    "control_tasks":              "taskworker-control",
})而 _default_topic 又根据 SiloMode.get_current_mode() 二选一:
if SiloMode.get_current_mode() == SiloMode.CONTROL:
    self._default_topic = Topic.TASKWORKER_CONTROL.value
elif settings.TASKWORKER_DEFAULT_TOPIC:
self._default_topic = settings.TASKWORKER_DEFAULT_TOPIC意思是:同一个 task 在 monolith 跑就直接默认 topic,在 control 跑自动切 control topic,在 region 跑自动切 region topic。 这点 Celery 真的做不到。
2. DjangoCacheAtMostOnce:Cache add() 原子实现幂等#
# taskworker/adapters.py
class DjangoCacheAtMostOnceStore(AtMostOnceStore):
    def add(self, key: str, value: str, timeout: int) -> bool:
return self._cache.add(key, value, timeout)Django cache backend 的 add() 是原子的 set-if-not-exists——意味着同一个 task_id 即使被 Kafka 投递两次,第二次 add 返回 False,worker 直接跳过。幂等保证就这么几个字:底层不重,上层不重处理。
但光幂等不够——Kafka 至少一次投递,极端情况下 task 还没执行完就 crash,重启后可能拿不到 ack 又被重新派发。怎么避免重复执行? 第一次进 worker 就 add(task_id, "in-progress", 24h),执行完 set(task_id, "done"),下次同 task_id 来的时候 exists() 一下,有就跳过。
4. SiloMode 决策 + VoyagerContext 传播#
最后两个细节:
SiloMode.get_current_mode()在 worker 启动时已经确定,所以SentryRouter自动选 topic——这其实是个单进程内的”router with environment awareness”;ViewerContextHook.on_dispatch()把当前 viewer context 塞进 headersentry-viewer-context,跨进程传播;这玩意儿原本是 Web Vitals 用的,在 worker 端恢复后能继续 trace 同一个用户的操作链路。
五、写在最后#
最后说点学习 sentry 的整体感受。
Sentry 不是一个”Python 大仓”,它是一个分布式系统伪装成 Python 应用。 你看 src/sentry/event_manager.py 3000 行,里面全是 eventstream.insert、nodestore.backend.get、GroupHash.objects.get_or_create 调来调去,真正的”事件落库”动作发生在 Kafka 后面十几个 consumer 里。这是 sentry 24 之后的核心选择:把 monolith 拆开,保留 Django 易写易读的内部,把所有重活异步化。
Outbox 是 sentry 这套架构里最值得学的模式。 任何需要跨服务 / 跨数据库一致性的场景,outbox + Kafka 都是双稳的:不上半成熟就把”分布式事务”拼成一团。Sentry 把它做成 mixin 直接挂 model 上,业务方只要用对应的 Model 基类,save/delete 就自动写 outbox,根本不用关心。
Taskbroker 替换 Celery 是 sentry 26 的关键工程。 我个人对这块很感兴趣,因为 sentry 的 monocle 实际是”在 Django 内核上塞 Sentry 内核”,把 Celery 替换掉不是简单的”换 broker”——是重新设计 idempotency / routing / context propagation 三个原语。能这么干的团队少之又少,sentry 能这么干因为 sentry 是 sentry。
读完 sentry 26 这套架构,我反而更确信一件事:好的架构不是设计出来的,是迁移出来的。Control/Region 拆分是为了应对 X 服务变 X 服务问题,Taskbroker 替换 Celery 是为了应对 X 服务变 X 服务问题。Sentry 早年的 monolith 不是错——那是当时的人给得起 X 服务问题的答案;现在 SaaS 化了,自然需要新答案。