一、一个反直觉的项目形态#
debpalash/VoiceStudio 是个 49,205 Star / 5,488 Fork 的庞然大物——121MB 描述,Python + Tauri/Electron monorepo,定位是「开源、本地优先的 ElevenLabs 替代品」。
我之前拆过 cs341、rakyll/hey、VectifyAI/PageIndex、NVIDIA/OpenShell、PAtteRNS——这些都是「一个产品能讲清楚故事的工程」。但 VoiceStudio 是个完全不同的形态:
它不是「一个产品」,而是「12+ TTS 引擎的统一抽象层」。
把它读完后,我把它的核心心智总结成 3 条:
- 多引擎统一抽象——同一个 API,可以选 omnivoice / cosyvoice / dots_tts / indextts / moss_tts / pockettts / supertonic3 / voxcpm2 / confucius4 等
- Host-aware 路由——同一台机器上,每个引擎根据
gpu_compat× HostCaps 决定”实际跑在哪” - Subprocess sidecar 隔离——每个引擎跑在独立 Python venv 里,dependency 冲突物理不可达
这三件事都不是 ElevenLabs 这种 SaaS 关心的——SaaS 假设”我的服务端都长一样”,但本地优先的工具要面对”用户的机器千奇百怪”。
让我把这三个心智一个一个拆给你看。
二、先看项目长什么样#
git clone 下来 121MB——主体在 backend/(26MB,Python FastAPI),客户端在 electron/(Tauri 桌面),核心引擎目录叫 omnivoice/(独立包)。backend/ 自身已经是个 mono-namespace:
backend/
├── core/        ← 认证、配置、错误处理、模型管理、compat shim
├── services/    ← 业务层(57+ .py 文件)
│   ├── engine_routing.py     ← ★ 多引擎 host-aware 路由
│   ├── subprocess_backend.py ← ★ sidecar 隔离原语
│   ├── model_manager.py      ← 引擎加载/卸载
│   ├── audio_dsp.py / audio_io.py / aec.py ← DSP 与 IO
│   ├── chunked_tts.py / dub_pipeline.py   ← TTS 切片 + 视频配音
│   └── diarization_*.py / asr_backend.py  ← ASR + 说话人分离
├── api/         ← FastAPI routers + 公共 schema
├── engines/     ← 12+ 引擎的 SubprocessBackend 子类
│   ├── omnivoice_subprocess / cosyvoice_subprocess / dots_tts /
│   ├── indextts / moss_tts_nano_subprocess / moss_tts_v15 /
│   ├── pockettts / supertonic3 / voxcpm2_subprocess /
│   ├── confucius4 / audiocpp / _echo (CI regression) /
│   └── omnivoice_gguf (量化)
├── speech_client/ ← Python SDK
├── worker/      ← 离线任务(音频书 / 批量配音)
├── migrations/  ← Alembic
├── plugins/     ← 第三方插件入口
└── hooks/ ← PyInstaller frozen-build shimengines/ 里每个引擎子目录都自带 main.py(sidecar 入口),这是每个引擎物理上独立的直接证据——后端父进程通过 SubprocessBackend spawn 子进程,用 length-prefixed JSON 走 stdin/stdout 通讯。
这跟 VectifyAI/PageIndex 的「cloud MCP + 本地 client 同款接口」是同一思路:统一接口 + 多实现 + 隔离 runtime。
三、核心心智 1:host-aware 路由——不静默 fallback#
backend/services/engine_routing.py 头 30 行是这个项目最硬的工程判断之一。我把它画成下面这张图:
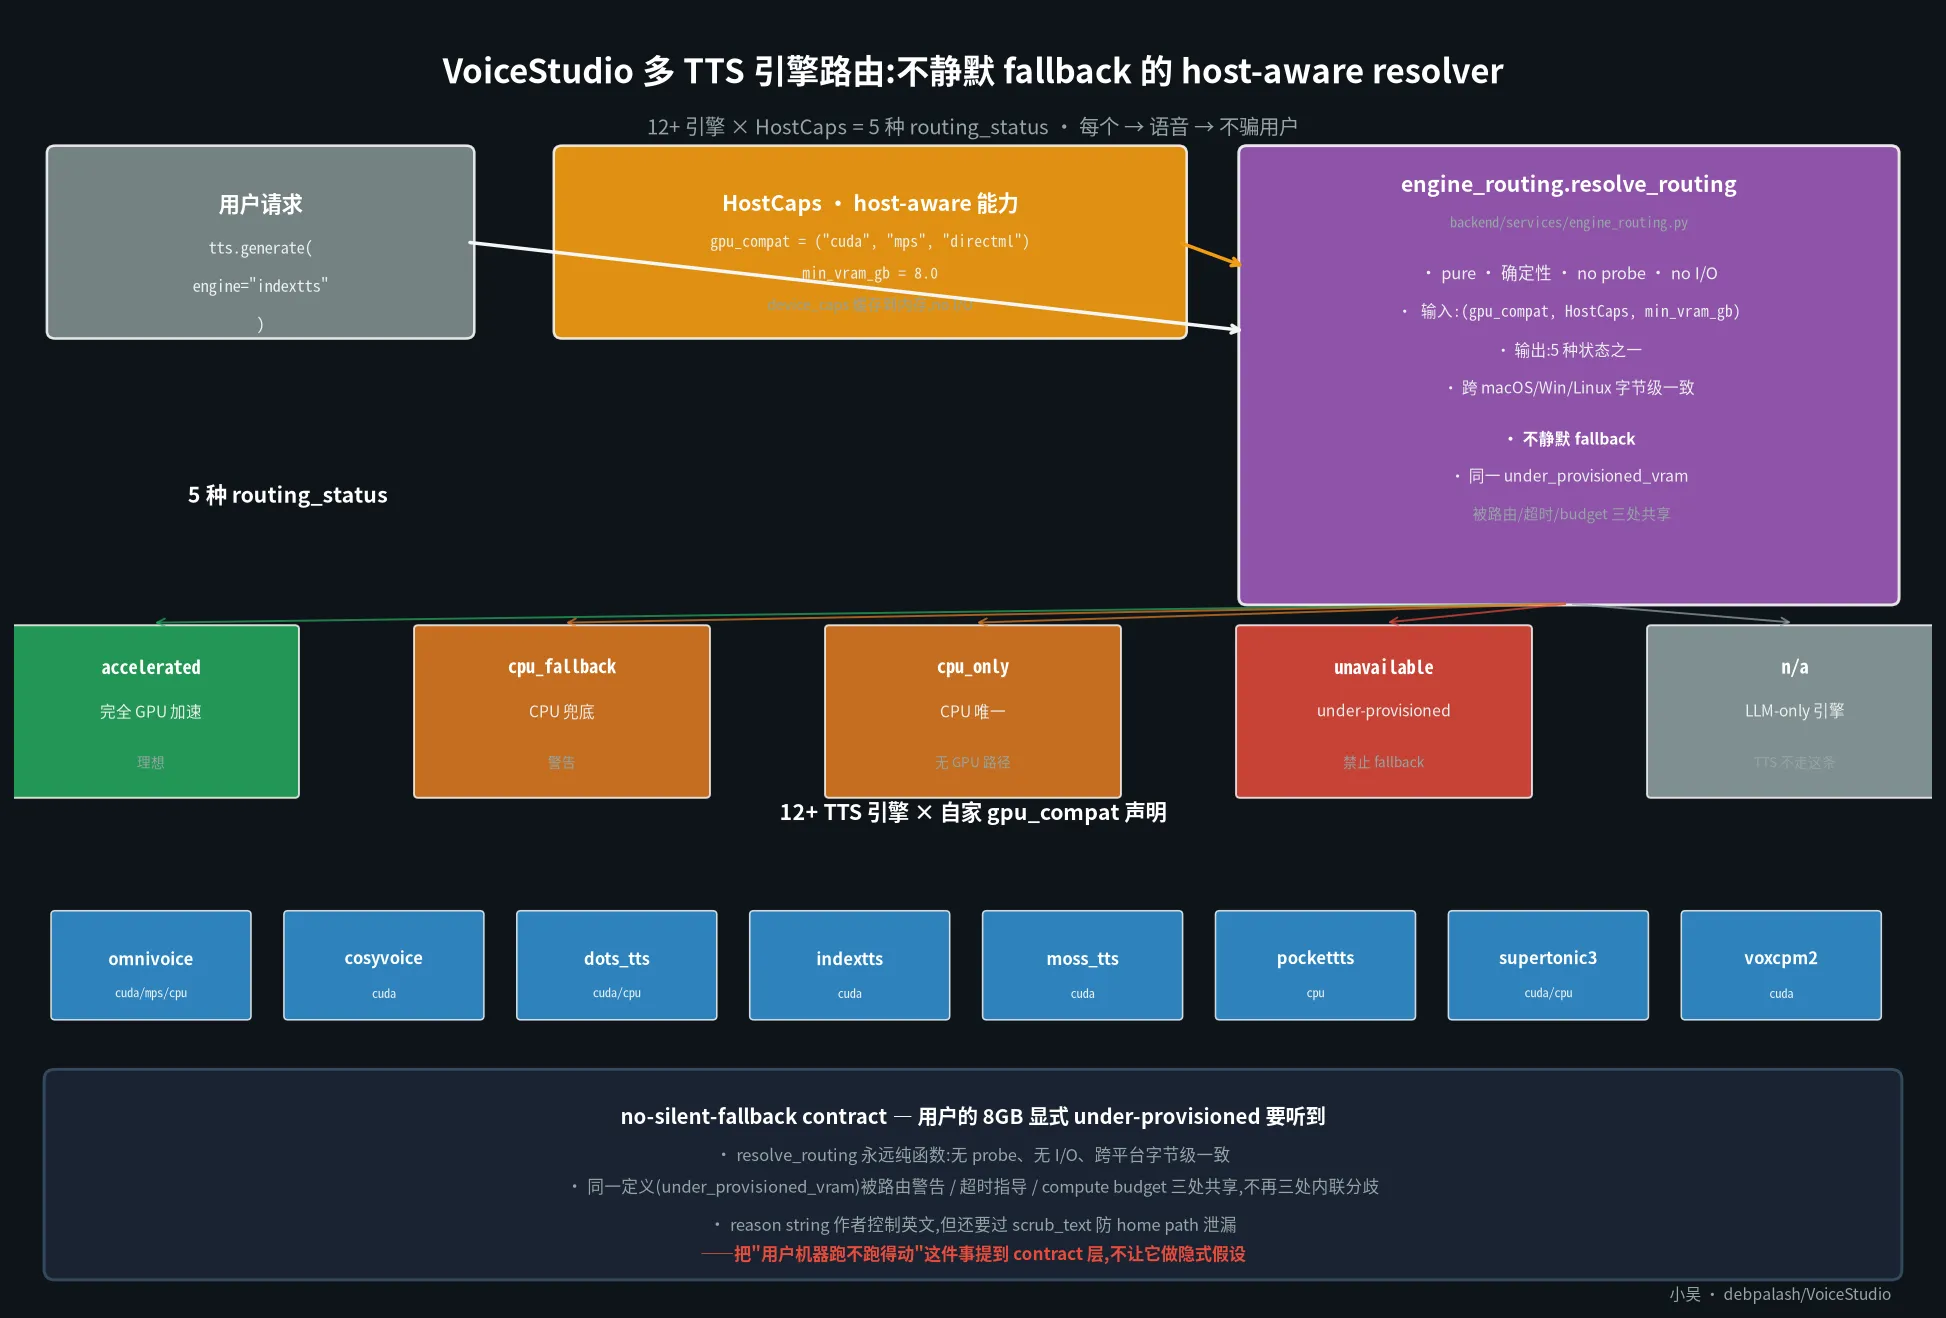
这张图把 12+ 引擎 × HostCaps 的完整决策路径画清楚了。让我把它的工程价值讲透。
3.1 函数签名就是 contract#
resolve_routing 的注释写得非常硬:
“Pure, host-aware routing resolver — maps an engine’s declared
gpu_compatagainst the cached host capabilities to ‘where will this engine actually run on this machine, and is that a problem the user should hear about?’”“No model load, no probe (the caller passes the cached
HostCaps), no I/O. Deterministic and byte-identical for a given(gpu_compat, HostCaps)across macOS/Windows/Linux — that cross-OS determinism is the whole point of the no-silent-fallback contract.”
翻译:
- 输入:引擎声明的
gpu_compat+ 缓存好的HostCaps - 输出:这个引擎实际上会跑在哪、用户是否需要被告知
- 保证:pure + no I/O + no probe + 跨平台字节级一致
这种”函数签名就是契约”的设计在系统编程里非常硬——很多 TTS 框架的引擎选择是”启动时探测”,结果 macOS 和 Linux 行为不一致。VoiceStudio 把这件事提前到缓存层,运行时只是查表。
3.2 5 种 routing_status,每个都对应一种用户期望#
RoutingStatus = Literal["accelerated", "cpu_fallback", "cpu_only", "unavailable", "n/a"]5 种状态,每种都对用户说一句不同的话:
| 状态 | 用户机器情况 | 用户应该听到 |
|---|---|---|
accelerated | GPU 完美匹配 | ”✅ 完全 GPU 加速” |
cpu_fallback | GPU 能跑但低于引擎最低显存要求 | ”⚠️ CPU 兜底,可能慢” |
cpu_only | 引擎根本不认 GPU | ”🔄 CPU 唯一,无 GPU 路径” |
unavailable | under-provisioned + 不可 fallback | ”🚫 禁止 fallback,请换引擎” |
n/a | LLM-only 引擎(TTS 不走这条) | “——不适用” |
accelerated vs cpu_fallback 区别最微妙——同样是 GPU,但 cpu_fallback 是引擎最低显存要求(min_vram_gb = 8.0)和 host 实际显存(HostCaps.vram_gb)的差。
3.3 under_provisioned_vram 的”单一真理源”#
engine_routing.py 里有一个非常关键的工程判断:under_provisioned_vram 这个判定逻辑必须只有一份代码,所有地方引用同一份。
源代码注释原话:
“The one definition of ‘under-provisioned’, shared by everything that acts on the verdict: the routing caveat below, the timeout guidance, and — since #1804 — the compute-time budget itself (
model_manager.generate_timeout_s). It was written out inline in each of them, which is how the budget came to disagree with the warning printed next to it.”
翻译:「之前 3 处地方各自 inline 写了 under_provisioned 判定,结果路由警告、超时指导、compute budget 三者结论打架」——#1804 之后统一到单一函数。
这是分布式系统里的”single source of truth”原则在 ML 工程里的具体体现:
- 路由层说”你 under-provisioned” → 显示警告
- 超时层说”你 under-provisioned” → 调高 timeout(因为 CPU 跑得慢)
- budget 层说”你 under-provisioned” → 调大 compute 时间预算
三处必须统一。VoiceStudio 的 #1804 就是把这条”三处打架”的工程债一次性还掉。
3.4 reason string 必须 scrub#
注释里有一段非常硬的安全判断:
“Reason strings are author-controlled English (interpolating only family/device names) but are still scrubbed by the caller (
core.scrub.scrub_text) before serialization, because an interpolateddevice_nameor probe note can carry a home path.”
翻译:reason string 是英文(只插值 family/device names),但仍然要过 scrub_text——因为 device_name 里可能带用户的 home 路径(/Users/jane/projects/...)。
这条和 NVIDIA/OpenShell 的”凭据 scrub”是同一类工程判断——任何用户机器相关信息都必须显式过滤,因为 LLM output 永远不能信任。
四、核心心智 2:SubprocessBackend sidecar 隔离#
backend/services/subprocess_backend.py 头 50 行是这个项目第二个最硬的工程判断。我把它画成下面这张图:
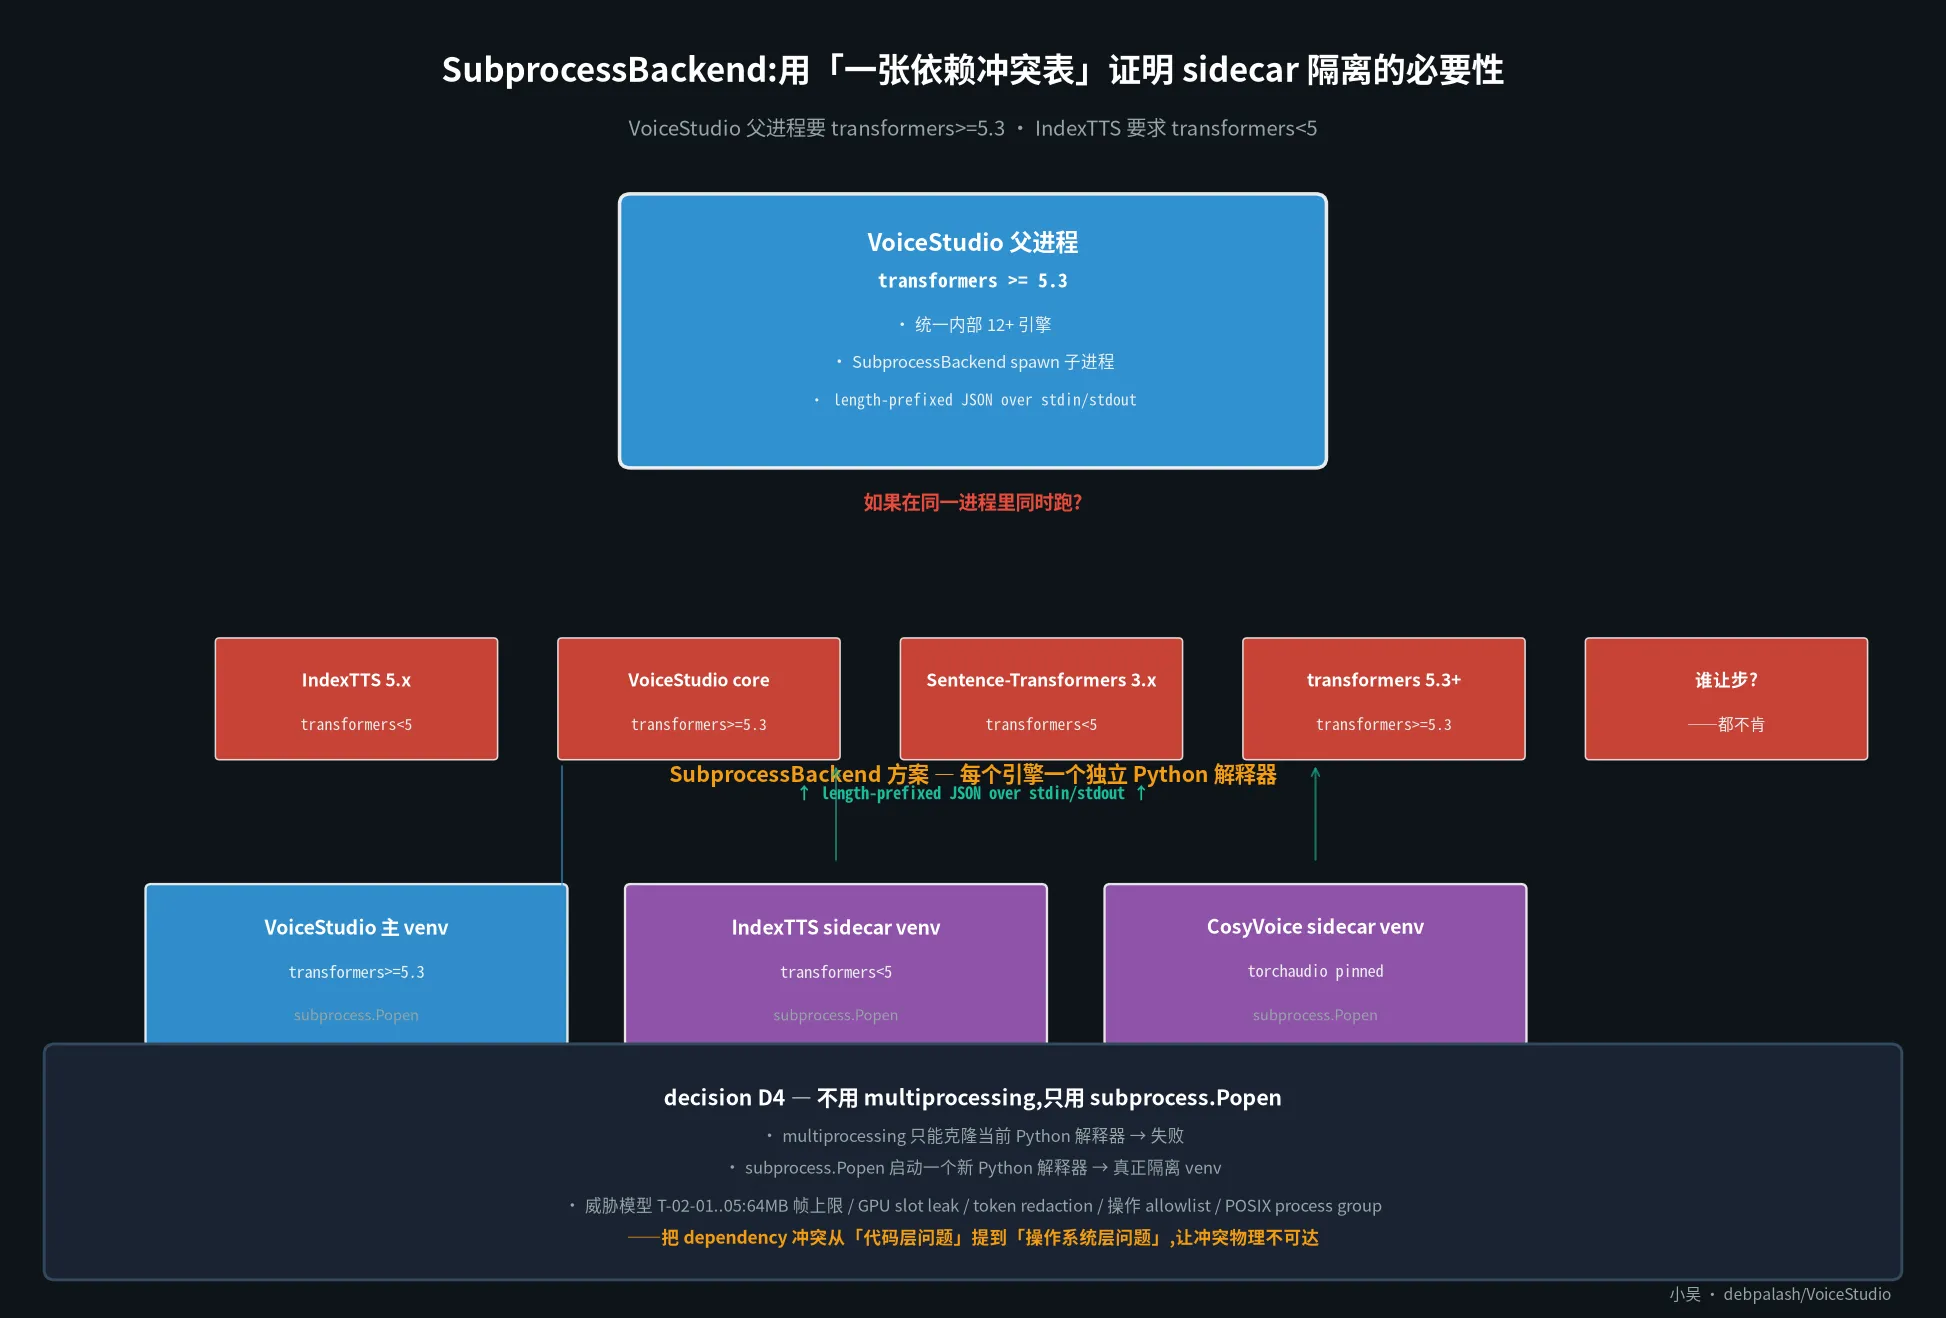
这张图把 dependency 冲突 + sidecar 隔离的逻辑画清楚了。
4.1 dependency 冲突是真实存在的#
源代码原话:
“Engines that need their own Python venv (because their dependency pins conflict with VoiceStudio’s — IndexTTS demands
transformers<5, VoiceStudio demandstransformers>=5.3) run inside asubprocess.Popenchild interpreter.”
这一句话讲清了问题:VoiceStudio 父进程要求 transformers >= 5.3,但 IndexTTS 引擎要求 transformers < 5——同一个进程里不可能同时满足两者。
Sentence-Transformers 3.x 也要 transformers < 5,这是另一个常见冲突。
4.2 multiprocessing 解决不了,要走 subprocess.Popen#
“NOT IMPLEMENTED with the multiprocessing module (Locked Decision D4 — no process-cloning variants of any kind). The whole point of this primitive is to run a different Python interpreter than the parent’s; multiprocessing can only clone the current interpreter, which defeats the dependency-isolation goal.”
multiprocessing 只能 fork 当前 Python 解释器——它解决不了 dependency 隔离问题,因为它根本换不了 venv。
subprocess.Popen 启动一个全新的 Python 解释器——可以独立指定 venv、sys.path、环境变量——这是真正隔离。
这条判断在决策文档里被标注为 D4(Locked Decision)——锁死的决策,不允许后续重构改回去。
4.3 通讯协议:length-prefixed JSON over stdin/stdout#
父进程和子进程通讯用什么?length-prefixed JSON:
# 父进程写:
length (4 bytes) + JSON bytes

# 子进程读:
read 4 bytes → 解码长度 → read N bytes → json.loads()为什么不直接用 stdlib 的 multiprocessing.Queue / Pipe?因为那些 IPC 工具也是基于 fork 的,会带上父进程的 venv。
length-prefixed JSON over stdin/stdout 是 Unix 进程间通讯的最朴素协议——没有任何隐性依赖。
4.4 5 条威胁模型#
源代码头注释里列了 5 条威胁模型:
| ID | 威胁 | 防御 |
|---|---|---|
| T-02-01 | DoS via length-prefix | hard cap 64 MB per frame |
| T-02-02 | GPU slot leak on sidecar death | try/finally in generate |
| T-02-03 | token bytes in stderr | drain via logging filter + HFTokenRedactor |
| T-02-04 | sidecar emitting unexpected ops | parent allowlist PARENT_INBOUND_OPS |
| T-02-05 | nested containment | POSIX supervisor process group / Windows Job |
每条都是真实的工程事故。我在 crash_diagnostics.py 里看到一条非常 hard 的细节:
“
faulthandlerinstalls handlers for the fatal signals (SIGSEGV, SIGABRT, SIGBUS, SIGFPE, SIGILL) that print every thread’s Python stack to stderr on the way down. That is the difference between ‘the process vanished’ and a named frame pointing at the engine call that killed it.”
翻译:faulthandler 安装 SIGSEGV 等致命信号的 handler,崩溃时打印每个线程的 Python 栈——这是”进程消失了” vs “命名 frame 指向杀进程的引擎调用”的差别。
这是个PyInstaller-frozen-build 的 debug 关键:torch.compile 在 frozen bundle 里会触发 SIGSEGV,Python traceback 抓不到,只有 faulthandler 能抓 native stack。
五、核心心智 3:/engines/<id>/main.py sidecar 入口#
backend/engines/ 下面 12 个子目录,每个都有一个 main.py,作为 SubprocessBackend 启动时的 sidecar 入口。__init__.py 里有一条非常硬的工程约束:
“
_echo/is permanent CI regression infrastructure — it ensures the SubprocessBackend round-trip stays green even when no production engine is installed. Do NOT delete it.”
_echo/ sidecar 是 CI 回归测试用的”空载”sidecar——它不做任何 TTS,只是 echo 收到的 JSON。这条用来保证 SubprocessBackend round-trip 永远不会因为没人装引擎就挂掉。
这是非常 hard 的工程测试设计——永远有一个最小可用的”假”引擎,让 CI pipeline 不依赖任何外部模型权重。
每个 sidecar 子类只需要 override 两个方法:
@classmethod
def venv_python(cls) -> Path: ...     # 路径到引擎自己的 python

@classmethod
def sidecar_script(cls) -> Path: ... # 路径到 backend/engines/<id>/main.pyspawn、ready-handshake、request/response、GPU-slot accounting、atexit teardown、stderr drainage、process-group cleanup 全部由 SubprocessBackend 基类统一管理——子类不用关心。
六、读源码学到的 5 件事#
读完 VoiceStudio 的核心模块,我把它的工程经验总结成 5 条。
6.1 多引擎统一抽象 = 单一函数签名 + 多实现 + 隔离 runtime#
VoiceStudio 不是「把 12 个 TTS 引擎的代码塞到一个 repo 里」——它是「统一 interface + 各自 sidecar 独立 venv + 各自 main.py 隔离」。
这种范式可以推广到:
- 多 LLM provider(统一 OpenAI-compatible interface + 各自独立 runtime)
- 多向量数据库(统一 query interface + 各自进程隔离)
- 多消息队列(统一 send/receive + 各自 SDK 隔离)
关键是:接口统一 ≠ 进程隔离。VoiceStudio 把这两件事都做到底。
6.2 no-silent-fallback contract 比”自动 fallback”更重要#
很多工具的 fallback 策略是”GPU 不行就 CPU,用户不知道”。VoiceStudio 反过来:显式告诉用户当前是 CPU 兜底还是 unavailable——因为 TTS 这种场景下,silent fallback 意味着”用户等了 5 分钟才发现是 CPU 跑的”。
这条工程哲学对任何用户机器千差万别的工具都适用:让用户知道机器在做什么,比让工具自作主张更专业。
6.3 under_provisioned_vram 单一真理源 = #0343 之痛#
源代码注释直接承认:“之前 3 处地方各自 inline 写了判定,结论打架”。统一到单一函数之后,路由警告 / 超时指导 / compute budget 三者一致。
这条工程经验可以推广到:
- 「这个 query 是否 cacheable」——不能在 cache 层和 query 层各自判定
- 「这个 user 是否 premium」——不能在 API 层和 billing 层各自判定
- 「这个 request 是否 idempotent」——不能在 retry 层和 DB 层各自判定
任何”看似独立的判定”,只要它们共同影响同一处行为,就必须在代码层面是单一函数。
6.4 进程隔离用 subprocess.Popen,不用 multiprocessing#
multiprocessing 是 Python 标准库里最容易被误用的模块之一——它的 fork 模式”看起来”是隔离进程,但它 fork 的是当前 Python 解释器 + 当前 venv——根本没解决 dependency 隔离。
subprocess.Popen 启动新进程,可以独立指定 venv、sys.path、env vars——这是真正隔离。
我读完后把这条写进自己的工程决策备忘:
- 多语言 runtime 隔离 →
subprocess.Popen - 同语言 Python 隔离 → 还是
subprocess.Popen(不用 multiprocessing) - 真正需要 share memory →
multiprocessing.shared_memory - 进程内并行 →
concurrent.futures.ProcessPoolExecutor(还是 subprocess)
6.5 faulthandler + frozen-build 是 TTS/ML 工具的标配#
tch.compile 在 PyInstaller 冻结的二进制里经常崩 native——Python traceback 抓不到,只有 faulthandler 能抓 native stack。
VoiceStudio 在 crash_diagnostics.py 里默认启用 faulthandler(可用 OMNIVOICE_DISABLE_FAULTHANDLER=1 关掉),这一条应该成为所有 Python ML 工具的默认配置。
我读完代码后把这条写进了自己的工具链:
# 所有 Python ML 工具的 startup 入口
import faulthandler
faulthandler.enable()  # SIGSEGV / SIGABRT / SIGBUS / SIGFPE / SIGILL
# 自动打印 native stack 到 stderr七、横向对比:VoiceStudio 和其他 voice AI 工具的差异#
我读完代码后,把 VoiceStudio 和其他主流 voice AI 工具做了横向对比:
| 工具 | 部署 | 引擎隔离 | 依赖冲突 | 路由确定性 | 许可 |
|---|---|---|---|---|---|
| VoiceStudio | 本地优先 + 桌面 | subprocess sidecar | ✅ 每个 venv 独立 | ✅ pure function | AGPL-3.0 |
| ElevenLabs | SaaS only | ——不适用 | 服务端统一 | ——不适用 | proprietary |
| Coqui TTS | 本地 | 进程内 import | ❌ 冲突难解 | ❌ probe at start | Apache-2.0 |
| Piper | 本地 CLI | 单一 binary | ——不适用 | N/A | MIT |
| OpenVoice | 本地 | 进程内 import | ❌ 冲突难解 | ❌ probe at start | MIT |
| Bark | 本地 | 单一 model | ——不适用 | N/A | MIT |
VoiceStudio 在 特殊的位置——本地优先 + 多引擎 + 强隔离——这是其他工具没有覆盖到的。
7.1 VoiceStudio 不适合什么场景#
我自己的判断,以下场景 VoiceStudio 不合适:
- 只是想用 ElevenLabs 一两个核心功能——本地优先 + 多引擎 + 强隔离带来的复杂度 ≈ 3-5x 单一模型工具
- 生产部署需要 SaaS SLA——VoiceStudio 是工具,不适合 24/7 SLA
- 跨平台支持优先级最高——VoiceStudio 主要在 macOS/Windows/Linux 上,服务端 / IoT 不是它的设计目标
- 没有 GPU——虽然有 CPU fallback,但 TTS 的实时性要求 + 无 GPU = 几乎不可用
7.2 VoiceStudio 的工程落地价值#
但有一个隐藏的工程价值是 VoiceStudio 带来的——它的多引擎抽象 + sidecar 隔离是”如何在用户机器千奇百怪的本地优先工具里做工程化”的范本。
未来 5 年的本地 AI 工具,必须:
- 走 no-silent-fallback contract(显式告知用户当前在哪种模式跑)
- 走 multi-engine router(允许用户根据硬件选引擎)
- 走 subprocess sidecar 隔离(避开 dependency 地狱)
VoiceStudio 把这 3 条都做到底,这套范式可以推广到所有”用户机器跑 AI”的场景——本地 LLM 推理、本地 embedding 推理、本地图像生成。
九、可复用方法论:读「多引擎抽象」类 Python 项目的正确姿势#
读完 VoiceStudio,我把读这类项目的方法论总结成 4 步:
- 先看
__init__.py——Python 项目的__init__.py通常会说明”子模块之间的关系”。VoiceStudio 的engines/__init__.py一句话讲了 sidecar + SubprocessBackend +_echo/三件事 - 找「接口基类」+「实现子类」——
SubprocessBackend是基类,12+ 子类在engines/<id>/main.py,这就是多引擎抽象的骨架 - 看 contract 层的
**/__init__.py头注释——VoiceStudio 的头注释直接列了 5 条威胁模型 +D4Locked Decision,这是”hard 化的工程判断”,比代码本身更值得读 - 看 CI 回归测试的最小可用 stub——VoiceStudio 的
_echo/是个”什么都不做”的 sidecar,只为 CI 不挂。这种”故意空”的测试设计非常 hard
这套方法论也适用于读 LangChain / LlamaIndex / Stable Diffusion web UI 等”多 provider 抽象”的 Python 项目。
十、写在最后#
VoiceStudio 不是一个”漂亮”的工程项目——它是个 121MB 的庞然大物,49k Star 但 commit log 显示它在持续 merge community fixes,有些代码明显是”能用就行”的工程产物。
但它做对了一件事:把”本地优先 + 多引擎 + 强隔离”这套范式,在 voice 这个具体场景里落地到了极致。每个工程判断——从 subprocess.Popen 到 no-silent-fallback 到 _echo/ 回归 stub——都是”具体的工程现实主义”。
我读完后想清楚了 3 件事:
- 本地优先工具的真壁垒是「用户的机器千奇百怪」——SaaS 服务商可以假设服务端统一,本地工具必须面对 5 种 GPU / 3 种 OS / 12 种 driver 版本
- 多引擎抽象的真正价值是「跨硬件 fallback」——不是”哪个引擎最好”,而是”哪个引擎能在用户机器上跑”
- 依赖冲突物理不可达 > 软件层 try/except——把 dependency 冲突从”代码层问题”提到”操作系统层问题”,让冲突彻底不可达
最后回答一个事实问题:VoiceStudio 的 AGPL-3.0 许可意味着任何 SaaS 用它的代码,必须公开整个衍生作品的源代码——这是和 ElevenLabs 这种专有 SaaS 完全不同的生态定位。它不卖服务,它卖”你能在自己机器上跑开源 ElevenLabs 的能力”。
参考与引文#
本文涉及的所有引用都来自 debpalash/VoiceStudio 仓库本身(commit 0834c8b,2026-09-30 拉取),以下是我精读过的核心文件:
README.md—— 项目定位 + 6 个 workspace 截图backend/services/engine_routing.py—— 核心 1:host-aware 路由 + no-silent-fallback contract +under_provisioned_vram单一真理源backend/services/subprocess_backend.py—— 核心 2:sidecar 隔离原语 + 5 条威胁模型 +subprocess.Popen而非multiprocessingbackend/engines/__init__.py—— 子模块边界 +_echo/CI 回归测试backend/engines/omnivoice_subprocess//cosyvoice_subprocess//dots_tts//indextts//moss_tts_*/pockettts//supertonic3//voxcpm2_subprocess//confucius4//audiocpp//omnivoice_gguf/—— 12+ 引擎的 sidecar 入口backend/core/crash_diagnostics.py——faulthandler默认启用 + frozen-build 诊断backend/hooks/pyi_rth_numpy_compat.py+pyi_rth_torch_compiler_disable.py—— PyInstaller frozen-build 兼容 shimbackend/core/device_caps.py——HostCaps缓存层backend/core/scrub.py—— reason string scrubbackend/services/model_manager.py—— 引擎加载/卸载backend/services/chunked_tts.py+dub_pipeline.py+dub_qc.py—— TTS 切片 + 视频配音backend/services/diarization_local.py+diarization_native.py+diarization_runtime.py—— 说话人分离的本地/原生/runtime 三层backend/services/audio_dsp.py+audio_io.py+aec.py—— DSP 与 IO + 回声消除backend/services/asr_backend.py—— ASR 抽象
仓库地址:github.com/debpalash/VoiceStudio ↗ 当前 Star:49,205 / License:AGPL-3.0 / 默认引擎:k2-fsa/OmniVoice / 支持 646 种语言
关于配图:本文两张图都是用 matplotlib 重新画的——
img1-routing.png是 VoiceStudio 多 TTS 引擎路由架构图,展示 12+ 引擎 × HostCaps → 5 种 routing_status 的完整决策路径;img2-subprocess.png是 SubprocessBackend sidecar 隔离图,展示「父进程 vs sidecar venv vs JSON RPC」的 dependency 冲突解法。原仓库docs/media/electron/有 6 张 Workspace 截图,我没复用,重画两张是为了把”no-silent-fallback contract”和”subprocess.Popen 隔离”这两个工程核心可视化讲出来。