ZCode 深度解析:84 万行 TypeScript 里的编码 Agent 工程学
💬 评论Z.ai 把自家的编码 agent 一次性开源:一核三壳的架构、三层上下文压缩、闭集的 UI 同步协议,以及一套真的会拦人的架构策略。我把它的治理门禁在本地跑通了,也把两种违规注入进去试了试。
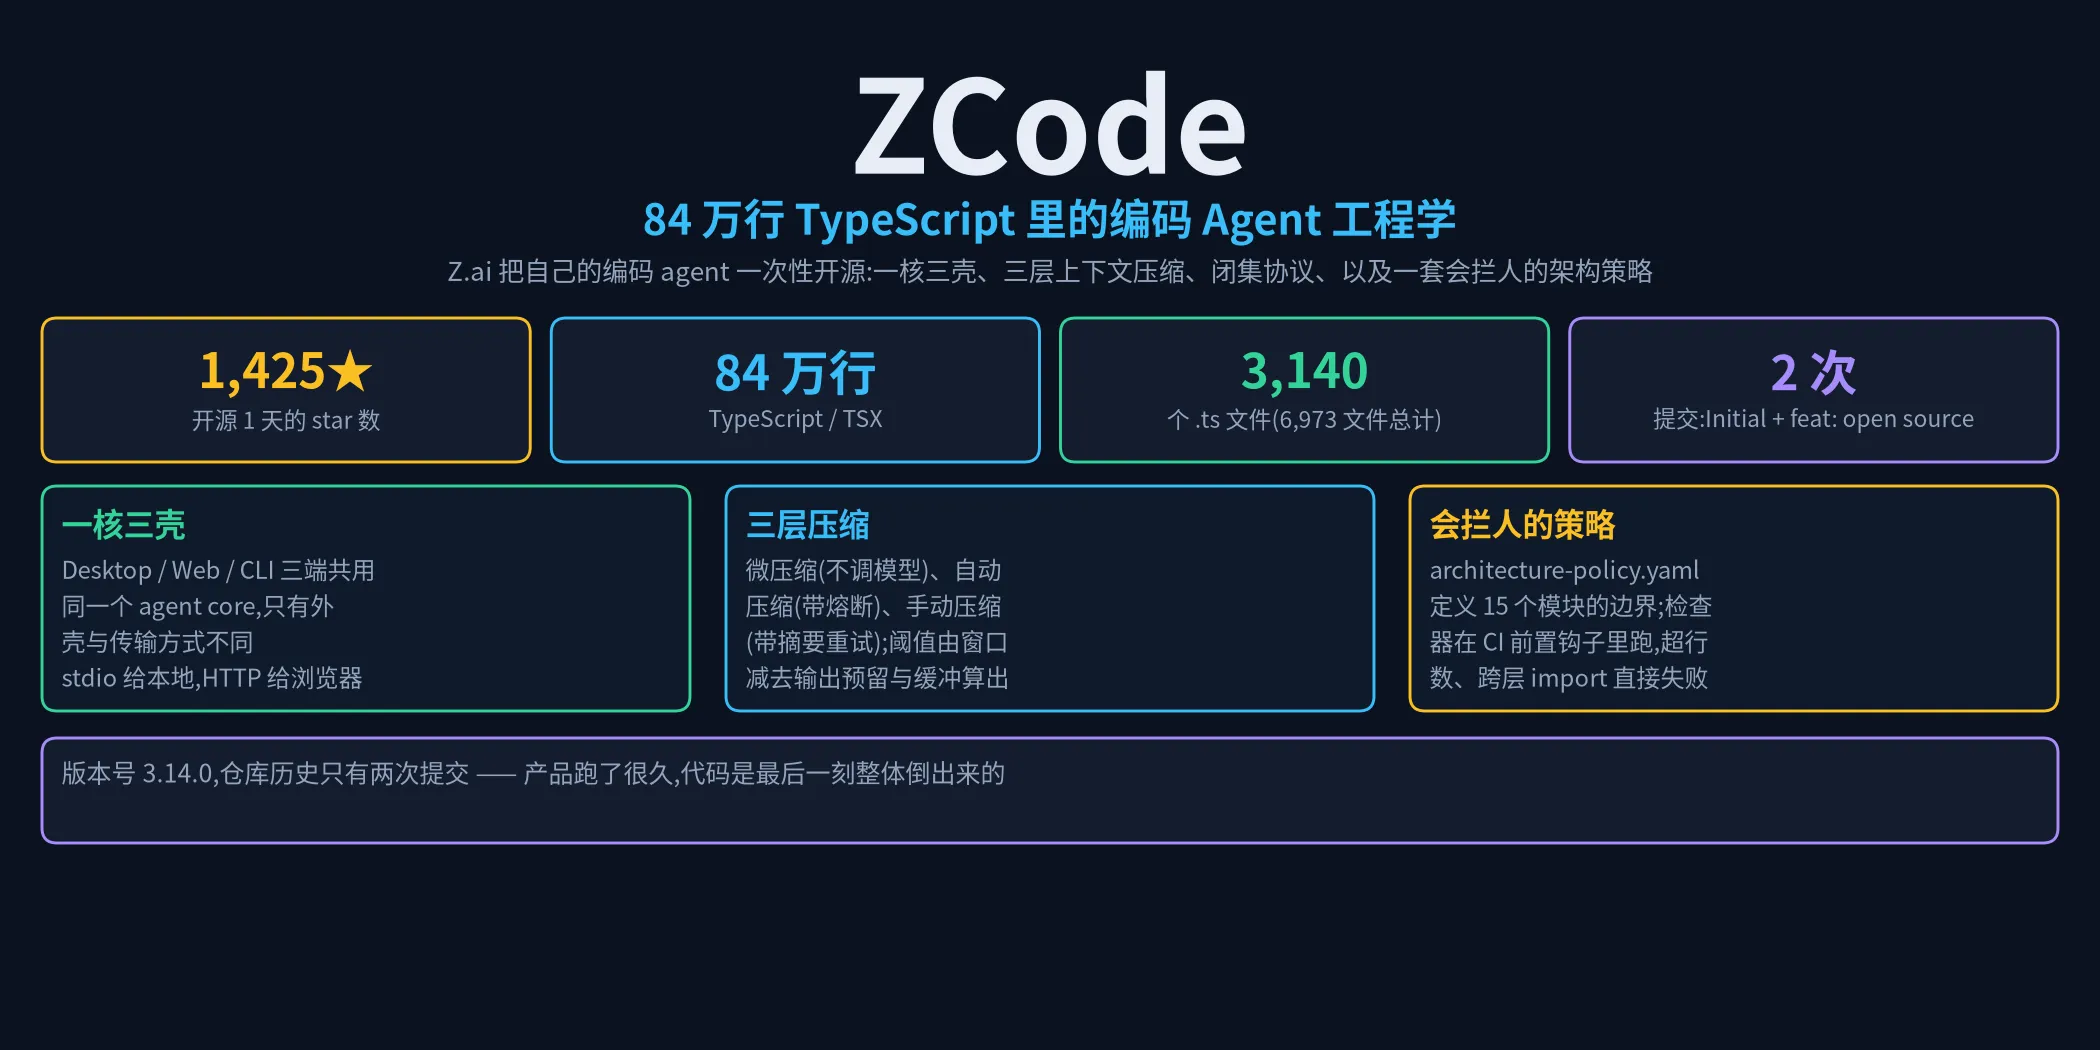
仓库:zai-org/ZCode ↗ · 官网:zcode.z.ai ↗ Apache-2.0 · 版本 3.14.0 · 建仓 2026-09-20 · 5,384→1,425 stars(建仓 24 小时内) 6,973 个文件 / 3,140 个
.ts+ 756 个.tsx/ 约 84 万行 TypeScript
先看一组数字:仓库创建于 2026-09-20 中午,一天之内 1,400 多颗星,而它的 git 历史只有两次提交 —— Initial commit 和 feat: open source。产品版本号已经到 3.14.0。
也就是说:这不是一个”公开孵化”的项目,而是一次成品级别的整体倒出。Z.ai(智谱)把他们内部一直在用的编码 agent —— 桌面端、Web 端、命令行三套客户端,连同 84 万行 TypeScript —— 在一个下午悉数开源。
那么问题来了。Claude Code、Codex CLI、Cursor、Aider、还有我之前拆过的 Pi,编码 agent 这个赛道已经挤满了,一个”又一个 CLI”为什么值得花时间读?
我的答案是:因为 84 万行这个数字本身,就是一份关于”做一个能用的编码 agent 到底要处理多少事”的清单。 模型调用只是其中很小的一块。剩下的是:
- 一轮对话要经过哪些状态,怎么保证状态合法;
- 上下文窗口满了怎么办,而且不能让用户花冤枉钱;
- 工具怎么调度、哪些能并行、哪些必须问人;
- agent 说”我要先做 A 再做 B”时,这份计划怎么被验证;
- 以及一个更少被讨论的问题:一个 84 万行的仓库,怎么让 AI agent 也在里面安全地改代码。
这份代码的回答,有三处让我觉得”这个团队是真在生产环境里被咬过”,也有几处让我停下来的诚实之处。下面按从外向内的顺序读。
一、格局:一核三壳、两传输、三圈依赖#
先建立坐标系。这个 monorepo 的形状很清楚:
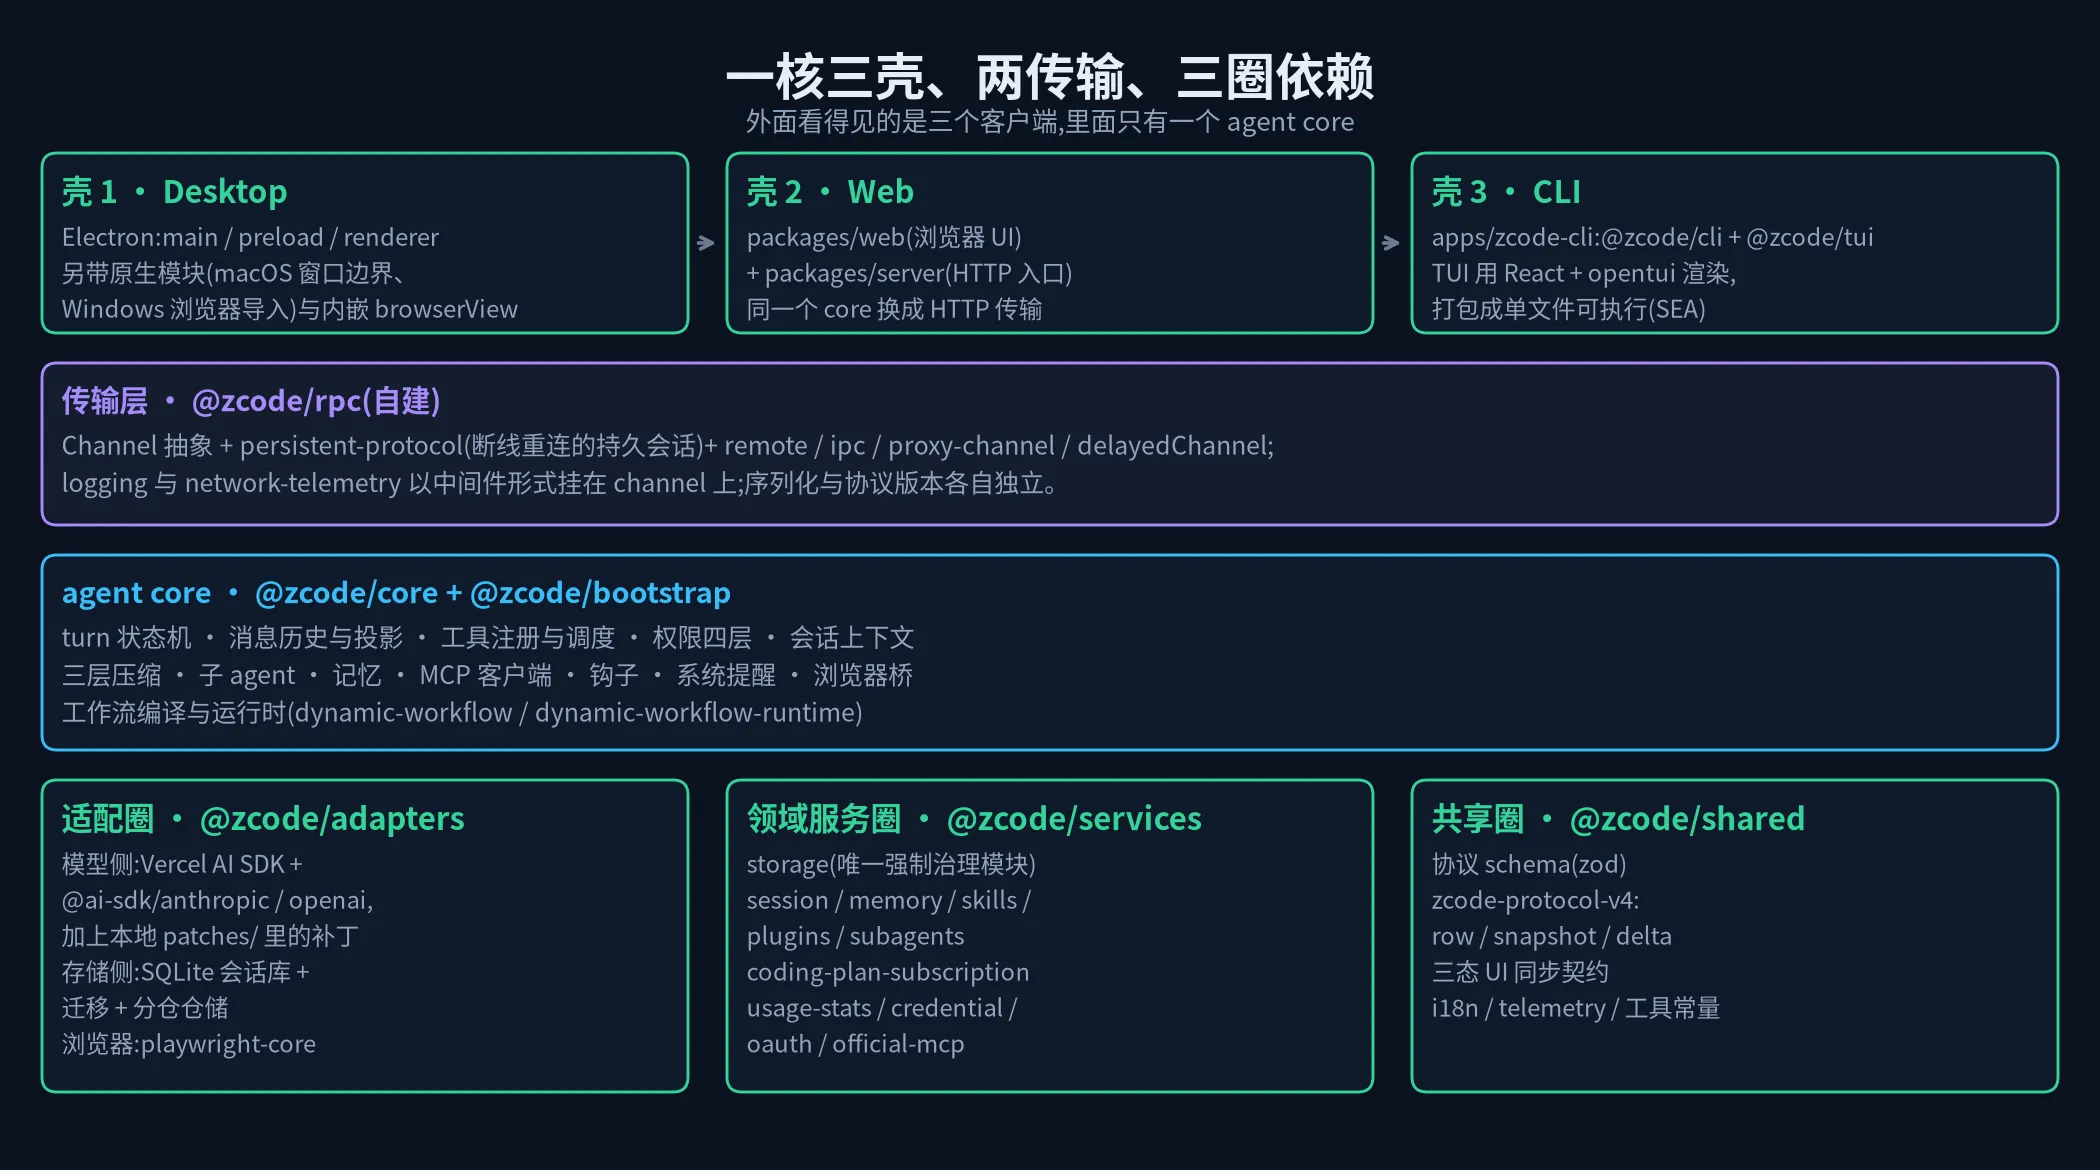
三个壳:packages/desktop(Electron,main/preload/renderer 三段外加原生模块)、packages/web + packages/server(浏览器 UI + HTTP 服务)、apps/zcode-cli(命令行 + TUI,打包成单文件可执行文件)。
两个传输:packages/server 里有 entry-stdio.ts 和 entry-http.ts 两个入口 —— 本地客户端走 stdio,浏览器走 HTTP。同一个 agent core,换一根管子。
一个自建的 RPC:packages/rpc 只有 3,295 行,却是整个系统的关节。它有 channelClient / channelServer 的通道抽象、persistent-protocol.ts(断线重连后的持久会话)、remote / ipc / proxy-channel / delayedChannel 几种通路,还有把日志与网络遥测做成中间件挂在 channel 上的机制。
三圈依赖:adapters(模型与存储的具体实现)、services(领域服务)、shared(协议与共享类型)。模型侧用的是 Vercel AI SDK(ai@6.0.193 + @ai-sdk/anthropic + @ai-sdk/openai + openai-compatible 适配器),存储侧是 SQLite 会话库(带迁移脚本和按主题拆分的仓储)。目录里还躺着一个 patches/:他们给上游依赖打补丁(@ai-sdk/anthropic、openai-compatible、@arms/rum-electron……)。
规模分布也值得看一眼,因为它决定了这个项目”重”在哪里:
| 位置 | 行数量级 | 说明 |
|---|---|---|
apps/zcode-cli/packages/core | 95.5k | agent 本体:状态机、工具、权限、压缩 |
apps/zcode-cli/packages/bootstrap | 63.5k | 启动装配、认证、脚本工作流运行时 |
apps/zcode-cli/packages/tui | 41.4k | 终端界面(React + opentui) |
apps/zcode-cli/packages/dynamic-workflow | 19.9k | 工作流编译与静态分析 |
packages/desktop / packages/ui / packages/web | 约 30 万 | 三端界面与原生能力 |
packages/services | 约 18 万 | 会话、存储、技能、插件、订阅 |
packages/formal-proof | 1,835 | 产品交互的状态空间枚举器 |
packages/zcode-cua | 585 | Computer Use 占位包 |
(工程工具链也很有个性:lint 和 format 用 Rust 写的 oxlint / oxfmt,不是 ESLint/Prettier;版本与运行时用 mise 钉住(node 24.14.0 / pnpm 10.33.2);依赖体检用 knip;git 钩子用 husky。)
把这张地图放在心里,后面的每一节都会落在它的某个格子里。
二、一轮对话被拆成了九个相位#
第一个让我认真读下去的,是 packages/core/src/agent/turn-state.ts。
大多数 agent 框架的主循环写成一个 while 加一堆回调:调模型、拿到工具调用、执行、拼回消息、再调模型。能跑,但很难回答一个简单问题:“现在处在第几步?”
ZCode 的答案是显式状态机:
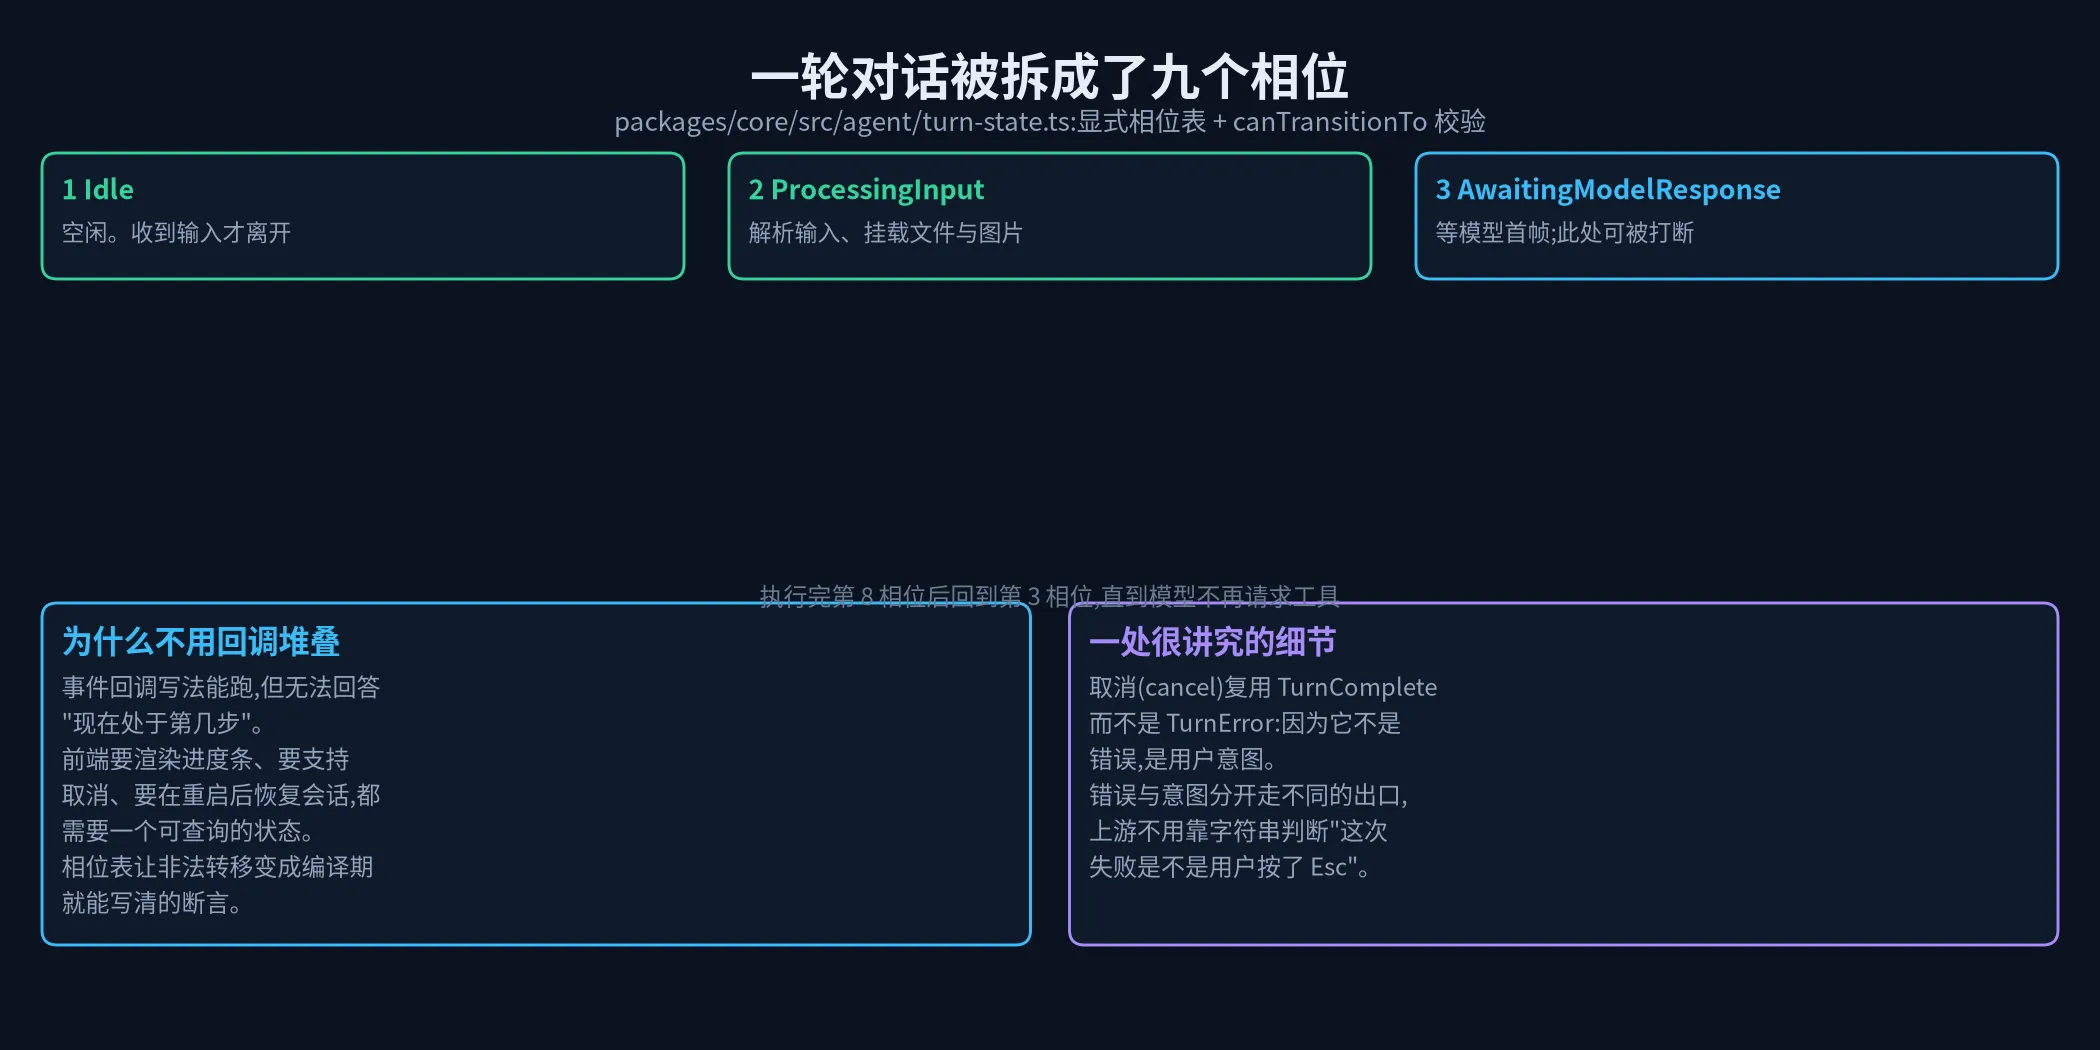
九个相位,一条主路径:Idle → ProcessingInput → AwaitingModelResponse → Streaming → SchedulingTools → ExecutingTools / AwaitingPermission → AggregatingResults →(回到 AwaitingModelResponse,直到模型不再请求工具)→ Completing → Complete。
关键在于,每个相位都配套一张允许转移表:
// turn-state.ts:canTransitionTo()
const validTransitions: Record<TurnPhase, TurnPhase[]> = {
  [TurnPhase.Idle]:                 [TurnPhase.ProcessingInput],
  [TurnPhase.ProcessingInput]:      [TurnPhase.AwaitingModelResponse, TurnPhase.Completing],
  [TurnPhase.AwaitingModelResponse]:[TurnPhase.Streaming, TurnPhase.Completing, TurnPhase.Error],
  [TurnPhase.Streaming]:            [TurnPhase.SchedulingTools, TurnPhase.AggregatingResults,
                                     TurnPhase.Completing, TurnPhase.Error],
  [TurnPhase.SchedulingTools]:      [TurnPhase.ExecutingTools, TurnPhase.AwaitingPermission,
                                     TurnPhase.Error],
  [TurnPhase.ExecutingTools]:       [TurnPhase.AggregatingResults, TurnPhase.AwaitingPermission,
                                     TurnPhase.Error],
  [TurnPhase.AggregatingResults]:   [TurnPhase.AwaitingModelResponse, TurnPhase.SchedulingTools,
                                     TurnPhase.Completing, TurnPhase.Error],
  [TurnPhase.AwaitingPermission]:   [TurnPhase.ExecutingTools, TurnPhase.Error],
  [TurnPhase.Completing]:           [TurnPhase.Idle],
  [TurnPhase.Error]:                [TurnPhase.Idle],
};(我照抄了这张表,是因为它比任何文档都更清楚地描述了”一个 agent 一轮里可能发生什么”。注意 Streaming → AggregatingResults 这条:模型只回文本、没有工具调用时,可以直接跳到汇总;而 Completing / Error 两个终态都回到 Idle,说明状态机是可以复用的 —— 一次 turn 结束,下一次从零开始。)
以及一个校验函数 canTransitionTo(from, to)。这一步的价值不在运行时(运行时它几乎从不失败),而在于把”这轮对话到底有哪些形态”从隐含知识变成了可枚举的数据。
有了这张表,很多以前要靠人记的事情就变成可以回答的:
- 界面要画进度条,只需要看当前相位;
- 用户按 Esc,从哪些相位可以取消、取消后落到哪里,是表里写清楚的;
- 会话恢复时,“上次在那个相位崩了”这句话有确切含义。
同一处还有一个小细节我很喜欢:取消(cancel)复用的是 TurnComplete 事件,而不是 TurnError。 因为”用户按了 Esc”不是错误,是意图。把错误和意图分成两个出口,上游就不必靠判断错误字符串来猜”这次失败是不是用户自己按的”。这种分法在写完之后会显得理所当然,但在一开始就想到,是需要经验的。
另外,状态机的驱动者是 runtime/agent-runtime.ts(664 行),旁边还配了一个 command-queue.ts(241 行)—— 输入的排队与打断,和状态机是一对:一个管”有序的状态”,一个管”无序的输入”。
三、上下文工程:三层压缩,三档代价#
第二个让我停下来的是 packages/core/src/compact/。它只有 857 行,但回答了一个所有长会话 agent 都会遇到、且大多处理得很糙的问题:上下文快满了怎么办?
常见的做法是”到阈值就叫模型摘要一遍”。ZCode 分了三层,而且顺序很有讲究 —— 先做免费的,再做便宜的,最后才动贵的:
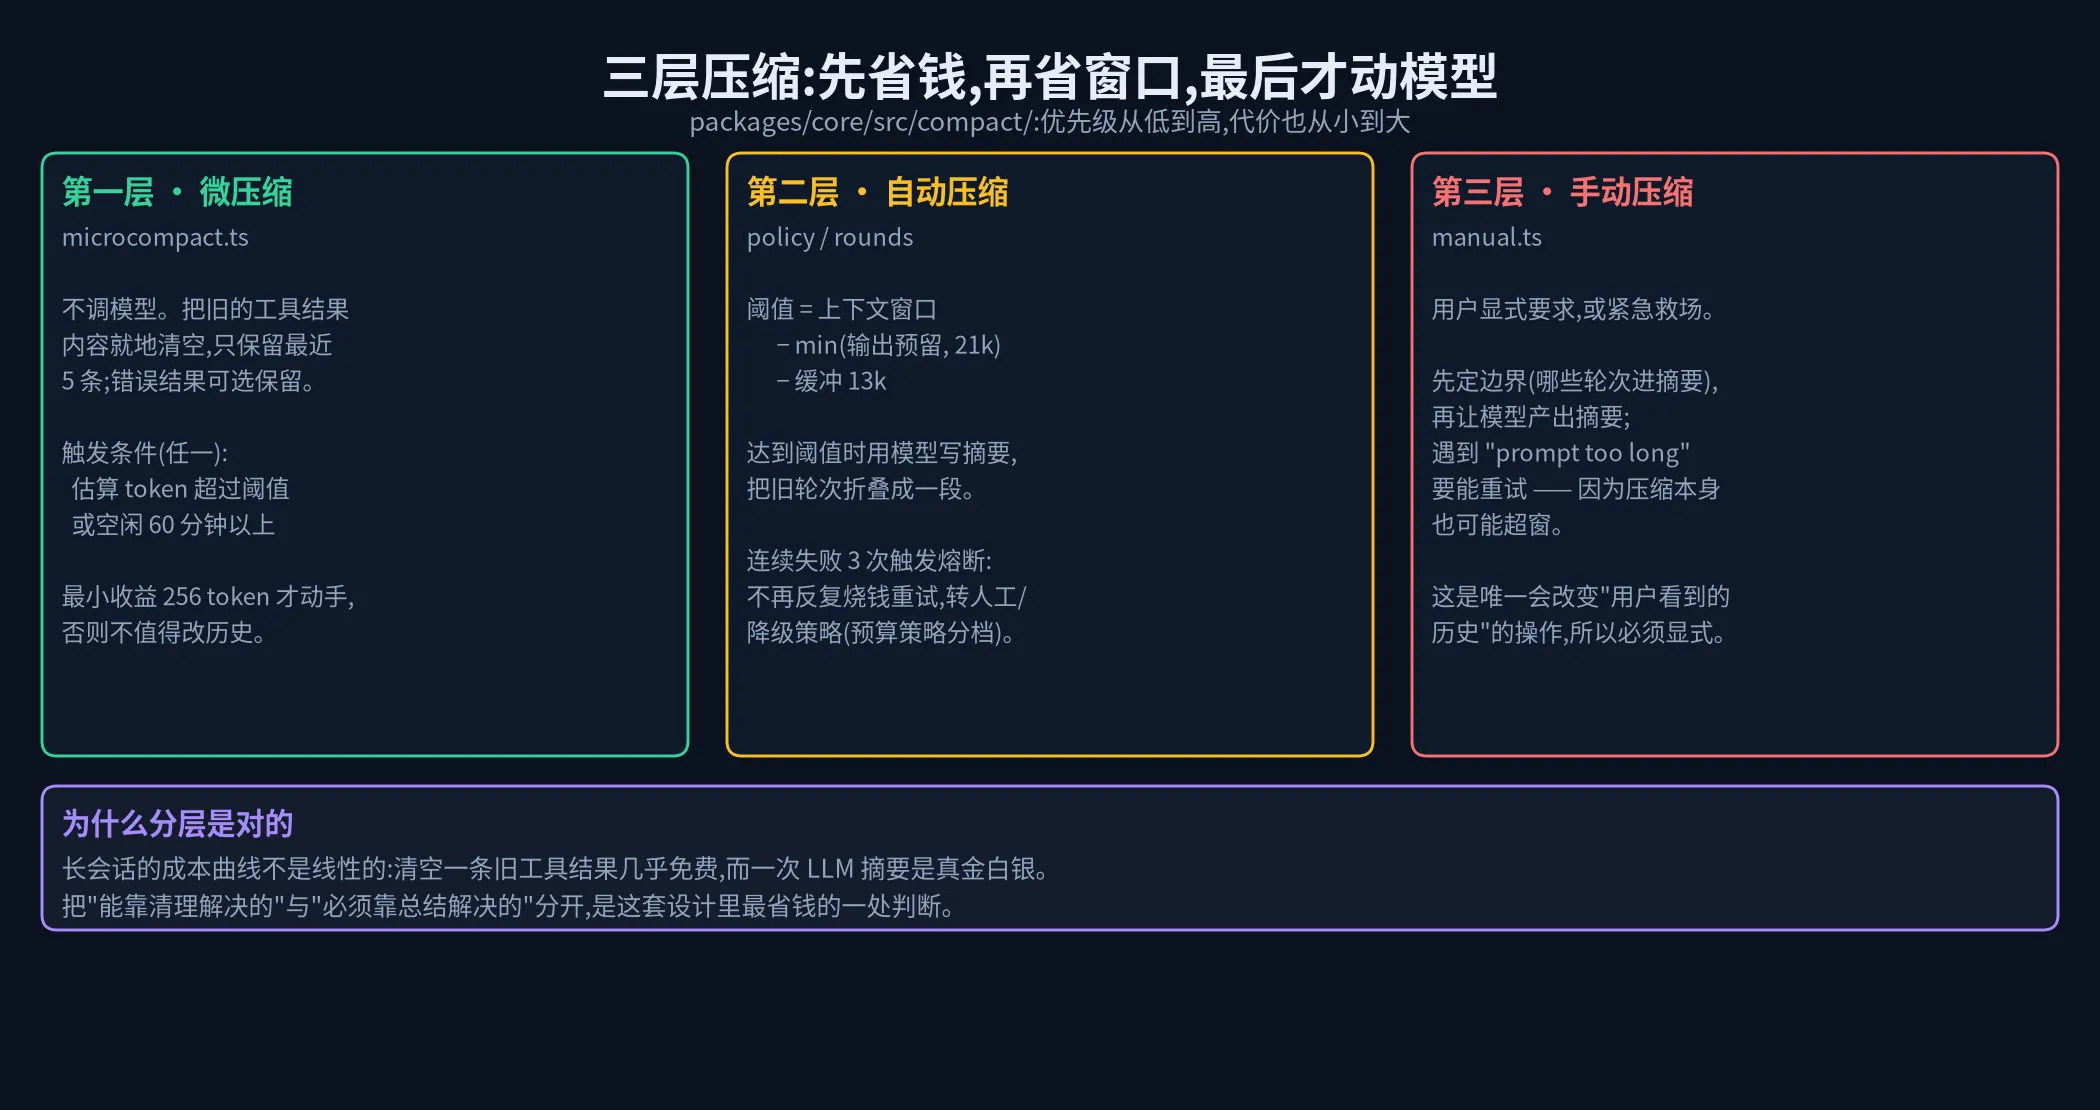
第一层是微压缩(microcompact),特点是完全不调模型。 它做的事很土:把旧的工具调用结果内容清空。工具调用和结果的结构保留,文本内容丢弃 —— 在上下文里,一条 5,000 token 的 Read 结果会被折叠成”这里曾经读过某个文件,结果已清理”。
它有两个触发条件,这里能看到设计者对成本和体验的平衡:
// microcompact.ts 的核心常量(原文常量名)
export const DEFAULT_MICROCOMPACT_KEEP_RECENT_TOOL_RESULTS = 5;   // 只清"最近 5 条之外"的
export const DEFAULT_MICROCOMPACT_MIN_TOKEN_SAVINGS = 256;        // 省不到 256 token 就不动历史
const DEFAULT_MICROCOMPACT_IDLE_THRESHOLD_MINUTES = 60; // 空闲 1 小时以上也触发最后那条很有意思:用户走开了,回来后系统”顺手把旧结果清了”,这样下一次请求更省 token,而用户不会察觉丢失了什么 —— 因为被清的是他早就看过的东西。“省不到 256 token 就不动手”这条也值得学:优化本身也有成本(改历史会破坏 prompt 缓存),不值得为小钱破坏缓存。
第二层是自动压缩,阈值公式值得抄:
export const DEFAULT_AUTOCOMPACT_OUTPUT_RESERVE_TOKENS  = 32_000;  // 默认预留
const PREFLIGHT_AUTOCOMPACT_OUTPUT_RESERVE_TOKENS        = 21_000;  // 预检档预留
export const AUTOCOMPACT_BUFFER_TOKENS                   = 13_000;
export const MAX_CONSECUTIVE_AUTOCOMPACT_FAILURES        = 3;

// 有效窗口 = 上下文窗口 − min(预留, 上下文窗口)
// 压缩阈值 = 有效窗口 − 缓冲三个细节值得记:预留是取最小值而不是固定值(小窗口模型不能按 32k 留),13k 的缓冲留给系统提示、工具定义和下一轮输入;而”预留”本身还有两个档(默认 32k、预检 21k)—— 因为正常请求的输出上限本身就是一个可配的目标,压缩阈值必须跟着它走。把”窗口管理”写成账面数字而不是感觉,是这一层最工程化的地方。
第四行就是熔断:连续 3 次压缩失败就停手。这条规则救的是钱 —— 失败的压缩会反复把整个上下文喂给模型,而每次都失败。
第三层是手动压缩,只在用户显式要求或紧急救场时触发。它多两件事:先定”边界”(哪些轮次进入摘要),再考虑”摘要本身也可能超窗”的情况并准备重试。
三层之间是正交的:能靠清理解决的,不要用总结;能靠一次总结解决的,不要重开会话。 这个优先级是我在这份代码里看到的最省钱的一处判断。
四、工具、调度、权限:三层各管一件事#
接下来是 agent 的手和脚。这块的规模超出我的预期:光工具实现文件就有 114 个。
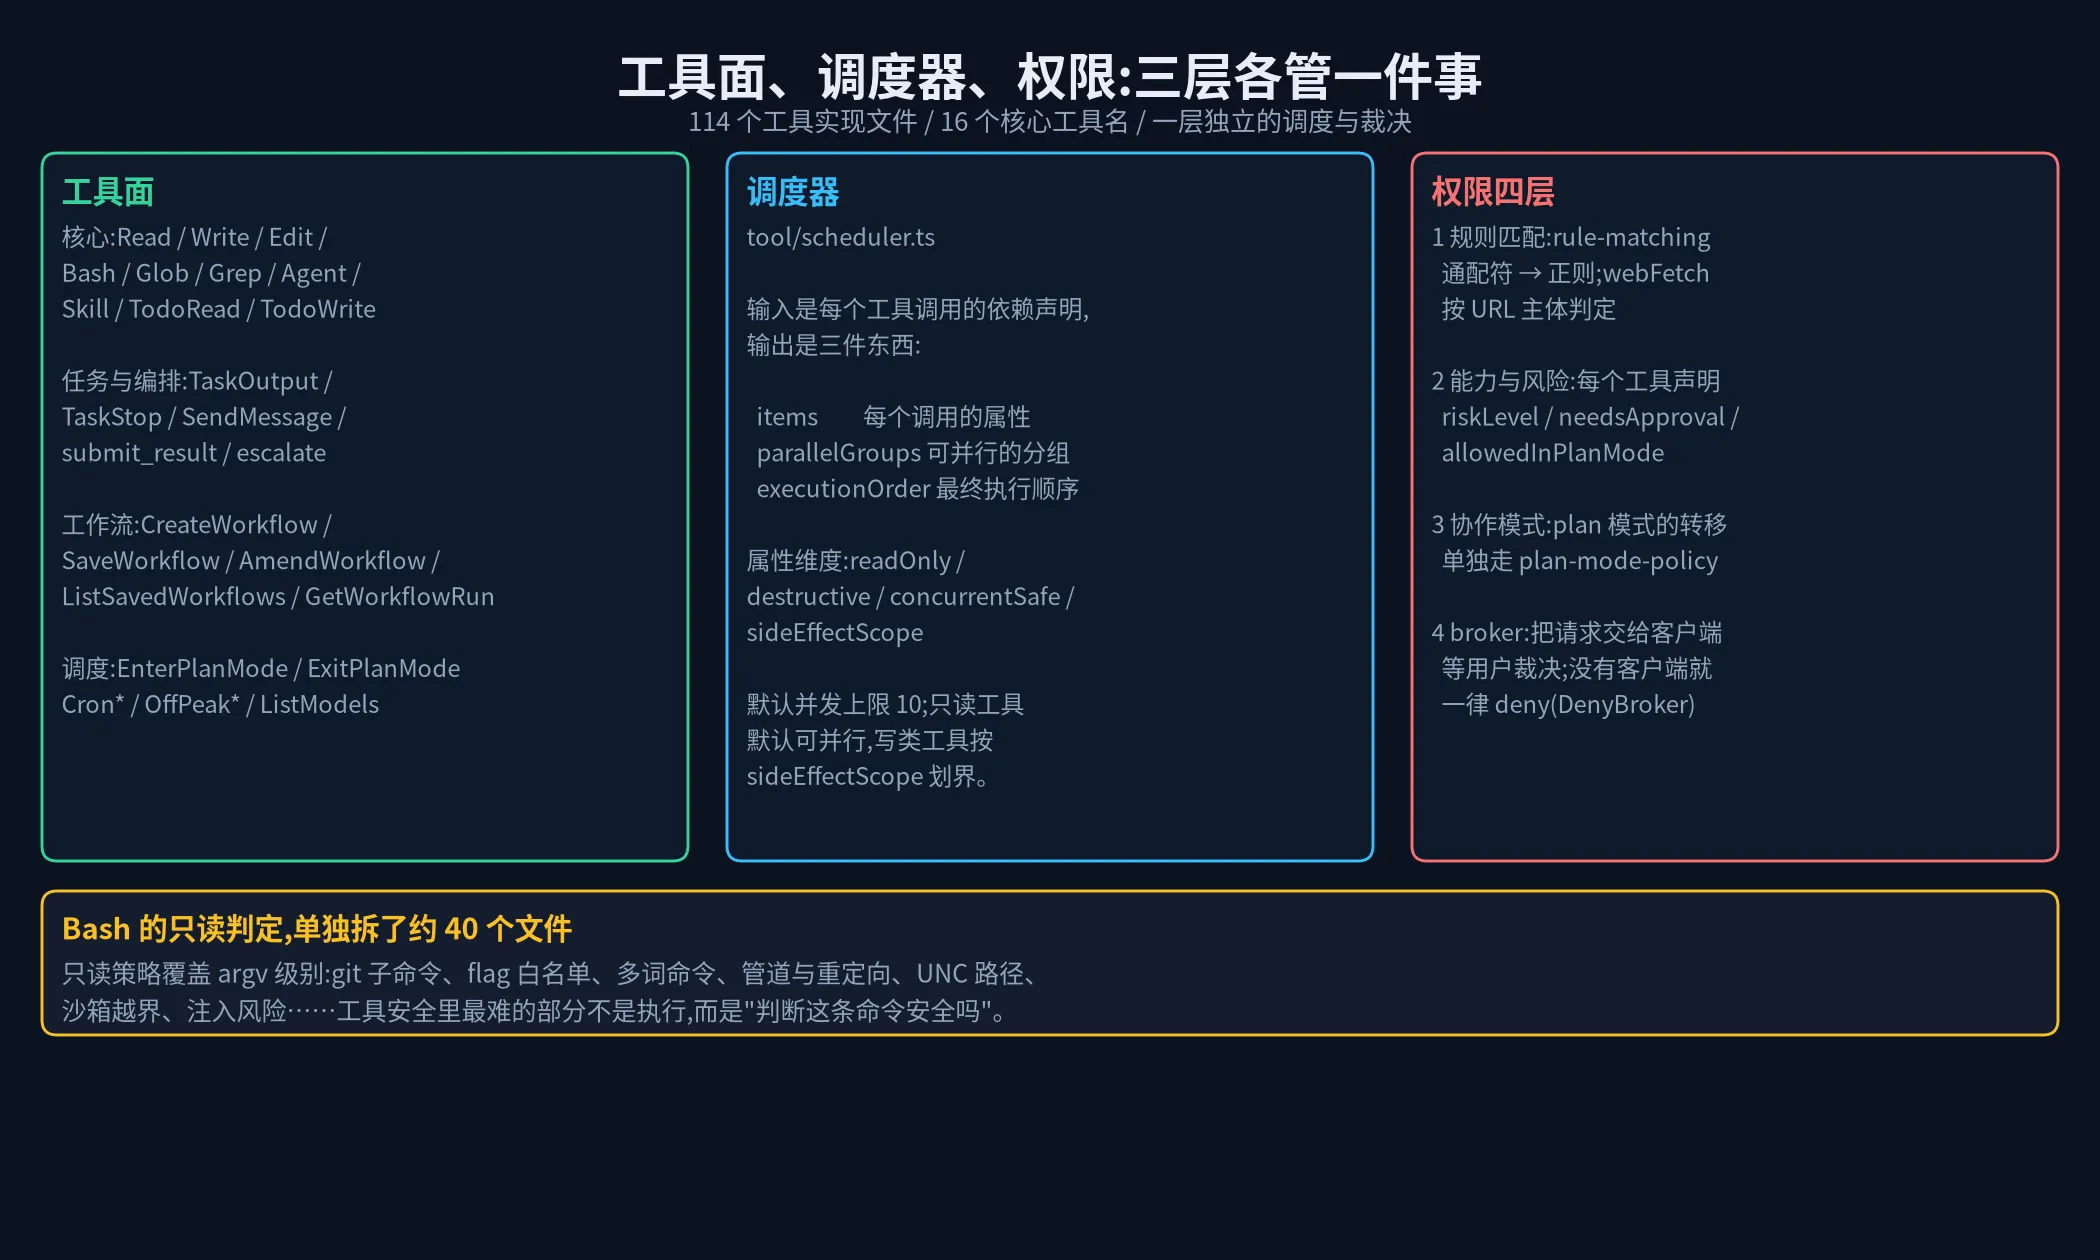
工具面。核心十几个工具和主流 harness 大致对齐:Read / Write / Edit / Bash / Glob / Grep / Agent(子 agent)/ Skill / TodoRead / TodoWrite。真正体现产品形态的是另外几组:
- 工作流组:
CreateWorkflow/SaveWorkflow/AmendWorkflow/ListSavedWorkflows/GetWorkflowRun—— agent 可以写、存、改、列出工作流(第五节展开); - 任务组:
TaskOutput/TaskStop/SendMessage/submit_result/escalate; - 模式与调度组:
EnterPlanMode/ExitPlanMode/Cron*/OffPeak*/ListModels。
调度器。tool/scheduler.ts 的职责是把”模型一次给出的多个工具调用”编排成执行计划,输出三样东西:
export interface ToolScheduleState {
  items: ToolScheduleItem[];       // 每个调用的依赖与属性
  parallelGroups: ToolCallId[][];  // 哪些可以并行
  executionOrder: ToolCallId[];    // 最终顺序
}

export interface ToolScheduleItem {
  toolCallId: ToolCallId;
  dependencies: ToolCallId[];
  canRunParallel: boolean;
}判据是每个工具声明的属性:readOnly / destructive / concurrentSafe / sideEffectScope。默认并发上限 10;只读工具默认可并行,有副作用的工具按”影响范围”划界。这个抽象的聪明之处在于:它把”能不能同时做”从模型的语言推理,转移到了工具的静态声明上 —— 模型可以一次要求读 20 个文件,调度器负责让它们真的并行。
权限四层。这是我最欣赏的一段,因为它把”问人”这件事拆得很有层次:
- 规则匹配(
rule-matching.ts):把用户配置的通配符规则转成正则;网络类工具还要按 URL 主体判断,而不是整个 URL —— 否则一个 query string 就能绕过白名单; - 能力与风险:每个工具声明自己的
riskLevel、是否需要批准、在 plan 模式下是否允许; - 协作模式:plan 模式(只读探查 + 出计划)的进出转移单独由
plan-mode-policy.ts管; - 裁决者:
broker把请求交给客户端等用户裁决;如果当前没有客户端能接(比如纯后台运行),则一律 deny —— 默认实现就叫DenyPermissionBroker,理由字符串是No permission client configured for <toolName>。
第四层是这条链子最容易被做错的地方。多数实现里,“没人应答”会被当成”默认通过”,因为那样流程不会卡住。ZCode 选了相反的方向:无人应答 = 拒绝。 对 agent 这种能删库、能推代码的东西来说,这个默认值选对了。
最后单独说一句 Bash。这个工具的只读判定被拆成了大约 40 个文件:argv 级别的解析、git 子命令的语义、flag 白名单、多词命令的识别、管道与重定向、UNC 路径、沙箱越界、注入风险……(细节在 tool/handlers/bash-readonly-policy.ts 与它的邻居们里,git-bash-subcommands.ts、bash-multiword.ts 之类各管一段。)
工具安全里最难的部分从来不是执行,而是”判断这条命令安全吗”。 40 个文件这个数量级,和”用一个正则匹配 rm -rf”之间的距离,就是玩具和产品的距离。
五、让 agent 写 TypeScript,然后把类型系统当护栏#
如果说这份代码里有一处设计是”别家没见过”的,那就是 dynamic-workflow 这个包。
先看它要解决的问题。agent 干活时会做计划,但计划通常是不可验证的:要么让模型吐一段自然语言(“我会先分析需求,然后并行实现,最后做集成测试”),要么让它吐一个 JSON 计划 —— 然后你只能祈祷字段没写错、依赖没写反。
ZCode 的选择是:让 agent 写 TypeScript 源码。
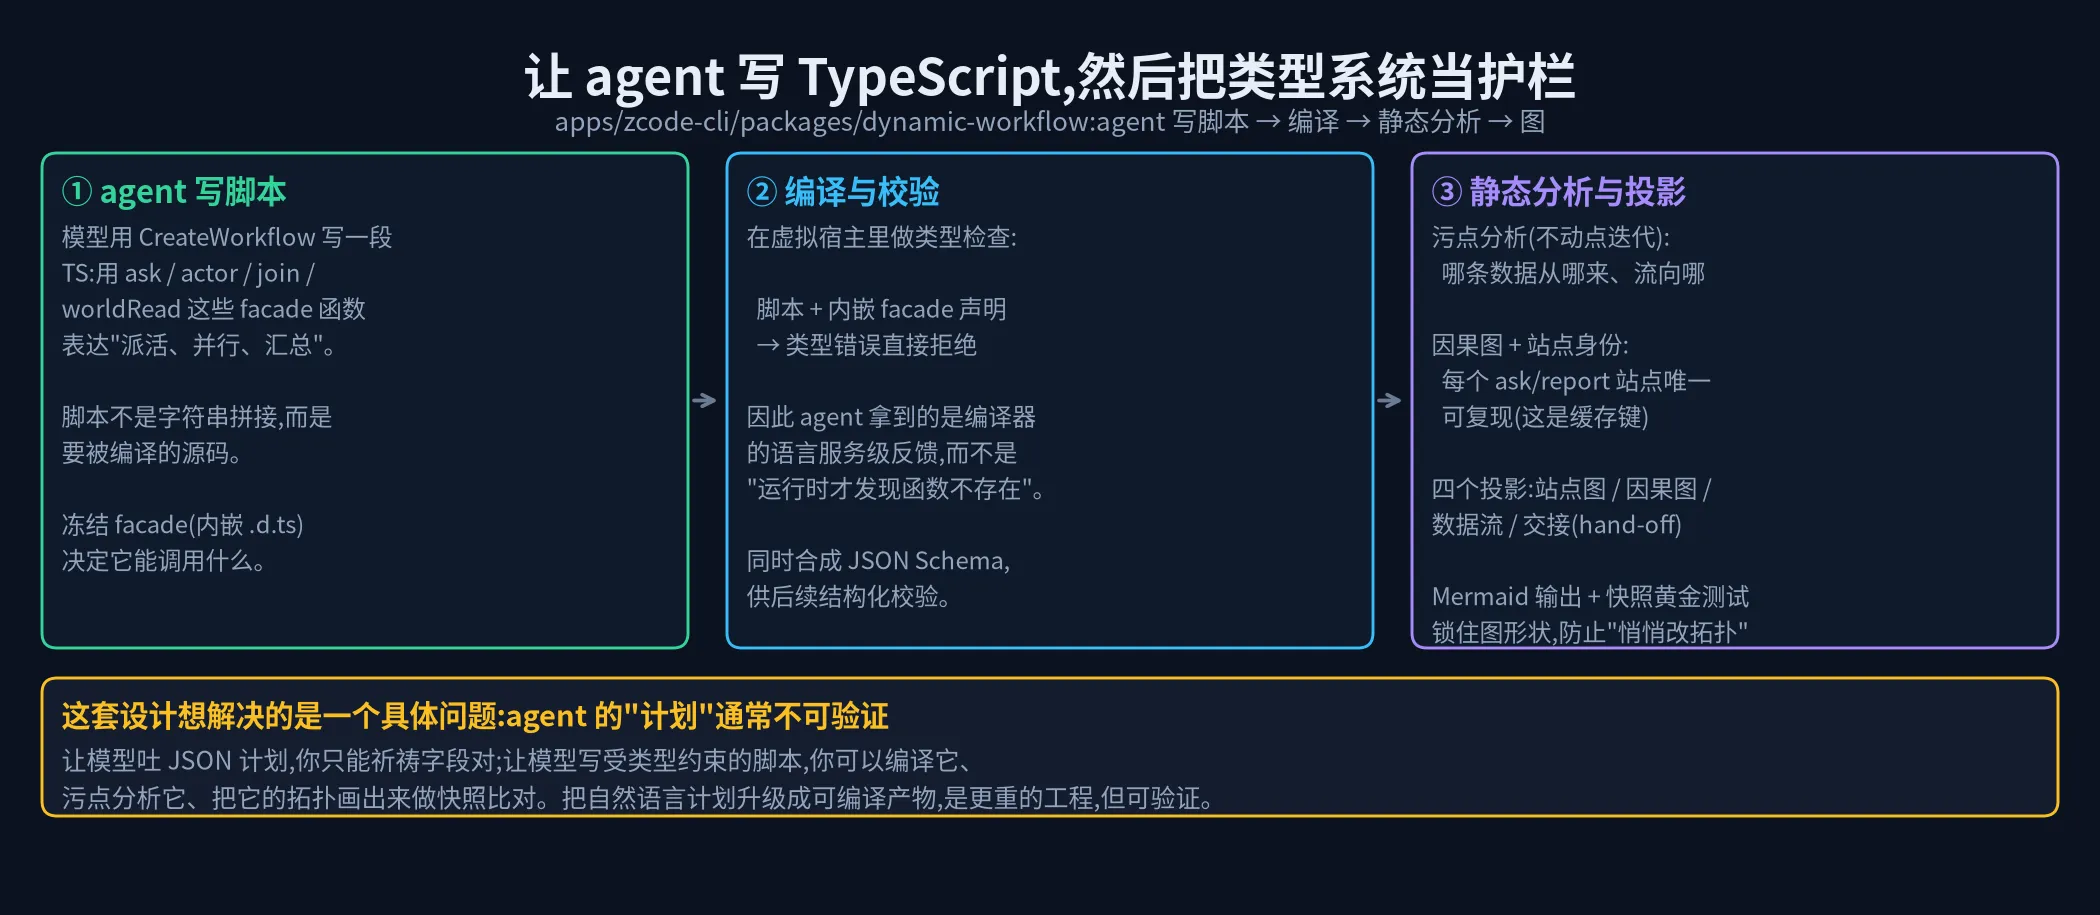
工作流脚本要用一组固定的 facade 函数来表达协作,这些函数的类型声明被内嵌在包里(facade/dts.ts),在虚拟宿主里和脚本一起做类型检查 —— 也就是说,模型写错函数名或参数,得到的是编译器的报错,不是运行时的惊喜。facade 的文档本身就是设计说明书,而且写得相当讲究。比如 agent(name) —— 它解释了为什么”名字”不是标签:
/**
 * Create a fresh actor. ...
 *
 * The name is optional, but a non-empty one is an identity, not a label. It must be
 * unique within the run: two actors under the same name fail the whole run. It is
 * also the key a revised re-run matches its cache on (AmendWorkflow imports the
 * finished work of each named actor), so stable, meaningful names carry work across
 * script revisions. Anonymous actors are legal and never reuse imported work.
 *
 * In a fan-out or a loop each iteration is a separate actor, so a single static name
 * there is the duplicate case: give each one its own name ... or leave them all
 * anonymous. A literal name in a loop is reported when the script is compiled; a
 * computed one fails at run time.
 */
declare function agent(name?: string, persona?: string | AgentPersona): Agent;一个”名字”同时承担了五件事:运行内唯一性、重跑时的缓存键、修订版脚本导入旧成果的凭据、循环展开时的重复检测、以及运行面板上的标签。而且它把两种错误分在了两个时间点:字面量重名在编译期报,计算出来的重名在运行期失败 —— 能做到这一点,是因为编译期能看见字面量。
另一个我读完想抄进自己项目的注释,是 report() 存在的理由:
Unlike log() it is journaled: a resumed run never shows the same item twice, and the items are delivered with the completion notification even when the run ends in failure. That is the point of it — a run that dies on its twelfth of forty tasks still did eleven tasks’ worth of work, and reported items are how that work survives.
(大意:一次在四十个任务里死在第十二个的运行,依然完成了十一个任务的工作量,而 report 就是让这些工作”活下来”的方式。)
长任务的中间成果必须被当作一等公民持久化。 这句话我读过很多遍,但很少见到哪个框架把它写进 API 文档里。
编译通过之后,真正的重活在静态分析里。工作流脚本会被拆成四张图:
- 站点图:每一个
ask/report/actor调用是一个 site,有稳定身份(这就是重跑时复用的缓存键); - 因果图:谁的数据流到了谁;
- 数据流(污点分析):用不动点迭代算出”哪条数据来自哪个站点”,从而知道哪些结论依赖哪些输入;
- 交接(hand-off):子 agent / 演员之间的任务传递边界。
四张图可以导出 Mermaid,而且有快照黄金测试锁住图形状 —— 拓扑结构一旦改变,测试会失败,而不是悄悄生效。这一步在很多”AI 编排”项目里是完全没有的:工作流跑起来看起来对,但没人知道它的形状变了没有。
我读这一节时的感受是:这套设计把”agent 的计划”从一次性的自然语言,升级成了一份可编译、可分析、可版本管理的产物。 代价很实在(要维护 facade 类型、编译器、分析器、快照),收益是”计划”第一次变得可以审查。
六、UI 与 agent 之间的协议:故意的”表达力不足”#
前五节都在讲 agent 内部。这一节讲一个很容易被忽略、却决定客户端稳定性的东西:服务端往界面推状态的那套协议。
ZCode 的协议版本化在 packages/shared/src/zcode-protocol-v4。它由三件套组成:ConversationRow(会话行)、StatePatch(状态增量)、snapshot(全量快照)。规则很少,但每条都在约束自己:
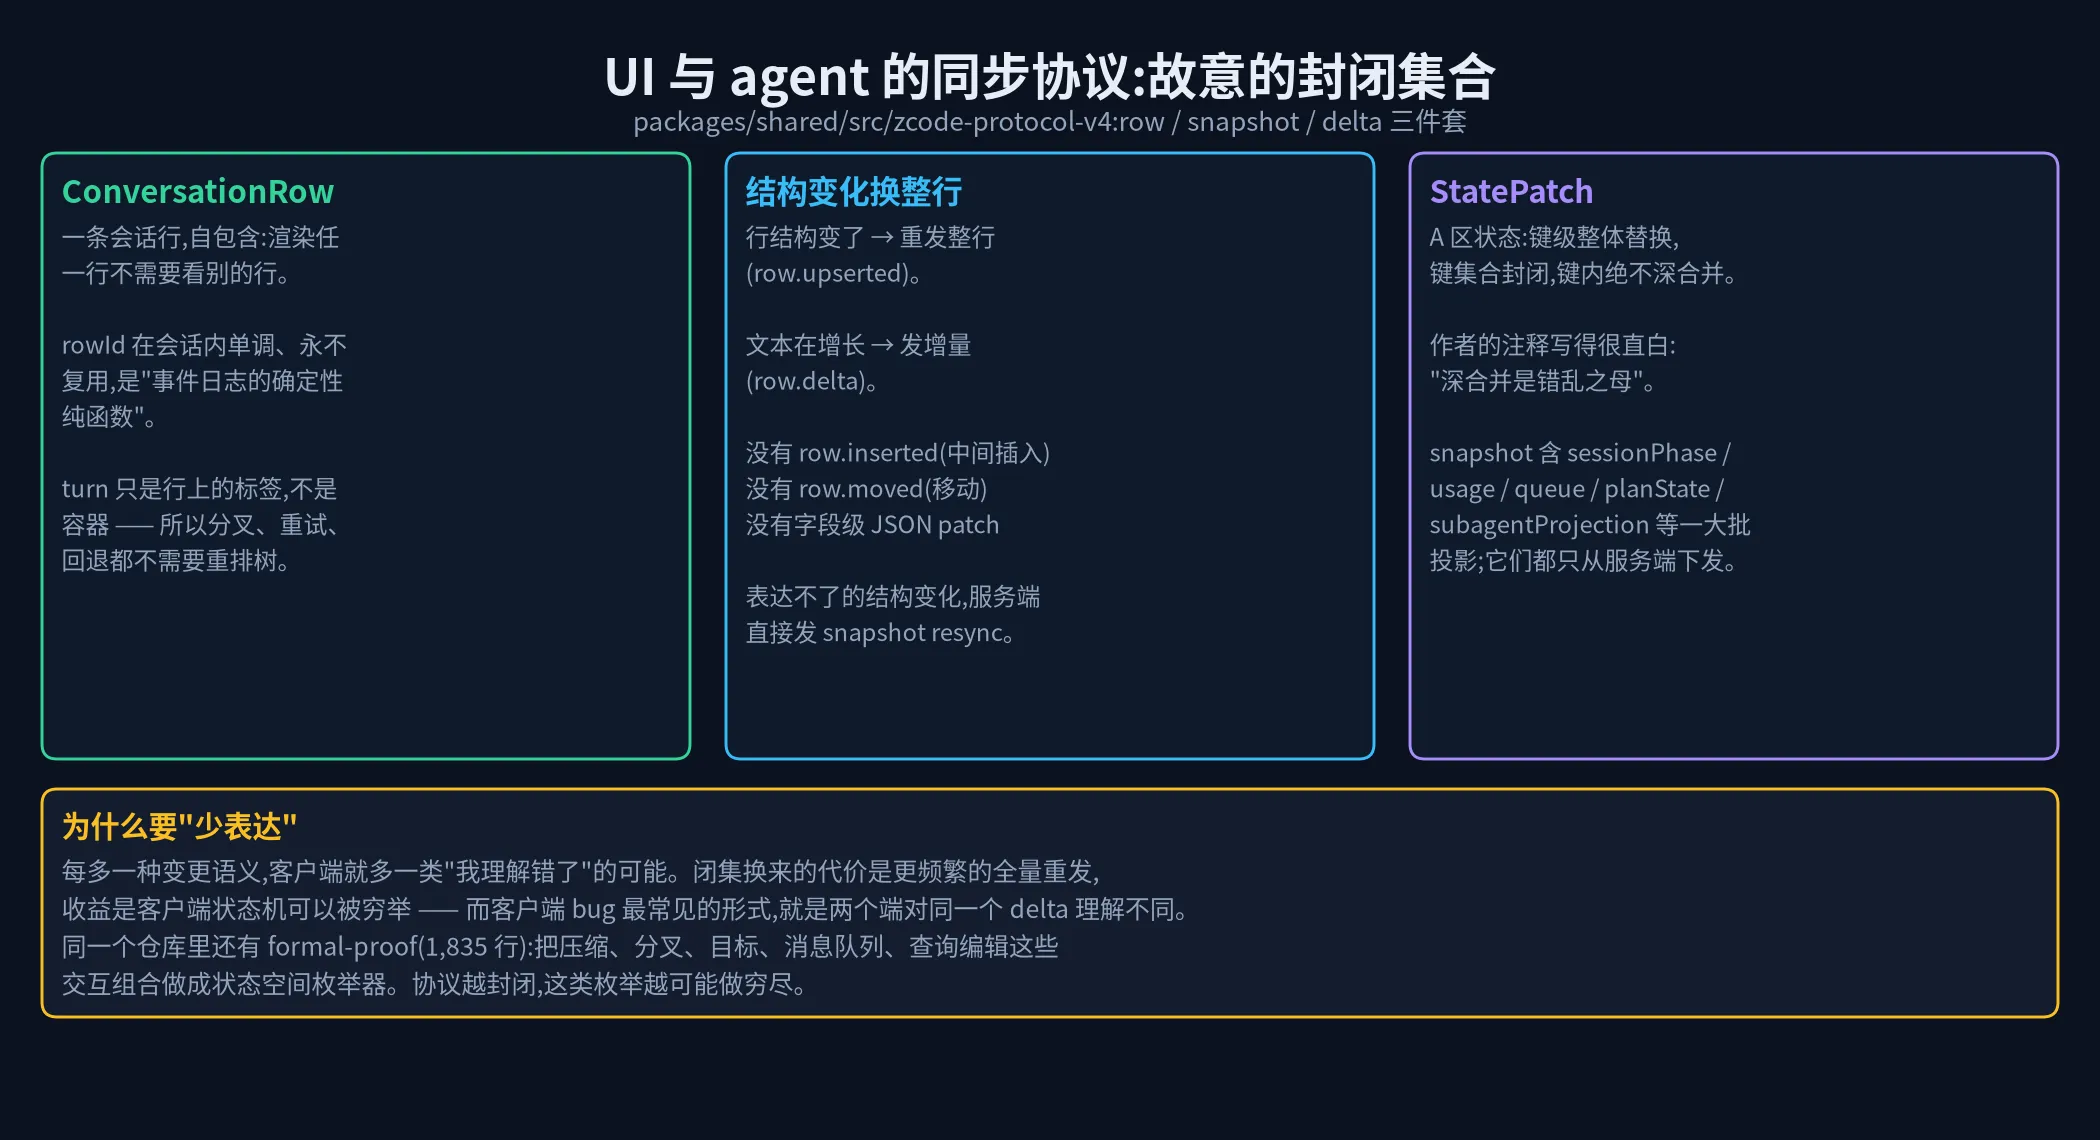
第一,行是自包含的。 一条 ConversationRow 能独立渲染,不需要”先看别的行”。这不是洁癖,而是流式场景的硬要求:模型边写边出,客户端必须能在只拿到一条行的情况下把它画出来。
第二,行身份永不复用。 rowId 在会话内单调递增,永不复用 —— 于是”事件日志”变成了确定性纯函数,重放能得到同样的结果。
第三,结构变化换整行,文本增长发增量。 一条行如果结构变了(多了工具调用块、状态从 pending 变 done),就重发整行;如果只是正文变长了,就发一个字符串增量。
第四 —— 也是最关键的 —— 变更语义是个封闭集合。 协议里没有 row.inserted(中间插入)、没有 row.moved(移动)、没有字段级 JSON patch。注释里的理由是:
Anything the model can’t express → server sends snapshot resync.
翻译过来就是:“你说得比我多”不是能力,是负担。 每多一种变更语义,客户端就多一类”我理解错了”的可能。凡是闭集表达不了的变化,服务端直接重发一份快照 —— 用带宽换正确性。
同一份文件里还有一句让我笑出来的话,关于状态键的合并策略:
// 深合并是错乱之母。
// 键级整体替换,且键集合封闭。“深合并是错乱之母” —— 任何一个调试过两个端状态不一致的人都该把这句话打印出来贴在显示器上。
有意思的是,这个仓库里还有 packages/formal-proof(1,835 行):一个专门枚举产品行为状态空间的形式化测试工具,覆盖压缩、分叉、目标、消息队列、查询编辑这些交互的组合。协议越封闭,这类枚举越可能做到穷尽 —— 这两件事是一个思路的两面:先把状态空间压小,再证明它没有意外。
七、架构治理:一套真的会拦人的规则#
如果前面几节讲的是”agent 怎么干活”,这一节讲的是”人(和 agent)怎么改这个仓库”。这是我读这份代码最大的意外收获。
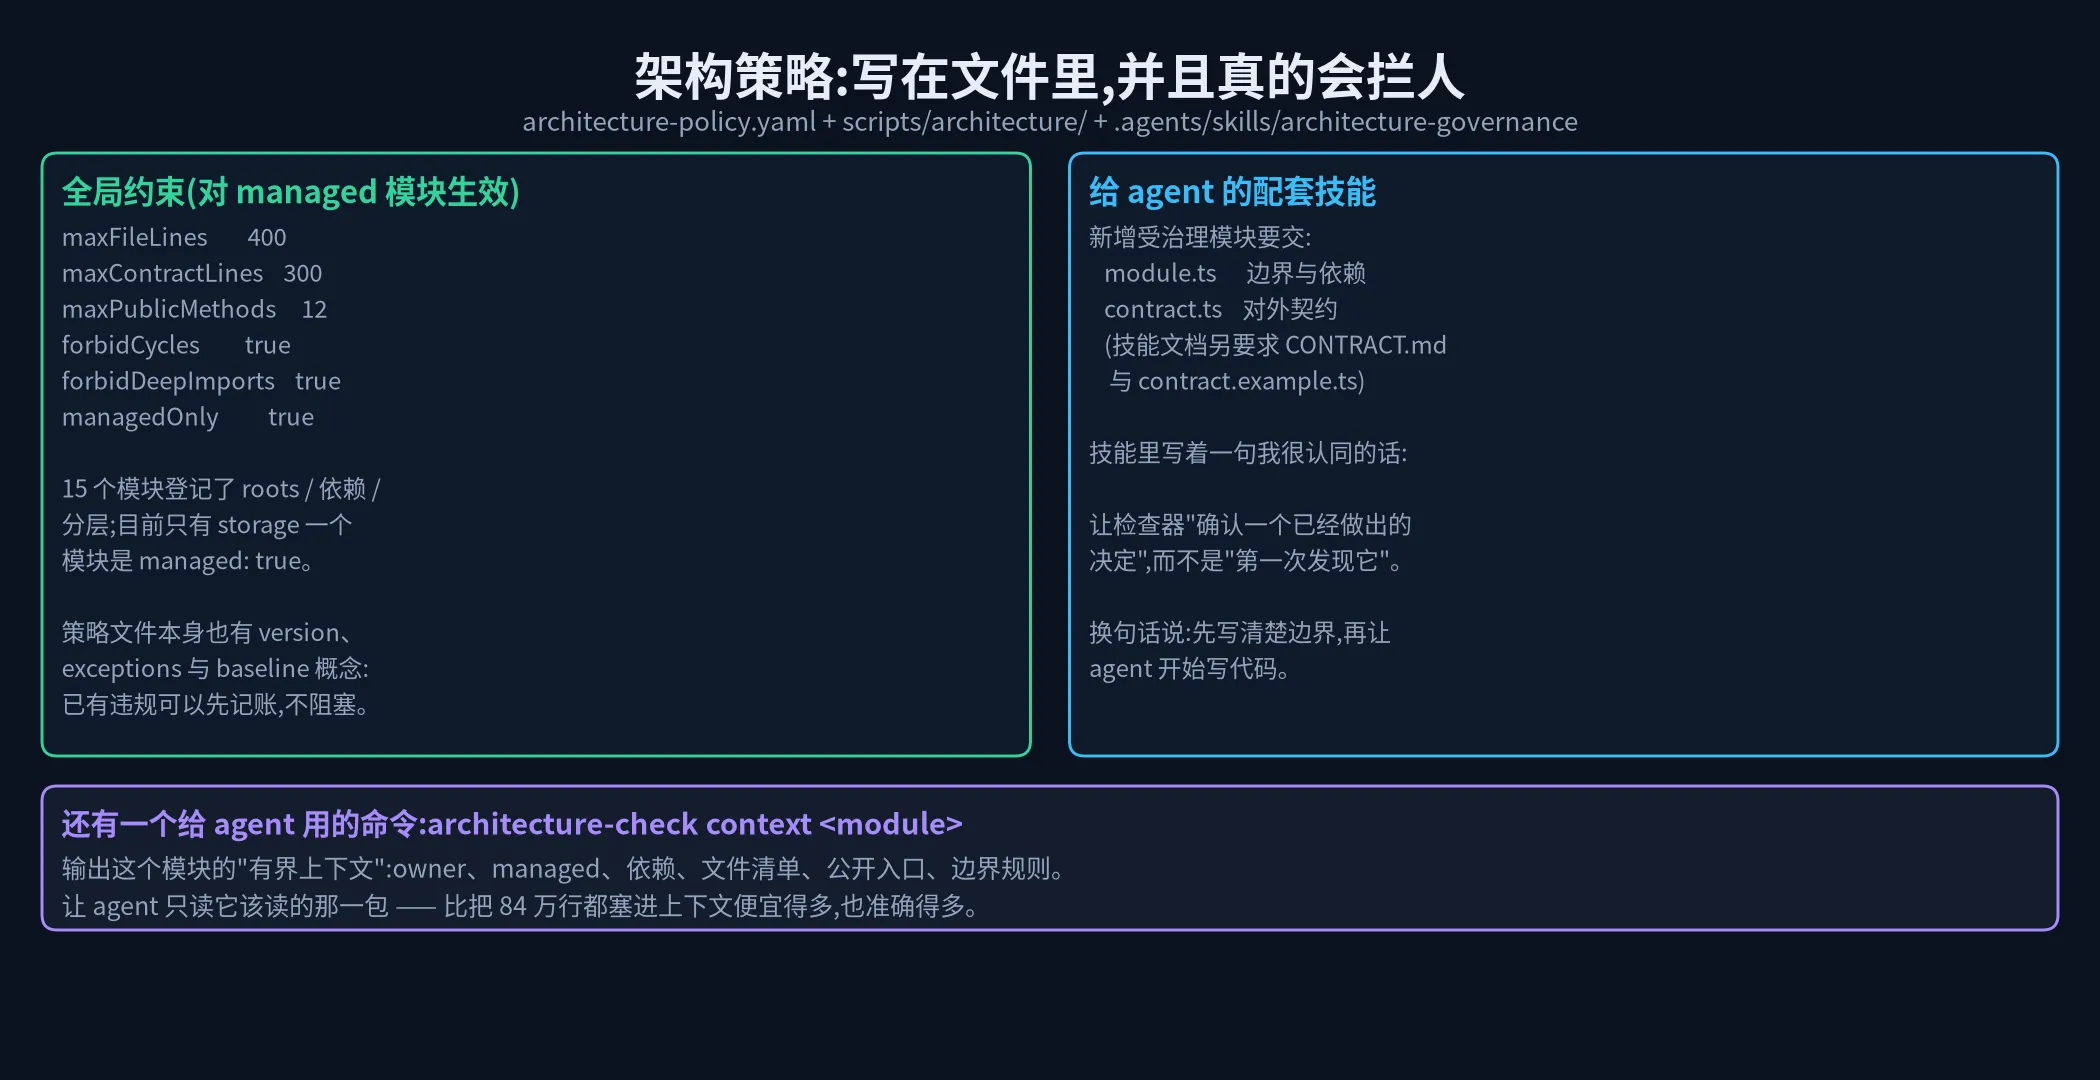
仓库根目录有一份 architecture-policy.yaml,内容是 15 个模块的边界声明,外加一组全局约束:
maxFileLines: 400        # 单文件行数上限
maxContractLines: 300    # 契约文件行数上限
maxPublicMethods: 12     # 单类公开方法上限
forbidCycles: true       # 禁止循环依赖
forbidDeepImports: true  # 禁止越过公开入口的深引用
managedOnly: true # 只对 managed: true 的模块生效配套的是 scripts/architecture/ 下的检查器,以及一份专门写给 AI agent 的技能文档 .agents/skills/architecture-governance/SKILL.md。技能文档里有一句话我很认同:
让检查器”确认一个已经做出的决定”,而不是”第一次发现它”。
换句话说:先写清楚边界(module.ts 说边界与依赖,contract.ts 说对外契约),再让 agent 开始写代码。
我把它跑起来了,还注入了两种违规#
文档说得再好,不如看它会不会真的拦人。所以我做了两组实验(仓库里带了完整的 typescript 依赖,补装即可运行):
实验一:在有界模块里塞一个 580 行的文件。
$ node scripts/architecture/architecture-check.mjs
architecture: FAILED
violations: 1
baseline: 0
new: 1
- max-file-lines .../storage/domain/zzProbe.ts: 文件 581 行,超过上限 400 行删掉文件重新跑:violations: 0 baseline: 0 new: 0。
实验二:让 domain 层反向依赖 adapters 层。
我在 storage/domain/cleanPlan.ts 顶部加了一行 import ... from "../adapters/rootsResolver.js":
architecture: FAILED
violations: 2  new: 2
- layer-direction .../domain/cleanPlan.ts: 层 domain 不能依赖更高层 adapters
- cycle .../app/ports.ts → .../domain/cleanPlan.ts → .../adapters/rootsResolver.ts → .../app/ports.ts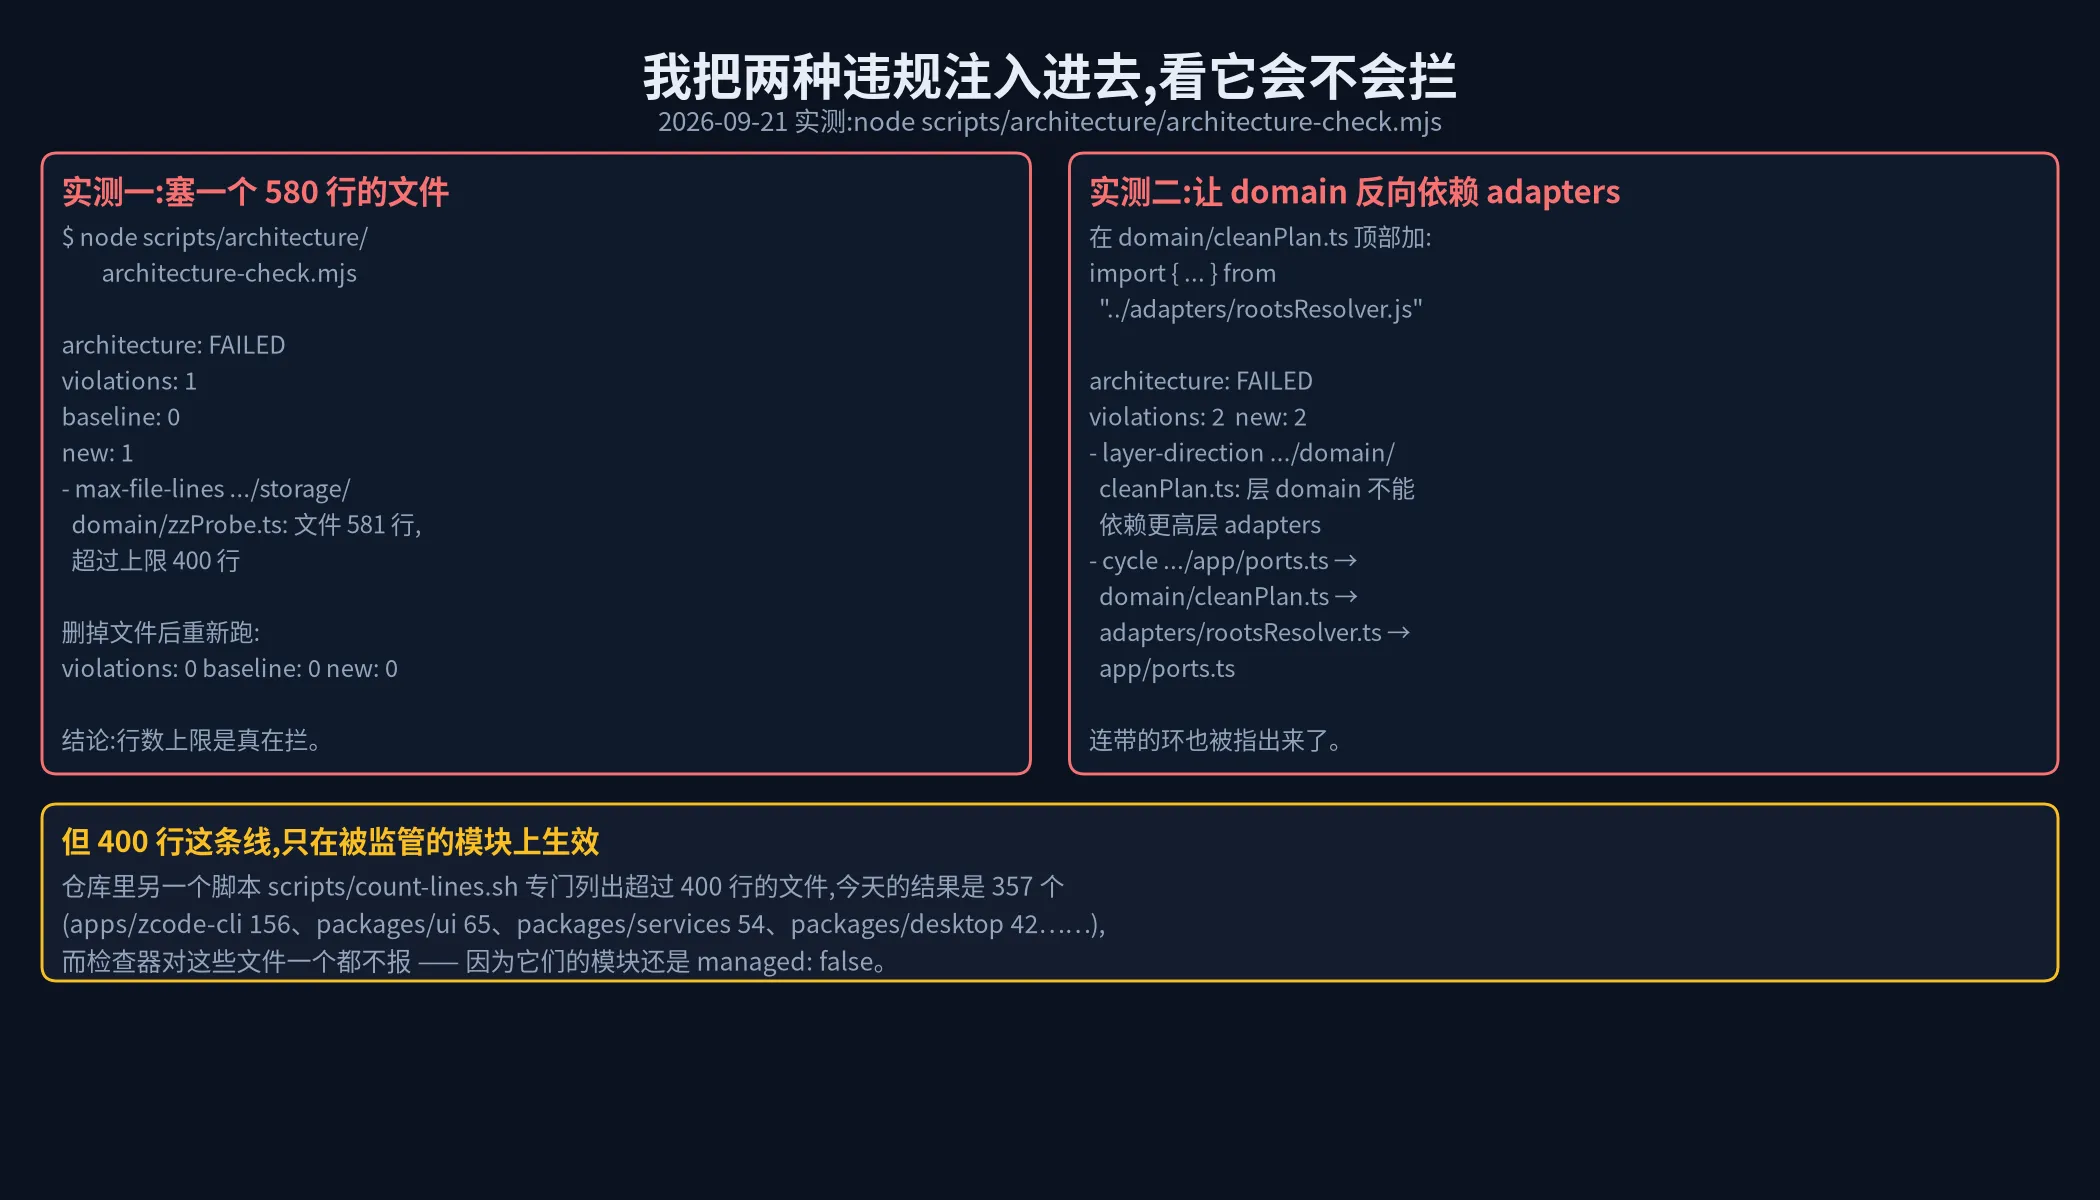
注意第二条:它不只报了跨层引用,还把我这一行引入的循环依赖连根挖出来,把环上的路径完整打印了。 一个只做正则匹配的检查器给不出这个结果 —— 它得真的建了依赖图。
这个检查器还挂进了本地流程:根 package.json 里 verify:pre-push = lint + architecture:check --changed,加上 husky 钩子,推代码前先过一遍。
但这里也有一处我很喜欢的”现实”#
maxFileLines: 400 这条线,只在 managed: true 的模块上生效。15 个模块里,目前只有 storage 一个是 managed: true。
我用仓库自带的另一个脚本 scripts/count-lines.sh(专为列出超 400 行文件而写)数了一遍:今天有 357 个文件超过 400 行(apps/zcode-cli 156 个、packages/ui 65 个、packages/services 54 个、packages/desktop 42 个……),而检查器对这些文件一个都不报 —— 因为它们的模块还是 managed: false。
这处细节我认为比”他们有一个严格的架构检查器”更有信息量。它说明了治理落地的真实路径:
- 先把边界画出来(15 个模块全登记),让所有人心里有图;
- 挑一个模块真正开始强制(
storage:分层domain / app / adapters,配module.ts+contract.ts),用小范围验证规则本身合理; - 其余的留白,
managed: false豁免,不阻塞日常提交; - 已有违规还有
baseline机制兜住,不要求”一天之内全部还清”。
把规则写满、把执行分阶段,这种”理想主义 + 现实主义”的配比,是能长期活着的那一种。 我见过的半途而废的架构治理,几乎都是反过来:规则写得含糊,却想一次强制到底。
另外还有一个给 agent 用的命令值得一提:
$ node scripts/architecture/architecture-check.mjs context storage
# Architecture context: storage
owner: desktop-settings
managed: true
requires: shared, rpc, services
...
## Boundaries
- Cross-module imports must use declared requirements and public entrypoints.context 会输出这个模块的”有界上下文”:它归谁管、依赖谁、有哪些文件、公开入口在哪、边界规则是什么。这样 agent 去改一个包之前,只需要读它该读的那一包,而不是把 84 万行都塞进上下文。给 agent 设计”该看什么”,比给它更大的窗口更划算。
八、一个把商业模型缝进 harness 的地方#
读到这里,你可能已经注意到一件事:这份代码里有很多”不该出现在开源 CLI 里”的东西。
最典型的是 OffPeak(闲时派发)。工具列表里有 OffPeakCreate / OffPeakList,意思是:把一批任务标记成”低峰时段再跑”。它的实现里有一段注释,把”拒绝边界”拆成了两层:
- 会话级 deny 名单(用户显式拒绝过这类任务);
- 工具级第二道判定(配额、资格);
并且区分了错误码:3103 是配额类错误,3101 是资格类错误 —— 两类都进 deny 名单,但原因不同。这是一个和”订阅额度”强耦合的功能:它存在的意义就是让用户在便宜的时段消耗算力。
同样入口明显的还有:
packages/services/src/coding-plan-subscription:订阅计费的服务层,内部按渠道拆成两个 provider —— 国内走 BigModel(支付宝),海外走 Z.ai(Stripe / PayPal),包含下单、支付检查、绑定/解绑、企业采购等接口;packages/services/src/usage-stats:用量统计(按 provider 拆分);packages/services/src/credential/oauth:凭证与登录;packages/model-option-map:一个自研的受限 CEL 求值器(词法、语法、求值三段齐备),用来表达”哪个模型在哪个套餐下开放哪些选项”这类映射规则。
最后这个包我很想单独说一句:为了一类”模型选项可用性”的规则,他们写了一个小语言。 听起来过度设计,但换个角度想:这些规则会随套餐和地区频繁变化,写成代码就要发版;写成一个小表达式语言,就能当作数据下发和热更新。在合适的边界上引入一门小语言,是”配置过于复杂”的正解,而不是反模式。
这些设计带来的判断是:ZCode 不是一个”纯技术演示”,而是一个在售产品的引擎。 好处是它的每一处设计都挨过真实用户;代价是它带着产品的形状 —— 你如果要把它当框架用,得接受里面这些商业耦合(或者至少知道它们在那儿)。
九、几处诚实的地方#
一篇只夸的文章没有信息量。这一节讲我在这个仓库里看到的”减法”和坦白 —— 我认为它们比加分项更能说明这个团队怎么工作。
第一,zcode-cua 是一个 fail-closed 的占位包。
@zcode/zcode-cua 这个包(585 行,几乎全是 .d.ts 声明加同名占位 .js)把自己的身份写在 README 第一行:
API-compatible placeholder package for Computer Use. This build ships without Computer Use: every runtime surface (Computer Use runtime, broker RPC, Helper install/launch/verify, PiP session client, native addon loader) reports unavailable and fails closed, predicates about official CUA frames are
false, and permission ports keep their privacy fail-closed semantics.
也就是说:Computer Use 的整套接口都还在(类型、契约、权限端口一应俱全),但每一个实现都返回”不可用”,并且是”失败即关闭”而不是”降级凑合”。判定官方 CUA 帧的函数一律返回 false。
第二,browser-use-plugin 走了一条更硬的路。
主流方案是给模型一堆浏览器工具(click / type / screenshot)。它没有。它给了模型一个 JavaScript REPL:模型写 JS 调 playwright API,由 node-repl-host 执行。更有意思的是执行模型 —— 每次调用都在一个全新的内核里跑。
这意味着状态不能靠 JS 变量传递,必须每次重新推导(这也解释了为什么它的 API 里到处都是”重新获取当前标签页”这类函数)。限制很大,但它换来两件事:模型可以用循环、条件、函数表达自动化,而不是靠一次次工具调用来排列组合;而且每次执行都是确定性的、可复现的。这是个典型的”把表达力交给语言、把复杂度留给运行时”的选择。
第三,他们连产品交互都拿去枚举了。
packages/formal-proof 只有 3 个文件(其中一个还是样式表),1,835 行,做的是:把压缩、分叉、目标、消息队列、查询编辑这些功能的状态空间枚举出来,检查组合起来有没有非法状态。
一个 UI 团队愿意为一个”帮我看看这些按钮组合起来会不会出事”的内部工具花时间写状态机模型,说明他们的 bug 主要不是来自算法,而是来自交互组合。这个判断,我觉得很准。
第四,坦白地说,也有一些你看不到的东西。
- 公开快照里没有 CI 定义(没有
.github/目录),虽然.gitignore里提到过一个内部脚本scripts/ci/ci-repo-hygiene.mjs(“在 CI 第一站拒绝”混入的构建产物)—— 也就是说,那套门禁在公开仓库里不会自动跑,架构检查得你手动执行; - 测试文件在公开快照里只剩 4 个(命名还带着
nonCliAcpRetirement、importedClaudeRecovery这种内部演进的痕迹),而dynamic-workflow的 README 明确提到了基于 fixture 的编译器测试套件 —— 那套 fixture 没有跟着开源; - git 历史只有两次提交,没有演进过程。你读到的是一份”结论快照”,不是一段”思考过程”。
这三条不构成批评,而是阅读时的边界:你没法从这份代码里学到”他们怎么一步步走到这里的”,只能看到”他们最后停在了哪里”。
十、那么,这份代码里有什么值得带走#
我读完记下七条,前四条是设计,后三条是判断。
① 把”计划”变成可编译的产物。 让模型吐自然语言计划,你无法验证;让它写受类型约束的脚本,你可以编译它、做污点分析、把它画成图、用快照锁住形状。dynamic-workflow 这条路很重,但它把 agent 编排从”祈祷”推到了”审查”。
② 上下文压缩分层:清空 → 摘要 → 重开。 优先级从免费到昂贵。判断标准应该是”这次优化值不值这个代价” —— 所以微压缩里有 MIN_TOKENS_SAVED = 256 这样的门槛,而不是能省就省。
③ 把”能不能并发”从模型的语言推理,转移到工具的静态声明。 模型一次要求读 20 个文件时,不该由它来判断哪些能并行;readOnly / sideEffectScope 这些声明在编译期就写好了,调度器按它们分组。
④ 协议的”表达力”要克制。 变更语义做成闭集,表达不了的直接全量重发。“深合并是错乱之母” —— 两端口径不一致的 bug,十有八九是从”我们支持一种很灵活的合并”开始的。
⑤ 治理要写满、执行要分阶段。 15 个模块先登记边界,只有 1 个进入强制;其余靠 managed: false 豁免,已有违规用 baseline 记账。理想主义的规则 + 现实主义的节奏,才活得下去。
⑥ 给 agent 的”该看什么”,比给它”更大的窗口”更值钱。 context <module> 输出的是一个包的有界上下文,而不是整个仓库。
⑦ 承认不确定,而不是假装能跑。 一个明确失败的占位包,比一个半吊子实现更专业。这条大概是全篇里我最想复述的一句。
结语#
回到开头那个问题:编码 agent 这个赛道已经挤满了,为什么这份代码值得读?
因为它是一份**“做完之后”的清单**。前端、后端、桌面、协议、编译、静态分析、架构治理 —— 它没有把”做一个 agent”简化成”包一层 API 调模型”,而是老老实实地把每一层都做了一个够用的版本,然后在几处地方做到了深(状态机、压缩分层、工作流编译、架构门禁)。
它也有代价。84 万行 TypeScript 意味着极重的依赖与构建链,商业耦合意味着它带着产品的形状,单次提交的历史意味着你看不到它的来路。
但如果你正在写自己的 agent harness,这份代码最有用的地方不在于”抄哪一段”,而在于它给了你一张清单:原来这里有这么多事情要做。你不需要都做,但你应该知道它们存在 —— 然后决定哪几件是你此刻真正需要的。
至于 Z.ai 为什么要在 2026 年 9 月一次性开源这个 —— 我想答案就在同期的仓库列表里:GLM-5(7,209★,“From Vibe Coding to Agentic Engineering”)、zcode-plugins(插件市场)、feedback(ZCode 用户建议收集)。先有模型,再有 harness,再有插件生态。 开源 harness 是这条链子上最便宜、也最容易让人动手写插件的一环。
附:本文所有代码引用来自
zai-org/ZCode的main分支快照(2026-09-20 开源版本,产品版本 3.14.0)。架构检查的两次实验在 2026-09-21 于本地完成,命令与输出为原始记录;文中引用的英文注释保留原文,并附中文大意。图片中:架构示意与流程图由我绘制,应用图标、GLM 图标与安装包美术来自仓库自带的品牌资源。