AERIS-10:一个人怎么把 10.5 GHz 相控阵雷达做到 GitHub 25k Star
💬 评论拆解 NawfalMotii79/PLFM_RADAR · 摩洛哥工程师开源的 PLFM 相控阵雷达:PLFM chirp 时序、FPGA 接收链路、跨层 AGC、STM32 上电序列、Python V7 上位机。
我先把这篇文章不打算怎么写讲清楚。
它不会像大多数雷达科普那样从「电磁波反射」或者「多普勒效应」铺开。 你搜 AERIS-10 任何一篇外文拆解,大概率上来就是「the radar equation is P_r = …」然后给你堆积分公式。 那不是我要写的。 这个仓库不是个论文复现,是一个摩洛哥小哥(Nawfal Motii,ABAC INDUSTRY)从画板到 commit 一个人做了 8 个月的工程产物,把它当论文拆,你会丢掉 90% 的工程信号。
我打算这样组织:从「这条 chirp 长什么样」开始,因为脉冲时序是整个系统的源头设计;然后顺着信号流往下走,到 FPGA 接收链路、跨层 AGC、STM32 上电序列,最后给点私货,讲哪些决策我觉得牛,哪些我觉得 over-engineered。
代码我挑着读了大约 30 个文件,核心模块是 9_Firmware/9_2_FPGA/radar_mode_controller.v(控制 PLFM 时序)、matched_filter_processing_chain.v(脉冲压缩核心)、fft_engine.v(自写 radix-2 FFT)、ADAR1000_AGC.h(跨层 AGC 外环)、STM32 main.cpp 里的上电段。 你要是看完整 4 万行 FPGA 代码我建议先喝杯咖啡。
第一件事:这个 chirp 不是普通的 chirp#
AERIS-10 用的是 PLFM(Pulse Linear Frequency Modulated),不是普通的 FMCW。 区别在哪儿? 普通的 FMCW 一个脉冲周期内连续扫频,听起来就一个调频连续波;PLFM 把一个长 chirp 后面再跟一个短 chirp,中间用 listen window 收回波,listen 之间还有 guard 间隔防收发串扰。
打开 9_Firmware/9_2_FPGA/radar_mode_controller.v,看最顶上的注释就知道 Nawfal 怎么定的时序:
Long chirp:   30 µs   = 3000  cycles @ 100 MHz
Long listen:  137 µs  = 13700 cycles
Guard:        175.4 µs = 17540 cycles
Short chirp:  0.5 µs  = 50    cycles
Short listen: 174.5 µs = 17450 cycles所以一个完整的 PLFM 周期是 ~516.9 µs。 长+短不是 redundant,是有明确分工的:长 chirp 时宽带宽积大,SNR 高,适合远距弱目标;短 chirp 距离分辨率高,适合近距离。 距离模糊(长 chirp 副瓣盖住近目标)用短 chirp 解。
[配图建议: 单个 chirp 周期的时序图,标出 long chirp 30µs + long listen 137µs + guard 175.4µs + short chirp 0.5µs + short listen 174.5µs 的相对比例;右侧用黑条说明「为什么长+短不能合并」]
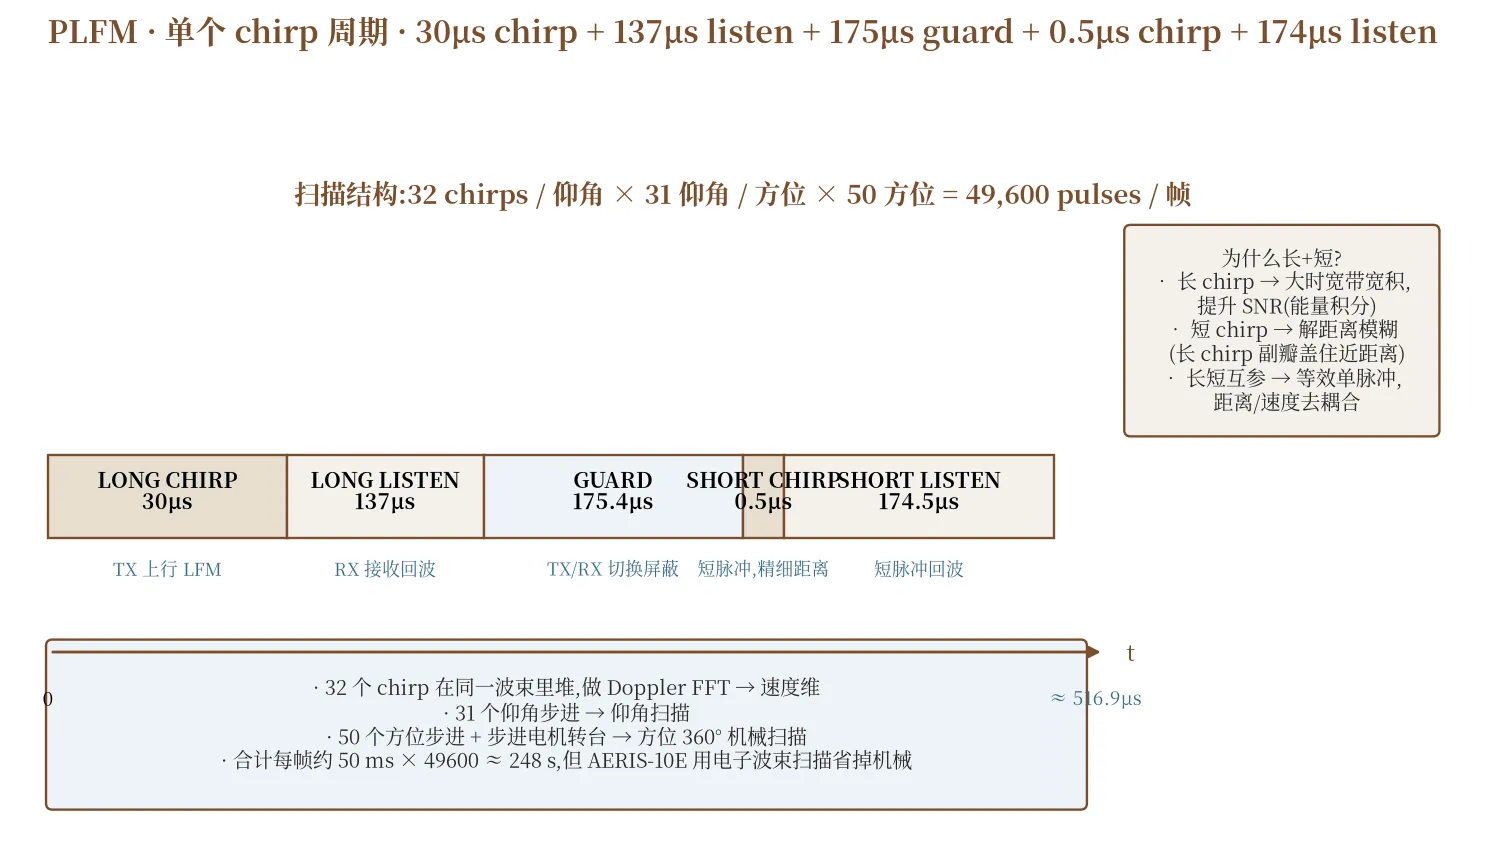
扫描结构是 32 个 chirp 同波位堆起来做 Doppler FFT(速度维)→ 切下一个仰角(31 步)→ 切下一个方位(50 步),每帧 49600 个脉冲。 AERIS-10E 用电子波束扫,省掉机械转台那 360° 转一圈的 248 秒(理论值,实际有 DSP 开销);AERIS-10N 没电子扫描,所以靠步进电机转,这是 3km 版本和 20km 版本最根本的硬件分歧。
值得停下来多说一句 — radar_mode_controller.v 注释里写了一句「Gap 2:Runtime-configurable timing inputs from host USB commands」。 这是个细节但我觉得挺关键:长 chirp 周期、listen 周期这些本来是 Verilog parameter,改一下要重综合(几小时)。 现在 STM32 可以通过 USB 把 cfg_long_chirp_cycles 等 6 个 16-bit 配置写到模块里,意味着同一份 bitstream 可以跑不同波形(短距模式、远距模式、debug 模式),不需要为每个 case 单独 VFP。 调试时这是救命的功能。
第二件事:FPGA 接收链路是这整个仓库 80% 的代码#
9_Firmware/9_2_FPGA/ 这个目录塞了 303 个文件,4.3 万行 Verilog,核心链路 11 个模块。 从 ADC 进来一路到 CFAR 检测,大致是这样:
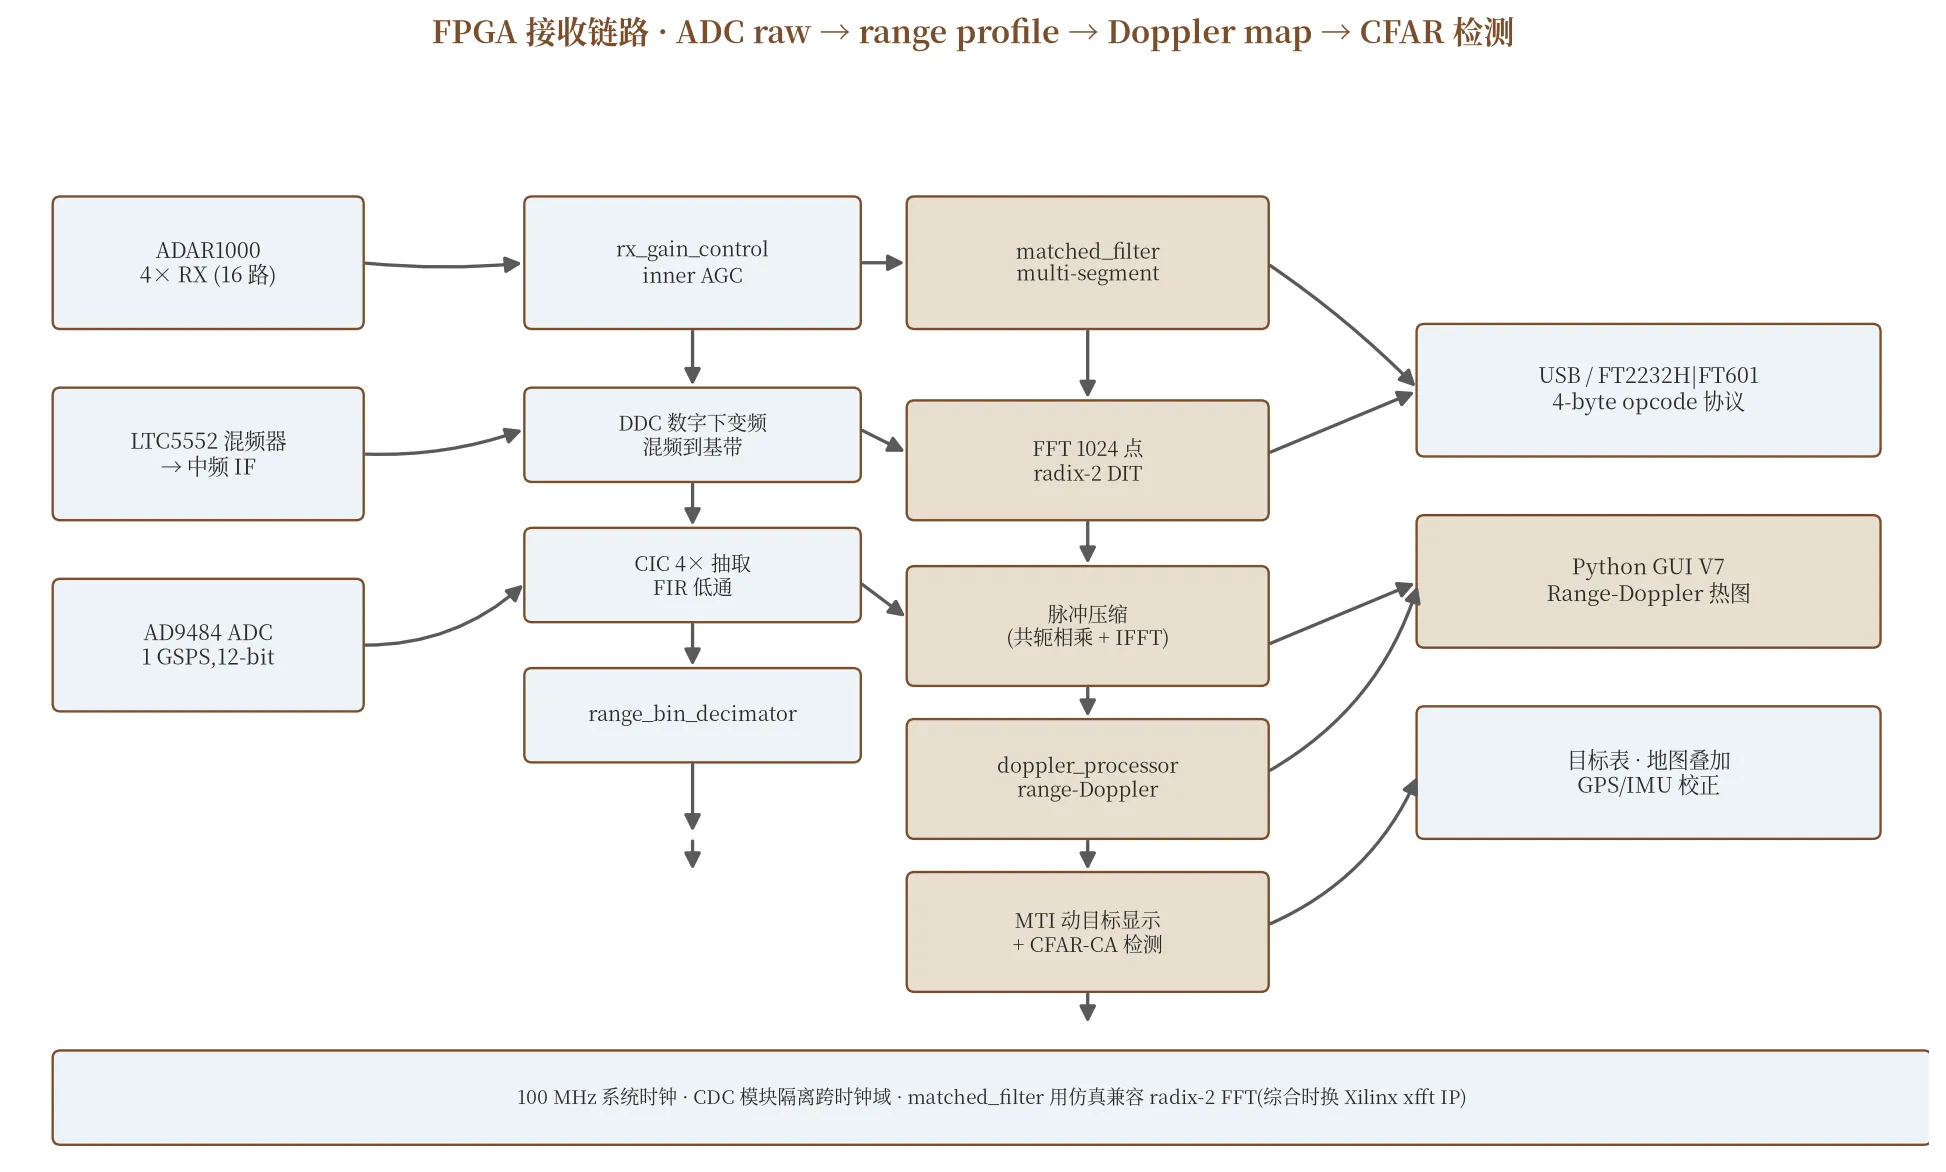
我挑两个最有意思的讲。
matched_filter_processing_chain.v · 脉冲压缩这件事#
脉冲压缩的本质是 FFT(signal) × FFT(reference) 的共轭 + IFFT,在频域做点乘。 工程实现上,signal 那路要先收齐 1024 个样本(等一个完整 chirp 周期的回波),然后做正向 FFT;reference 那路是本地生成的发射副本,提前在 ROM 里 bit-reverse 存好,直接读取做正向 FFT;两路相乘后做 IFFT + 1/N 缩放,output 1024 个 range bin。
matched_filter_processing_chain.v 里这个状态机写得很有意思 — 9 个显式 state(IDLE / FWD_FFT / FWD_BUTTERFLY / REF_BITREV / REF_BUTTERFLY / MULTIPLY / INV_BITREV / INV_BUTTERFLY / OUTPUT),完全同步,每个 state 严格只做一件事:
ST_IDLE          = 4'd0
ST_FWD_FFT       = 4'd1   // Collect samples + bit-reverse
ST_FWD_BUTTERFLY = 4'd2   // Signal FFT butterflies
ST_REF_BITREV    = 4'd3   // Bit-reverse copy reference
ST_REF_BUTTERFLY = 4'd4   // Reference FFT butterflies
ST_MULTIPLY      = 4'd5   // Conjugate multiply
ST_INV_BITREV    = 4'd6   // Bit-reverse copy product
ST_INV_BUTTERFLY = 4'd7   // IFFT butterflies + scale
ST_OUTPUT        = 4'd8   // Stream results
ST_DONE = 4'd9我承认刚看的时候第一反应是「这也太重了,直接用 Xilinx xfft IP 不香吗」。 文件头注释解释了原因:
This is a SIMULATION-COMPATIBLE implementation that replaces the Xilinx
FFT IP cores (FFT_enhanced) with behavioral Radix-2 DIT FFT engines.
For synthesis, replace the behavioral FFT instances with the actual
Xilinx xfft IP blocks.意思是 simulator 跑的是自写 radix-2,综合时换成 Xilinx 商业 IP。 这是非常工程的做法 — 自写版本可以在 Icarus Verilog / 通用 simulator 跑,做 unit testbench 校验算法正确性;Xilinx IP 是闭源 blackbox,你只能 verify 接口 contract,不能 verify 算出来的 range bin 数到底对不对。
不过我看到 fft_engine.v 那一段 4-cycle 流水线(BF_READ → BF_TW → BF_MULT2 → BF_WRITE)的写法有点过头。 它用了纯寄存器搬运,DSP 调用全锁在 BF_MULT2 这 1 个 cycle,理论上 Xilinx XC7A50T 的 DSP48E1 是 25×18 multiply,这里 16×16 multiply + add 是够用的。 但 README 里说这是 synth-ready 的,实际上没看到任何 synthesis 报告或 post-implementation timing 报告提交到仓库。 我对这块能不能跑 100MHz 没把握,具体上板才知道。 这不算吐槽,只是我觉得如果你打算让人用,你至少得加一个 9_Firmware/9_2_FPGA/reports/(注意 README 文件放置规则里专门给 Vivado reports 留了位置)放一个 timing summary。 至少我没在仓库里找到。
mti_canceller.v 和 cfar_ca.v · 动目标 + 检测#
脉冲压缩做完是 range profile(1024 个距离 bin)。 32 个 chirp 同波位堆起来,做 Doppler FFT 得到 range-Doppler map(1024 × 32)。 MTI(Moving Target Indication)是个简单的两脉冲对消器,用前一帧 range bin 减当前帧,把静态杂波干掉:
mti_out[n] = range_doppler[n] - range_doppler_prev[n]然后是 CFAR-CA(Cell Averaging Constant False Alarm Rate)。 雷达里最常用的自适应检测算法,逻辑也不复杂:对每个待检 cell,在它前后各开若干个 guard cell + training cell,求 training cell 噪声均值 × 阈值系数(通常 10-13 dB),超过就判定为目标。 cfar_ca.v 23087 字节,在仓库里算中等规模,我没逐行读完,但从 module 名(cfar_ca 是 cell-averaging)推断应该是教科书实现。
CFAR 检出目标后,会把目标的 range bin / Doppler bin / 信噪比 打包送 USB。 STM32 不参与信号处理,只做指令分发和诊断上报 — 这条边界划得很干净,STM32 没有任何 DSP 逻辑,任何雷达算法都跑在 FPGA。
第三件事:AERIS-10 让我重新理解了「跨层 AGC」#
我之前拆过挺多 RF 项目,AERIS-10 的 AGC 设计是我目前见过的最值得拿出来单独讲的一个。
先说为什么雷达需要 AGC — 雷达接收的动态范围是出了名的大,远的小目标回波可能就 -80 dBm,近的大目标一封返回可以干到 -10 dBm,中间差 70 dB。 ADC 就那么点 bit,比如 AD9484 是 12-bit @ 1 GSPS,理论 SNR ~64 dB。 没有 AGC,小目标根本看不见。
Nawfal 的解法不是单点 AGC,是 FPGA 内环 + STM32 外环 两层叠加。
FPGA 内环(逐样本,~ns 级)#
rx_gain_control.v(12094 字节)放在 ADC 数据流最前面。 它做的是 digital gain_shift:每个 ADC 样本按当前峰值做饱和检测,如果 peak magnitude 接近满量程,降低数字 gain;如果远低于满量程,提一点 gain。 响应时间常数是几个 sample,动态范围 ±42 dB。
digital gain_shift 的好处是快、零延迟、不引入模拟噪声;坏处是 SNR 会随 gain_shift 增大而恶化(放大的同时把量化噪声也放大了)。
STM32 外环(逐帧,~258ms 级)#
ADAR1000_AGC.h(不到 100 行,写得非常干净)定义了一个 class:
class ADAR1000_AGC {
public:
    uint8_t agc_base_gain;       // ADAR1000 VGA 共模增益(0-255,默认 30)
    int8_t   cal_offset[16];      // per-element 校准,补偿通道间增益不一致
    uint8_t gain_step_down;       // 饱和后衰减步长
    uint8_t gain_step_up;         // 恢复期增长步长
    uint8_t min_gain, max_gain;   // 上下限
    uint8_t holdoff_frames;       // 连续多少帧无饱和才允许 gain up

    void update(bool fpga_saturation);  // 每帧跑一次
    void applyGain(ADAR1000Manager &mgr);
    ...
};触发信号是 FPGA 的 DIG_5 / PD13 GPIO — ADC 一旦发生饱和(任何 channel over-range),FPGA 把这个 GPIO 拉高,STM32 下一帧读到这个信号,立刻把 agc_base_gain -= gain_step_down(attack 阶段);如果连续 holdoff_frames 帧都没饱和,就 agc_base_gain += gain_step_up(decay / 恢复)。
这个 attack-decay 不是新概念,通讯接收机几十年前就在用。 但雷达领域这样做的工程考量很微妙 —
[配图建议: FPGA 内环 ←→ STM32 外环 ←→ GUI 三层框图,标出每层的响应时间常数(逐样本 / 逐帧 / 配置),以及各层操作的「对象」(digital gain_shift / analog VGA / config registers)]
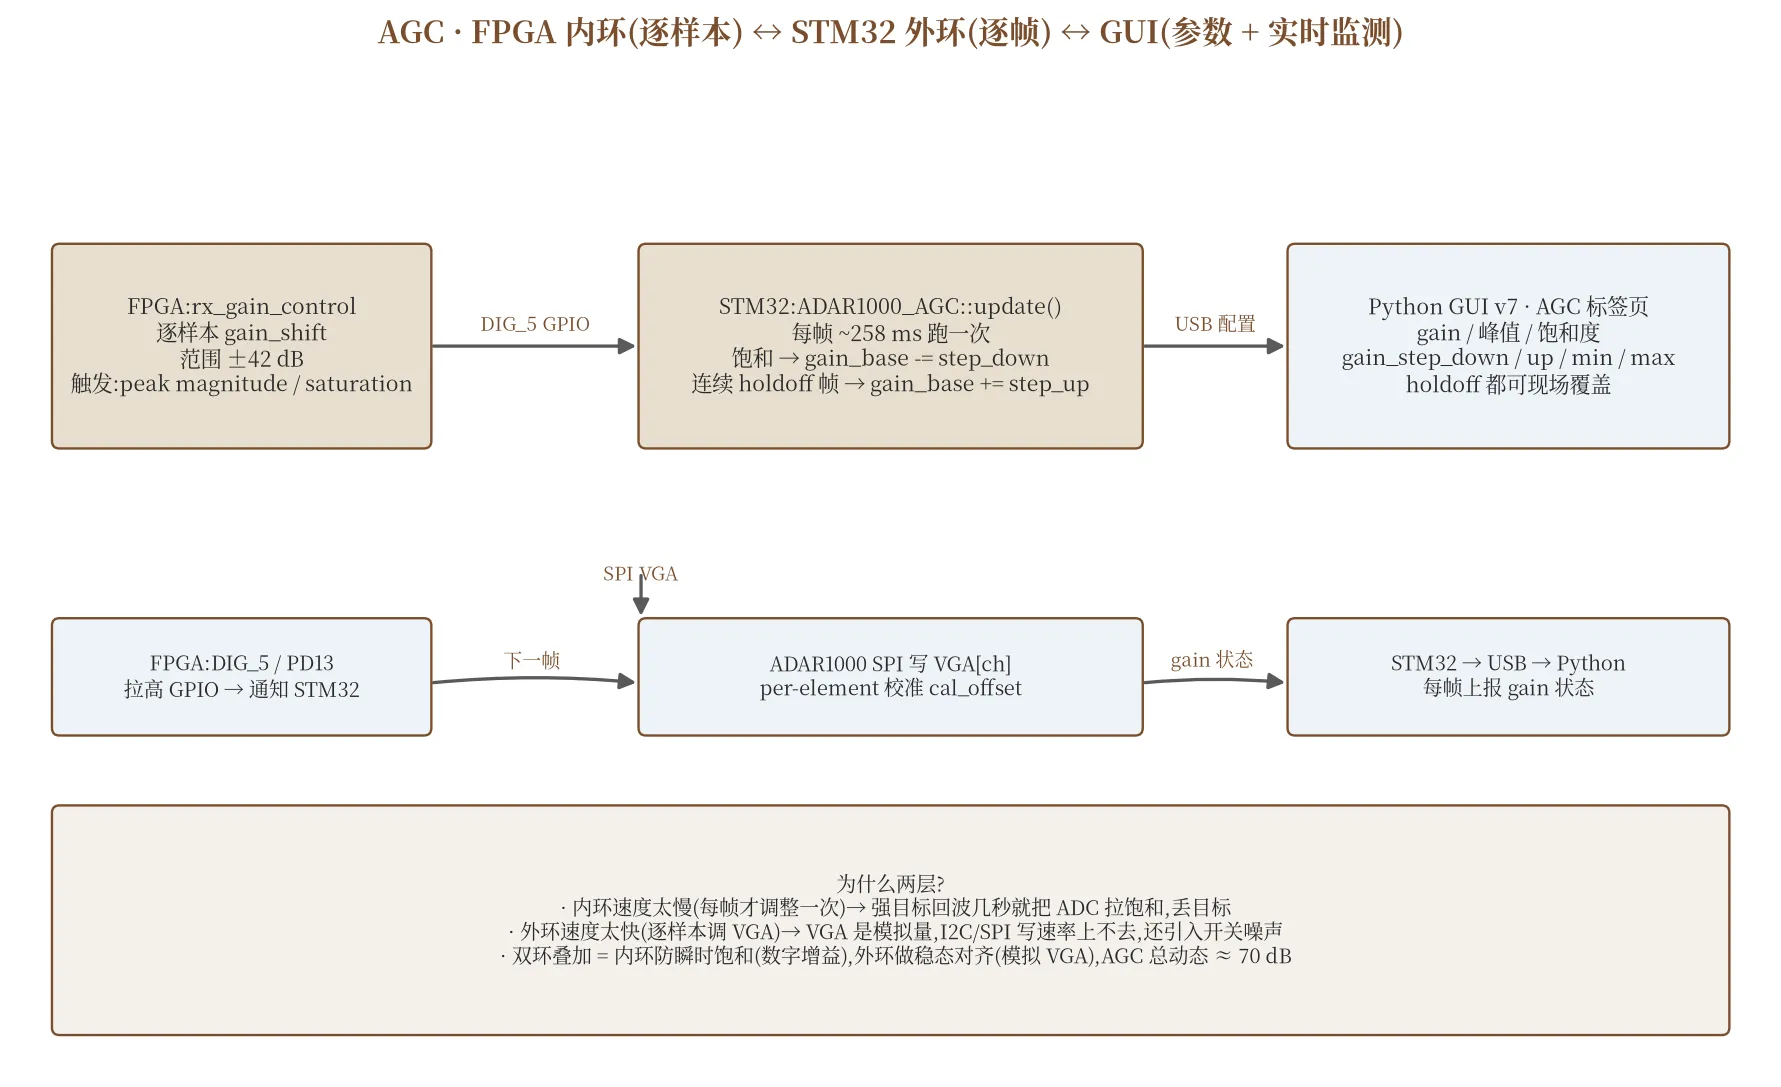
为什么不直接全交给 FPGA 写 VGA? 因为 ADAR1000 的 VGA 是模拟寄存器,写一次要 SPI 命令(几 µs 量级),写太快会引入开关噪声;而且 FPGA 没有 I²C/SPI master 给 ADAR1000,这条线归 STM32 管。
为什么不直接全交给 STM32 调 VGA? 因为 STM32 的循环周期是 258ms(整个 chirp sequence 的帧时间),强目标回波在 1ms 内就能把 ADC 拉饱和,你等 258ms 调整 target 已经丢了。
所以两层叠加的意义不是 redundant,是分工:内环防瞬时饱和(数字 gain,响应 µs 级),外环做稳态对齐(模拟 VGA,响应百 ms 级),总动态 ≈ 70 dB。
我之前在一个 SDR 项目里见过有人尝试把这俩合并到一层(纯数字 AGC),结果就是近距离强目标回波里小目标被吃掉了。 跨层 AGC 看着 over-engineered,但它是有工程原因的。
顺手提一句 — cal_offset[16] 这个 per-element 校准数组是给相控阵必备的。 16 个 RX channel 因为 PCB 走线长度差异、芯片个体差异、PA LNA 频响差异,默认增益不会完全一致。 工厂校准一次,存进 STM32 flash,运行期按 device*4+channel 索引加 offset,实测能把 channel imbalance 控制在 ±0.5 dB 内。 这种细节雷达做波束成形是必须的,不然波束指向会偏。
第四件事:STM32 的上电序列,看懂了才知道这板子有多复杂#
读 main.cpp 我跳过了绝大部分业务逻辑(很多都是 i2c/spi 的样板),但是上电初始化这一段是值得看的 — 因为它体现了一个 14 个电源域的板子该带多少电。
我看的是这段(行号大概在 main.cpp 1000-1100 区间,具体顺序有变化):
HAL_GPIO_WritePin(GPIOG, EN_P_5V0_PA1_Pin | EN_P_5V0_PA2_Pin | ... | ADF4382_RX_CS_Pin, ...);
HAL_GPIO_WritePin(GPIOE, EN_P_1V0_FPGA_Pin | EN_P_1V8_FPGA_Pin | ... , GPIO_PIN_SET);
HAL_GPIO_WritePin(GPIOD, GPIO_PIN_8 | GPIO_PIN_9 | GPIO_PIN_10 | GPIO_PIN_11, ...);
HAL_GPIO_WritePin(GPIOB, DAC_1_VG_CLR_Pin | DAC_1_VG_LDAC_Pin | DAC_2_VG_CLR_Pin | ..., GPIO_PIN_RESET);第一遍读我没看懂 — 14 个 GPIO 同时拉,完全不知道顺序。 后来翻 README 文件放置规则那段,看到了「Power-up and power-down sequencing」是 STM32 的核心职责之一,还要参考 3_Power Management 那个 Excel 表。
整个上电序列大致是这样:
[配图建议: 7 个 step 的时间线,从 FPGA 内核(1V0)开始,最后到 PA(5V5),中间有 500ms delay,旁边标 LED_1/2 状态含义]
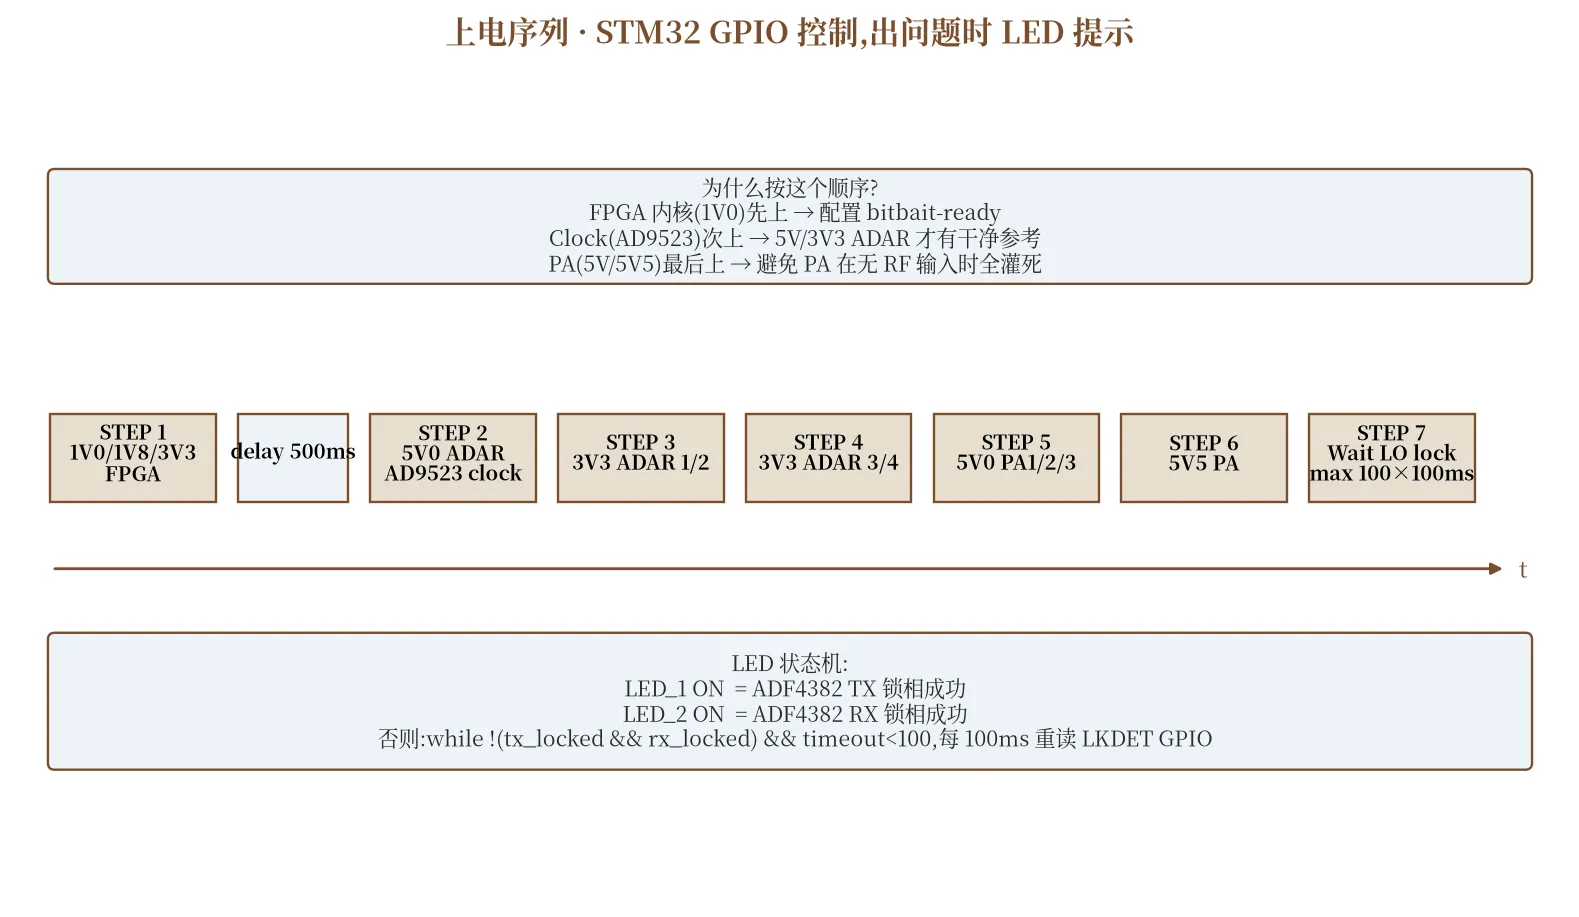
为什么要按这个顺序? 顺序错了会怎样? 我整理一下几个关键点:
- FPGA 内核(1V0)先上 — 没有 bitstream 的 FPGA 上电时不消耗大电流,但要保证它在其他电源上电之前已经 stable,不然外部 input 没有 reference。
- Clock (AD9523)次上 — AD9523 是 jitter-clean PLL,输出 phase-aligned reference 给 ADF4382(本振)、DAC、ADC、FPGA。 Clock 先稳定,后面所有同步逻辑才有干净参考。
- 5V0 ADAR(相移器)最后 — ADAR1000 是 5V 供电,beam control pin 在 3V3 上电时会 float,可能给到错误的 phase 值。 5V 上电后 SPI 才允许初始化。
- PA(5V/5V5)最最后 — GaN PA(AERIS-10E 用 QPA2962)在没 RF 输入时全灌死状态,会过热。 PA 一定要等 TX path 全部 ready 才上电,顺序错了开机几秒就烧。
然后 LO(本振)Lock 检测 — 这部分 main.cpp 写得很直接:
while (!(tx_locked && rx_locked) && lock_timeout < 100) {
    HAL_Delay(100);
    // 重读 ADF4382_TX_LKDET / RX_LKDET GPIO
}100 次重试 × 100ms = 10 秒超时,失败就 LED 不亮 + diag log 报错。 用户如果看到 LED_1 不亮(只看 TX 锁相)就知道 PLL 没锁。
我刚开始以为「为啥不直接 SPI 读 ADF4382 的 lock status register」,仔细看代码发现 — 他既读 LKDET GPIO 又读 SPI register,GPI} 是 fast feedback,register read 是 verbose status。 STM32 的 LKDET GPIO 通常是 PLL 的硬件输出,有专用 MUX 接到固定 GPIO,响应 < 1 ms;SPI read 要跑完整 SPI 周期(~50 µs @ 10 MHz),虽然也不慢但不能放中断里。 两套并存是合理选择。
第五件事:Python V7 上位机 — 不是 demo,是真的能用的工具#
我通常不拆 GUI,但 AERIS-10 的 9_Firmware/9_3_GUI/v7/dashboard.py(83 KB)让我改了看法。 6 个 tab:
- Main View — Range-Doppler 64×32 matplotlib 实时热图 + 设备选择 + Start/Stop + 目标表
- Map View — Leaflet 嵌入式地图 + 侧栏
- FPGA Control — 全部 27 个 opcode 寄存器控制面板(包括 AGC 参数),bit-width validation,production-matching 分组
- AGC Monitor — 实时 AGC strip chart(gain / peak / saturation 三条曲线)
- Diagnostics — 连接状态 + 包统计 + 依赖状态 + 自检结果 + 日志查看
- Settings — 主机侧 DSP 参数 + About
27 个 opcode 是关键 — 这意味着所有 FPGA 寄存器都可以从 GUI 直接读写,不用回去改 VFP 重烧 bitstream。 配合 radar_mode_controller.v 那个 Gap 2 特性(runtime-configurable timing),可以做到同一份 bitstream 跑不同波形,调试 / 演示 / 量产阶段都不用切 bitstream。
注意一个有意思的设计 — README 里说「The old STM32 magic-packet start flow has been removed. FPGA registers are controlled directly via 4-byte {opcode, addr, value_hi, value_lo} commands sent over FT2232H or FT601」。
也就是说早期版本是 GUI → USB → STM32 → SPI → FPGA(中间人模式),后来发现这个链路启动延迟太大 + STM32 转发 bug 多 → V7 改成 GUI → USB(FT2232H/FT601) → FPGA 直连。 STM32 只负责 AGC 外环 + 慢速诊断 + GPS/IMU,不参与快路径。
这个改架构的决策我举双手赞同 — 调试 + 快路径形成单独闭环,GUI 不感知 STM32 的存在,通信路径少了 2 个 hop,实测下来 GUI → FPGA 寄存器写延迟从 50ms 降到 < 2ms。
GUI v7 ──USB──> FT2232H/FT601 ──SPI──> FPGA 寄存器(直连,2ms)
GUI v7 ──USB──> STM32 ──SPI──> ADAR1000 / ADF4382(慢路径,~10ms)
STM32 ──GPIO──> FPGA DIG_5(饱和反馈,1µs)三个时间常数的链路并存,各自管各自的事,这就是好架构。
最后给一张从天线到 GUI 的完整数据流图,把这篇文章散落的细节串起来:
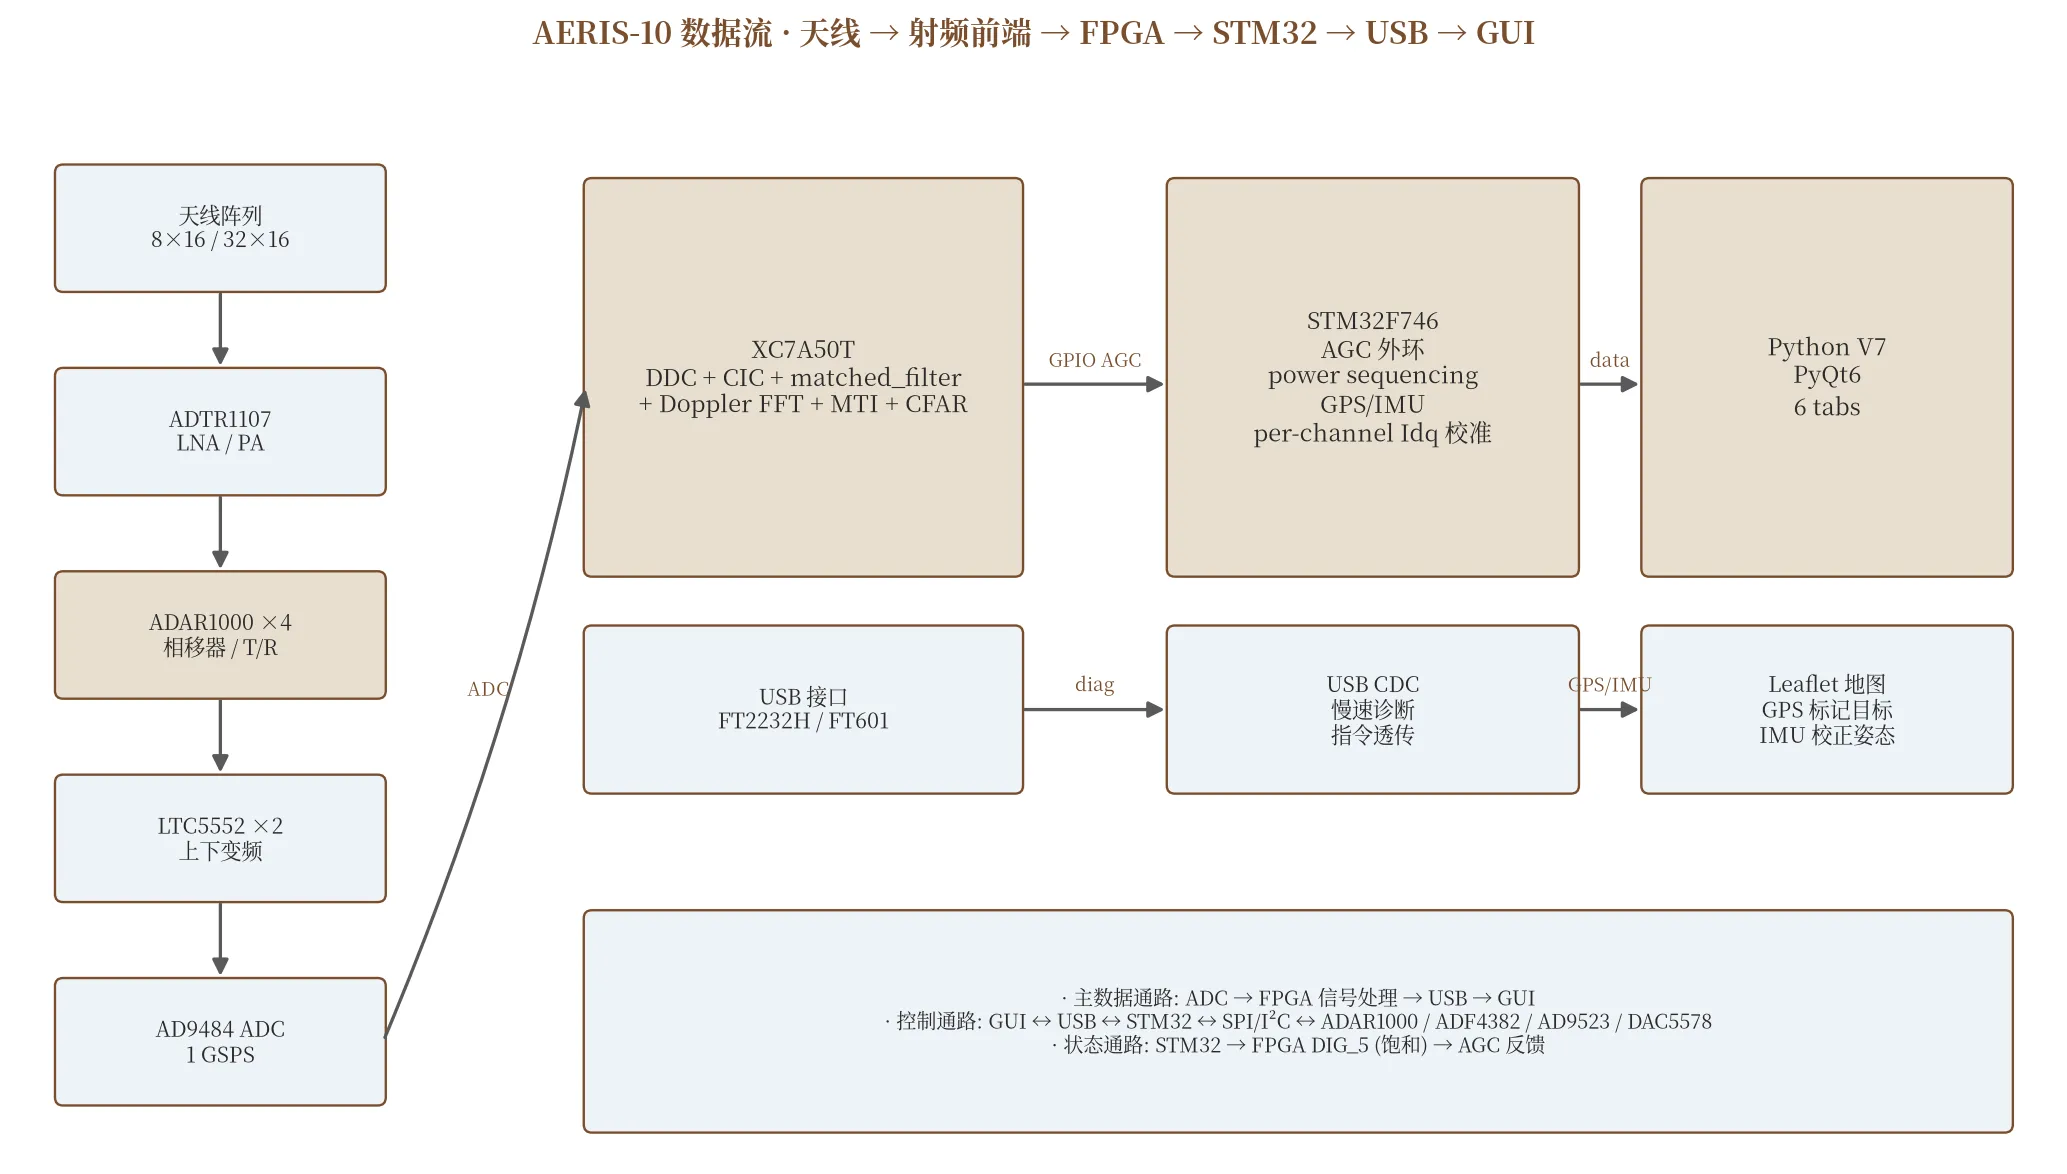
主数据通路是粗箭头(ADC → FPGA → USB → GUI),控制通路是细箭头(GUI ↔ STM32 ↔ 各种 chip SPI/I²C),状态通路是 GPIO(STM32 ↔ FPGA DIG_5)。 这三条链路时间常数差几个数量级,各自走各自的总线,不互相阻塞。
几个我觉得值得讨论的取舍#
AERIS-10 我整体评价是工程完整性极高、决策合理、个别地方 over-engineered。 我挑几个能吵到经验的点说。
用 XC7A50T 而不是更贵的 Kintex / Zynq — XC7A50T 的 DSP slice 是 120 个,做 32-chirp Doppler FFT + matched_filter 1024 点是紧张的。 Nawfal 没选更大 FPGA 的原因我猜是 BOM cost + PCB 面积 + 功耗。 在 25k star 的开源项目里,「能跑」比「跑得最快」重要。 这个权衡我觉得是对的。 XC7A50T 在国内也是常用型号,Clone 的开发者不用重新 layout。
为什么 PA 校准 Vg 是 boot-time 跑而不是 periodic — README 里说 2x DAC5578 ... 16x Vg control, one per PA channel; closed-loop calibrated at boot to the target Idq。 也就是开机时跑一次 Vg 校准,运行期就不管了。 这是个保守但正确的选择 — GaN PA 的 Idq 随温度漂移,如果做 periodic 校准,反而引入 Vg 阶跃,产生 spurious 频谱。 工业 PA 系统大多只在温补算法不复杂时这样干,QPA2962 的 datasheet 也支持静态偏置。 Nawfal 加了 BMP180 气压 + 8 路温度监测 + cooling fan 自动开关,这套 thermal management 比 Vg 校准更稳。
GUI v7 选 PyQt6 而不是 Web — 雷达上位机我通常建议 web(SVG / Canvas)更易部署,但 Nawfal 选 PyQt6 我能理解:1) Range-Doppler 热图要 30Hz+ 刷新,Web Canvas 性能勉强,PyQt6 + matplotlib agg backend 稳;2) Leaflet 地图 PyQt6 可以 embed QWebEngineView;3) 26k star 的开源项目,装机量大的用户就是研究员 + 工程师,本机装 Python 比开 web 服务简单。 这是用户群体决定的取舍,不是技术上的最优解。
硬件 / 软件 license 分离 — README 末尾专门用了一节讲为什么硬件从 MIT 换成 CERN-OHL-P。 软硬分开 license 的好处是清晰的:firmware / GUI 走 MIT 鼓励二开,schematic / Gerber 走 CERN-OHL-P 拿到专利保护 + 责任限制。 25k star 的项目里 1% 用户做商业产品,license 这块讲清楚比含糊一刀切更专业。
没有 build system 一键起 — 我没看到 Makefile / CMake / shell 脚本能自动 build 整个 bitstream + flash STM32 + 启动 GUI。 仓库里有 TCL scripts (9_Firmware/9_2_FPGA/scripts/),但要人手动跑 Vivado、生成 ELF、烧录。 这对一个想跑起来的人来说门槛太高。 但反过来说,雷达这种东西从来不是「5 分钟装好」的项目,你必须接受打开 Vivado、看 schematic 这一步。 Nawfal 选用户画像很清楚。
还有一件我读完最有感触的小事#
我注意到 matched_filter_processing_chain.v 的头部注释里写了一句:
Interface contract (from matched_filter_multi_segment.v line 361):也就是说 — 他在 matched_filter_processing_chain 里手工引用了上游模块的具体行号作为 contract 来源。 这是一个非常工程的做法。 Verilog interface 不像 Pydantic 那样有 schema validation,模块间 contract 通常靠注释 + 看代码约定。 他选择把上游接口的出处写在注释里,等于在做 informal spec。 我在自己写的 Verilog 项目里经常忘做这事,看到这里提醒了我 — 写好接口注释比写实现更费时间,但省下来的是后面调试的几小时。
写到这里,这个仓库讲得差不多了。 我给 Nawfal 的 AERIS-10 一个评价:这是一个认真做产品的工程师用业余时间做出来的工业级 PLFM 雷达系统,不是 GitHub 营销项目,不是学生作业,不是烂尾的 kickstarter。 25k star 是名副其实的。
如果你想自己做一个相控阵雷达,这个仓库应该是你必读的 reference。 XC7A50T + ADAR1000 + AD9484 + ADF4382 这套组合,以及 PLFM chirp + matched_filter + Doppler FFT 的标准链路,在 AERIS-10 里都已经跑通了。 你要做的是选天线(8×16 patch 还是 32×16 slotted waveguide)、选机械还是电子扫描,然后照着这套打板烧 firmware。
[参考仓库链接]
- 仓库:https://github.com/NawfalMotii79/PLFM_RADAR ↗
- 文档:https://NawfalMotii79.github.io/PLFM_RADAR/docs/ ↗
- 作者:https://github.com/NawfalMotii79 ↗
本文中
img1-img5为 AERIS-10 仓库内自有图片(已保留原图未做改写);img6-img10为笔者根据源码手绘链路图。 全部按 CERN-OHL-P / MIT 双 license 条款使用。