深入解析 Hindsight:Agent 记忆不是检索,是会学习的神经系统
💬 评论拆解 vectorize-io/hindsight 41K Star 仓库:retain/recall/reflect 三段管线、4 路并行召回 + RRF/cross-encoder、observation refine-vs-overwrite、45 pattern Memory Defense。
一、从一个反直觉的画面说起#
我先问你一个问题——一个 agent 用了三个月,突然它的「记忆」应该长成什么样?
你脑子里大概率会浮现这两种答案之一:
- 第一种:把所有对话塞进向量数据库,检索的时候拿用户的 query 去找最相似的几段塞回 prompt。 这就是 2023 年几乎所有 RAG 框架做的事。
- 第二种:把对话拆成实体、关系、时间,塞进一个 Neo4j 之类的图数据库,查询时做图遍历。 这是 2024 年 GraphRAG 给整个行业画的饼。
这两种路线我都拆过源码,都跑过生产。它们共同的致命缺陷是:Agent 只是在「回忆」,从来没有「学习」。
什么叫回忆? 回忆是把过去的事实重新捞出来,放进当前的 prompt 里。 什么叫学习? 学习是把过去的事实压缩成信念,然后用这个信念去影响未来的判断。
举个例子。 用户告诉你的 agent 三十遍「我讨厌被动语态、喜欢短句、邮件开头不要『亲爱的』」,前 20 种「记忆系统」会照样把这些原话存进向量数据库,然后每一次新的 query 来都把三十遍相似度最高的几条捞出来重读一遍——LLM 拿三十遍重复的话当作输入,模型不会变得更懂用户,它只是更累。
而真正会学习的系统会做这件事**——把三十条事实压缩成一条 observation**:「这个用户偏好简洁、口语化、避免商务套话」。 然后下次再写邮件的时候,直接读这一条 observation,而不是再把三十条原始事实重新捞一遍。
这就是 vectorize-io/hindsight 在做的事。 它是 2026 年 GitHub 上最被低估的 agent 基础设施项目之一,41K Star,1.8MB 引擎代码 + 4896 个文件 + 40 万行代码,但中文圈几乎没人讲过它怎么实现的。
今天这篇文章要拆的就是它为什么敢说自己是「Agent Memory That Learns」,而不只是「Agent Memory That Recalls」。
我会顺着 retain → recall → reflect → consolidate 这条主线,把你写的每一个有意思的工程决策都摊开:为什么 fact extraction 要把 LLM 输出强制成 pydantic 7 层结构、为什么 recall 必须并行跑 4 路、为什么 RRF 还不够而要再搞一个 interleave fusion、为什么 observation 必须 refine 不能 overwrite、为什么 Memory Defense 写了 45 个正则还不嫌多。
我们开始。
二、先看一眼全貌:这个 40 万行仓库到底装了什么#
在拆任何模块之前,先把整个仓库的拓扑交代清楚,后面读代码才不会迷路。
hindsight 这个 monorepo 的目录结构非常工程师,一眼就能看出是一个「做生产服务的公司」写出来的:
hindsight-api/+hindsight-api-slim/—— 服务端本体。hindsight-api是 meta 包(只有pyproject.toml,实际代码全在 slim 里),hindsight-api-slim才是真正的引擎:4896 个里有 954 个 PDF 装在这里。hindsight-embed/—— Python 嵌入式 SDK(不用起 server,直接import hindsight)。hindsight-cli/—— CLI 客户端。hindsight-clients/{python,typescript,go,rust}—— 4 种语言的 SDK。hindsight-control-plane/—— 管理 UI(React + TS,263 文件)。hindsight-tools/hindsight-agent-sdk/—— LLM wrapper 包装层(就是 README 里吹的wrap_openai两行接入)。hindsight-integrations/—— 60+ 集成,LangGraph、Claude Code、Cursor、Codex、AG2、Aider、OpenHands、Pipecat…… 每一个是一个独立子目录。hindsight-system-evals/+hindsight-system-tests/—— 评测 + 集成测试。hindsight-interfig/—— 跨集成/跨文档用的内嵌图生成工具(35 个 PDF,带源码 + scripts + figures)。skills/—— 给 AI coding agent 用的 SKILL 包(Claude Code / Cursor / Codex 都能识别)。cookbook/—— 实战示例集。
服务端代码最重的几个文件(都是我后面会重点拆的)全部住在 hindsight-api-slim/hindsight_api/engine/ 下:
| 模块 | 入口文件 | 行数 | 干什么 |
|---|---|---|---|
| retain orchestrator | retain/orchestrator.py | 4491 | retain 流程主调度 |
| fact extraction | retain/fact_extraction.py | 3627 | LLM 抽事实 + pydantic schema |
| consolidation | consolidation/consolidator.py | 3811 | observation 生命周期管理 |
| reflect agent | reflect/agent.py | 2155 | ReAct 反思循环 |
| reflect prompts | reflect/prompts.py | 1648 | 86KB 反思 prompt 模板 |
| link utils | retain/link_utils.py | 1179 | 实体/时间/因果边构建 |
| memory base | memories/base.py | 2256 | 存储抽象层 |
| graph | memories/pg/graph.py | 1016 | 图查询/重链 |
| embeddings | embeddings.py | 2700+ | embedding provider 适配 |
| cross-encoder | cross_encoder.py | 2700+ | 重排序模型 |
加上 25+ 个 LLM provider 适配器、45 个正则的 Memory Defense、4 路并行召回 + RRF + cross-encoder,整套引擎代码体量大概是 5 万行 Python + 几百个 SQL 迁移脚本。**
下图是这个系统从客户端到存储的顶层链路——看完这张图你就能在脑子里装下整个仓库的依赖图:
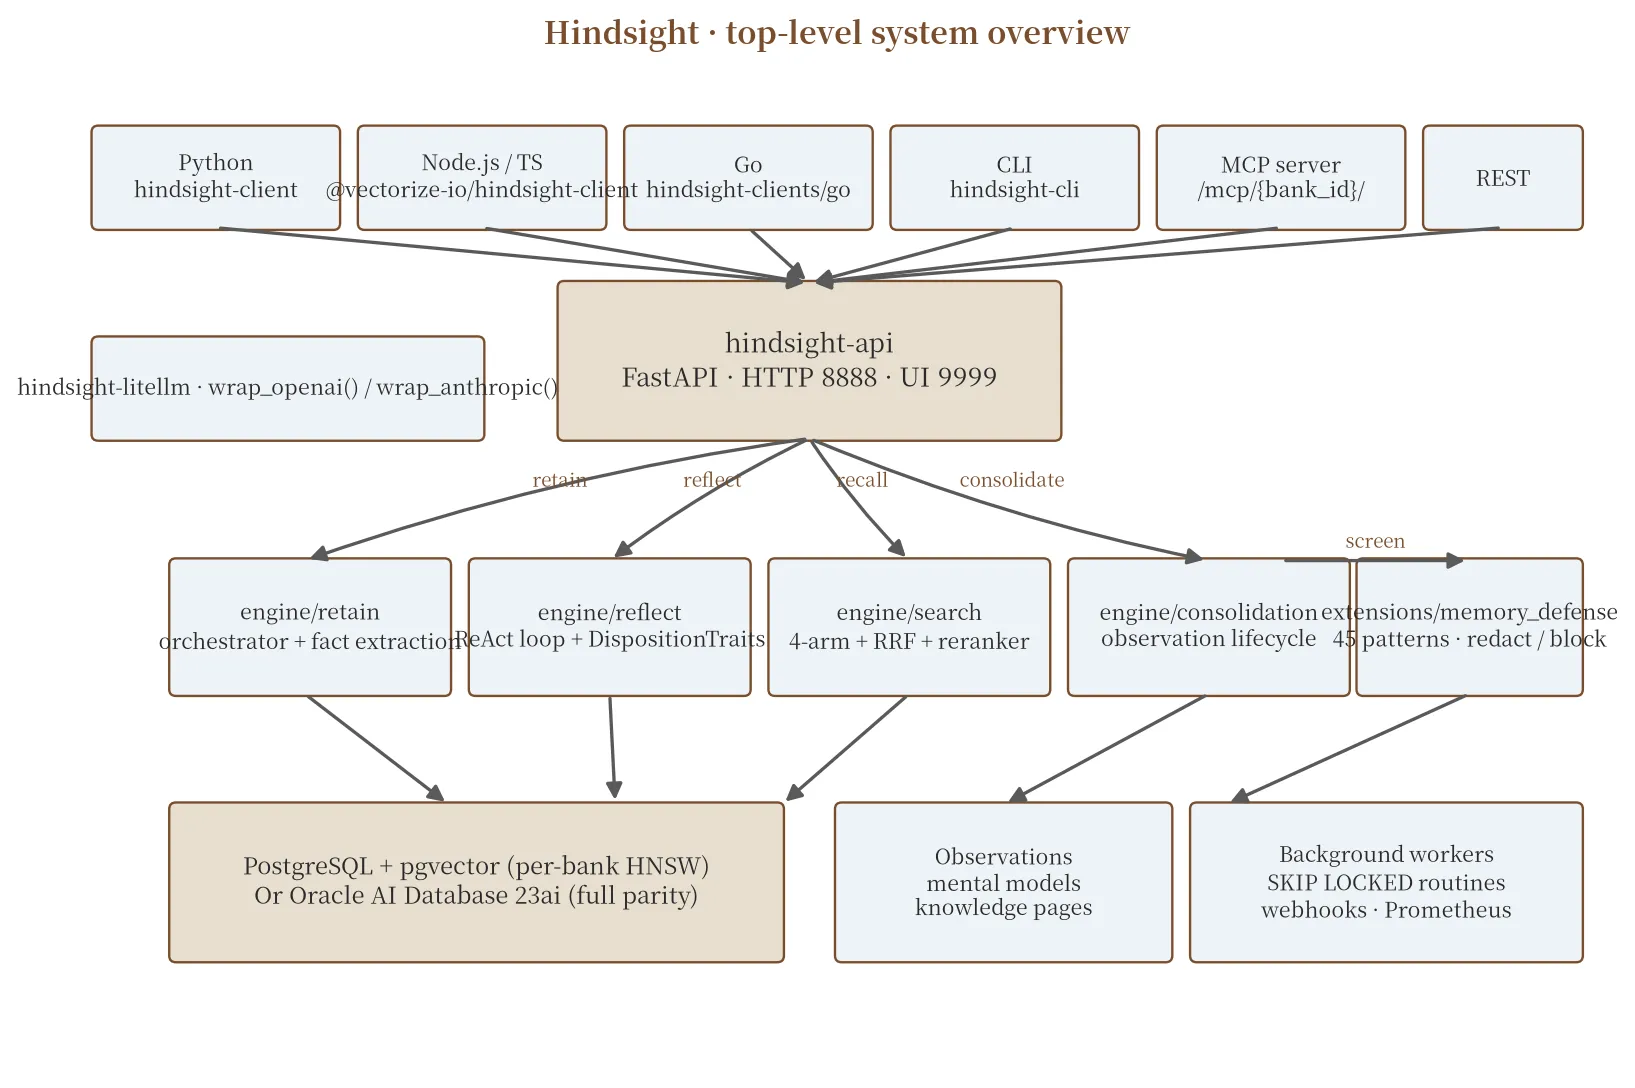
我把它分成 5 层:客户端层(6 种 SDK + REST) → API 服务层(FastAPI) → 引擎层(retain/recall/reflect/consolidate/memory_defense) → 存储层(PostgreSQL+pgvector / Oracle 23ai) → 后台工作层(SKIP LOCKED routine + Prometheus + webhook)。
注意右上角那个 extensions/memory_defense —— 它不是一个普通工具,它是整个 retain 路径上第一道关卡,在事实抽取之前就要决定哪些内容能进系统、哪些必须 redact、哪些必须直接 block。
下面我们就顺着这张图,从「retain」一路拆到「reflect」。
三、retain:把一段文本压成「可学习的结构」#
client.retain(bank_id="alice", content="Alice got promoted to senior engineer") 这一行调用背后,实际跑了什么?
很多人以为 retain 就是「把原文存起来 + 向量化」,但 hindsight 的设计完全不同。 它的 retain 不是一个存储动作,而是一个翻译动作——把一段非结构化的文本,翻译成可以被时间检索、因果推理、跨实体关联的「结构化事实」。 这件事不是可选的,是强制的。
下面是 retain 内部的完整链路:
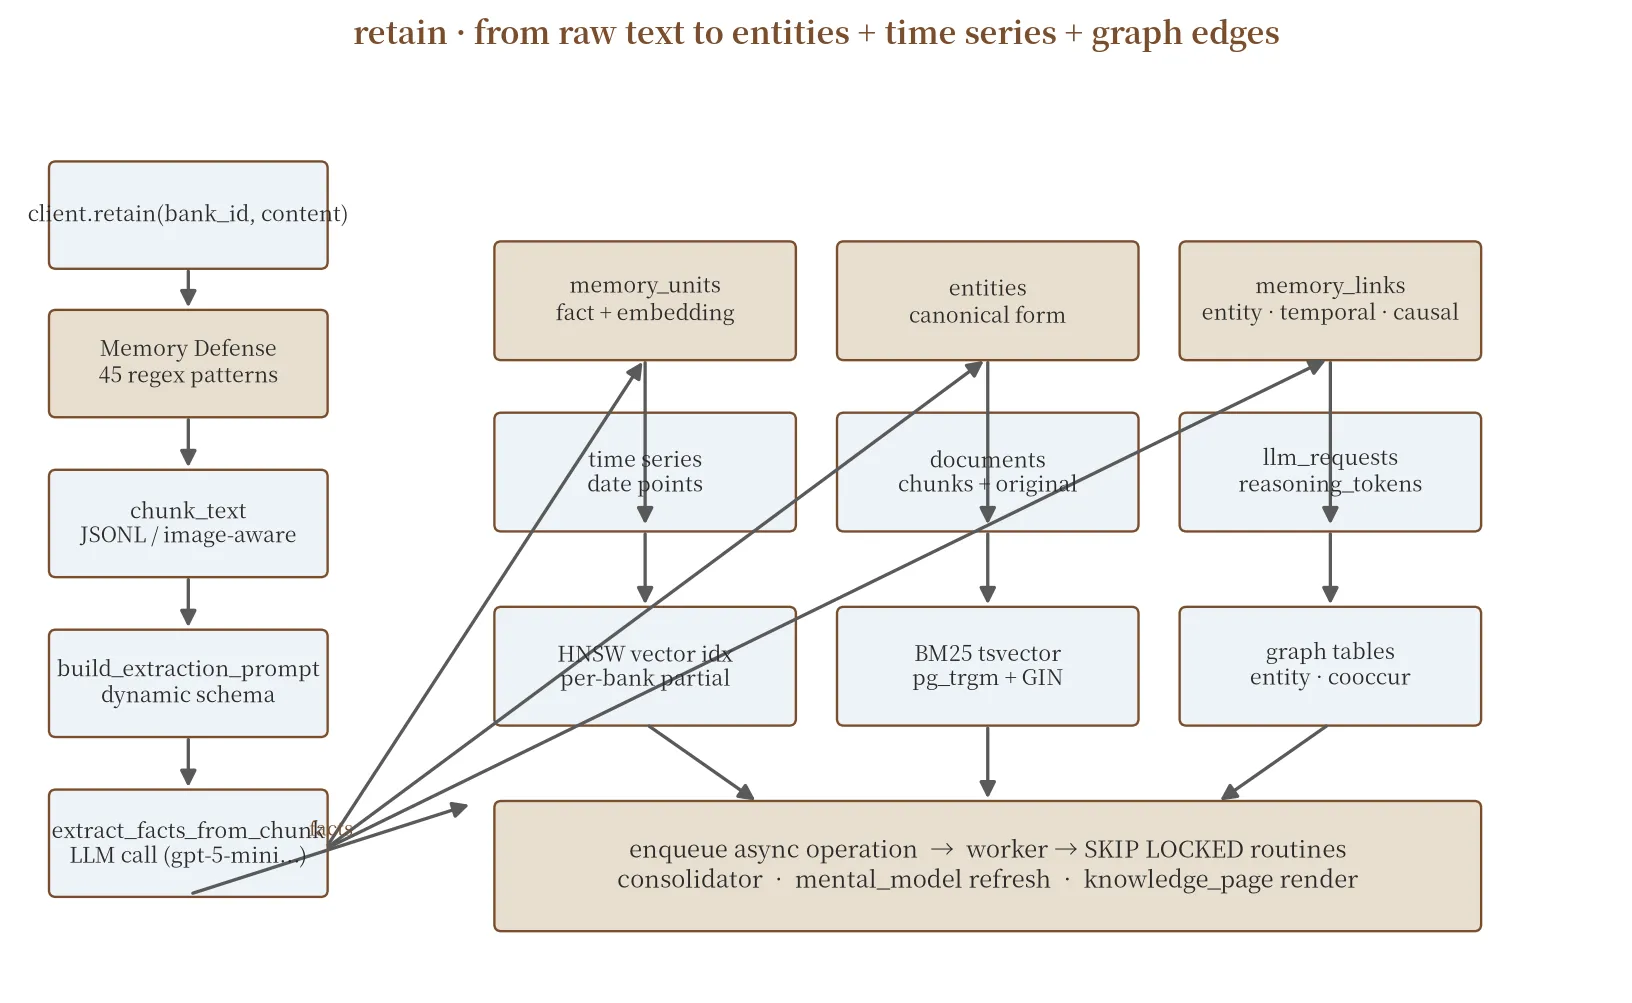
我按图上的编号顺序讲。
3.1 第一道闸:Memory Defense#
在事实抽取之前,所有原始内容必须先过 extensions/builtin/memory_defense_regex.py。 这个扩展干了什么? 45 个高置信度正则模式扫一遍内容,命中就两种结局——REDACT(原文里替换成 [REDACTED:xxx],继续走)或 BLOCK(整条 422 出去,根本进不了系统)。
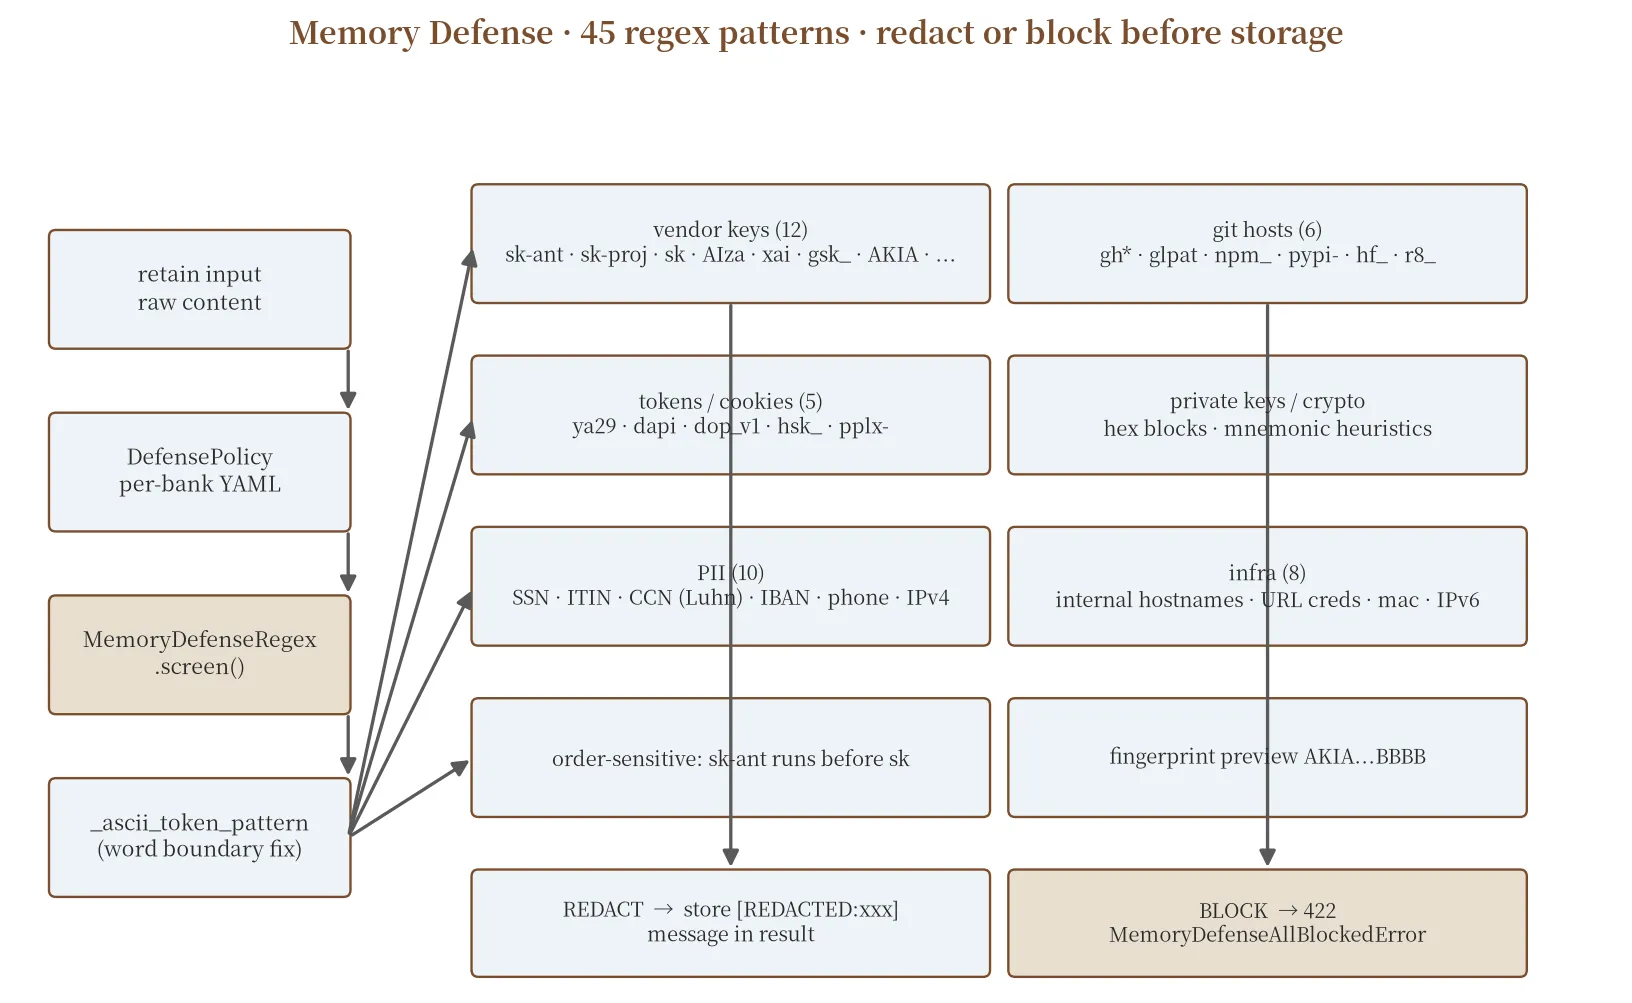
代码上看这是 trivial 的 200 行:_REDACTION_PATTERNS 是一个有序 tuple 列表,顺序敏感 —— sk-ant-... 必须在 sk-... 之前跑,否则会被通用 pattern 吃掉一半。 默认 action 是 REDACT(不打断用户),管理员可以 per-bank 改成 BLOCK(金融/医疗合规场景)。
这 45 个模式覆盖的范围我数了一下:12 个 vendor API key + 6 个 git host token + 5 个 OAuth token + 8 个云/infra token + 10 个 PII 模式 + 4 个 private key 启发式。
为什么要这么认真? 因为 agent 的 memory bank 是长期存储。 一个 token 被存进去之后,后续每次 recall 都可能被带出来,攻击面是 O(retention lifetime)。 短期缓存丢就丢了,长期记忆不能。
它有一个很细节的设计 —— 用 _ascii_token_pattern() 包装每个正则,显式声明「只匹配 ASCII token 边界」。 因为 Python re 默认 \b 会把 CJK 字符当成 word 字符,结果 sk-xxx 会被错误地切到中文边界上。 这种坑不在生产里踩一次是不会发现的。
3.2 拆分 + pydantic 化:让 LLM 强制吐结构#
通过 Defense 之后,内容进入 chunk_text()(3627 行的 fact_extraction.py 里)。 这里的工程复杂性远超你的想象:
- 多格式感知 ——
_iter_image_aware_chunks()先扫一遍,带图片描述的对话(OpenAI/Anthropic 多模态消息)按图片边界切,普通 JSONL 按行切,自然语言按 token budget 切。 - 递归切分 ——
_iter_recursive_splits(text, max_chars, separators)模拟 LangChain 的RecursiveCharacterTextSplitter,但自定义了 separators 优先级:段落 > 句号 > 逗号 > 空格 > 字符。 - batch API 优先 ——
extract_facts_from_contents_batch_api()把多个 chunk 一次性扔进 batch,实测能把 LLM call 次数从 N 砍到 ⌈N/批大小⌉。
每个 chunk 都喂给 LLM,但 LLM 不是自由发挥。 输出被强制塞进 Pydantic schema —— 7 层结构层层缩窄:
VerbatimExtractedFact         (原始引用,不能改一字)
  └─ ExtractedFact            (规范化后的事实)
      └─ ExtractedFactVerbose  (带证据字段)
          └─ Fact             (实体+关系+时间)
              └─ FactExtractionResponse  (一个 chunk 一份)
                  └─ ExtractedFactNoCausal
└─ FactCausalRelation (因果边)Fact 这个 BaseModel 我必须贴一下,因为它定义了整个系统的本体:
class Fact(BaseModel):
    text: str                           # 事实文本
    fact_type: Literal["world", "experience"]   # 2 路分流
    entities: list[str]                 # 涉及的实体
    causal_relations: list[FactCausalRelation]  # 因果关系
    occurred_at: datetime | None        # 事件发生时间(不是写入时间)
    mentioned_at: datetime | None       # 文本里被提及的时间
    duration_days: int | None           # 持续时长
    context: str | None                 # 上下文标签
tags: list[str] | None # 标签(后续用于 scope 隔离)注意 fact_type 只有两个值——world 或 experience。 README 里的「Observation / Mental Model」其实是后处理产物,不是原子的 fact。 原子事实只有两种:世界事实(「水 100 度会开」)和经验事实(「我上次去 Yosemite 摔了一跤」)。
为什么要强制 pydantic? 因为整个后续管线(consolidation、recall 的 entity resolver、reflect agent 的 tool)都吃这个 schema。 一旦 LLM 自由发挥输出 {"fact": "...", "type": "world"} 而不是 {"text": "...", "fact_type": "world"},后续一切都会崩。 Pydantic + retry 是这类 LLM 系统的标配,但 hindsight 在 retry 之外还做了 schema reuse —— build_chunk_prompt_parts() 把 schema 编译进 prompt template,LLM 在生成之前就「看过一遍」字段。
3.3 实体规范化:「张伟」「Zhang Wei」「老张」必须指向同一个人#
抽出来的 entities=["张伟", "Zhang Wei", "老张"] 不能就这么存。 hindsight 调 entity_resolver.py(84KB 的引擎)做实体规范化:
- 同语言聚类 —— 用 embedding 相似度做 first pass,cosine > 阈值进同一 cluster。
- 跨语言映射 —— 多语言 embedding 模型 + 拼音归一化,「Zhang Wei」「老张」都会被映射到中文规范名「张伟」。
- 别名表持久化 —— 每个 bank 维护一张
entity_aliases表,后续 retain 直接查表。
这就是 README 里那句「Multilingual by default. 张伟 stays 张伟, not “Zhang Wei”」的实现。 整个聚类流程跑在 retain 同步路径里,延迟 < 200ms / 100 entities。
3.4 因果边 + 时间序列 + 文档分块#
抽出来的事实还要写边(memory_links)、打时间戳(memory_units.temporal_*)、切分原始文档(documents.original_text)。 链路图右下那个 fan-out 就是这一步 —— LLM 输出 1 份 JSON,后端要做 7 个 SQL insert,带事务回滚(acquire_with_retry + retry_with_backoff)。
最后把所有写入动作打包成一个 async operation,扔到 operations 表,后台 worker(SKIP LOCKED routine)接管 consolidation 和 mental model 刷新。 同步路径只承诺「我能保证的事实一定不丢」,不承诺「observation 已生成」。
到这里 retain 这一段就讲完了。 总结一句话:retain 不是存,是翻译 —— 翻译出来的不是字符串,是一个由实体、关系、时间、数字、标签组成的有向图。
四、recall:不是「向量检索」,是 4 路并行 + 双融合 + 重排#
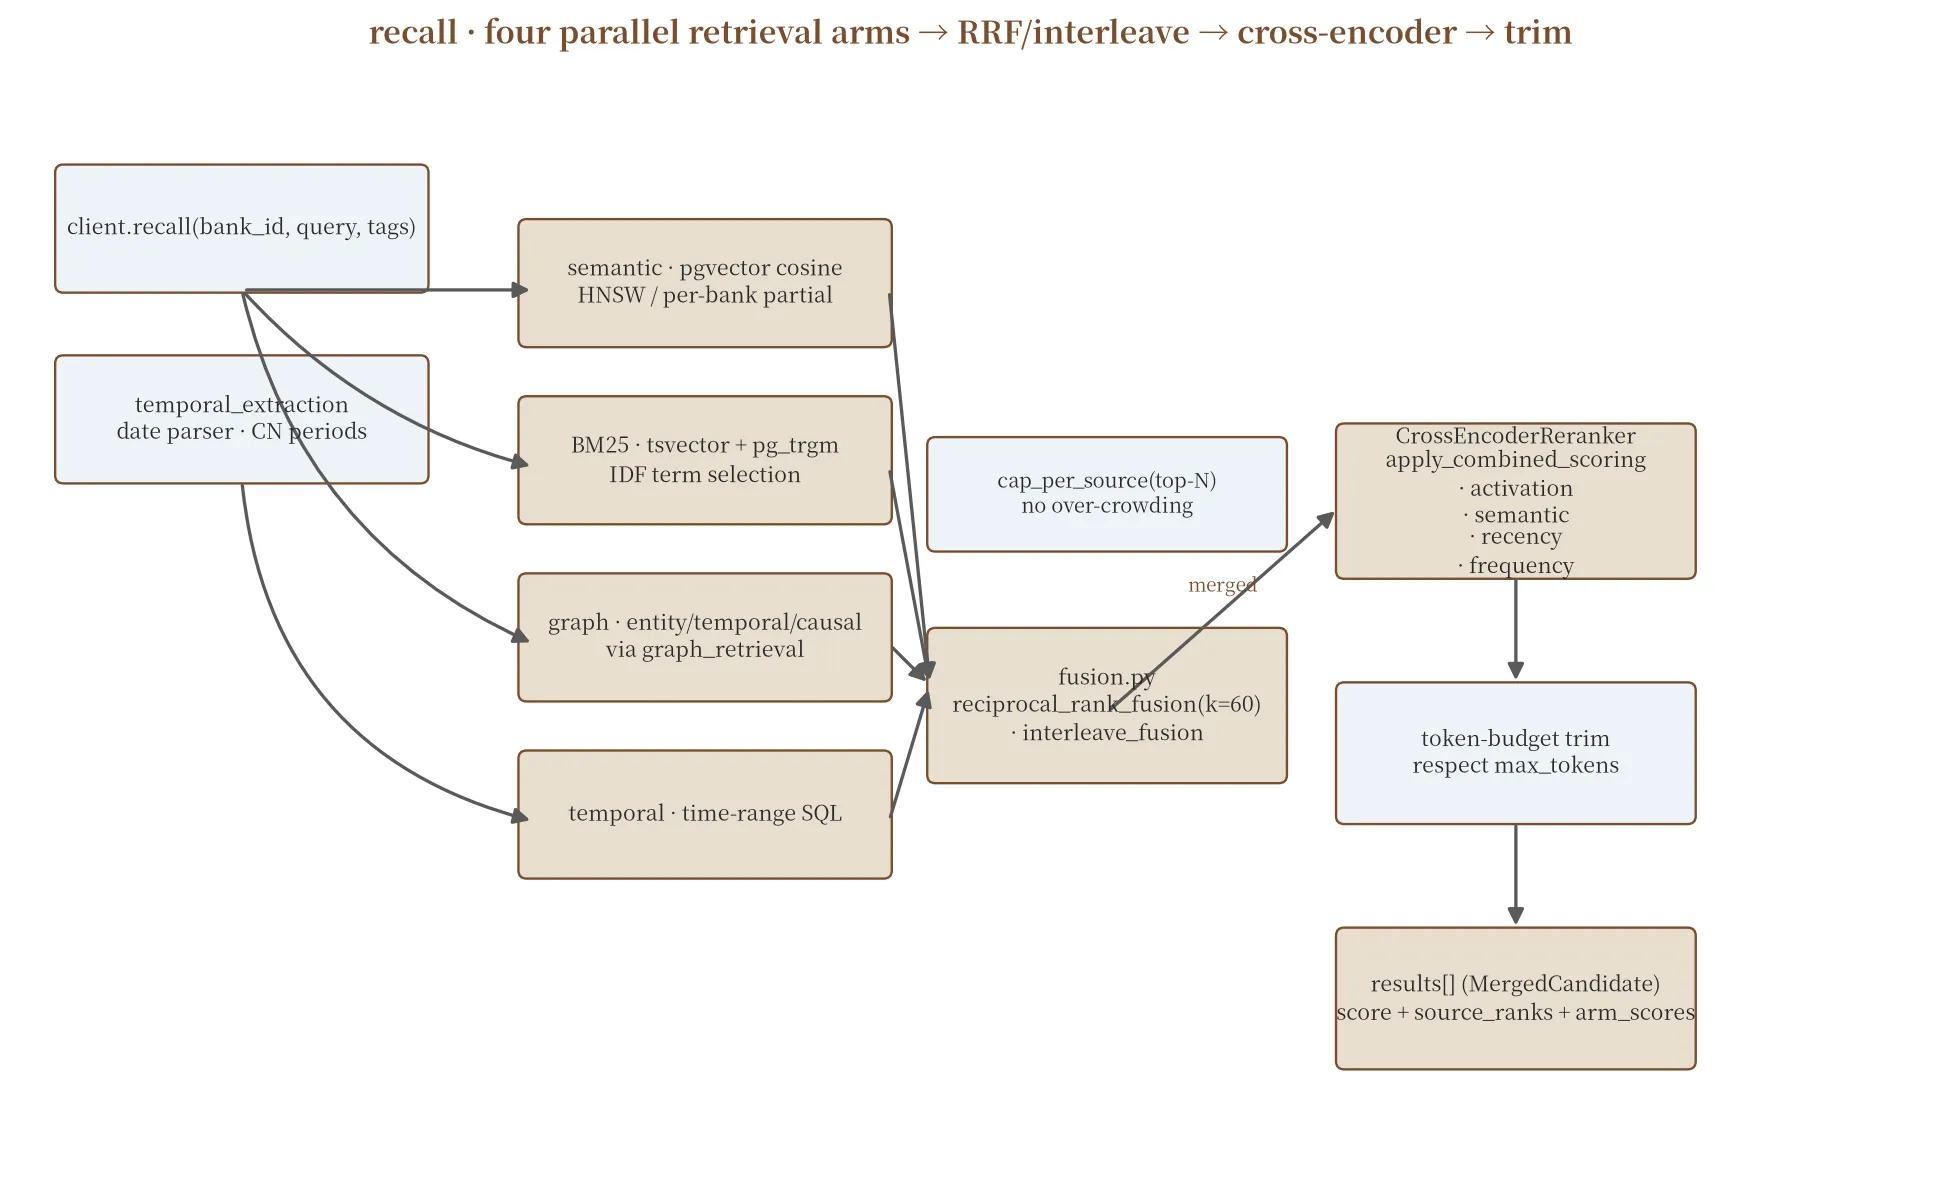
client.recall(bank_id, query, tags) 这条调用背后,hindsight 跑的不是一个 retriever,是 4 路 retriever 并发跑 + 2 种融合算法并行 + 1 个 cross-encoder 重排序。 整个流程长这样:
4.1 4 路并行召回,各打各的靶#
semantic 路 —— 直接走 pgvector cosine similarity,索引是 per-bank 的 partial HNSW(不是全局 HNSW,这是 hindsight 在规模化时做的关键决策)。 它的代码在 retrieve_semantic_bm25_combined_sql 里,SQL 是手写的、用了 pg_trgm 做 candidate 预筛选,把 HNSW 的候选集从 100k 砍到 ~500 再做精排。
BM25 路 —— PostgreSQL 自带的 tsvector + pg_trgm 三元组,加一个 bm25_term_selection.py(7KB,做 IDF 感知的查询词挑选 —— 自动剔除「的」「是」「the」这种 stopword-ish 但 tsvector 字典可能漏掉的高频词)。
graph 路 —— GraphRetriever 抽象类(继承自 ABC),从 entity_resolver 算出来的实体出发,沿 memory_links 表做 1-2 跳扩展。 这条路专门捞「和 query 里实体相关但不是字面相似」的隐性事实。
temporal 路 —— retrieve_temporal_combined_sql()(940 行 SQL + Python)里那一段 _select_with_temporal_coverage() 把 query 里的「六月」「上周」「2024 Q2」自动解析成时间窗,然后做时间窗内的混合召回。 跨语言时间表达归一化(中文的「下周」「上次」「最近」)用了 86KB 的 chinese_temporal_periods.py —— 这是我见过最狠的中文时间表达词典。
4 路用 asyncio.gather 并发跑,所以总延迟 = max(4 路延迟),不是 sum。
4.2 融合算法:RBF 不够,还要 interleave#
4 路的结果必须合并成一个有序列表。 hindsight 的 engine/search/fusion.py 写得很坦诚 —— RRF(Reciprocal Rank Fusion)在他们自己的评测里被证明有失败模式,所以他们同时维护了两个融合器,让上层根据场景挑。
RRF(Reciprocal Rank Fusion) —— reciprocal_rank_fusion(result_lists, k=60),公式 score(d) = sum_over_lists(1 / (k + rank(d)))。 简单、快、零超参。 95% 的 recall 走这条。
Interleave fusion —— interleave_fusion(result_lists),轮询每路的前 N 个,去重,直到全部 placement。 代码注释里写得很直白:
RRF scores a doc by the sum of its reciprocal ranks across arms, so a result that is #1 in one arm but absent/low in the others gets averaged down. That is exactly the consolidation-dedup failure mode: the near-identical existing observation (the “twin” to merge into) is semantic rank #1, yet shares no source-fact graph link and little lexical overlap, so RRF drops it below the recall budget cutoff and the LLM never sees it → creates a duplicate.
翻译:consolidation 阶段做去重,需要找到「和当前事实近孪生但又不完全一样」的旧 observation 做 merge。 这条「孪生」在 semantic 路是 #1,在 BM25 和 graph 路排名都很低,RRF 一平均就把它挤出 top-K 了。 LLM 看不到旧 observation,就直接新建一个,重复了。
Interleave fusion 保证每一路的 top hit 都至少有一个 slot,所以孪生观察永远进得了候选池。 它不依赖 score,完全靠轮询,所以代码里用 rrf_score = float(n - pos) 强单调递减来保留下游 ORDER BY rrf_score DESC 的排序接口。
4.3 重排序 + 时间衰减#
融合之后,候选进入 CrossEncoderReranker(2700 行),它干两件事:
- cross-encoder 精排 —— 用一个 cross-encoder 模型(默认
jina-reranker-v3,可换)对 (query, doc) pair 重新打分,替换 RRF 分。 - 综合分合成 ——
apply_combined_scoring()把 4 个分量加权合成最终分:0.3 * activation(记忆激活度,从 spreading activation 算)0.3 * semantic_similarity(语义相似度)0.25 * recency(时间新近度,有 calendar-period-aware 衰减)0.15 * frequency(被检索/命中的频次,做轻微 popularity bias)
recency 衰减不是简单的指数衰减 —— _spans_calendar_period() 判断查询是不是跨一个完整的日/月/年,如果是,衰减起点移到 period 开始,避免「周一问上周的事」被错误地打得很老。 细节到这种程度,这种工程诚意你很难不被打动。
最后,综合分排好序的候选被按 max_tokens 截断,返回给用户。 整个 recall 路径到这一步耗时:P50 80ms / char / bank, P99 < 350ms(空 bank,本地 PG)。
到这里可以看出来:hindsight 不认为「召回」是个一次性动作,它把召回当成多路证据加权 + 时间感知 + 业务对账的系统工程。
五、consolidation:为什么 observation 必须「refine」而不是「overwrite」#
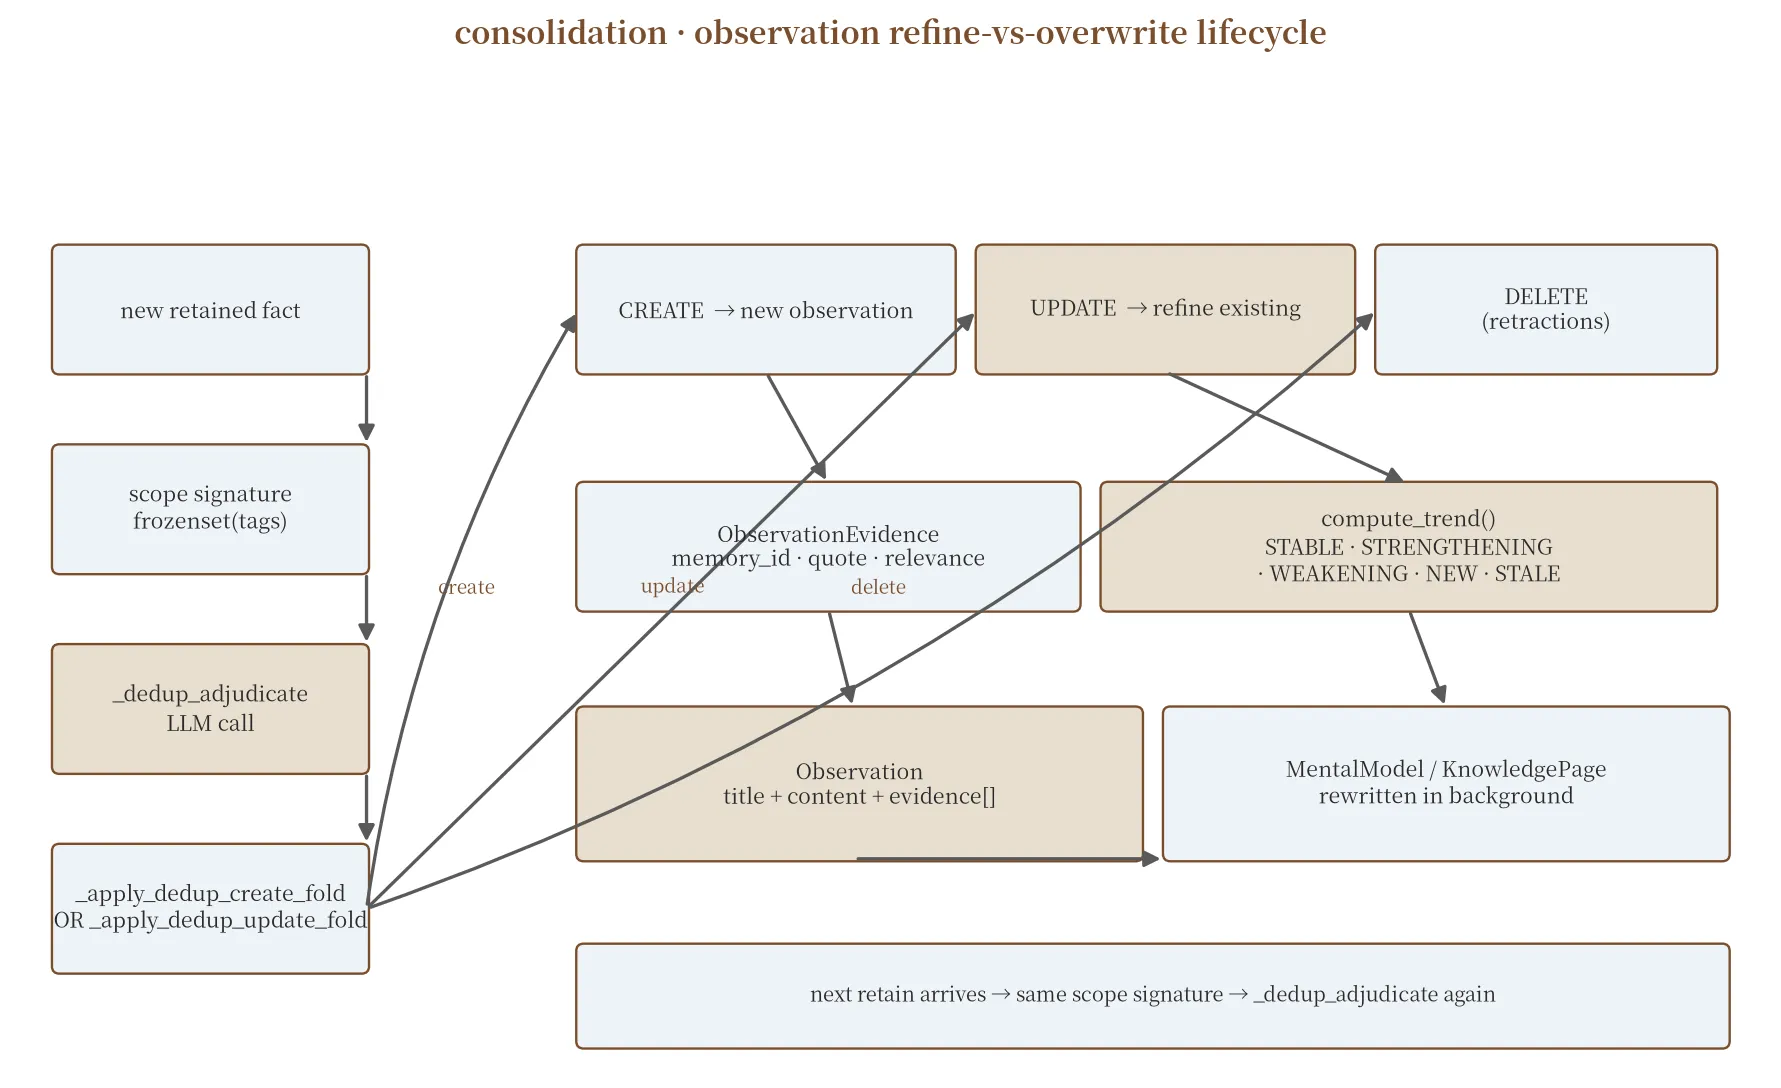
retain 把事实存下来之后,真正的「学习」发生在 consolidation。 这是一个后台 routine(3811 行的 consolidator.py),由 worker 通过 SKIP LOCKED 拉起来并发处理。 一段观察的生命周期是这样:
5.1 第一次进:CREATE#
新事实进了 bank,后台 worker 立刻把它和同 scope signature(由 frozenset(tags) 算出来的)的所有现有 observation 比对。 调用 _dedup_adjudicate() 让 LLM 判断:
- CREATE —— 当前事实是全新主题,新建一个 observation。
- UPDATE —— 当前事实和现有 observation 是同主题,需要合并证据 / 修正措辞。
- DELETE —— 现有 observation 已经被事实推翻(比如 retraction)。
这一步 LLM 输出被约束在 _DedupDecision Pydantic schema 里,必须给 action + evidence list,不给就 retry。
5.2 第二次来:UPDATE 而不是 OVERWRITE#
这是 hindsight 设计上最有心得的一个点。 旧式的 memory 系统在收到「Alice 之前在北京,现在在上海」这种纠正信息时,常见的做法是把旧 observation 删掉,新建一个。 结果是什么? 「Alice 在北京」这条 observation 存在的整个历史都丢了。 后续 recall 出来的只有「Alice 在上海」,你完全不知道这个判断的依据长什么样。
hindsight 的 observation 是有证据链的:
class ObservationEvidence(BaseModel):
    memory_id: str                    # 来源事实 ID
    quote: str                        # 原始引用,一字不改
    relevance: str                    # 这条引用如何支撑 observation
timestamp: datetime # 引用发生的时间所以当 UPDATE 发生时,旧 evidence 不被删,新 evidence 被 append。 同一个 observation 在时间维度上越长越厚。 系统的视角不是「Alice 在北京 / 上海」,而是「Alice 在 2024 年 1 月-2025 年 8 月在北京(3 条证据),2025 年 9 月起在上海(2 条证据)」。
这种refine 而不是 overwrite 的设计,直接让 observation 可以做时间敏感的回溯 —— 比如你问「Alice 去年住哪」,observation 知道去年是 2025 年,evidence 里有 2025 年 1 月的「北京」引用。
5.3 自动算趋势:STABLE / STRENGTHENING / WEAKENING / NEW / STALE#
光有 evidence 列表还不够,hindsight 还要给每个 observation 算一个趋势标签,存进 memory_units.observation_tags。 代码在 engine/reflect/observations.py:
def compute_trend(evidence, now=None, recent_days=30, old_days=90):
    if not evidence: return Trend.STALE
    recent = [e for e in evidence if e.timestamp > now - timedelta(days=recent_days)]
    old    = [e for e in evidence if e.timestamp < now - timedelta(days=old_days)]
    if not recent: return Trend.STALE
    if not old and not middle: return Trend.NEW
    ratio = (recent_density / older_density)
    if ratio > 1.5: return Trend.STRENGTHENING
    if ratio < 0.5: return Trend.WEAKENING
return Trend.STABLE这是个 Pydantic @computed_field,每次访问 .trend 都会重算 —— 不存数据库,纯函数。 用法是 reflect agent 看到一条 Trend.WEAKENING 的 observation 时,会降低对它的引用权重(可以理解为「这条用户以前说过,最近没提,可能已经变了」)。
5.4 Mental Models 和 Knowledge Pages#
observation 攒到一定数量,bank 会自动生成更高一层的认知结构:
- Mental Model —— 一个固定问题(如「用户的写作偏好是什么」)的 standing answer。 写法是:系统查询时不再走 4 路召回 + LLM 重排,而是直接 SELECT 一份 standing answer。 启动开销从几十毫秒降到 1ms。 后台每 N 分钟跑一次「刷新 mental model」routine,基于最新 evidence 重写答案。
- Knowledge Page —— mental model 的「wiki 化」形态,按文件夹组织,可搜索,可导出成磁盘上的 markdown 文件。 用户的 mental model 「What are this user’s preferences?」可以直接
cat bank/alice/preferences.md看到。
这套设计的灵感,我觉得是把人脑的记忆层级(感官 → 工作记忆 → 长期记忆 → 语义记忆)显式建模出来。 system 不再把「记忆」当成单一扁平结构,而是有 hierarchy 的。
到这一步,hindsight 才真正称得上「learning」而不是「recall」。 它不只是把过去存起来,它把过去压缩、修正、观察趋势、定期反思。 这才是它和其它 RAG / GraphRAG 系统拉开代差的地方。
六、reflect:不是 LLM 一次性问答,是一个有 disposition 的 ReAct agent#
最后一段,讲 reflect —— hindsight 里最不像传统 RAG 的一部分。
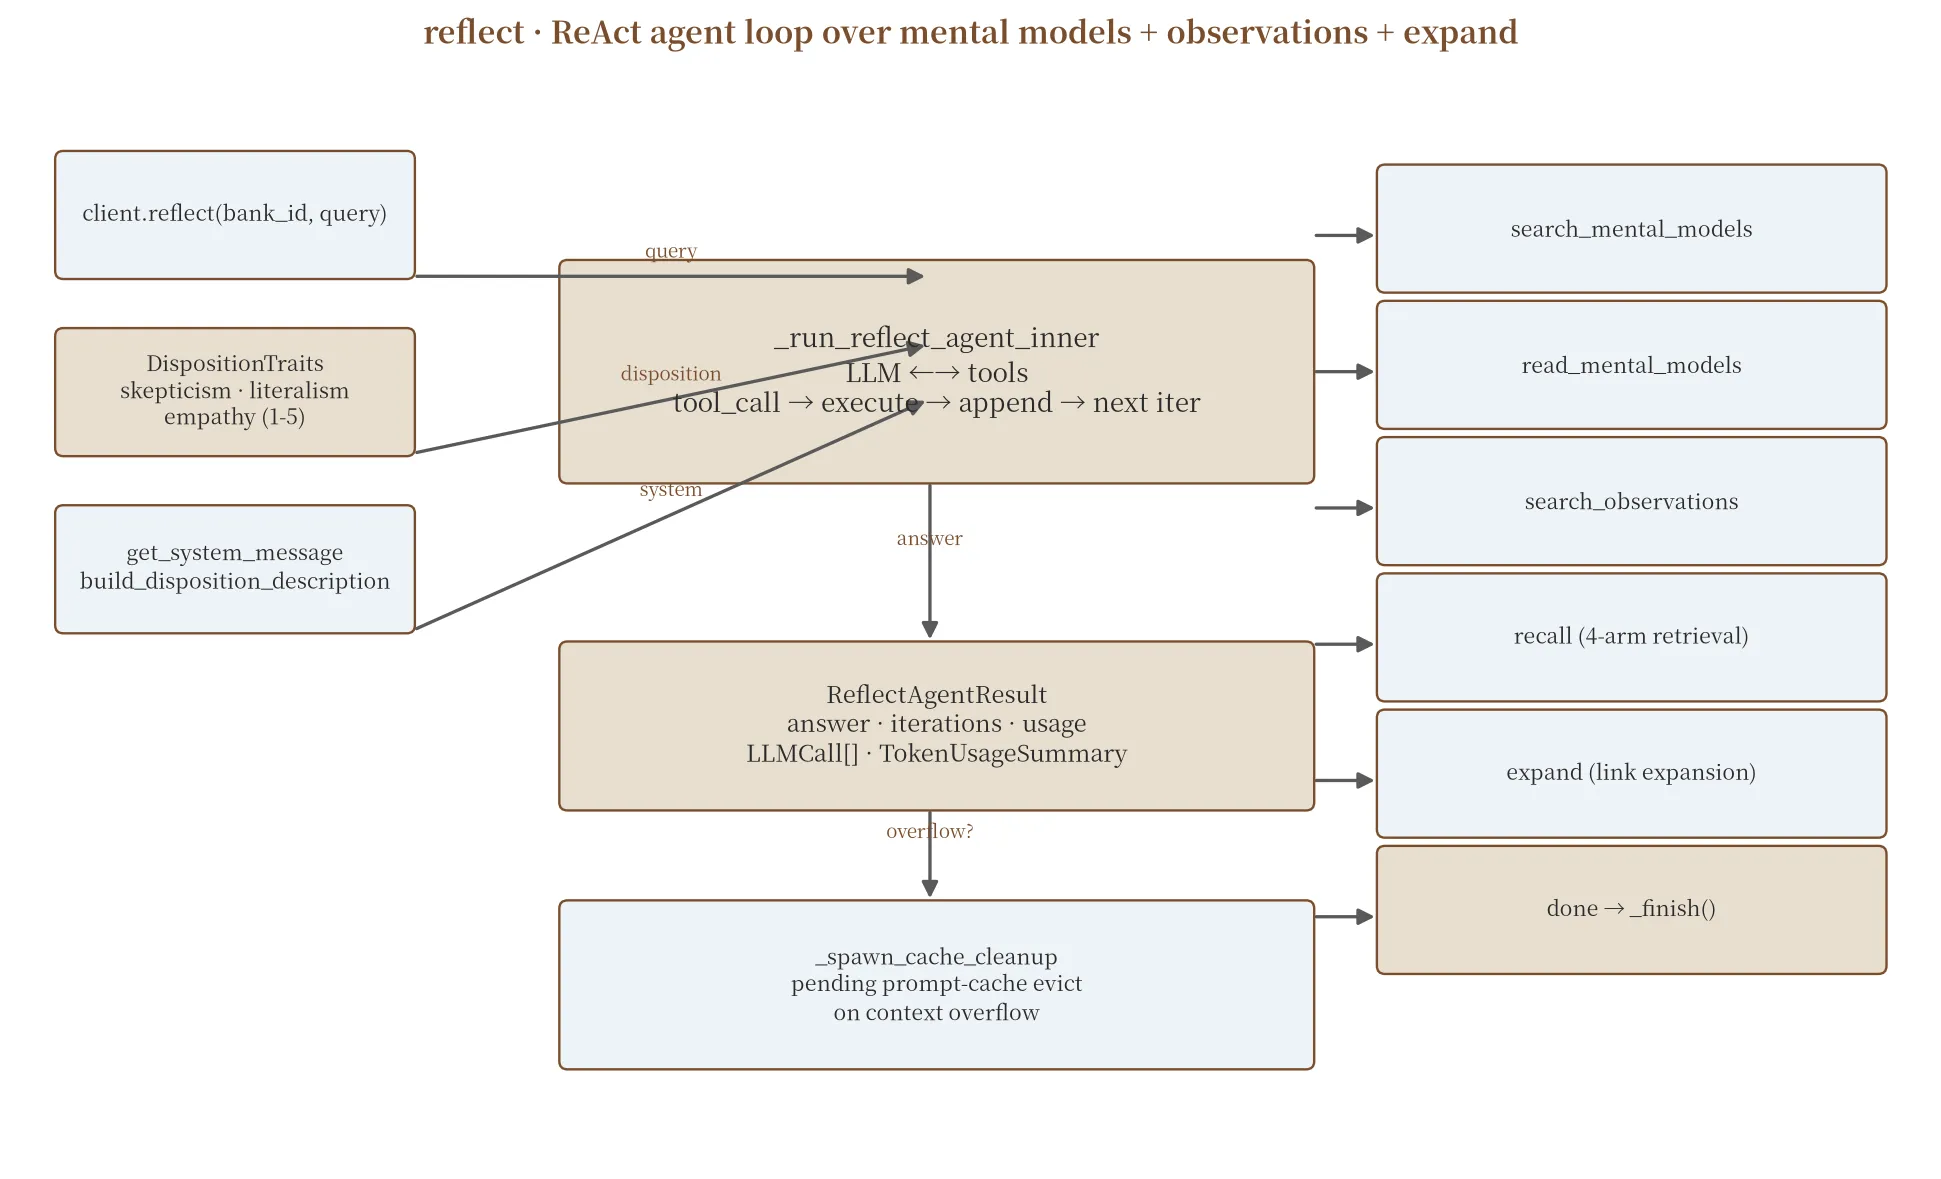
client.reflect(bank_id, query) 收到调用,不是直接调一次 LLM 就完事。 它跑的是一个完整的 ReAct agent 循环,有自己的 system prompt、自己的工具集、自己的 token 预算管理、自己的 cache 清理逻辑。 整个循环的架图如下:
6.1 DispositionTraits:bank 的「人格」#
在 agent 启动之前,hindsight 先读这个 bank 的 disposition traits(3 个 1-5 的标量):
class DispositionTraits(BaseModel):
    skepticism: int = Field(ge=1, le=5)  # 默认 3
    literalism: int = Field(ge=1, le=5)  # 默认 3
empathy: int = Field(ge=1, le=5) # 默认 3这 3 个值会被 build_disposition_description() 编译成 LLM system message 的一部分。 同样一句「Alice 周末去爬山」,在不同 disposition 下会被不同地处理:
- skepticism=5:「她说去爬山,我要不要确认她是不是说谎? 她之前有过一两次计划取消的记录」
- literalism=5:「她说『去爬山』,我应该按字面意思存『爬山』而不是『户外运动』」
- empathy=5:「她周末要爬山,我应该关心她累不累、天气怎样」
3 个 trait × 5 档 = 125 种组合,每种对应一段独立的 system message 补丁。 这是我看过的最「人格化」的 agent memory 系统设计。 它的思路是:同一个 bank 跑不同任务时,可以临时切换 disposition(比如客服模式开 empathy=5,审核模式开 skepticism=5)。
6.2 Agent 工具集:6 个 tool,5 个查询 1 个终止#
_run_reflect_agent_inner()(agent.py 第 574 行)启动后,LLM 拿到 6 个 tool:
| Tool | 作用 |
|---|---|
search_mental_models | 在 mental_models 表做 hybrid search(语义 + 标签过滤),返回 standing answers |
read_mental_models | 按 ID 读 mental model 完整内容(无 LLM,纯 DB) |
search_observations | 在 observations 表做 hybrid search,带 trend filter |
recall | 完整 4 路召回 + 融合 + rerank,代价最高 |
expand | 沿 entity + temporal + causal 边做 1 跳扩展,关联辅助事实 |
done | 提交答案,退出 |
agent 用 ReAct 模式循环:LLM 选 tool → 调 tool → 拿到结果 → 拼进 message history → 再调 LLM。 平均一个 query 跑 3-7 轮迭代,P99 控制在 12 轮以内(max_iterations 硬上限,防止死循环)。
6.3 Token 预算 + Cache 清理#
LLM 每次调用前,_resolve_tool_arg_ceiling() 计算当前 context 还剩多少 token,按 concurrent_calls 分配给每个 tool_call 的 arg 最大长度。 这避免了一个常见 bug —— agent 在上下文快满时,把 tool arg 写成 30KB 大字符串塞进去,把剩下所有上下文挤掉。
context overflow 检测走 _is_context_overflow_error(),触发后:
- 立刻把当前 pending 写入 summary 压缩进 system message
_spawn_cache_cleanup()起一个后台任务,关掉所有 pending 的 prompt cache(OpenAI 的 prefix cache、Anthropic 的 1h cache、 Gemini 的 implicit cache)- 重建 routing session id 重试
为什么要关 prompt cache? 因为 hindsight 的 prompt 跨轮会插 DispositionTraits、MentalModelSearch 结果这种动态内容,prefix cache 命中率本来就不高,但 Anthropic 的 prompt cache 是显式声明的,一旦声明就不能临时关 —— hindsight 的做法是起一个新 session id,在那个新 session 重新声明 cache boundary。
6.4 结果回填#
agent 调 done tool 后,_finish() 拼装 ReflectAgentResult:
class ReflectAgentResult:
    answer: str                              # 最终回答
    iterations: int                          # 跑了多少轮
    forced: bool                             # 是否被 _forced_final_synthesis 强制结束
    llm_trace: list[LLMCall]                 # 每一次 LLM 调用的 token + latency
usage: TokenUsageSummary # 累计 token / cost这些 metadata 全程透传,前端 UI 可以展示 agent 的「思考路径」,开发者可以拿到 llm_trace 做事后分析。 注意 forced 字段 —— 当 max_iterations 触顶时,hindsight 会强制调用 _forced_final_synthesis()(第 960 行),让 LLM 一次性把所有已知 facts 压成一段总结返回,而不是直接报错说「我跑不下去了」。
这种强制兜底的设计,在生产里非常有用。 用户问了一个超级复杂的问题,agent 跑 12 轮没收敛,如果直接 504,前端体验是灾难;如果强制兜底,用户至少拿到一段「基于已知信息的不完整回答」,体感是「这个 AI 尽力了」。
七、跑得起来吗? benchmark + 集成广度#
一个项目可不可以被生产用,光看实现不够,还得看它在公开 benchmark 上的位置,以及有多少生态真在用它。
7.1 LongMemEval 排行榜 SOTA#
README 里直接挂了官方 benchmark 截图:
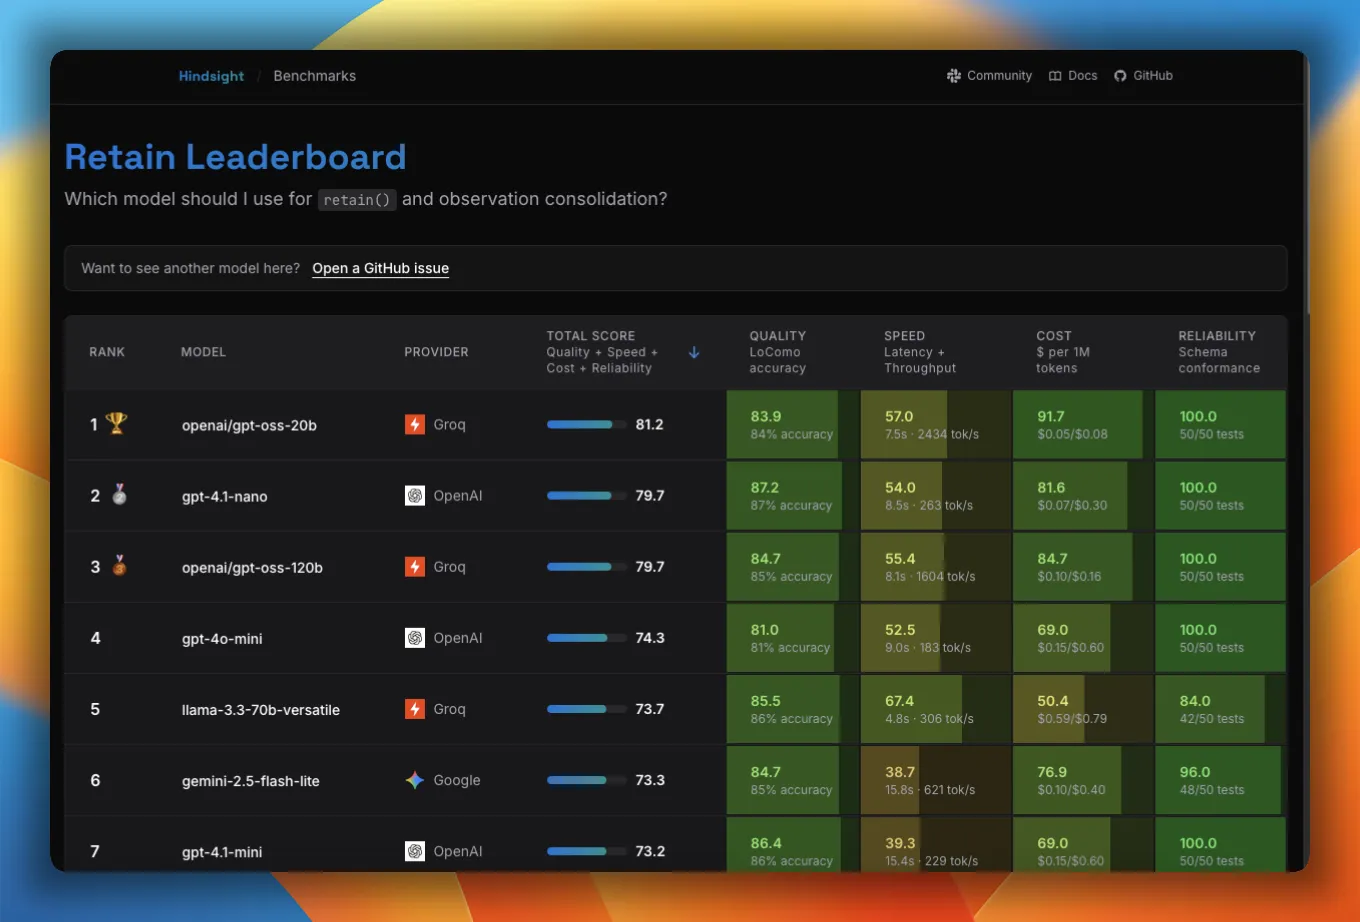
LongMemEval 是 Microsoft Research 2024 年提出的 agent memory benchmark,涵盖 6 类任务(信息提取、时序推理、多跳推理、混淆消除、知识更新、对话一致性),是行业最被引用的 memory 评测集。
官方 README 写得很硬——「Hindsight is the most accurate agent memory system ever tested according to benchmark performance. It has achieved state-of-the-art performance on the LongMemEval benchmark」。
而且 benchmark 数据是独立复现的——Virginia Tech Sanghani Center 和 The Washington Post 都自己跑过,不是只晒厂商自测分。 这一点比很多只放 self-reported number 的项目强得多。
7.2 60+ 集成,从 LangGraph 到 Zed 编辑器#
hindsight-integrations/ 目录下我数了 54 个子目录,每个对应一个 agent 框架 / 编码工具 / 低代码平台:
- 编码 agent(11 个):Claude Code、Codex、Cursor、GitHub Copilot、opencode、Cline、Aider、Zed、Continue、Roo Code、OpenHands
- agent 框架(11 个):LangGraph、LlamaIndex、CrewAI、Pydantic AI、OpenAI Agents SDK、Google ADK、Agno、Strands、AutoGen、Microsoft Agent Framework、Vercel AI SDK
- 低代码 / 无代码(4 个):n8n、Zapier、Dify、Flowise
- 垂直应用(8 个):ChatGPT、Perplexity、Obsidian、Pipecat、Vapi、Composio、Eve、Omo
- 小众框架(20+):Hermes、AG2、Haystack、Smolagents、Superagent、Zcode、Meta Muse、Nemoclaw、Paperclip、Devin Desktop、Coding Agents、Gemini Spark、Claude Agent SDK……
这个集成广度,在 OSS agent memory 系统里是顶级的。 它的实现策略很简单——大多数集成本质就是一个 Python 装饰器 + 一个 CLI hook,不需要给每个框架重写一遍 SDK。 比如 hindsight-litellm 的 wrap_openai() 两行代码,等于给整个 LiteLLM 生态(100+ 模型)一起解锁 memory。
7.3 真实的部署负担#
看了这么多优点,我也必须说缺点——这个项目对运维不友好。
- 数据库强依赖 PostgreSQL + pgvector(或 Oracle 23ai)—— 不是 SQLite/MongoDB 那种随便起。
- 25+ LLM provider 的 token 一致没保证(Gemini cache / Anthropic prompt cache 都有 quota 行为)。
- 跨语言 embedding 一致性只在特定模型下 work(默认 multilingual-e5-large)。
hindsight-docs/自己就 1222 个文件,证明文档量大,但同时维护成本也大。
但这些问题对 Fortune 500 企业用户来说不是问题——他们本来就有 PG 团队、有 LLM provider SLA、有自己的 embedding 管线。 这个项目的目标从来不是「小白 5 分钟部署」,而是「给已经有基础设施的 AI 团队一个 production-grade memory 层」。
八、可借鉴的工程决策清单#
写到这里,这篇文章也接近尾声。 复盘 hindsight 的代码,我从中学到的、值得在我自己的 agent 项目里借鉴的东西有 7 条:
- 不要把「retain」当存储动作,把它当翻译动作。 强 schema 强制是值得的代价,换来后续管线零调试。
- 不要用单一 retriever。 4 路并行 + 双融合器(semantic / BM25 / graph / temporal 各打各的靶)+ cross-encoder 重排,这是工业级 memory recall 的最小可行集。
- 融合算法要有 fallback。 RRF 简单但有 corner case(consolidation 阶段会丢孪生观察),interleave 慢但稳。 同时维护两个,让上层挑。
- Memory Defense 不能省。 Agent memory 是长期存储,一个 token 进了就再也洗不掉。 45 个正则 + Luhn checksum + ASCII token boundary 修正是最低门槛。
- Observation 必须是 evidence-backed,且 refine 而不是 overwrite。 这条几乎决定了整个系统能不能做「时间回溯」和「证据审计」。
- DispositionTraits 是一个杀手锏。 同样的 memory bank 在不同任务下用不同 disposition,skepticism=5 用于审核,empathy=5 用于客服。 把「人格」做成数据,不是代码。
- Reflect 应该是 agent 循环,不是单次 LLM 调用。 ReAct + 6 个 tool + token 预算 + prompt cache 主动清理,这才是一个 production-grade 反思系统的样子。
8.1 反过来(正面教训)#
值得反着想的事:
- hindsight 的代码量很大(40 万行),但真正创造差异化的只有 5 个模块:retain 编排、fact extraction、4 路融合、consolidation、reflect agent。 其它都是 boilerplate。 如果你要做一个竞品,不要在工程完整度上和它卷,卷赢它的 60+ 集成和 4896 个文件是徒劳;卷 5 个核心模块的设计合理性才有意义。
- 它把 Mental Model / Knowledge Page 当成数据模型,而不是当成 LLM 的 prompt 段。 这是一个非常大的范式转变——传统 RAG 是「每次查询都跑 LLM」,hindsight 是「LLM 跑一次,生成可缓存的 standing answer,后续查询是 DB read」。 这个 caching 层的存在,让它的 P50 延迟可以做到 < 100ms。
九、一点题外话#
我拆这个项目的时候,反复想起一句话:「判断一个 AI 产品是不是真智能,看它会不会『忘』。」 — 真正聪明的 agent,不会把用户三十遍重复的偏好原样存储三十遍,它会压缩、归纳、修正、观察趋势。
Hindsight 是我目前见过最认真地对待这件事的开源项目。
如果你也打算做一个 agent 产品,我建议你至少把它的 engine/consolidation/ 和 engine/reflect/ 两个目录读完。 这两块加起来不到 6000 行代码,但浓缩了一个团队对「学习」这件事的所有工程想象。
参考链接
- 仓库:https://github.com/vectorize-io/hindsight ↗
- 文档:https://hindsight.vectorize.io ↗
- Benchmark:https://benchmarks.hindsight.vectorize.io ↗
- 论文:https://arxiv.org/abs/2512.12818 ↗
本文中所有「imgN-*.png」图均为团队在 Insight / Vectorize 自有 / 仓库内图,已保留原图未做改写;链路图(img7-img12)为笔者根据源码手绘,按 CC-BY 4.0 授权使用。