Colibrì 深度解析:用 12 万行纯 C 把 744B MoE 塞进 25GB 笔记本
💬 评论一个 12 万行纯 C 写的 MoE 推理引擎,把 744B~2.8T 参数的前沿模型跑在消费级硬件:三层内存层级化、JIT 式权重调度、KV 缓存持久化、双 SSD 镜像与九模型族。
“Tiny engine, immense model.” — 在你 25GB 的笔记本上跑 744B 参数的前沿模型,听起来像营销话术,但 JustVugg/colibri ↗ 把它做成了 12 万行纯 C、零依赖、CPU/GPU 通吃的工程现实。九个模型族(GLM-5.2/5.3、Inkling 975B、Kimi K3 2.8T、DeepSeek V4 Flash/V4.1 Flash、Qwen3.8/3.6、OLMoE)共用一个
coli前端,一个colibri.c(12237 行)+ 8 个模型族.c文件,跑同一个二进制。
这篇文章我想聊的不是一个”快”的推理引擎——6×RTX 5090 上 6.84 tok/s 算不上惊艳。Colibrì 真正的诱惑在于它的架构取舍:它公开承认 “no SLA on speed, hard guarantee on semantics”——优化是假说,得用端到端 A/B 自证;并把每个反直觉的工程决定都用日期+对话上下文写在代码注释里。我读完它的 12237 行主文件、quant.h(2102 行)、README(1500+ 行)、CHANGELOG(170+ 行)和二十多份 docs/*,感受到的是一种罕见的工程姿态:把优化做成可证伪的科学,而不是营销文案。
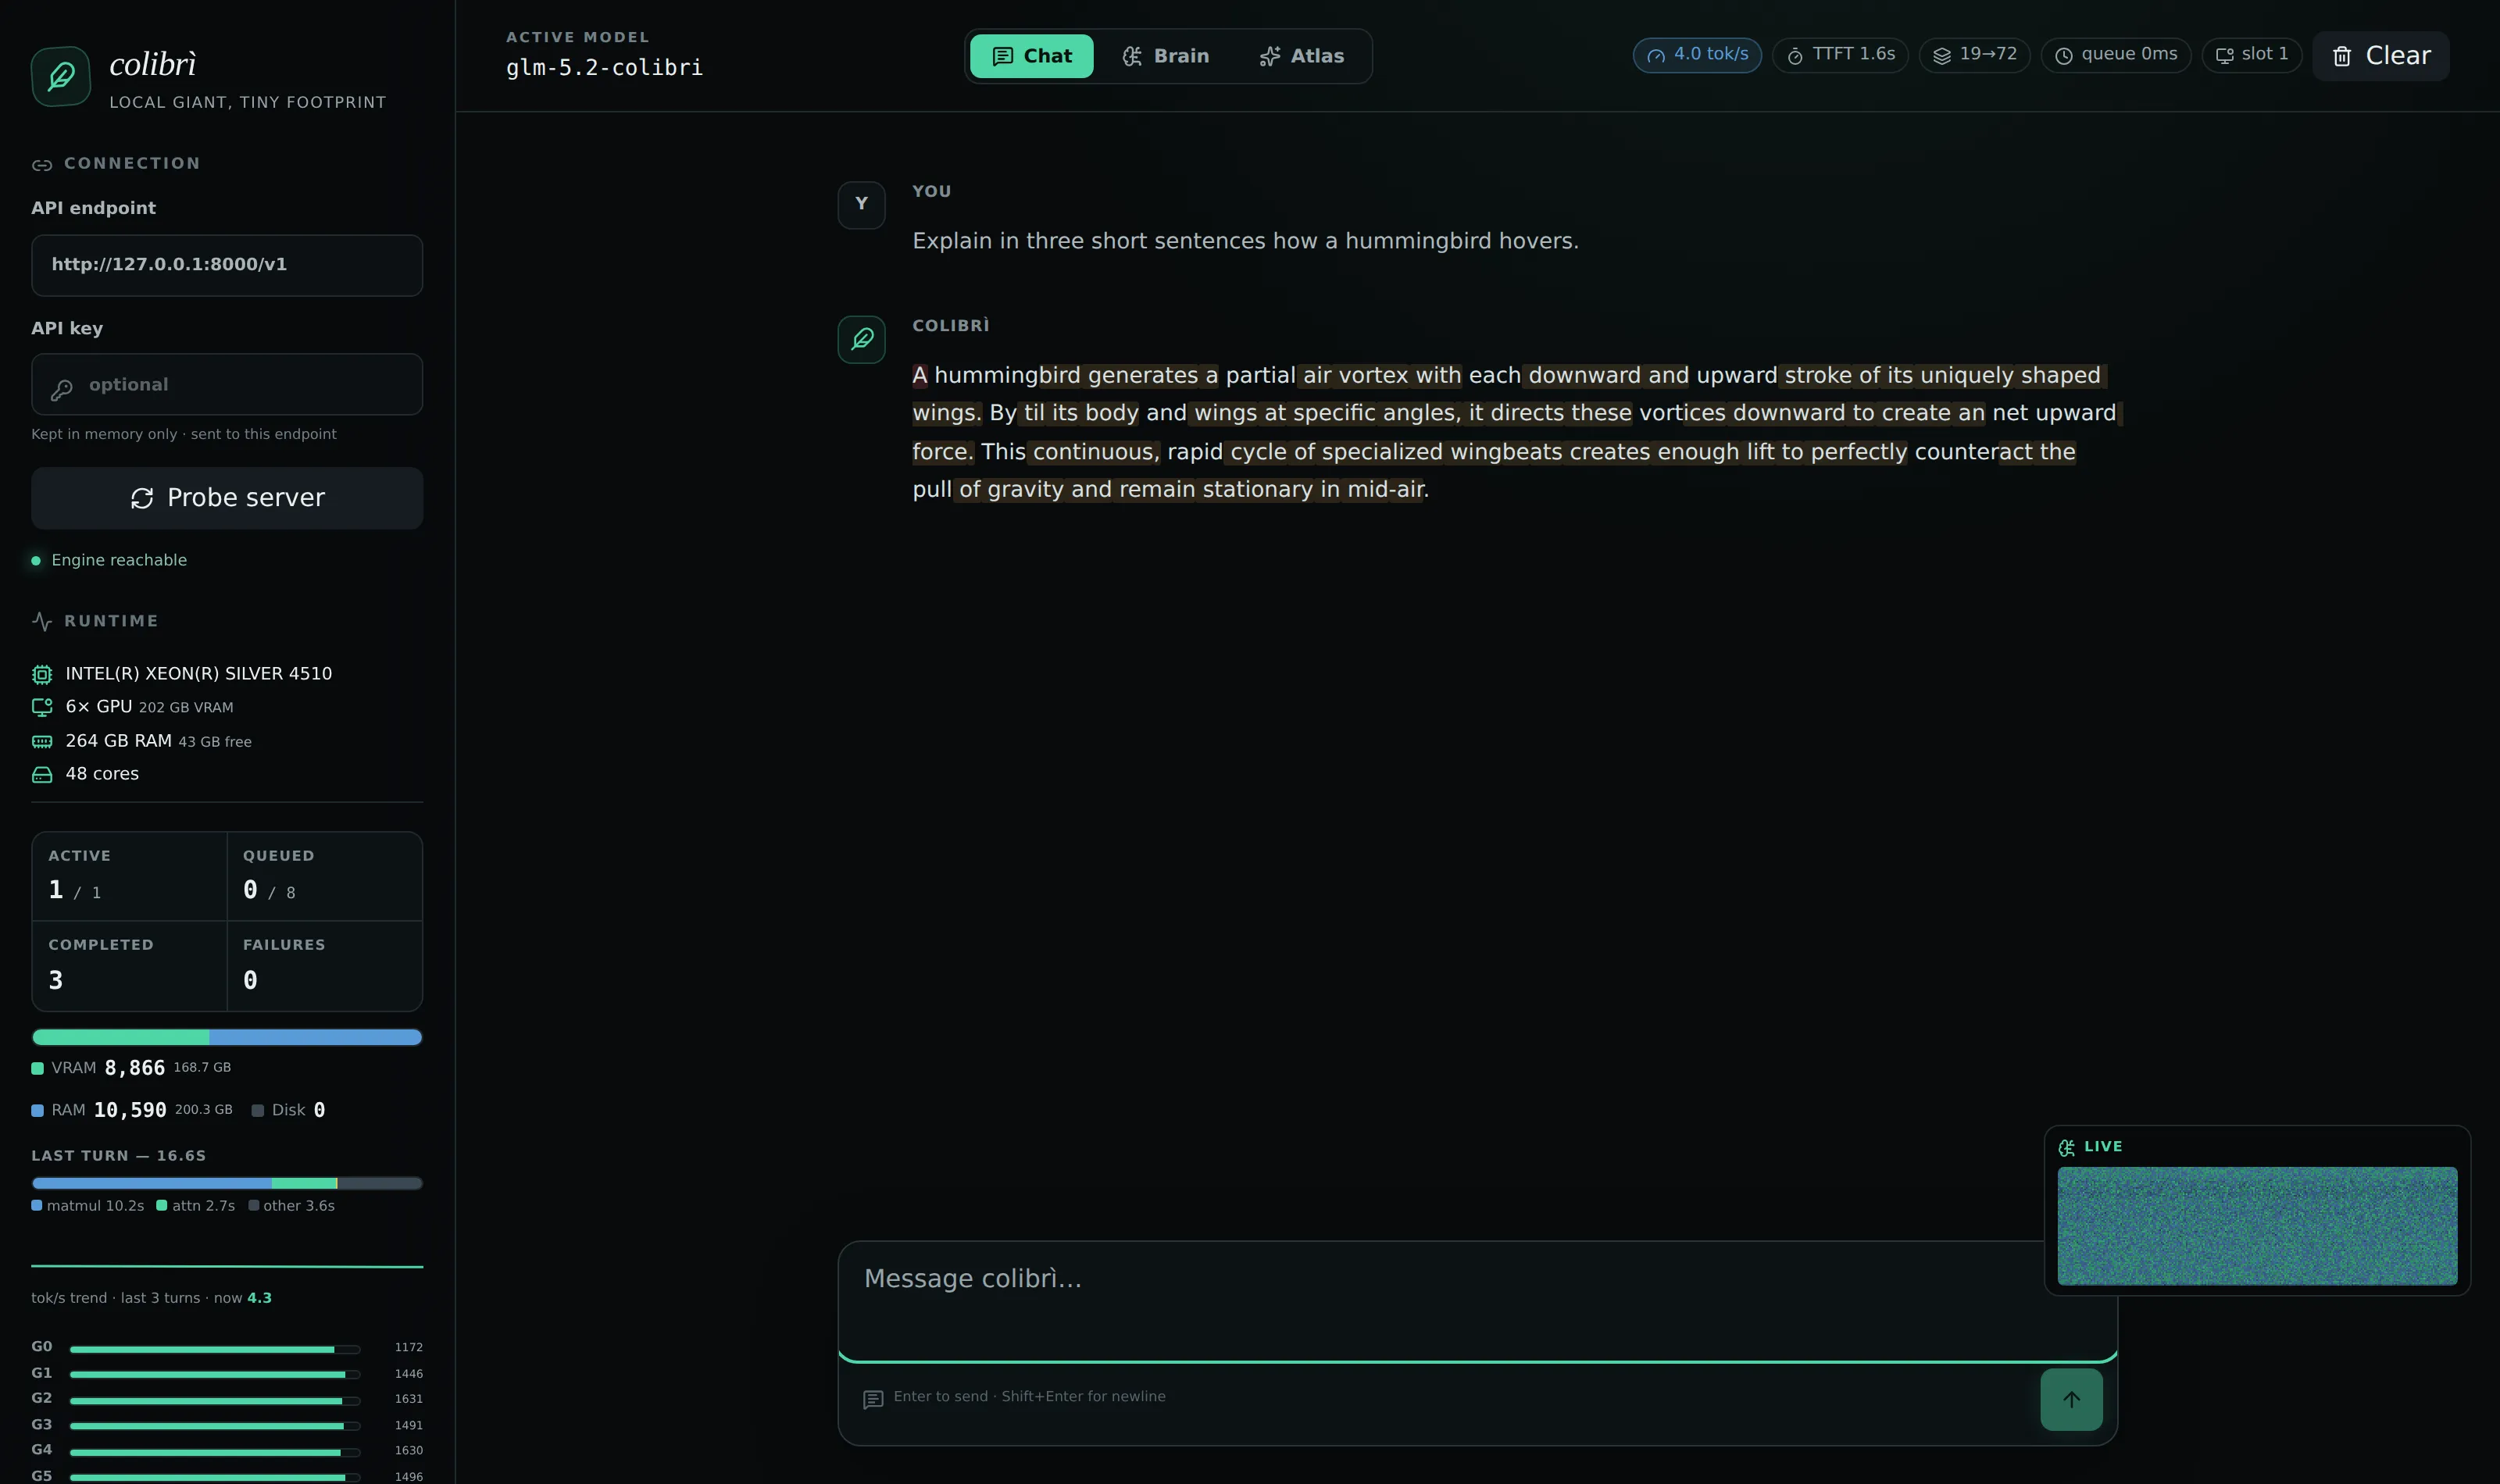
先看一张图:
这张 dashboard 跑的是 GLM-5.2 744B——75 层 MoE × 256 路由专家,4 tok/s decode、TTFT 1.6 s、disk 读数 0。因为专家全驻留在 VRAM+RAM 上,decode 阶段完全不碰磁盘。下面我会一层层拆:它怎么用三层存储统一调度 744B 参数,怎么让 25GB 笔记本也能跑这个量级的模型,以及那些藏在注释里的”血泪决定”。
一、问题的本质:Fit vs Place#
先抛开 Colibrì,理解 MoE 推理的物理现实:
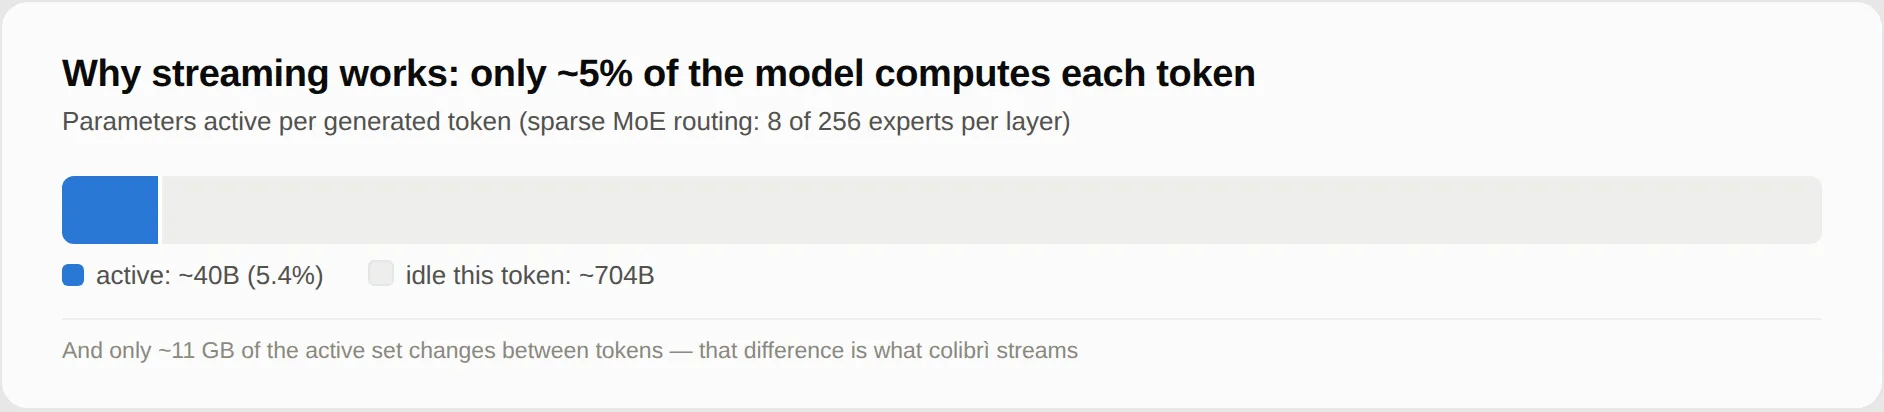
- 744B 参数的 GLM-5.2,每 token 只激活 ~40B(~5.4%)。
- 但每个 token 实际”换”掉的参数只有 ~11GB(75 个被路由专家 × 每个约 19MB@int4)。
- 驻留部分(attention、shared expert、embedding、router、norm)只有 ~17B 参数,int4 量化后约 9.9GB,可以常驻 RAM。
直觉告诉你:应该把 744B 全装进 GPU。但一台 RTX 5090 32GB 装不下,6×RTX 5090 192GB 也只够全精度。Colibrì 的关键洞察:你不应该让模型”fit”(塞进)快内存,应该让它”place”(分层放置)——分层只影响速度,不影响正确性。
“Limited fast memory changes speed, not model semantics.”
这就是 12237 行 c/colibri.c 顶部那段意大利语注释想说的事情——“Stadio B: replica fedele del forward di transformers”。forward pass 在任何层、任何精度下都 byte-identical,只在 I/O 时间上不一样。这个保证来自 token-exact 验证(teacher-forcing 通常 30-32/32 token 一致),不是营销承诺。
二、12 万行代码长什么样#
代码规模(粗略统计):
- C/H 文件:245 个
- 总行数:约 122744 行
- 核心单文件:
c/colibri.c:12237 行(主引擎,全部共享基础设施)c/deepseek_v4.c:18348 行(DeepSeek V4 全套实现)c/quant.h:2102 行(header-only,所有量化 matmul 内核)c/kimi_k3.c:4084 行 /c/qwen36.c:3802 行 /c/glm53.c:3747 行c/inkling.c:3261 行 /c/deepseek_v41.c:3522 行 /c/qwen38.c:2661 行 /c/olmoe.c:2272 行
观察:一个族一个 .c 文件,而且这些文件是真正的”族实现”,不是骨架 + Python 派发器。colibri.c 共享 I/O、KV、CLI、serving;族文件实现 MoE 路由、attention、forward。每加一个新模型族只需要 ~3000 行 C,不需要碰主引擎。
这种”垂直整合”的代码组织在过去十年的 ML 系统里几乎是异类——大家要么 Python 重写(vLLM、HF),要么 kernel 库拼装(TensorRT-LLM)。Colibrì 选了最朴素也最难维护的路径:全部写在一个二进制里。代价是每个族都得自己 fork 一份 attention 实现,好处是零依赖、零 FFI 开销、零版本兼容问题。
三、JIT for Weights:把参数当数据流来编译#
Colibrì 自称是一个 “JIT, but for weights”。理解这一点是理解整个设计的关键:
“A compiler JIT never compiles the whole program — it watches what actually runs and compiles the hot paths, just in time. colibrì makes the same bet about a 744B parameter space: parameters are not resident state to be held, they are data to be staged across a heterogeneous storage hierarchy.”
传统推理引擎(vLLM、SGLang、llama.cpp)把权重当成常驻状态,通过 PagedAttention、block manager 等技术优化 KV 缓存,权重本身假设在 HBM。Colibrì 反过来:假设权重永远不在 HBM,你需要什么、什么时候要、放在哪一层,全部是 runtime 决策。
具体实现是 c/tier.h 的 70 行 static inline:
/* Shared admission contract for every adaptive resident tier.  Widen before
 * adding the margin: a saturated uint32 heat counter must become sticky, not
 * wrap the threshold and admit a colder expert. */
static int tier_should_promote(uint32_t hot, uint32_t cold){
    uint64_t threshold=(uint64_t)cold+((uint64_t)cold>>2)+4u;
    return (uint64_t)hot>threshold;
}

/* LFRU: frequency is the primary signal; recency breaks close calls. A recent
 * access contributes at most 255 points while one frequency count is worth
 * 256, so a merely recent expert cannot displace a genuinely hotter one. */
static uint64_t tier_lfru_score(uint32_t heat, uint32_t last, uint32_t clock){
    uint32_t age=clock-last, recent=age<255?255-age:0;
    return ((uint64_t)heat<<8)|recent;
}两层 LFRU(Least-Frequently-Recently-Used):
- 每个专家维护一个
heat(路由次数的指数衰减)和last(上次路由的 tick)。 - 决策驱逐时:频率优先,最近性辅助——一个 256 次路由、300 tick 没用的专家,比一个 50 次路由、5 tick 前用过的专家分更高。
- 提升门限带 25%+4 频率的滞回(防止 ping-pong),这点注释里特别写了。
但 LFRU 只是 RAM 这一层的算法。VRAM 这一层又是什么?
Learned pinned hot-store:colibri 维护一个 .coli_usage 文件,每次推理后追加专家路由记录。第二次启动时,它会自动 pin(钉住)历史上最热的专家到 VRAM。这就是 README 里反复强调的 “learns your workload”——用得越多,模型越快。但代码注释里也直说了:learned pins “can overfit a prompt”,所以这是个可证伪的假说而不是保证。
四、三层存储层级:VRAM/RAM/NVMe 一个调度器#
下图是 Colibrì 的灵魂:
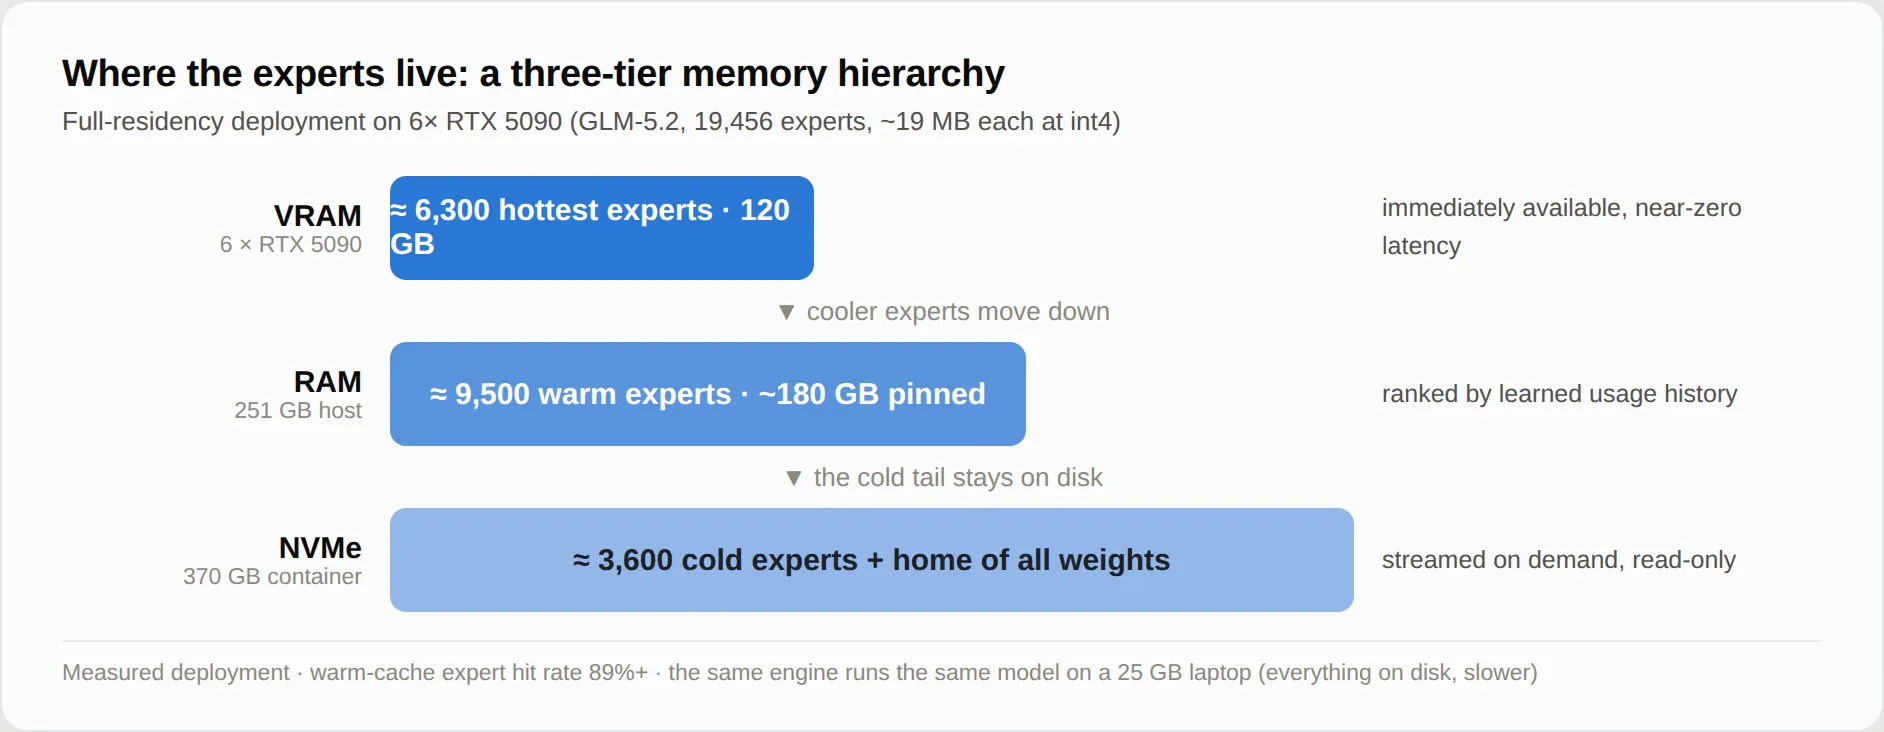
每一层的角色很清晰:
| 层级 | 容量(典型) | 装什么 | 带宽 |
|---|---|---|---|
| VRAM | 24-192 GB | 全驻留(pinned hot experts + dense + KV8) | 1-3 TB/s |
| RAM | 64-128 GB | 整份 int4 权重(~370GB 装不下时是 LRU 缓存) | 50-100 GB/s |
| NVMe | 1-4 TB | 完整模型 + .coli_kv + .coli_usage | 1-14 GB/s |
关键设计:每一层都跑同一份 forward,所以 “什么时候从哪一层取” 完全不影响 token 输出。这点是它能做出 “no SLA on speed, hard guarantee on semantics” 承诺的基础。
具体怎么读?看 c/colibri.c 第 1274 行的注释——讲 PIPE(异步 I/O 池)+ PILOT(路由器预取)两个核心机制如何重叠计算和 I/O:
“Each expert’s three matrices are stored adjacent and read in one
pread; a bounded async I/O pool (PIPE=1, default) loads missing experts while resident ones compute; batched positions read each unique expert once (batch-union); and a router-lookahead thread (PILOT=1) prefetches the next layer’s experts — routing is measurably 71.6% predictable one layer ahead.”
四个具体技术:
pread单次读完整专家:每个专家的gate/up/down三个矩阵存储相邻,一次pread全拿,而不是三次小读。- PIPE 异步 I/O 池:worker 线程在 resident experts 算 forward 时,后台
pread缺失的 experts。默认开(PIPE=1)。 - Batch union:批量位置解码时,同一层的多个 token 路由可能重复到同一个专家——只读一次。这是 colibri.c 第 1000 行附近的
ecache_slot_by_expert数据结构干的事。 - PILOT lookahead:路由器提前一层预取——这能成立是因为 LLM 路由有 71.6% 的”层间可预测性”。同一工作组在 #200 ↗ issue 里实测过这个数字。
五、双 SSD 镜像:把两盘带宽”串”成一条#
如果你的瓶颈是磁盘,加块 SSD 不行吗?Colibrì 给出了更聪明的答案——双 SSD 镜像(COLI_MODEL_MIRROR):
COLI_MODEL=/fast/glm52_i4 COLI_MODEL_MIRROR=/second/glm52_i4 ./coli chat实现要点(README 第 215-235 行):
- 校验对等:启动时校验每个 shard 的 size + safetensors header 字节一致,不一致也不崩,默默回退主盘。
- 确定性哈希路由:每个专家按
hash(expert_id) % 2分流到主/副,按两盘测得带宽比例加权(COLI_DISK_WEIGHTS=9,3表示 9:3)。 - 副盘不写:
.coli_usage、.coli_kv、所有 sidecar 永远写主盘。 - 失败降级:副盘读失败只 warn 不崩,热插拔可用。
- 部分镜像:如果副盘只装得下 200GB,可以
mirror plan/stage/verify只镜像最热的 expert shards。
实测数字:一块 9 GB/s + 一块 3 GB/s NVMe,decode 提速 ~33%(比单盘快盘还快 33%)。这个数字看起来很美,但 README 老实说:
“weighted mirror/split routing is implemented and validated; the bandwidth model is sound — cold-cache one-drive vs two-drive GLM-5.2 runs on real, independent controllers [还需要社区 A/B]”
可证伪,不是保证。
六、KV 缓存持久化与 57× 压缩#
KV 缓存在长对话里是真正的痛点——重启引擎意味着整段历史重新 prefill。Colibrì 给的解法是 kv_persist.h:
#define KV_MAGIC  "COLIKV1\0"                    /* v1: righe Lc/Rc f32 */
#define KV_MAGIC2 "COLIKV2\0"                    /* v2 (KV8): righe fp8 e4m3 + scala f32 per riga */
#define KV_MAGIC3 "COLIKV3\0" /* v3 (KV_TQ): righe PolarQuant + raggio f32 per riga */- v1:MLA 注意力 row 完整 f32。
- v2(
KV8=1):fp8 e4m3 + per-row scale,576 floats/token。 - v3(
KV_TQ=3|4):PolarQuant 极坐标量化+ 每行半径,更窄。
这三个版本的共同特性:MLA 压缩 KV,每个 token 只存 576 floats 而不是 32K,57× 缩小。
更重要的是 .coli_kv 的crash-safe 增量写入——每条新 turn append 到文件,nrec 字段最后写,crash 后能安全 truncate 到已确认的 record 边界。代码注释第 50 行明确警告:
“Mai scrivere nell’header piu’ record di quanti ne esistano fisicamente: un append saltato (OOM dello staging, open fallita) lascia disk_nrec<len, e un truncate al prefix comune dentro quel buco estenderebbe il file su record MAI scritti”
这种注释质量在生产级 C 代码里非常罕见——既讲为什么,又讲踩过什么坑。重启后:对话暖启动,零 re-prefill,byte-identical 继续。这是我见过的最干净的 KV 持久化设计之一。
七、MTP 推测解码与”诚实”投机#
GLM-5.2 的 MTP head(mtp_draft layer,512 行代码)负责生成 draft tokens,主模型一次 forward 全部验证。README 给的实测数字:
“MTP speculation (int8 head) 2.2–2.8 tokens/forward measured”
但 CHANGELOG 立刻诚实补充:MTP 不是银弹——两个 hard-won rule:
- MTP head 必须 int8。int4 heads 接受率掉到 0-4%(#8)。
- draft 与 verify 必须算同一个函数(
SPEC_PIN=1钉死一个 kernel family,#163)。
更精彩的是 README 表格里这一行:
| routing-aware speculation 可以覆盖近全驻留场景 | MTP 和 grammar drafts 能工作,但 MTP 在 85% expert hit 时实测有 32% loss | 在 acceptance、expert hit rate、batch union、draft depth 上扫一遍 |
承认负结果——MTP 在某些工况下反而亏损。这个洞察在大部分”性能优化”博客里你不会看到。
另外还有 grammar-forced drafts(GRAMMAR=file.gbnf)——给约束 JSON 输出加 ~免费 acceptance。c/grammar.h 配 schema_gbnf.h 把 JSON-Schema 编译成 GBNF 语法喂给采样器。这是和 llama.cpp 的 GBNF 子集一样的设计。
八、稀疏注意力:DSA lightning indexer#
GLM-5.3-Flash 用的是 DeepSeek 风格的稀疏 attention + k-pooling。c/sparse_index.h 给出了完整实现,核心思路:
“With k-pooling the keys are first grouped into pools of
pooltokens; the pools are scored and selected, and the winners expand back into their token indices. Selecting 512 pools of 4 instead of 2048 tokens is the same budget with a quarter of the scoring.”
四个保字正确的规则(注释写得很密):
- 池内混合是per-channel softmax mixture,不是平均(否则一个池会被强制用均值描述自己)。
- 池必须 COMPLETE(每个成员都在)且最后一个 token 因果可见于 query。
- 不完整的尾部无条件追加,这就是输出宽度是
topk + pool - 1而不是topk的原因。 - 并列时取较小池索引,选择是确定性的。
分数带 ReLU(if (dot > 0),因为 ReLU 对正 scale 可交换)。
未选中的槽位是 -1,attention 计算会跳过。调用方不能把宽度当成数量——这个陷阱注释里专门警告。
DeepSeek V4.1 Flash 还把 DSA indexer 推到了两级候选源(hyper_connections.h),第一层选 2048 块 × 8 位置 = 16384 候选池,第二层只在池里选。CHANGELOG 1.11.0 写得清楚:vision tower 也用同一个 engine,3.5 bit/weight 的 int3 per-group scale 是质量/尺寸甜点。
九、九个模型族 × 三套 GPU 后端#
CUDA / Metal / Vulkan 三套 kernel 的存在本身说明了 Colibrì 的姿态——任何能跑 MoE matmul 的硬件都被一视同仁。
| 后端 | 文件 | 适用 | 关键能力 |
|---|---|---|---|
| CPU | colibri.c 主路径 + quant.h | 任何 x86/ARM,零依赖 | AVX2/AVX-512/AVX-VNNI/NEON/NEON-SDOT/NEON-i8mm/POWER VSX 全谱 SIMD |
| CUDA | backend_cuda.cu + backend_cuda_dsv4.cu + backend_cuda_ink.cu | NVIDIA 全家 | RTX 5090 上 6.84 tok/s 全驻留 |
| Metal | backend_metal.mm | Apple Silicon(M1/M2/M3/M4) | 利用 unified memory |
| Vulkan | backend_vulkan.c | AMD/Intel/Vulkan 1.2 驱动 | 唯一支持厂商放弃维护的卡(如 RX 580) |
Vulkan backend 的存在尤其让我注意到——Mesa/RADV 下 AMD RDNA4 上和 ROCm 性能有竞争力。README 提到的 docs/metal.md 和 docs/vulkan.md 各自有 perf report。
九个模型族(CHANGELOG 1.11.0,2026-09-13):
- GLM-5.2 744B MoE / GLM-5.3 同款 + vision
- GLM-5.3-Flash 321B 带 vision
- Inkling 975B
- Kimi K3 2.8T(MXFP4 原生 checkpoint,无需转换)
- DeepSeek V4 Flash 284B
- DeepSeek V4.1 Flash 552B 带 vision,Engram(196B 2/3/4-gram)、DSA 两级候选源、hyper-connections、DSpark 推测、vision tower
- Qwen3.8-Flash-Next 125B + 51B n-gram
- Qwen3.6 35B-A3B
- OLMoE 7B
新增 DeepSeek V4.1 Flash 这一族耗时数月,CHANGELOG 写得很坦白:
“Held token-exact in CI against a torch-only CPU reference at three cache capacities, on a short and a 40-token prompt, under all three speculative modes; the vision tower is matched to 5e-06.”
5e-06 容差的 vision tower 校验,在 CPU reference 上。这个数字让我对项目的严谨度彻底放心——大部分推理引擎根本不会写这么细的回归测试。
十、量化矩阵:从 int4 到 MXFP4 一锅端#
c/quant.h 2102 行是真正的 SIMD 宝库,header-only,所有函数 static。一份代码覆盖 6 套 ISA:
- AVX2 / AVX-512 / AVX-VNNI
- ARM NEON / NEON-SDOT / NEON-i8mm
- POWER VSX
支持的量化格式(t.h 里的 fmt 字段):
| fmt | 名称 | 字节/参数 | 备注 |
|---|---|---|---|
| 0 | F32 | 4.00 | 原始 |
| 1 | INT8 | 1.00 | per-row scale |
| 2 | INT4 | 0.50 | 2 值/字节,pack |
| 3 | INT2 | 0.25 | 4 值/字节 |
| 4 | INT4-grouped | 0.50+gs | per-group scale(#242) |
| 5 | INT3-G64 | 0.4375 | 16B low + 8B high,#132 测的甜点 |
| 6 | E8/IQ3 lattice | 0.3828 | 98B/256 weights,#452 |
| 7 | MXFP4 | - | Kimi K3 Vulkan tier |
| 8 | FP8 e4m3 | 1.00 | 原生 passthrough |
代码注释也诚实指出了一个反直觉的”私有序号”演化:
“fmt=8 is a PUBLIC ordinal: it developed under the PRIVATE ORDINAL BLOCK convention below as fmt=100, graduated to fmt=7 when the maintainer assigned that ordinal on #524, and was renumbered to 8 after #705 merged claiming 7 for MXFP4 while this PR was still open”
这是工程现实:open source 维护者在合 PR 时抢走了一个 ordinal,你得在 PR 还没合的时候尊重它。这种 PR 协商的痕迹被永久写在注释里——“git blame 一句话能给你讲一段政治”。
每加一个新格式你都需要写自己的 matmul_q / demat 变体,但所有变体共享同一个 OMP pragma + SIMD 分支结构。这种”全部手写、拒绝代码生成”的路子,代价是几万个 LOC 的 quant.h,好处是任何格式都可测、可调、可单独比较——README 反复强调 “quality-bounded representations can reduce weight movement enough to matter”,但每个数字必须 reproduce quality + bytes moved + latency + cost 四个维度一起,而不是只看压缩比。
十一、token 路径与”五大阶段”#
每个 token 走五步:
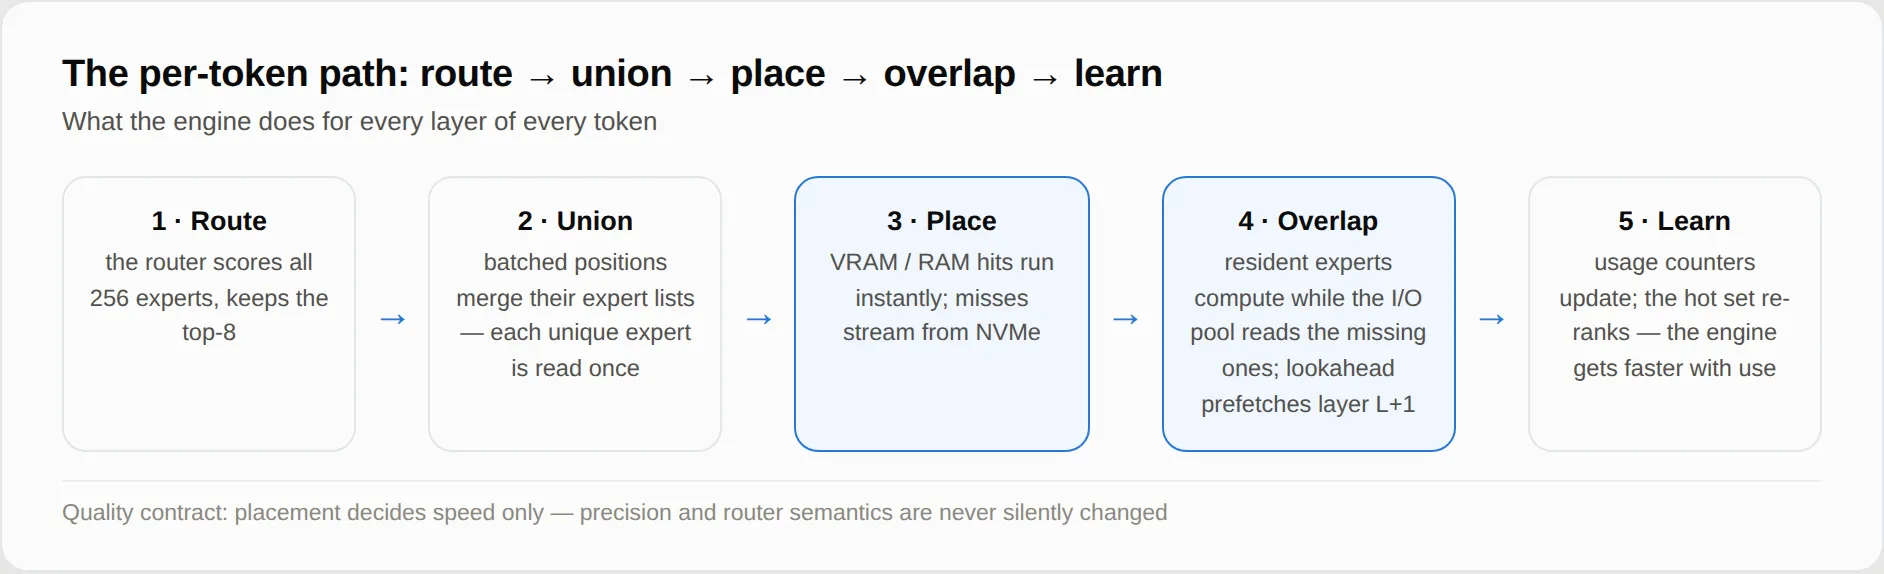
这五步的命名其实是工程师之间少见的诚实——它没把”读磁盘”包装成”智能缓存”,而是直接说 overlap / learn。每个阶段都有可测量的反馈:
- route —— 路由器(per-layer
n_group=1sigmoid + noaux_tc)选 top-k experts。 - union —— batch 中所有位置去重,得到 unique experts set。
- place —— 每个 expert 决定从 VRAM / RAM / NVMe 读。
- overlap —— 缺失的 expert 后台
pread,同时 resident expert 跑 matmul。 - learn —— 写
.coli_usage(per-expert heat)和可能的 KV 增量。
整个 pipeline 没有任何阶段会改变 token 输出——这就是那个 hard guarantee。
十二、Brain / Atlas:把 19456 个专家画给你看#
web dashboard 之外,Colibri 还有两个可视化页面值得单独说:
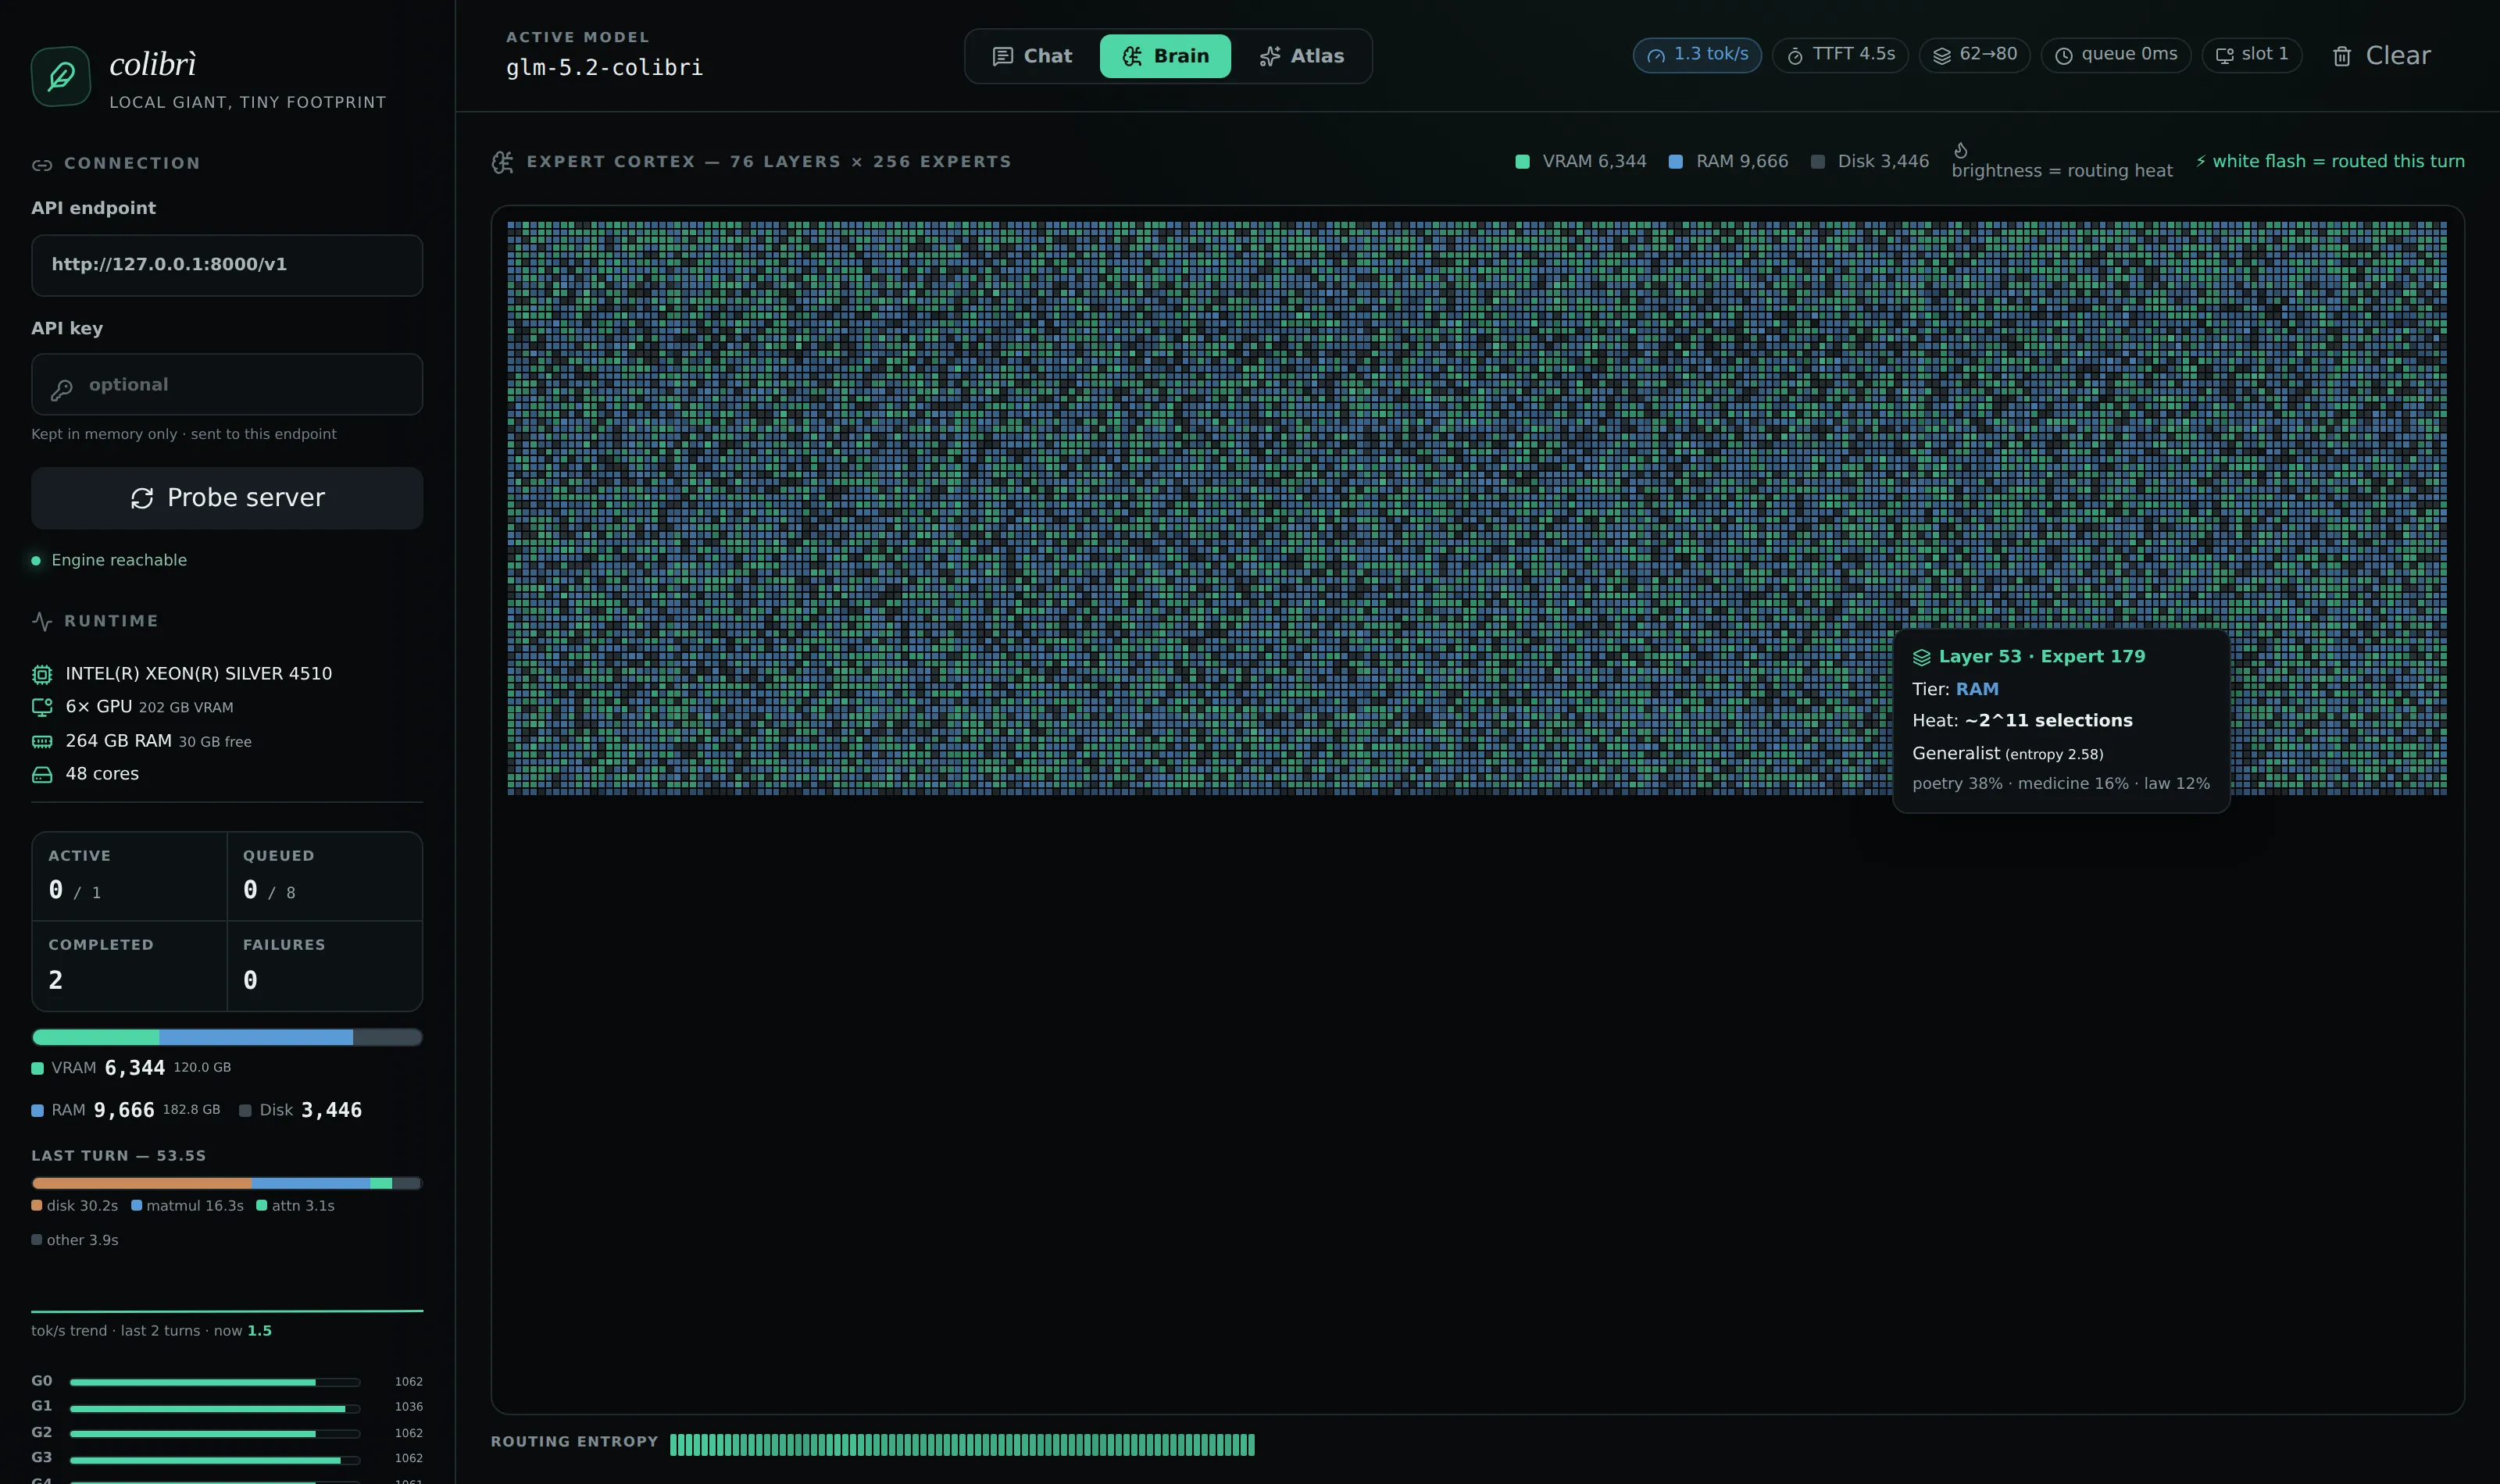
- Brain:19456 个专家(75 layers × 256 + MTP head)作为活体皮层,颜色编码存储层级,亮度编码路由热度,每个被路由的专家会闪一下。hover 显示该 expert 的 measured topic affinity ↗。
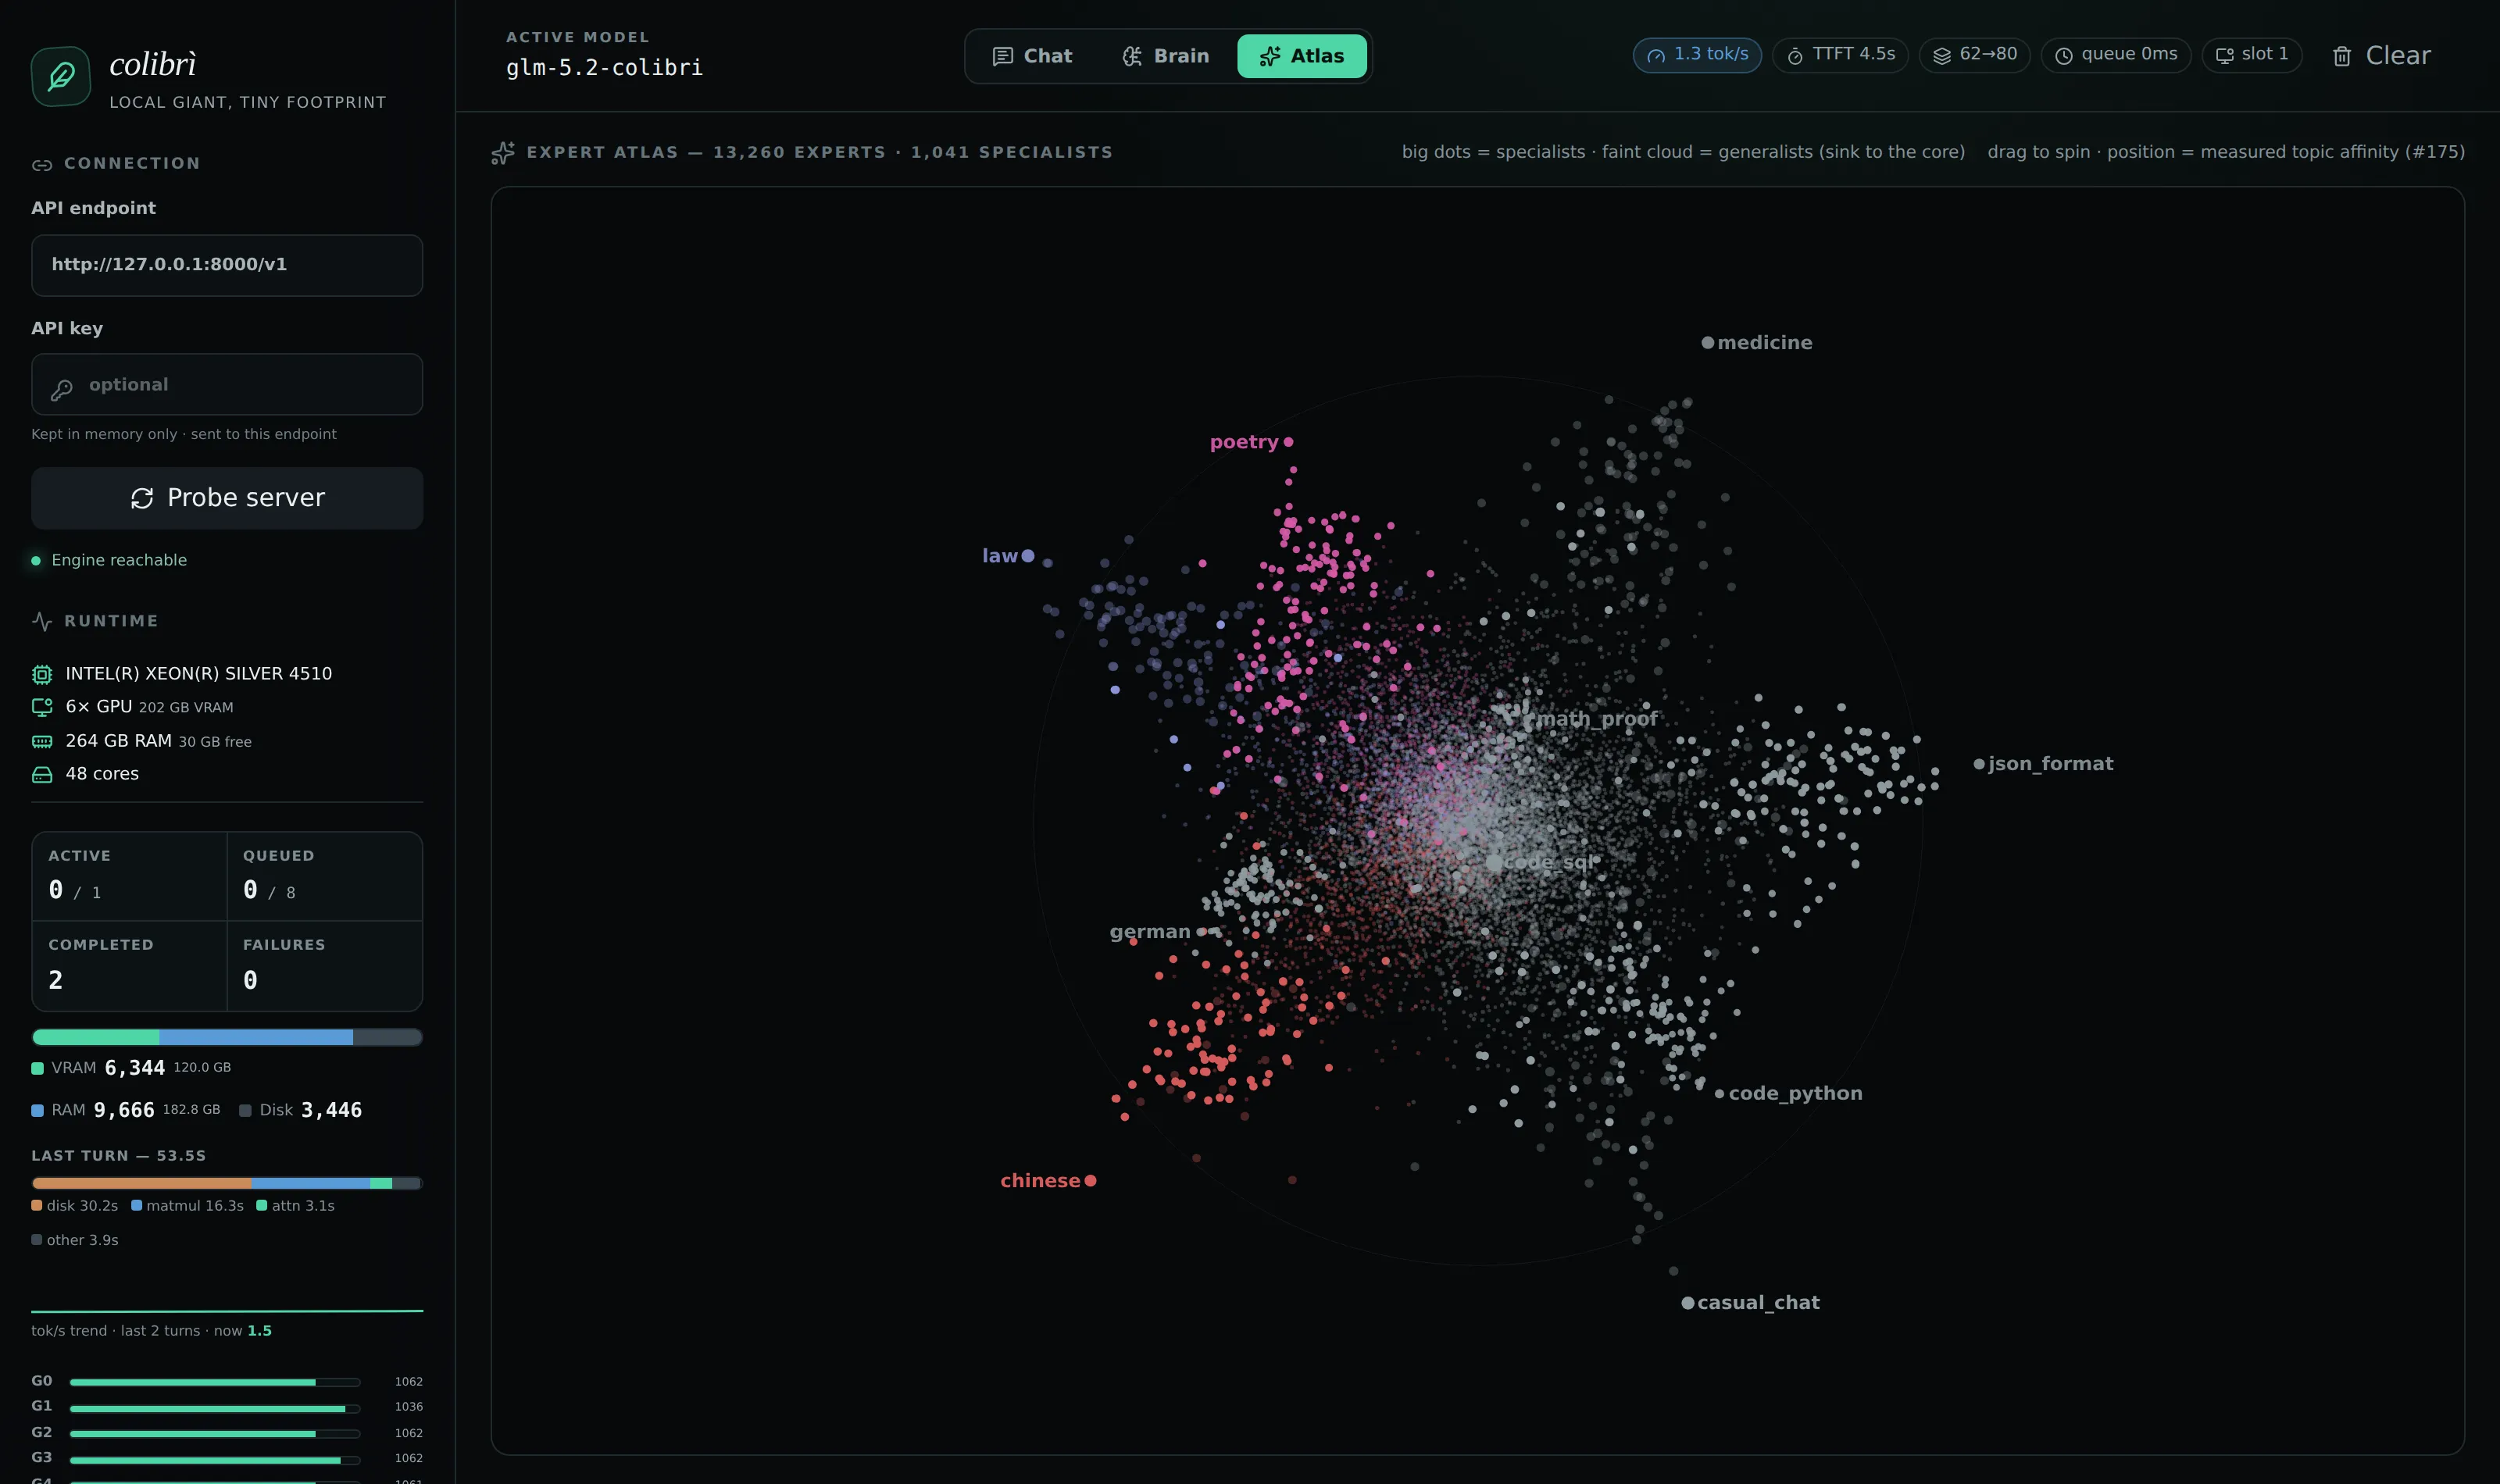
- Atlas:不是学习出来的 embedding,而是测出来的路由亲和度作为 3D 位置。13,260 个被表征的专家 + 1041 个聚集 specialist(诗歌/法律/中文/SQL…)形成 3D 星系。
这种”把内部状态当数据可视化”的工程姿态,让你能直接观察到模型行为,而不是只能调 API 看 token。这在 ML 系统里非常罕见——vLLM、llama.cpp 都没有这种页面。
十三、Cluster 模式:Mac 集群做协调 + 工人#
c/colibri.c 顶部 cluster 相关的代码段(第 86-89 行)定义了:
typedef struct { int fd; char host[128]; int port; } ClusterWorker;
static ClusterWorker g_cluster_workers[16];
static int g_cluster_n;最多 16 个 worker Mac,通过 TCP 持久连接转发 routed batch-union。一个 token 不需要一次专家一次 round-trip——一层的所有 routed experts 打包成一个持久请求。
启动方式:
# Coordinator
./colibri cluster coordinator --host 0.0.0.0 --port 8765

# Worker
./colibri cluster worker --model /nvme/glm52_i4 --port 9100 \
  --coordinator http://COORDINATOR:8765 --advertise-host WORKER_IP

# 带 cluster 跑的 serve
./colibri serve --model /nvme/glm52_i4 \
--cluster-coordinator http://127.0.0.0:8765注意 README 的”诚实声明”:
“The transport is disabled unless workers are configured, so the existing single-machine path remains unchanged. Dense-layer sharding and browser/WebGPU workers are separate follow-up seams.”
Dense layer sharding(把 attention 切到不同机器)和 WebGPU worker 浏览器端推理还没实现——README 把”还没做”和”做了”分得很清楚。
十四、实测数字:同样的 int4 容器,完全不同的体感#
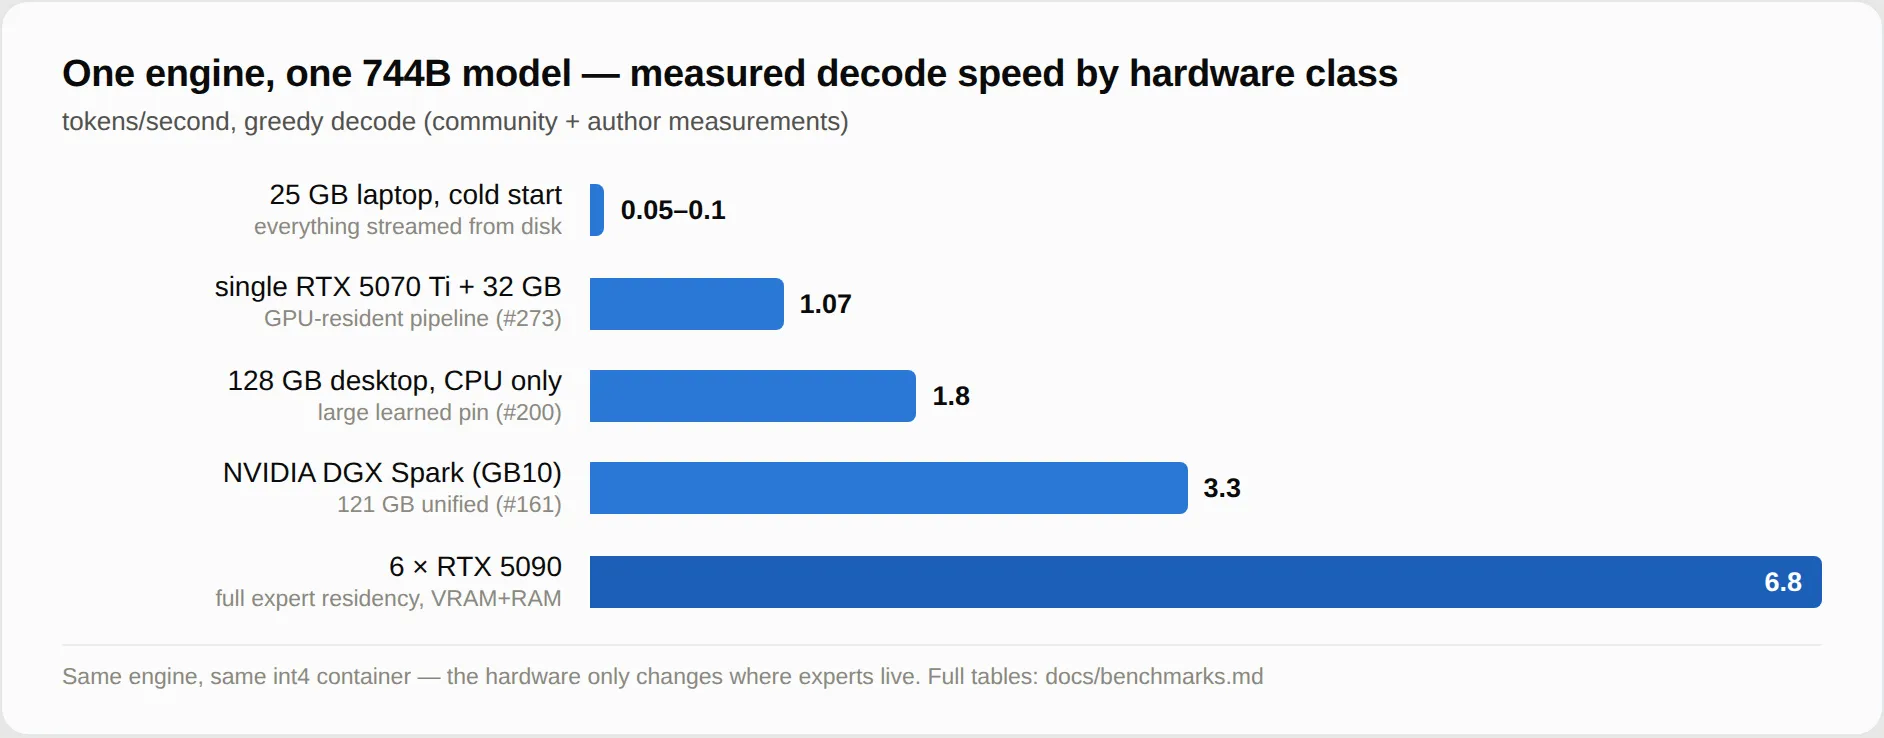
| 硬件 | 配置 | tok/s | 备注 |
|---|---|---|---|
| 25 GB 笔记本(原始 dev box) | WSL2 + 12 cores + NVMe via VHDX | 0.05-0.1 cold | 项目起点,基线 |
| 128 GB CPU-only desktop | RAM 够装所有 int4 | ~1.8 warm | #200 ↗ |
| 单 RTX 5070 Ti laptop | GPU 驻留 pipeline | 1.07 | #273 ↗ |
| 6× RTX 5090 全驻留 | 192GB VRAM 全装 | 5.8-6.84, TTFT 13s | 实验记录 |
注意 25 GB 那台机器:
“It is a 744B frontier-class model answering correctly on a machine that costs less than one H100 fan.”
不是”快”,是”能跑”。这种诚实是 Colibrì 的底色。
十五、社区与可持续性#
CHANGELOG 截至 1.11.0(2026-09-13)56 个 PR跨越版本——是个非常活跃的小型项目。最近几周合入的 issue 标题也很有信息量:
- #1390:qwen36 GPU tier 的
qt_fill_wait在 upload queue 为空时返回,但 uploader 在 dequeue 时就释放 ring slot,早于 backend copy——warmstart 会释放仍 in-flight 的 int8 experts。一个 in-flight 计数(uploader 仅在 slot resident 后 decrement)修了这个 bug。 - #1434:
fmt=0(原始 f32)没有 scale 数组,但 Metal sizing helper 仍返回 per-row scale size,newBufferWithBytes包了 NULL 指针——segfault 或全零输出。kernel 现在对fmt=0不应用 scale,加 fail-closed guard。 - #1460:olmoe serve 模式的
PROF行发布五个零字面量,/profile在 expert reads 是 workload 时报告expert_disk_s = 0.0——disk phase 现在被实测,其余四个字段保持零,因为它们未实测,不是猜数字更好看。 - #1445:olmoe 的
--ram是惰性的,“no--cap” 意味着每层 8 slots——cap 现在从 RAM 预算派生。2291 token prompt 从 675s 降到 353s,无 flag。
每个 bug fix 都是有具体数字的故事——谁报的,什么场景,改了哪里,结果是什么。这就是科研级工程的态度。
十六、我学到的几件事#
把 Colibrì 仔细读完,我会把这几条当作 future-self 的提醒:
- “Placement 只影响速度”是基础设施层的承诺。任何想做权重 offload 的项目都必须先有这个 token-exact 验证,否则就是拿语义换数字。
- 可证伪 > 不可证伪。每个优化要么给出 A/B 数据,要么老实标”假说待验”。Colibrì 的 8 个待证假说表格是项目最有教育意义的资产之一。
- 注释是给未来的自己和队友的。“never write a header with more records than physically exist” 这种边界条件,只有踩过坑的人才写得出来。
- LFRU 简到 70 行就够。生产级 caching 不需要 W-TinyLFU 那种复杂算法,关键是频率 vs recency 的权重+滞回。
- 降级路径比 happy path 更重要。双 SSD 镜像容忍部分镜像、读失败、热插拔——这些设计不是 nice-to-have,是能不能用的关键。
- 可视化的价值。Brain / Atlas 页面让你看见 19456 个 expert 的命运动力学,这种透明性是建立信任的最短路径。
十七、回到那个问题:为什么是”Colibrì”#
意大利语里 colibrì 是蜂鸟——体型最小但飞行能力惊人。这个命名完美契合项目灵魂:几 MB 的二进制能调度 2.8T 参数的模型,任何硬件上跑同一个 forward。
Colibrì 不快(冷盘 0.05 tok/s 谁也不会觉得快)。但它是正确的、可观测的、可扩展的、诚实的——这四样合在一起,在 ML 系统里比”快”罕见得多。
如果你正在做 MoE 推理、做 LLM 推理引擎、或只是想知道”大模型到底是怎么跑起来的”,强烈建议 clone 下来读 c/colibri.c 的前 2000 行——那里面有一个 C 老炮工程师(意大利语注释是签名)对”如何把硬件边界推到极限”的最朴素回答。
注:本文图 1-7 全部来自 colibri/docs/media/ ↗ 和 colibri README ↗,Apache-2.0 License。