深入解析 Sonarr:一个 10 年老牌 PVR 的调度算法与架构设计#
代码量 10 万行(C# 5.6 万 + TypeScript 4.5 万)、50+ 索引器驱动、20+ 下载客户端驱动、28 个 Specification 决策规则、1373 行标题 Parser —— Sonarr 把”自动追剧”这件事做到了工业级。
一、Sonarr 是什么#
如果你只追三五部美剧,每周手动上 RARBG 看看有没有更新其实也不算麻烦。但一旦你追 30 部以上美剧、跨越十几个字幕组、要求固定 1080p x265、还要每周自动升级画质的时候,“自动追剧”就变成了一门需要工程化的手艺。Sonarr 就是把这门手艺从「手动 + 脚本」推进到「工业流水线」的开源软件。
官方 README 一句话定义:
Sonarr is a PVR for Usenet and BitTorrent users. It can monitor multiple RSS feeds for new episodes of your favorite shows and will grab, sort and rename them.
三个核心能力:
- 监控:每小时扫一次 RSS feed,看关注的剧有没有新集
- 下载:命中规则后把 NZB/Torrent 推给 SABnzbd/qBittorrent
- 整理:下载完成后按规则重命名、移进媒体库、通知 Plex/Jellyfin 刷新
PVR(Personal Video Recorder)这个词容易让人联想到 Windows Media Center 那种录电视的工具。Sonarr 的 PVR 不是那个意思 —— 这里的”录”指的是”自动录下视频文件”,也就是自动化下载 + 整理。
二、它不是一个人在战斗:Servarr 生态#
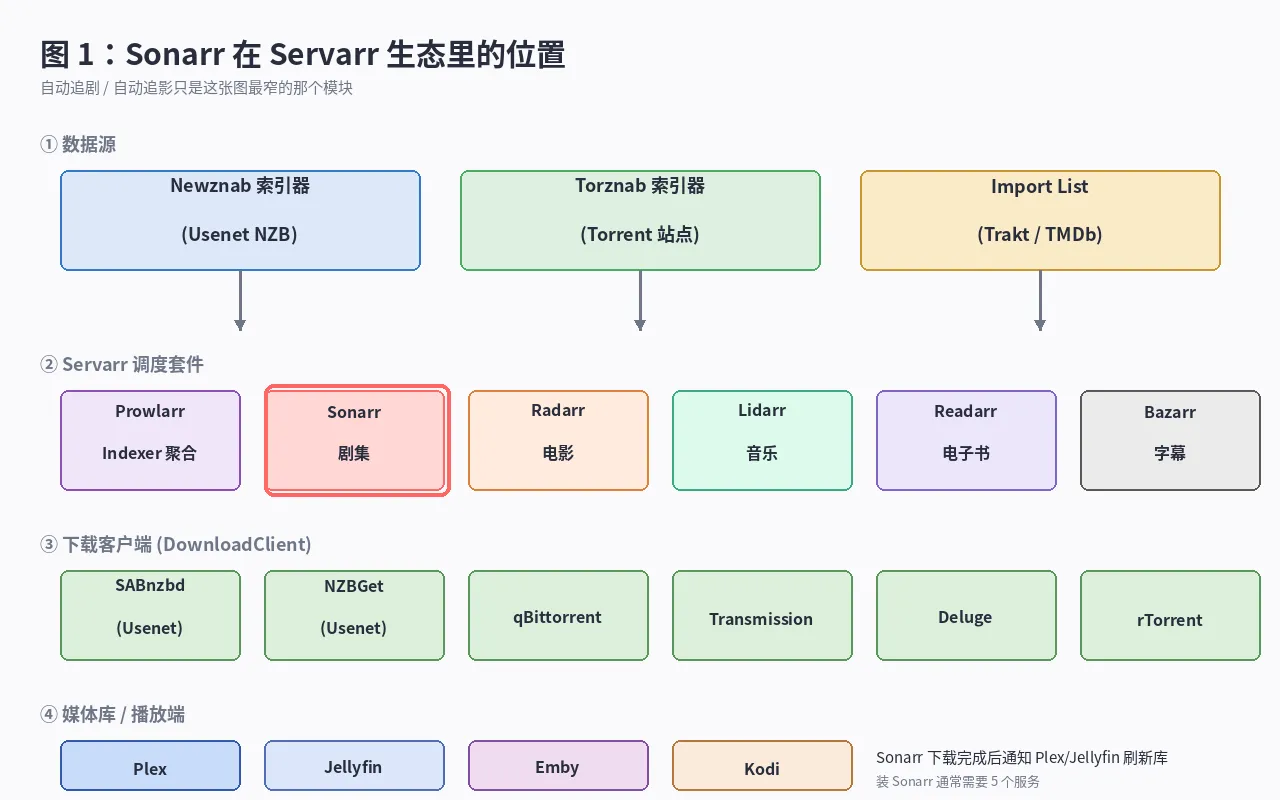
Sonarr 不是一个独立项目,它是 Servarr 家族里专门追剧的那一个。整个 Servarr 套件拆得很清晰:
| 套件 | 职责 | 类比 |
|---|---|---|
| Prowlarr | 索引器聚合(管理所有 Newznab / Torznab 站点) | Bitwarden 之于密码管理 |
| Sonarr | 电视剧集(本文主角) | Plex 之于电影 |
| Radarr | 电影(Sonarr 几乎原样复制改名) | Sonarr 的镜像 |
| Lidarr | 音乐 | Sonarr 的双胞胎 |
| Readarr | 电子书 | 同上 |
| Bazarr | 字幕(挂在 Sonarr/Radarr 后面) | Subtitle Edit 的自动化 |
一整套自动化追剧的最小组合通常是:Prowlarr + Sonarr + SABnzbd/qBittorrent + Plex/Jellyfin。Sonarr 把文件搬进媒体库后,会通过 Webhook 通知 Plex/Jellyfin 触发库刷新 —— 所以你打开播放器就能看到新一集。
为什么 Sonarr 的 GitHub Stars 只有 10k+ 这么少#
你会发现 Servarr 这堆项目在开发者圈里知名度不高,但在追剧 / HTPC 自部署圈子里是基础设施级别的存在。几个数据侧面印证:
- Sonarr 仓库是 GPL-3.0,但 Wiki(wiki.servarr.com)的浏览量比代码仓库高得多 —— 用户更关心”怎么配置”而不是”代码怎么写”
- Discord 社区 8 万+ 用户
- 下载量:Sonarr v4 beta 发布时 24 小时装机量过 10 万
三、Sonarr 内部模块全景:双栈四层架构#
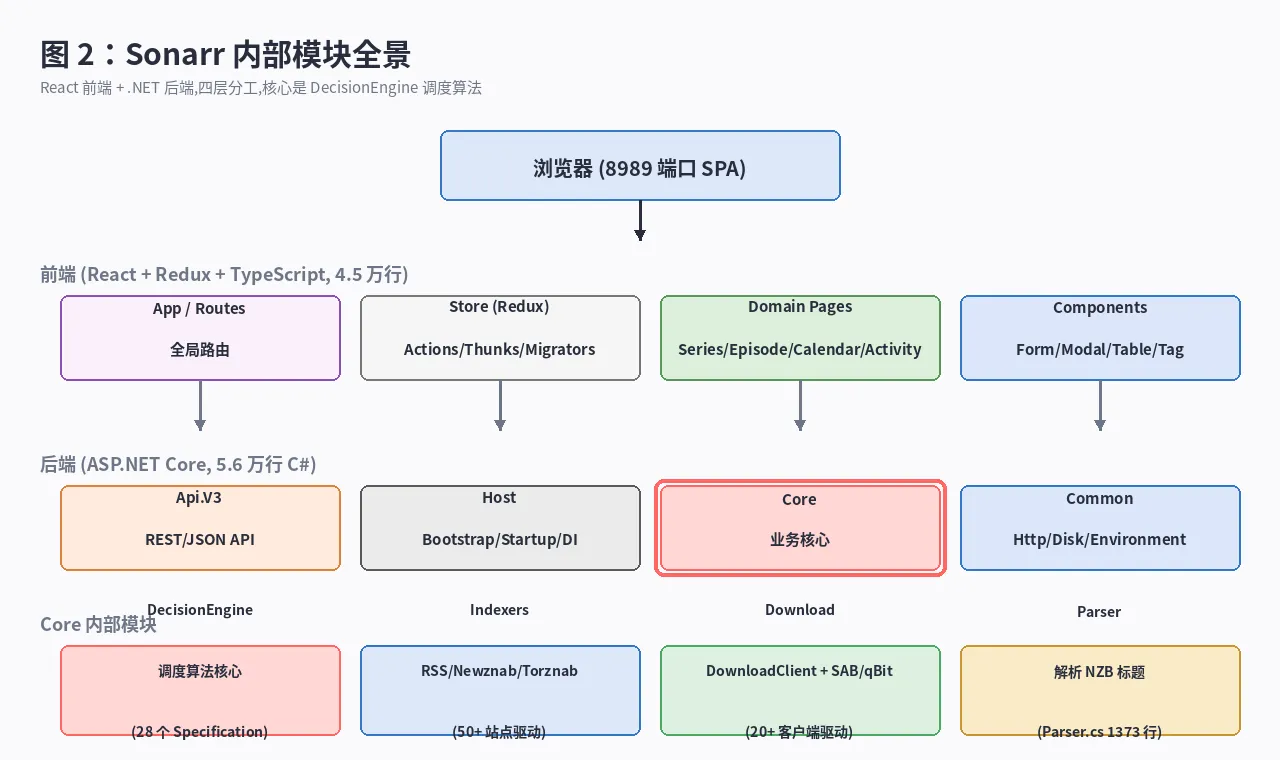
整个项目分四层:
浏览器 (8989 端口 SPA)
   ↓ HTTP
前端 (React + Redux + TS, 4.5 万行)
   ↓ REST/JSON
后端 ASP.NET Web API + Host + Core + Common
   ↓ 文件 / 命令行
Indexers + Download + Parser + DecisionEngine (Core 内部)3.1 前端:React + Redux,但用了「自升级 Migrator」模式#
Sonarr 的前端是 React + TypeScript + Redux,但有个非常有意思的细节:它有一套自己的 Store Migrators 链。
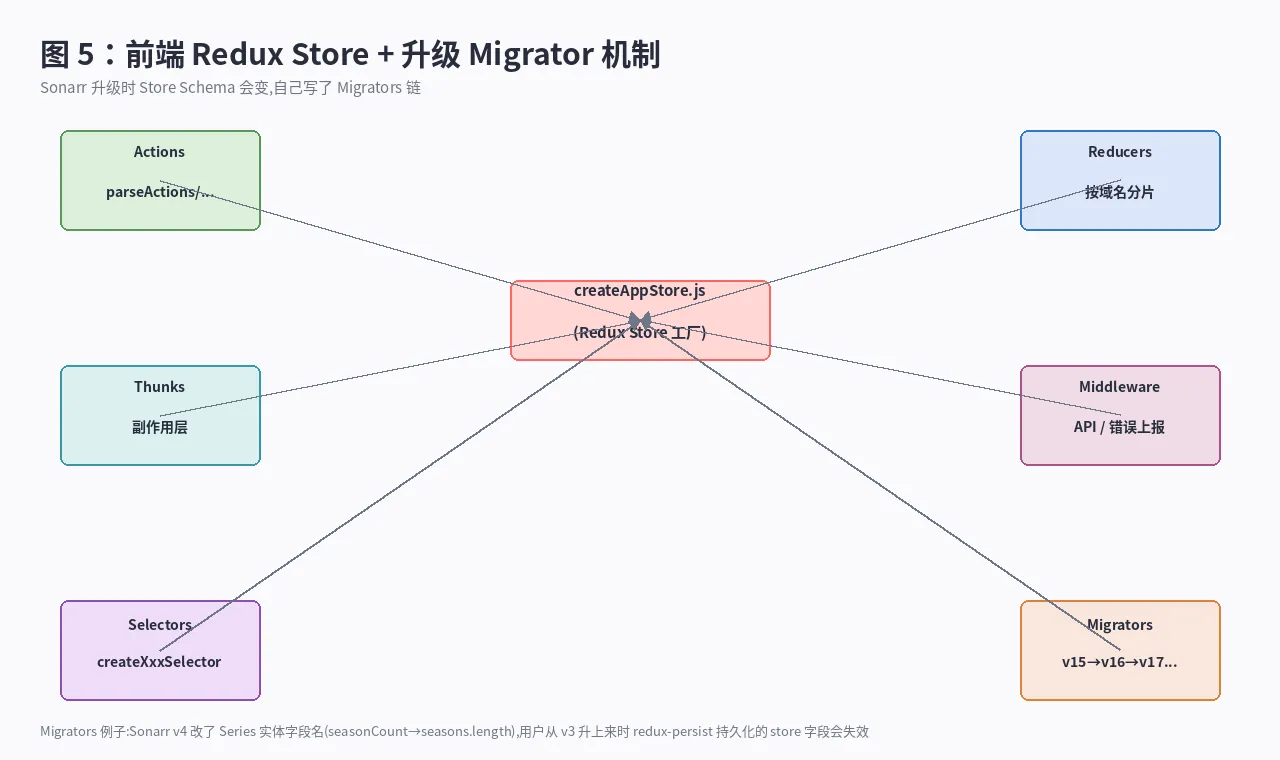
createAppStore.js 是 Redux Store 工厂,配置 actions / reducers / selectors / thunks / middleware / migrators。前 5 个都好理解,第 6 个 migrator 是 Sonarr 的特色:
用户从 Sonarr v3 升到 v4 时,redux-persist 把 Store 序列化到了 localStorage。但如果 v4 改了实体字段(比如
seasonCount改成seasons.length),那 localStorage 里的旧数据直接加载就会崩。Sonarr 写了一个 Migrator 链,每次加载时按version字段升级数据。
这是 Sonarr 用户体验丝滑的隐形功臣 —— 用户升级后所有列表、视图设置、UI 偏好都不丢。
3.2 后端:不是老旧的 .NET Framework,是 .NET 6 + DI 容器#
很多人听到 .NET 就想到 2008 年的 WebForm、拖控件的古老工具。Sonarr 完全不是 —— 它用 ASP.NET Core + Microsoft.Extensions.DependencyInjection + Microsoft.Extensions.Hosting,跟现代 Java Spring Boot 一样的依赖注入容器化思路。
Host 入口(src/NzbDrone.Host/Bootstrap.cs)就是经典的 Generic Host 模式:
public static void Start(string[] args, ...)
{
    var host = Host.CreateDefaultBuilder(args)
        .ConfigureServices((ctx, services) =>
        {
            // 注册所有 Core 服务
            services.AddSingleton<IMakeDownloadDecision, DownloadDecisionMaker>();
            services.AddSingleton<IFetchAndParseRss, RssSyncService>();
            // ... 200+ 个服务
        })
        .Build();

    host.Run();
}Core 项目结构(src/NzbDrone.Core/,4.7 万行)按照业务域拆分得很干净:
| 目录 | 职责 | 行数估计 |
|---|---|---|
| DecisionEngine | 调度算法,28 个 Specification | ~3000 行 |
| Indexers | 索引器驱动,50+ 站点 | ~8000 行 |
| Download | 下载客户端,20+ 客户端 | ~6000 行 |
| Parser | NZB/Torrent 标题解析 | ~4500 行(含测试 6000) |
| Datastore | EF Core 仓储 + 数据迁移 | ~10000 行 |
| Notifications | 通知(Discord/Slack/Email/…) | ~4000 行 |
注意 Datastore 占 Core 接近 1/4 —— 这是一个长期演化的项目的标志:核心业务代码就那么点,但 schema 演进(迁移 200+ 个版本)的代码比业务逻辑还多。
四、核心调度算法:DecisionEngine 的 28 道关卡#
这是 Sonarr 整个项目最值得讲的设计,比 React 前端、.NET DI 容器都更有学习价值。
4.1 场景复盘:RSS Sync 一小时会发生什么#
每隔 1 小时 → RssSyncService.Sync() 触发
  → 拉取所有启用的 Indexer 的最新 RSS feed(可能是 50 个站点 × 100 条记录)
  → 解析每条记录成 ReleaseInfo(标题、来源、大小、做种数)
  → 调用 DownloadDecisionMaker.GetRssDecision(reports)
  → 每个 report 过 28 个 Specification
  → 通过的丢给 ProcessDownloadDecisions
  → 排序后挑出最优的,丢给 DownloadClientProvider
→ 推到 SABnzbd/qBittorrent一个看起来简单的”追新集”,在 Sonarr 里其实是一次串行的 28 道过滤器。
4.2 28 个 Specification 串行过滤#
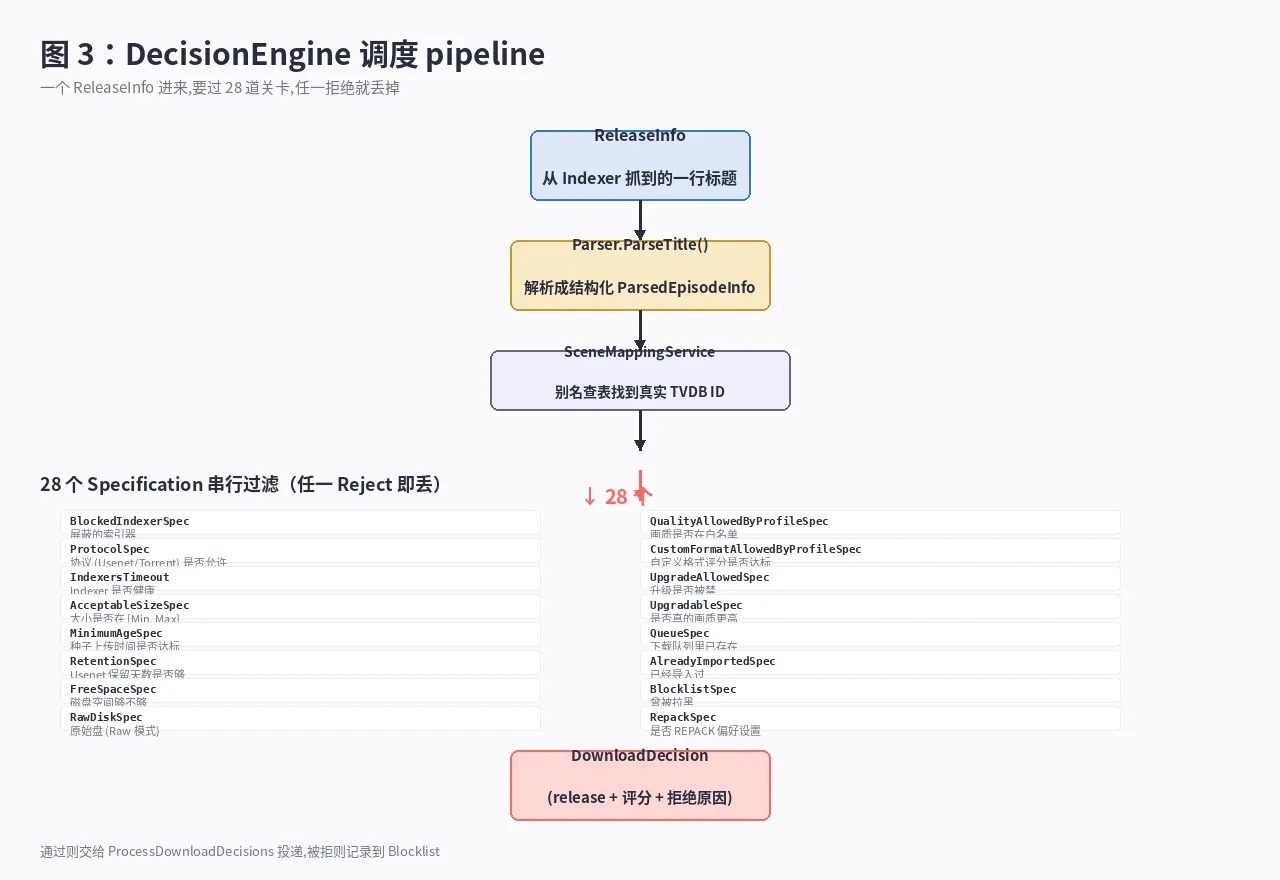
下面是核心代码(src/NzbDrone.Core/DecisionEngine/DownloadDecisionMaker.cs):
public class DownloadDecisionMaker : IMakeDownloadDecision
{
    private readonly IEnumerable<IDownloadDecisionEngineSpecification> _specifications;

    public DownloadDecisionMaker(IEnumerable<IDownloadDecisionEngineSpecification> specifications, ...)
    {
        // DI 容器把 28 个 Specification 全部注入进来
        _specifications = specifications;
    }

    private IEnumerable<DownloadDecision> GetDecisions(List<ReleaseInfo> reports, ...)
    {
        foreach (var report in reports)
        {
            // 1. 标题解析成结构化数据
            var parsedEpisodeInfo = Parser.Parser.ParseTitle(report.Title);

            // 2. 28 个 Specification 串行过滤
            foreach (var spec in _specifications)
            {
                var result = spec.IsSatisfiedBy(remoteEpisode, subject);
                if (result.Accepted) continue;

                // 任一 Reject 即丢,记录拒绝原因
                decision = new DownloadDecision(remoteEpisode,
                    new DownloadRejection(result.Reason, result.Message));
                break;
            }
        }
    }
}这是教科书级别的策略模式(Strategy Pattern):
- 每个规则独立成类:
AcceptableSizeSpecification/QualityAllowedByProfileSpecification/QueueSpecification…… 28 个独立类 - 统一接口
IDownloadDecisionEngineSpecification:所有规则都有IsSatisfiedBy()方法 - DI 容器自动注入:
IEnumerable<IDownloadDecisionEngineSpecification>让容器把所有实现类一股脑注入,新增规则只需要新写一个类 + 注册到 DI,不用改主逻辑
这是 Open-Closed Principle(开闭原则)的范本:你不需要修改 DownloadDecisionMaker 就能加新规则。
4.3 哪些规则最常踩坑#
我列出几个实战中用户最常问到的规则:
QualityAllowedByProfileSpecification —— 你给剧集配置了”只下 1080p”,但 Release 写的是 720p → 拒绝。
MinimumAgeSpecification —— 种子发布 5 分钟内就下载容易被举报,要求种子上传满 X 分钟(用户可配置,默认 0)。
RetentionSpecification —— Usenet 服务商只保留 N 天的文章(典型 1200 天),超过就拉不到,要求发布日期 < 服务商保留天数。
UpgradableSpecification —— 你已经有 1080p,再下 720p 不会被接受(除非禁用了”画质升级”)。
BlocklistSpecification —— 同一份 release 曾经因为失败被拉黑,N 天内不再尝试。
QueueSpecification —— 已经在下载队列里,不重复下载。
每个 Specification 还带具体的拒绝原因(DownloadRejection 枚举),用户在 Activity → Queue 页面能看到”为什么这个没下”。
4.4 评分 + 排序:CustomFormatScore#
通过 28 道关卡之后,并不是每个通过的 release 都会被下。Sonarr 还会计算一个 Custom Format Score:
remoteEpisode.CustomFormats = _formatCalculator.ParseCustomFormat(remoteEpisode, remoteEpisode.Release.Size);
remoteEpisode.CustomFormatScore = remoteEpisode?.Series?.QualityProfile?.Value
.CalculateCustomFormatScore(remoteEpisode.CustomFormats) ?? 0;Custom Format 是用户自定义的格式评分,比如:
- “x265” 加 100 分
- “DTS-HD” 加 50 分
- “3D” 减 200 分
- “Remux” 加 300 分
最后同画质(都是 1080p)的多个 release 按 CustomFormatScore 排序,最高分被选中推到下载客户端。这就是 Sonarr 比同类工具(FlexGet、CouchPotato)智能的关键 —— 不是”先到先得”,而是”同条件下选最好的”。
五、Parser:1373 行的标题解析器#
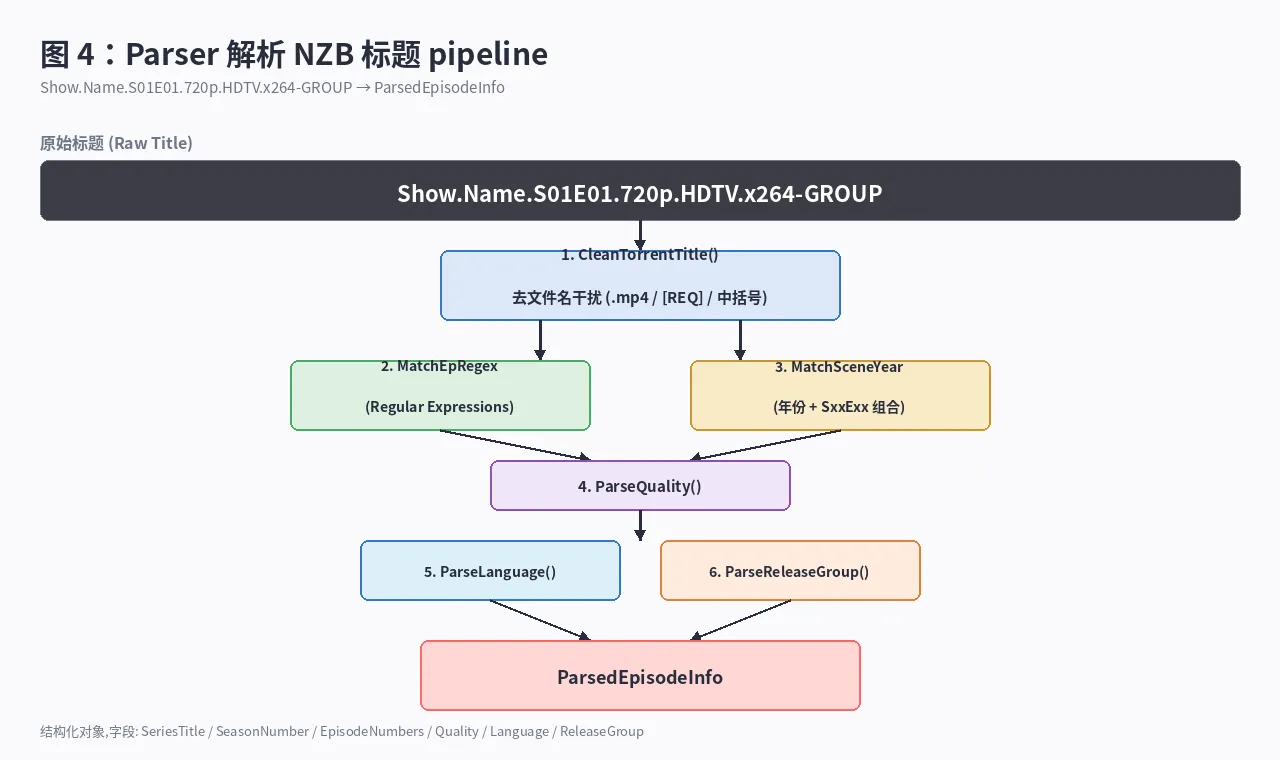
Sonarr 的 Parser.cs 是 Core 里单文件最大的,1373 行。它干的事情听起来简单 —— 把一行 NZB/Torrent 标题(Show.Name.S01E01.720p.HDTV.x264-GROUP)解析成结构化对象。但实际上是个非常难的字符串处理工程。
5.1 为什么这件事这么难#
NZB 标题是 Usenet 社区 20 多年的”野生约定”,没有任何标准。每个字幕组都有自己的命名习惯:
Show.Name.S01E01.720p.HDTV.x264-GROUP          # 标准
Show.Name.1x01.720p.HDTV.x264-GROUP            # x 风格
Show Name 1x01 720p HDTV x264-GROUP            # 空格
[Group] Show.Name - 01 [720p]                   # 动画圈
Show.Name.S01E01E02.720p.HDTV.x264-GROUP       # 多集打包
Show.Name.S01E01-03.720p.HDTV.x264-GROUP       # 连集
Show.Name.2024.S01E01.720p.HDTV.x264-GROUP     # 带年份
Show.Name.S01E01.PROPER.720p.HDTV.x264-GROUP   # PROPER 版本
Show.Name.S01E01.REAL.PROPER.720p.HDTV... # 多层 PROPER更离谱的是还会有各种”污染词”:[Req], Dual Audio, 10bit, HEVC, WEB-DL, HDR10, Atmos ……
5.2 6 步解析 pipeline#
| 步骤 | 函数 | 干什么 |
|---|---|---|
| 1 | CleanTorrentTitle() | 去掉 .mkv .mp4、方括号、[REQ]、年份干扰 |
| 2 | MatchEpRegex() | 用正则匹配 SxxExx 或 xXxx 模式 |
| 3 | MatchSceneYear() | 兜底,年份 + SxxExx 组合(处理 Show.2024.S01E01) |
| 4 | ParseQuality() | 把 720p/1080p/2160p 解析成 Quality 枚举 |
| 5 | ParseLanguage() | 从标题里抠语言(English/Japanese/…) |
| 6 | ParseReleaseGroup() | 抠 -GROUP 后缀的字幕组名 |
最后输出 ParsedEpisodeInfo —— 一个带 SeriesTitle / SeasonNumber / EpisodeNumbers / Quality / Language / ReleaseGroup 字段的结构化对象。
5.3 为什么不用 LLM/ML 做#
你可能会问:这种字符串处理为什么不直接上 GPT?理由:
- 成本:Sonarr 是个人/家庭服务器跑的,每分钟可能跑几百次(多剧集高频 RSS 同步),LLM 调用费用不可接受
- 延迟:同步循环里塞个 LLM 调用会把整个 RSS Sync 拖死
- 稳定性:正则 1373 行能跑就行,LLM 偶尔的幻觉会让某个 release 漏下或拒错
- 可调试:正则失败可以 log,LLM 失败只能干瞪眼
Sonarr 的做法是对的:能用确定性算法就别上概率性算法。这个原则在工业界反复被验证(参见之前拆解的 HyperFrames、God’s Eye View 都是这个路线)。
六、Indexers 与 Download:plugin 化的两端#
6.1 Indexers:50+ 站点驱动#
Sonarr 的”索引器”指的是 Usenet/Torrent 站点。src/NzbDrone.Core/Indexers/ 目录下按站点拆成 50+ 个子目录:
Indexers/
├── Newznab/          # 标准 Newznab 协议,自动适配所有 Newznab 站点
├── Torznab/          # 标准 Torznab 协议,自动适配所有 Torrent 索引站
├── BroadcastheNet/   # 私有索引站 1
├── HDBits/           # 私有索引站 2
├── IPTorrents/       # 私有 Torrent 索引
├── Torrentleech/     # 私有 Torrent 索引
├── FileList/         # ...
├── Nyaa/             # 动画专用
├── EzrssTorrentRssParser/
├── IndexerBase.cs    # 抽象基类
└── ...设计上,只对 Newznab/Torznab 这两个”标准协议”写完整适配,其余 50+ 站点都是通过基类 + 站点特有 cookie/header 的”半通用适配”。这跟 Pi Agent Harness 的 provider 适配思路(39 个 provider 共享 3 套 wire protocol)异曲同工 —— 识别出协议层共性,只对差异点做适配。
6.2 Download:DownloadClient 抽象#
下载端同样 20+ 客户端,按协议分两个抽象基类:
Download/Clients/
├── UsenetClientBase.cs        # Usenet 客户端基类
│   ├── SABnzbd/
│   ├── NZBGet/
├── TorrentClientBase.cs       # Torrent 客户端基类
│   ├── QBittorrent/
│   ├── Transmission/
│   ├── Deluge/
│   ├── rTorrent/
│   ├── DownloadStation/
│   └── ...
└── DownloadClientProvider.cs # 单例工厂每个客户端实现 4 个方法:Download() / Remove() / GetItems() / GetStatus()。同样的 protocol-aware 抽象设计。
关键设计:DownloadClientProvider 把所有客户端注入成 IEnumerable<IDownloadClient>,Scheduler 通过”加权随机 + 健康度”决定推哪个。某个 SABnzbd 实例挂了不影响其他实例。
6.3 下载失败后的「Blocklist + 重试」机制#
Sonarr 的「自动失败重试」是这个项目的灵魂之一。代码在 RedownloadFailedDownloadService.cs:
- 下载完成但导入失败(文件损坏 / 解压失败 / 命名冲突)
BlocklistService把这个 release 加进 Blocklist(一段时间内不再试)RedownloadFailedDownloadService自动换个 release 重试- 如果三次都失败,标记为永久失败 + 通知用户
这个机制让 Sonarr 基本不需要人工干预就能保证最终下到能用的文件 —— 这是它跟 FlexGet/CouchPotato 等同期项目的核心差距。
七、可学习的设计模式#
通读代码后,我认为 Sonarr 给开发者最有价值的几个模式:
7.1 决策引擎(Specification Pattern)#
把”是否接受一个 release”的复杂判断拆成 28 个独立、可组合的 Specification。这比 if-else 链和表驱动都好维护。
适用场景:规则数量会持续增长、每条规则需要单独测试、规则之间没有强依赖 —— 风控系统、推荐系统的过滤层、CI/CD 的 PR 校验。
7.2 Migrator 链(Schema 演化的客户端方案)#
升级时客户端 Store Schema 变化 → Migrator 链按版本升级 → 老用户不丢状态。
适用场景:长期演化的 SPA 应用,localStorage / IndexedDB 持久化无法清空重建。
7.3 Protocol-aware 适配(不是 Driver,而是 Adapter)#
不写 50 个独立的索引器驱动,而是先识别 Newznab/Torznab 这两个标准协议,再写非标站点的最小适配代码。
适用场景:对接多个第三方 API 时,先问”有没有标准协议(OAuth/JWT/GraphQL…)”,再决定要不要每个写 Driver。
7.4 1373 行的 Parser:能用确定性算法就别上概率性#
字符串解析能正则就正则,不要因为 LLM 火了就所有场景上 LLM。工业级应用对延迟、成本、稳定性的要求跟 ChatBot 完全不一样。
7.5 DI 容器 + IEnumerable<T> 多注入#
ctor(IEnumerable<IDownloadDecisionEngineSpecification> specifications)让容器自动注入所有实现,是 .NET DI 最优雅的特性之一。Java Spring 的 List<Strategy> 同样能做。
八、一些「工程文化」细节#
除了架构本身,Sonarr 的工程文化也很值得看:
8.1 配置文件全内联到 Settings 表#
Sonarr 不允许你直接编辑配置文件,所有设置必须通过 Web UI 修改并写入 SQLite。理由:升级时 schema 变更需要 SchemaValidator 校验,写成 YAML/JSON 文件用户改坏就直接挂。
8.2 Datastore Migration 200+ 个#
src/NzbDrone.Core/Datastore/Migration/ 下有 200+ 个迁移文件(_163_mediainfo_to_ffmpeg.cs 这种),每次数据库结构变化都要写迁移脚本。这是真正的”用户数据神圣不可侵犯”的工程实践 —— 10 年的项目,用户数据库能从 2014 升级到 2024 不丢一行数据。
8.3 .NET on Linux / ARM 是 2018 年才稳的#
Sonarr 的 Linux 部署(特别是 Raspberry Pi / Synology NAS)跑的是 .NET Core。它其实是 .NET Core 在 Linux 稳定后吃到最大红利的开源项目之一。这也是为什么 2018 之后 Sonarr 的装机量开始爆发。
8.4 社区驱动的 Spec 实现#
Sonarr 的”自定义格式”(Custom Format)特性一开始是社区 plugin 实现的,后来官方把它合并进主分支。开源项目”先 plugin 后合并”的演进路线,这里有个活样本。
九、为什么这次拆解不做「深度代码解读」#
读到这里你可能发现 —— 这次文章没有像前几篇那样逐函数逐行解析代码。原因有二:
- Sonarr 是个 10 年演化项目:很多核心代码经历了 5+ 次重写,现在看到的版本已经是被前人”打扫干净”的样子,单看当前代码看不出原始的设计动机。要看懂必须拉 git log 看演化历史 —— 这次没做
- 真正的设计在 Spec 之外:Sonarr 最有学习价值的是「调度算法 + 协议抽象」这套架构决策,而不是某个具体的 Specification 实现。架构决策比代码实现更耐读,也更值得讨论
如果你对某部分(Indexers / Download / Parser / Datastore Migration)有更具体的兴趣,告诉我,我可以再展开一篇专文。
十、给读者的两个建议#
如果你读到这里,也想自己搭一套 Sonarr:
10.1 最小起步配置#
硬件:树莓派 4 / NUC / 任意 x86 NAS(CPU 弱没关系,瓶颈在磁盘 IO)
存储:系统盘 SSD 128G + 内容盘 HDD 4T+(单独挂载)
系统:Linux (Ubuntu 22.04 LTS / Debian 12)
Docker:compose 起 Sonarr + qBittorrent + Prowlarr + Jellyfin 四个容器不要先上 Usenet(要付费),从免费 Torrent 起步。
10.2 自部署的法律红线#
Sonarr 本身是 GPL-3.0 开源、合法。但用它下载盗版内容(无论 Usenet 还是 Torrent)在绝大多数国家/地区都是违法的。请只把它用于下载你拥有合法版权的内容(如 Plex Pass 用户可下载自己的蓝光备份、公开版权的老电影等)。
十一、参考资料#
- Sonarr 官方仓库:https://github.com/Sonarr/Sonarr ↗
- Servarr Wiki:https://wiki.servarr.com/sonarr ↗
- Newznab 协议:https://newznab.readthedocs.io/ ↗
- Torznab 协议(Newznab 的 Torrent 扩展):https://github.com/Sonarr/Sonarr/wiki/Implementing-a-Torznab-indexer ↗
- 本文代码引用版本:
v4.0.0(2024 年 8 月),最新版本以官方仓库为准
本文是「开源项目拆解」系列的第 N 篇,前几篇拆过 HyperFrames ↗、God’s Eye View ↗、MathModelAgent ↗ 等。如果你对哪个项目感兴趣想拆,告诉我。