深入解析 CS341 Coursebook:UIUC 系统编程的「C 语言心智模型」全拆解
💬 评论拆解 cs341-illinois/coursebook(15MB / 16 章 / 7774 行 LaTeX):从 C 内存模型到 fork/exec/信号,把整本教材里串起来的那条「心智主线」拎出来当学习笔记写。
一、一个让我重新读 C 的项目#
CS341 是 UIUC 的「System Programming」课,这个仓库是那门课的免费开源教材——cs341-illinois/coursebook,15MB、16 个章节、7774 行 LaTeX 主干,外加一组手绘的 .eps 图。
我把它 clone 到本地是 09:14 这个时间点的事,本来想着「快速翻一遍目录交差」,结果一翻就停不下来——不是因为它写了什么新东西,而是因为它把系统编程里那些你嘴上能讲但其实没真正串起来的概念,用一种非常朴素的方式给你串了一遍。
“Why? Most kernels have their API accessible through C. The Linux kernel and the XNU kernel on which MacOS is based are written in C and have a C API.” ——
introc/introc.tex开篇
它不是一本教你「写代码」的教材。它是一本教你**「C 程序的字节在你眼前到底是什么」**的教材。
我读完的体感是:这本文和所有同类教材最大的区别不在内容(OSL、堆栈、信号…… 每本系统书都讲),而在它选择的「心智主线」——它几乎把所有东西都挂在一棵树上,树根是「C 内存模型」,树枝是「进程/线程/同步/IPC」,树梢是「文件系统和信号」。
所以这篇文章我想干一件事:不逐章复述目录,而是把这棵树的形状画给你看——用两张链路图、一组代码,把这本文真正想教你的那条主线讲清楚。
二、先把书摊开:这个仓库长什么样#
git clone 完之后,目录是这样:
coursebook/
├── main.tex              ← 主入口,input{prelude.tex} 后链所有章节
├── order.yaml            ← 章节顺序
├── prelude.tex           ← 全书共用前言
├── glossary.tex          ← 术语表
├── introduction/         ← 介绍
├── background/           ← 系统架构回顾(汇编、原子操作)
├── introc/               ← C 语言 + Linux(最重的一章,10 个子节)
│   ├── crash_course_introduction_to_c.tex
│   ├── pointers.tex
│   ├── c_memory_model.tex    ← 全书的根
│   ├── the_c_and_linux.tex   ← 「一切皆文件」「系统调用」
│   └── common_bugs.tex
├── processes/            ← POSIX 进程:fork / exec / wait / PID
├── malloc/               ← sbrk / malloc 内部
├── threads/              ← pthread / LWP / 共享地址空间
├── synchronization/      ← 互斥锁、条件变量(2395 行,全书最长)
├── deadlock/             ← 资源分配图
├── ipc/                  ← 虚拟内存 + IPC(1090 行)
├── scheduling/           ← FCFS / Round-Robin / MLFQ
├── networking/           ← OSI 7 层 + POSIX socket
├── filesystems/          ← inode / FAT / KiB 单位
├── signals/              ← 信号处置表 / handler
├── security/             ← CFAA / attacker 模型
└── review/ ← 期末复习注意 introc/ 这一章特别重——它有 10 个子文件,光一个 language_facilities.tex 就有 616 行。这意味着教材作者清楚:如果 C 的底子没讲透,后面所有东西都是空中楼阁。
order.yaml 里 17 个章节按这个顺序串成 17 章 LaTeX——从「C 语言」到「操作系统调度」到「安全与法律」。这条路径本身就是一个教学曲线:先用一章把 C 钉死,然后才允许你碰内核。
我接下来要拆的,就是这条曲线上最关键的 4 个节点:C 内存模型 → 系统调用 → 进程(fork/exec) → 信号。
三、C 内存模型:全书的心智根#
introc/c_memory_model.tex 这一节只有 218 行,但它是全书的心智根。我读完最深的感受是:它没有先讲”什么是 malloc”,而是先讲”struct 在字节里长什么样”。
教材原话:
“In low-level terms, a struct is a piece of contiguous memory, nothing more. Just like an array, a struct has enough space to keep all of its members.” ——
introc/c_memory_model.tex
这句话在大多数 C 教材里被跳过——大多数教材上来就讲 struct contact { ... },然后给一个 person.firstname。但 CS341 一定要先告诉你:struct 在内存里就是一个挨着一个的字节块,编译器算 offset,你读 person.firstname 其实是「基地址 + 0 字节处的 20 个字节」。
教材里给了一个非常实在的例子:
struct contact {
  char firstname[20];
  char lastname[20];
  unsigned int phone;
};

struct contact person;
// &person           == 0x100
// &person.firstname == 0x100  (offset 0x00)
// &person.lastname  == 0x114  (offset 0x14 = 20)
// &person.phone == 0x128 (offset 0x28 = 40)然后它给了一个真正的「工程级 hack」——零长度数组(char c_str[0])放在 struct 末尾,作为变长字符串的”挂钩”:
typedef struct {
  int length;
  char c_str[0];   // 零长度数组,只占 offset,不带任何字节
} string;

string* person = malloc(sizeof(string) + length + 1);
person->length = length;
strcpy(person->c_str, "person");这种写法在内核代码里很常见(教材原话:“this is a hack seen in a lot of kernel code”),原理就是:struct 在内存里就是连续字节,零长度数组不占字节,所以 malloc(sizeof(string) + length + 1) 相当于「先 malloc 一个 int 长度的头,然后紧挨着再 malloc length+1 个字节」——一次性分配,避免双 malloc 的开销。
我读完这一段的感受是:作者在用「内存字节流」强行重塑你的 C 心智——不是「字段访问」,而是「offset + 长度」。这才是后面讲 malloc、虚拟内存、IPC 时能用的统一语言。
3.1 把心智模型画成一张图#
教材讲完 struct 之后,自然就要回答一个更大的问题:整个 C 进程在内存里长什么样? 教材默认这一节你已经知道,但后面的 malloc 和 IPC 章都默认你懂,所以我决定把这一张图作为整篇文章的”第一张总图”:
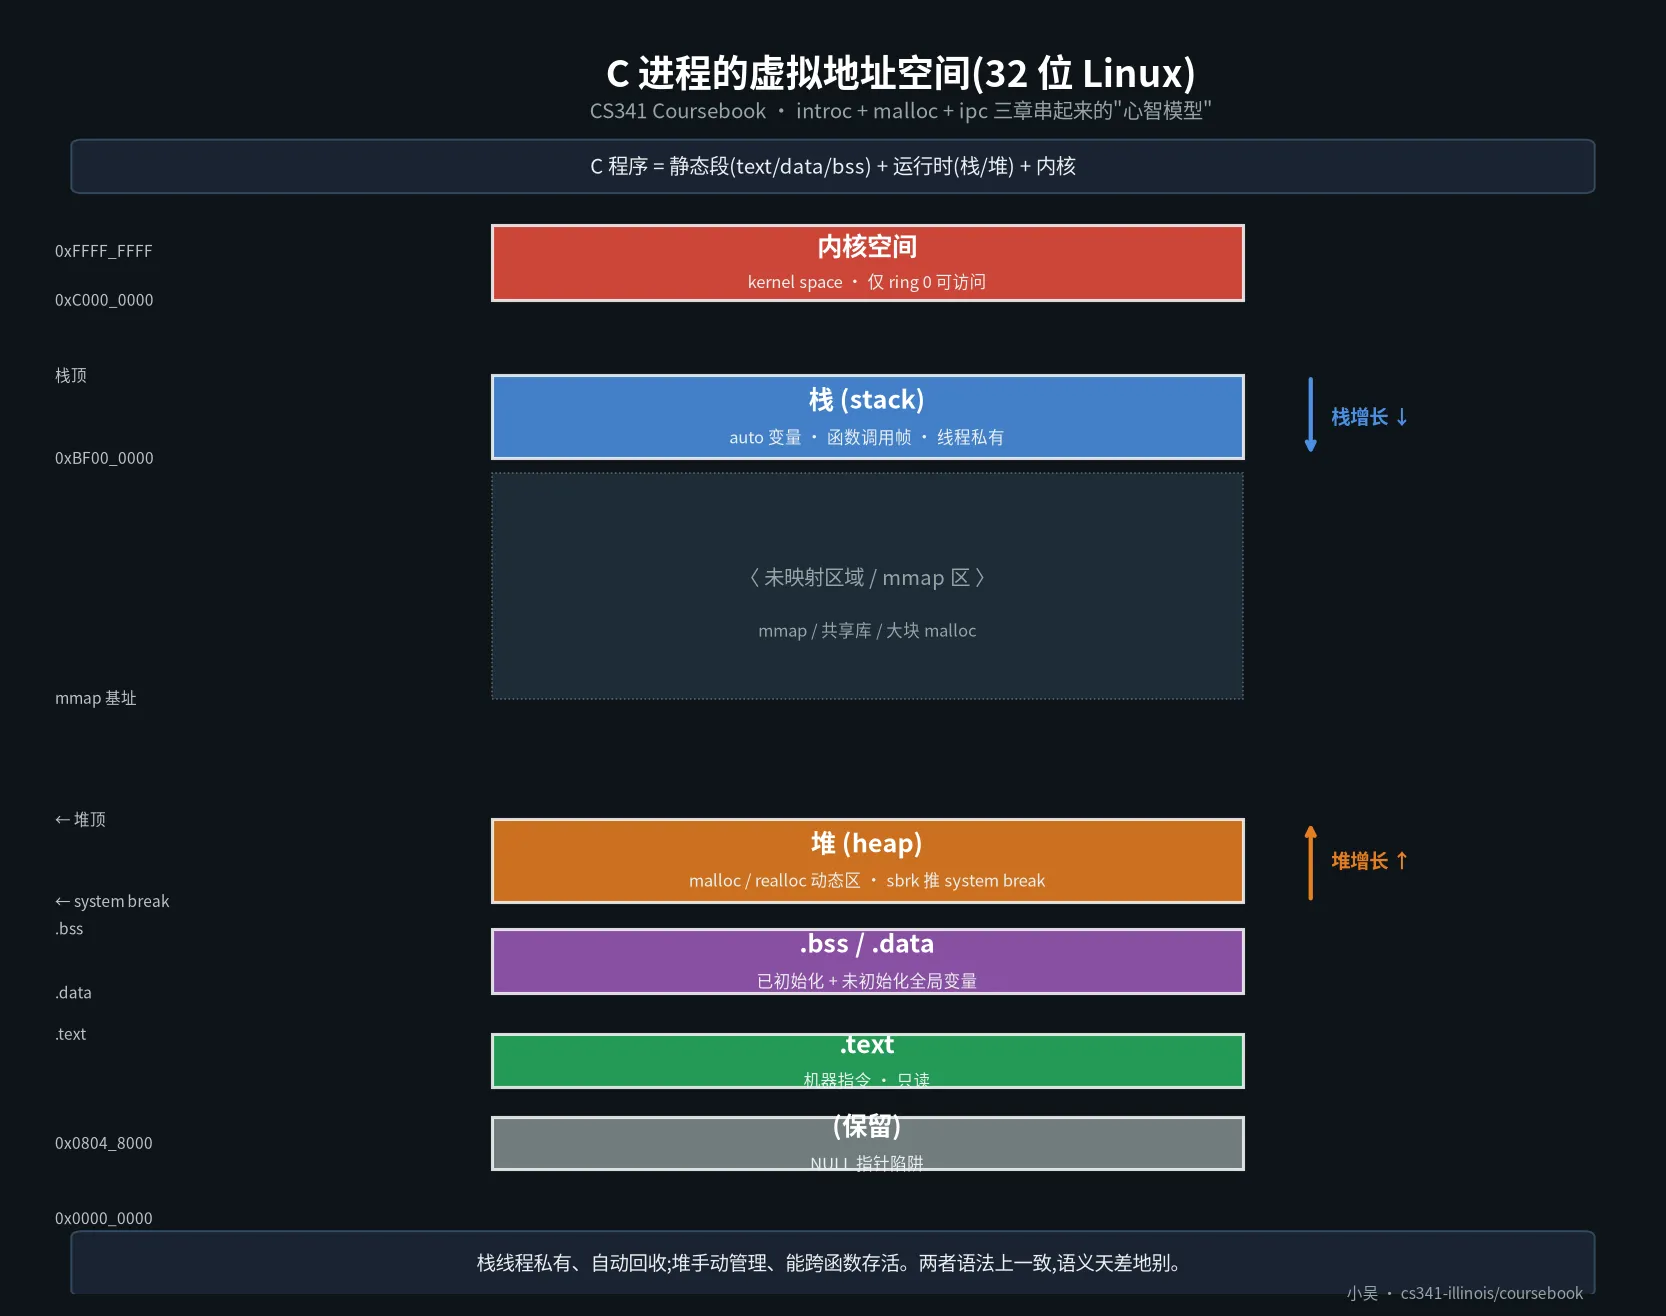
这张图我对照教材的描述重新画了一遍,几个关键点写在下面:
- .text:机器指令,只读。教材强调 .text 是进程共享同一份物理页(同程序的多个进程 .text 指向同一页框)。
- .bss / .data:全局变量。.data 是初始化过的,装载时从可执行文件读; .bss 是未初始化的,装载时内核直接清零。
- 堆(heap):
malloc出来的字节。教材在 malloc 节里讲到:大多数程序不直接用sbrk推 system break,而是用一个 malloc 库在系统 break 之上做切块(malloc.tex第 1 节)。 - 栈(stack):auto 变量、函数调用帧。线程私有——这一条教材在 threads 章里反复出现,因为它是后面所有同步问题的根。
- 内核空间:教材在 ipc 章里特意讲了 32 位 Linux 是 3:1 切分(用户 0x0000_0000-0xBFFF_FFFF,内核 0xC000_0000-0xFFFF_FFFF),64 位则复杂得多。
这张图最值钱的一条规则写在底部:
栈线程私有、自动回收;堆手动管理、能跨函数存活。两者语法上一致,语义天差地别。
这个区分,是后面 threads 章节反复强调的——因为线程共享地址空间,但每个线程的栈是私有的,这才是线程安全的根。
四、第二个心智钉:「一切皆文件」与系统调用#
introc/the_c_and_linux.tex 这一节很短,只有 55 行,但它是把”C 程序”和”操作系统”焊在一起的那一节。
教材原话非常直接:
“One POSIX mantra is that everything is a file. Although that has become recently outdated, and moreover wrong, it is the convention we still use today. What this statement means is that everything is a file descriptor, which is an integer.” ——
introc/the_c_and_linux.tex
然后给出一段经典三件套:
int file_fd   = open(...);      // 磁盘文件
int network_fd = socket(...);   // 网络 socket
int kernel_fd = epoll_create1(...); // 内核对象(epoll 实例)这三种东西在用户态看来都是 int,而操作系统通过「文件描述符表」把这个 int 映射到内核里的具体对象。这一条 POSIX 心智模型的重要性在于:你的进程和外部世界的所有交互,都长一个样——一个 int 加上 read/write/ioctl 三件套。
教材接着讲系统调用(下一节就是 common_c_functions.tex):
“A system call is an operation that the kernel carries out. First, the program places the system call number and its arguments in registers and executes a trap instruction. The kernel then carries out the call in kernel space, where it can perform privileged operations that user code cannot.” ——
introc/the_c_and_linux.tex
这是全书反复强调的一条边界——用户态写 C,内核态干活,中间靠 syscall 指令切换。这是后面所有内容(processes / threads / signals)的同一根脊柱。
我自己的学习笔记里把这条边界画在下面这张链路图里——fork → exec → wait 和 kill(信号) 在这条边界上的样子:
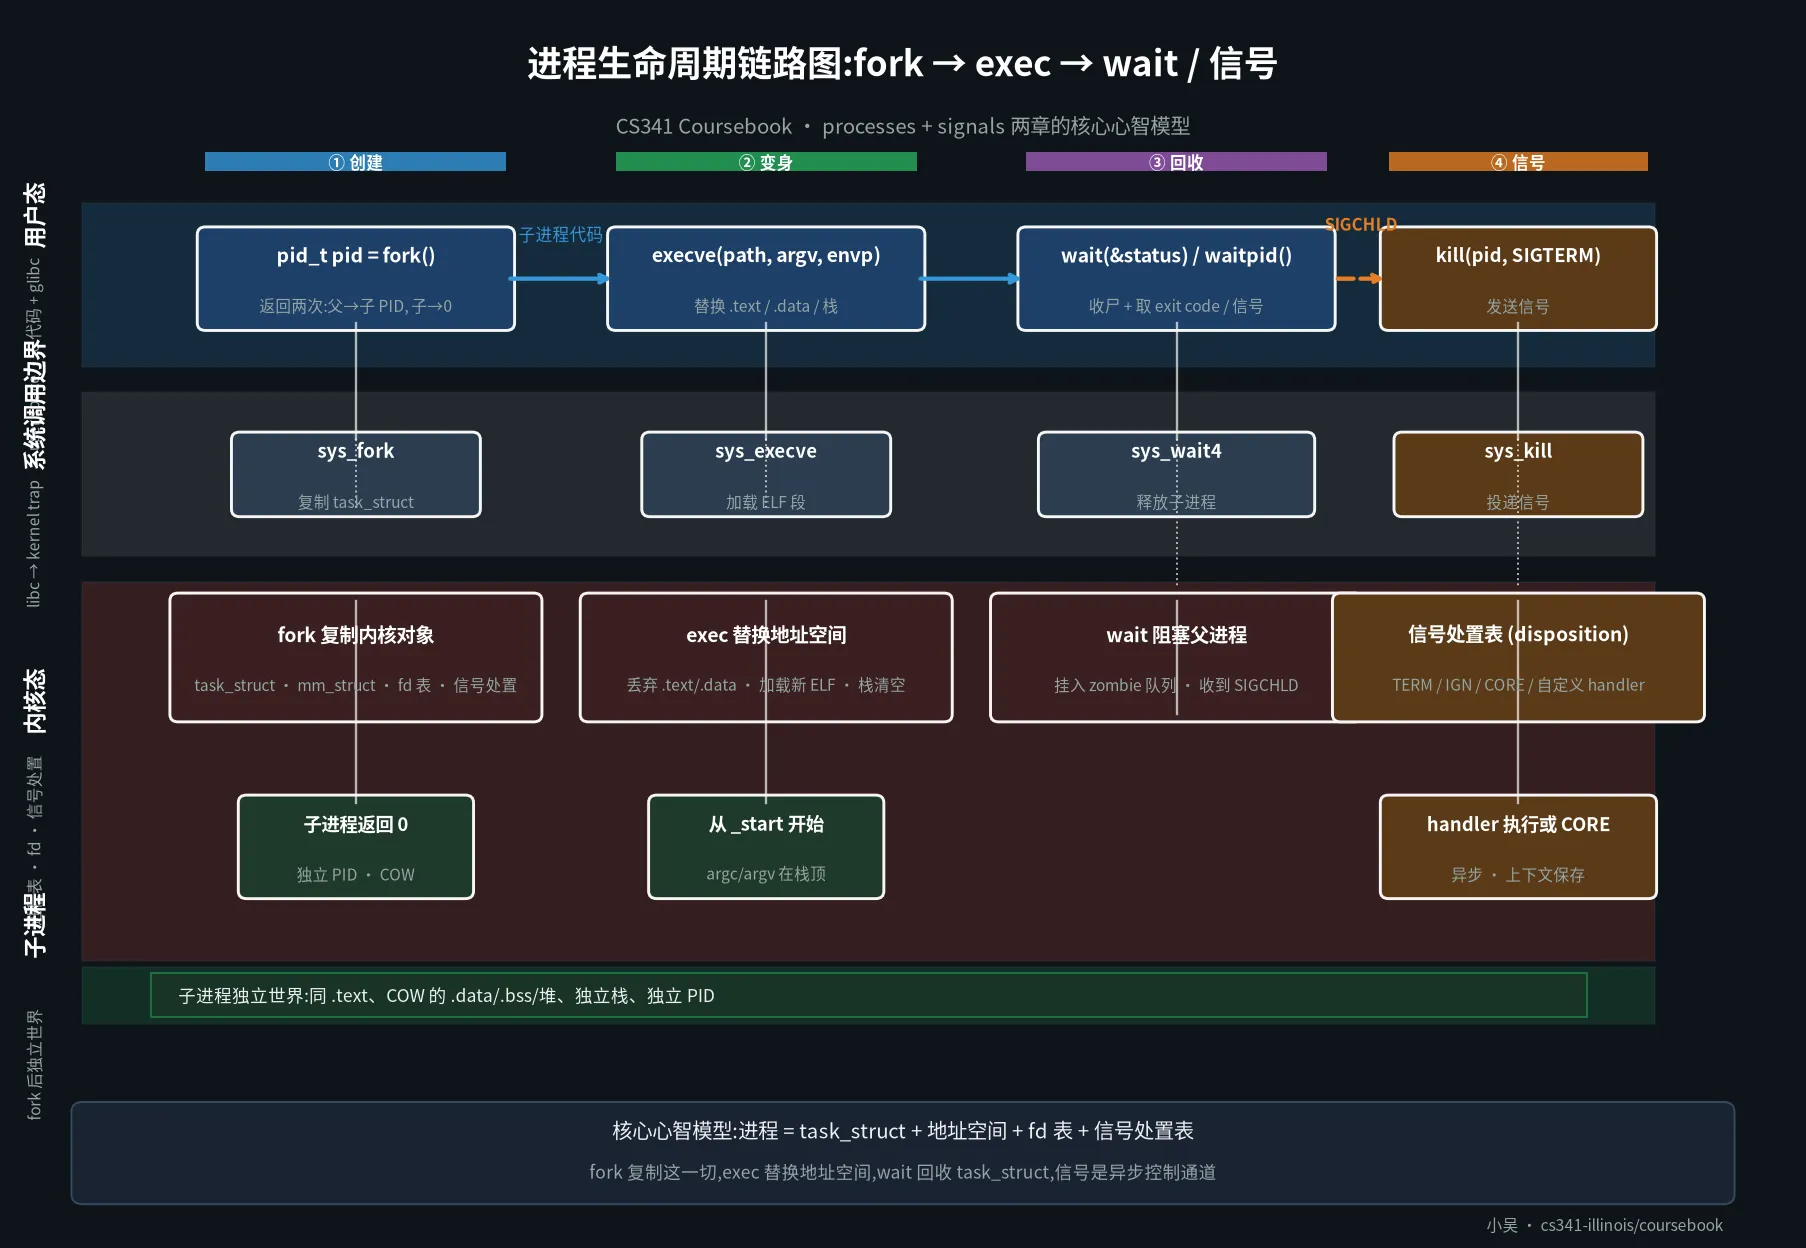
这张图把 processes 和 signals 两章串到了一起——后面我展开讲这张图的每一列。
五、进程:fork / exec / wait 是同一件事的三步#
processes/processes.tex 1027 行,内容庞杂,但核心套路只有一条:POSIX 把「创建一个进程」拆成「复制」和「变身」两步,「回收」单独一步。这套拆分在 Windows 上不存在,在 macOS XNU 上虽然兼容 POSIX 但实现细节不同。
5.1 fork:返回两次的诡异函数#
教材原话:
“fork() creates a new process by duplicating the calling process. The new process, referred to as the child, is an exact duplicate of the calling process, referred to as the parent… Both the parent and child continue executing from the point where fork() was called.” ——
processes/processes.tex§Fork
经典反直觉:同一个 pid_t pid = fork(); 语句,在父进程里返回子进程的 PID,在子进程里返回 0。教材专门给了一段代码展示为什么这种设计:
pid_t pid = fork();
if (pid < 0) {
    // fork 失败
} else if (pid == 0) {
    // 我是子进程,通常是这里调用 execve
    execve("/bin/ls", argv, envp);
} else {
    // 我是父进程,pid 是子进程 ID
    waitpid(pid, &status, 0);
}教材在这里埋了一个非常工程化的细节:子进程几乎一定会紧跟着 execve 调用,因为 fork 复制了父进程的整个地址空间(包括可能打开的 fd),而子进程真正想要的往往不是父进程,而是一个新程序。所以 POSIX 把这两个拆成两步——复制用 fork,变身用 exec,中间允许你做一些 fd 调整或环境清理。
我自己在读这一段时的关键收获是:fork 不是「创建进程」,它是「复制进程」。「创建新进程」这件事在 Linux 上是 clone()(教材在 threads 章里点了一句),而 fork() 只是 clone() 的一个特例——把新进程和父进程之间共享的部分设成 0。
5.2 exec:把当前进程整个换掉#
教材对 execve 的描述:
“The exec family of functions replaces the current process image with a new process image. The new image is constructed from a regular executable file… All previous process state is discarded.” ——
processes/processes.tex§Exec
execve(path, argv, envp) 是 6 个 exec* 函数里的「真身」,其它 execl / execv / execvp / execle / execvpe 都是它的语法糖,教材把它们做成表格逐个拆。
关键点:exec 之后 PID 不变,但地址空间整个换掉。这一条教材在 processes.tex 第二节明确写了——它和 fork 的区别就在这里。
教材还讲了一个反直觉的设计取舍:exec 成功后没有”返回值”,因为当前进程已经不存在了。你能拿到的只有两种情况——成功(回不来)、失败(返回 -1)。
5.3 wait:僵尸进程的葬礼#
教材这一节标题叫 “Waiting and Executing”,核心是 wait 和 waitpid:
“When a child process terminates, it becomes a zombie until its parent calls wait() or waitpid()… The kernel keeps a minimal amount of information about the zombie process: its PID, termination status, and resource usage.” ——
processes/processes.tex§Waiting
wait 的存在回答了一个看似无聊但实际很硬的问题:子进程退出后,谁来清理它的 task_struct?
答案:父进程不收尸,内核就一直留着那条记录(这就是 zombie 的含义)。教材给的状态机图非常清晰:
┌──────────┐   fork()    ┌──────────┐
│  Running │ ──────────→ │  Running │
│  Parent  │             │   Child  │
└────┬─────┘             └────┬─────┘
     │ wait()                  │ exit()
     │ ◄───────────────────    ▼
     │                   ┌──────────┐
     │                   │  Zombie  │
     ▼                   └────┬─────┘
┌──────────┐                 │ wait()
│  Running │ ◄───────────────┘
│  Parent  │  释放 task_struct
└──────────┘教材还讲了 WIFEXITED / WEXITSTATUS / WIFSIGNALED / WTERMSIG 这一堆宏的作用——区分”自己退”和”被别人信号打死”。
六、线程:进程里的「轻量版 fork」#
threads/threads.tex 605 行,核心点是:线程 ≈ 共享地址空间的进程。
教材原话:
“A thread is short for ‘thread-of-execution’. It represents the sequence of instructions that the CPU has and will execute… a thread is a process, meaning that creating a thread is similar to fork, except there is no copying meaning no copy on write. What this allows is for a process to share the same address space, variables, heap, file descriptors, etc.” ——
threads/threads.tex
教科书式的描述背后藏着一个工程事实:线程的真正系统调用是 clone(),Linux 上根本没有 pthread_create 这个系统调用——pthread_create 是 glibc 包出来的,它最终调用 clone(..., flags, ...) ,通过 flags 告诉内核「这次 fork 要不要共享地址空间」。
教材把这件事讲得很清楚:
// pthread_create 内部大致是:
clone(child_func, child_stack, CLONE_VM | CLONE_FILES | CLONE_FS | CLONE_SIGHAND, arg);CLONE_VM 这个 flag 是关键——它告诉内核「不要给新进程建新的 mm_struct,直接共用父进程的」。教材专门给了一段代码演示两个线程共享全局变量、但各自有独立的栈:
int sum = 0;  // 共享

void* worker(void* arg) {
    for (int i = 0; i < N; i++) sum += 1;  // 共享变量
    return NULL;
}这段代码就是后面 synchronization 章(全书最长,2395 行)的入口——sum += 1 在源码里是一行,翻译成汇编是 3 条指令(load → add → store),两线程并发执行可能丢更新。这是 critical section / race condition 的来源。
6.1 什么时候用进程 vs 线程#
教材给了一张很实在的清单,我直接照搬翻译:
| 用进程 | 用线程 |
|---|---|
| Chrome 浏览器不同标签页(隔离) | 想用多核加速单一任务 |
| 启动外部程序(gcc) | 大量共享状态 |
| 想避免 race condition | 通信密集(共享比同步便宜) |
| 通信少,简单 IPC 够用 | 不需要进程隔离 |
教材原话里有一句我特别喜欢:
“When you have too many threads — the kernel tries to schedule all the threads near each other which could cause more harm than good.” ——
threads/threads.tex
这是在劝退「线程越多越好」的迷信——线程切换本身有开销,线程多了反而 cache 命中下降。
七、同步:保护临界区的三种姿势#
synchronization/synchronization.tex 是全书最长的一章(2395 行),因为这是系统编程里最容易出错也最难讲清楚的部分。
教材开头就把核心问题摆出来:
“A critical section is a section of code that can only be executed by one thread at a time if the program is to function correctly.” ——
synchronization/synchronization.tex
然后给了一段 11 行的 countgold 代码,引出 race condition:
int sum = 0;
void* countgold(void* param) {
  int i;
  for (i = 0; i < 10000000; i++) sum += 1;
  return NULL;
}两线程并发跑,sum 的最终值大概率不是 20000000——因为 sum += 1 不是 atomic。教材紧跟着解释了为什么硬件的 add 指令也救不了:
“The operation may start by fetching the value of the memory from the stick of ram, then storing it in the cache or a register, and then finally writing back.” ——
background/background.tex
所以两条 add 指令即使在单核上也得有软件层的保护——教材把这事归到了三条路:
- 互斥锁(mutex):同一时刻只有一个线程进 critical section
- 条件变量(condition variable):线程等某个条件成立再继续
- 原子操作(atomic /
__sync_fetch_and_add):把三步操作压成硬件一步
教材在讲解 mutex 的时候特别强调了一个心智陷阱:
“Locks are not just for mutual exclusion. They also establish happens-before relationships in the memory model.” ——
synchronization/synchronization.tex
这一条对我来说是真正学到东西的地方——mutex 不只是「不准同时进」,它还在内存模型层面建立了「跨线程的事件顺序」。没有这个 happens-before 关系,即使两边代码顺序对,CPU 的乱序执行(out-of-order execution)也可能让你看到陈旧数据。
教材推荐了 Linux 上三个最常用的同步原语:pthread_mutex_t、pthread_cond_t、sem_t,还讲了 pthread_barrier_t(多线程 rendezvous)这种少见但工程上很有用的工具。
我自己的学习笔记:读完这一章后,我把工程上容易踩的坑列成下面 5 条:
- 永远别在持锁时调用可能阻塞的函数(包括
printf,因为它内部会锁 stdio) - 永远别在持锁时再请求同一把锁(死锁的经典触发器)
- 锁的粒度越小越好,但太小了会有性能开销——通常用 benchmark 调
pthread_cond_wait必须包在while里,因为 spurious wakeup 是 POSIX 规定的- 多锁时必须按固定顺序申请,否则 A→B 和 B→A 的两条路径会死锁
八、死锁:四条 Coffman 条件和一个画图工具#
deadlock/deadlock.tex 整章围绕一个核心定义展开:
“Deadlock is defined as when a system cannot make any forward progress.” ——
deadlock/deadlock.tex
然后给了一个非常工程化的版本:
“A system for the rest of the chapter as a set of rules by which a set of processes can move from one state to another, where a state is either working or waiting for a particular resource. Forward progress is defined as if there is at least one process working or we can award a process waiting for a resource that resource.”
教材把死锁的四条 Coffman 条件做成表:
| 条件 | 含义 |
|---|---|
| Mutual Exclusion | 资源不可共享(同一时刻只能被一个进程持有) |
| Hold and Wait | 持有资源的进程可以再申请新资源 |
| No Preemption | 已分配的资源不能被强制抢走 |
| Circular Wait | 存在一个「P1 持 R1 等 R2, P2 持 R2 等 R3, …, Pn 持 Rn 等 R1」的环 |
教材有一个非常实在的工程判断:
“In a lot of systems, deadlock is avoided by ignoring the entire concept… Have you heard about turn it on and off again? For products where the stakes are low (User Operating Systems, Phones), it may be more efficient to allow deadlock.” ——
deadlock/deadlock.tex
也就是说——对消费级系统,允许死锁然后重启是最便宜的方案。这是工程现实主义,不是教材放水。
教材提供了两种防死锁的策略:检测(resource allocation graph 找环)和避免(银行家算法)。它也给了一张非常清晰的资源分配图,用节点+边表示「谁持有什么/谁在等什么」:
   ┌──────┐  holds   ┌──────┐
   │  P1  │ ────────►│  R1  │
   └──────┘          └──────┘
       │ requests       ▲ holds
       ▼                │
   ┌──────┐  holds   ┌──────┐
   │  P2  │ ────────►│  R2  │
   └──────┘          └──────┘
       │ requests       ▲ requests
       ▼                │
(P1 wants R2)─────┘教材原话:有环 = 可能死锁(不是「一定死锁」,因为环只是潜在可能,真正死锁还要 P1 不释放 R1)。
我自己在工程上最常用的两条经验:
- 永远按固定顺序申请多把锁(lock ordering),直接破环
- 持锁时间尽可能短,critical section 里只做不可分操作
九、虚拟内存和 IPC:地址翻译的两级跳板#
ipc/ipc.tex 1090 行,把「虚拟内存」和「IPC」两件事捆在一章里讲,这是教材的精心安排——虚拟内存是为隔离,IPC 是为通信,两件事是同一枚硬币的两面。
教材对虚拟内存的引言非常接地气:
“In simple embedded systems and early computers, processes directly access memory… In modern systems, this is no longer the case. Instead, each process is isolated, and there is a translation process between the address of a particular CPU instruction or piece of data of a process and the actual byte of physical memory.” ——
ipc/ipc.tex
然后给出地址翻译的两级跳板:
虚拟地址 ──► TLB(快查缓存) ──► MMU(做页表翻译) ──► 物理地址
命中:跳过 MMU 缺页:触发 page fault教材把 32 位地址翻译讲得特别细——把 32-bit 切成 page number + offset,然后讲页表项(PTE)是什么,缺页异常怎么走。这部分我读下来和 OSTEP 那本很接近,但 CS341 多了一个细节:MMU 是 CPU 的一部分,不是单独的芯片——这关系到性能(必须 L1/L2 紧挨 CPU)。
IPC 部分教材讲了 7 种机制,我按我的理解把它们从「最快最贵」到「最慢最通用」排了个序:
| 机制 | 速度 | 适用 |
|---|---|---|
共享内存(mmap + MAP_SHARED) | 最快(没有内核拷贝) | 高吞吐,大数据 |
管道(pipe) | 快 | 父子进程、有血缘关系 |
| UNIX Socket | 中 | 同机进程,也可以跨网 |
| TCP Socket | 中 | 跨机 |
| UDP Socket | 中 | 跨机、低延迟(不可靠) |
消息队列(mq_*) | 慢 | 解耦 |
| 信号(Signal) | 最快但容量小(一个 int) | 通知,不传数据 |
教材对共享内存的设计解释得很透——MAP_SHARED 的 mmap 让两个进程看到同一块物理页。这块页在内核的 VMA 里同时挂在两个进程的 mm_struct 上,翻译到同一个 page frame。这是教科书写 IPC 都会画的图,我就不重复画了。
我自己的学习笔记里总结的一条:「快」的本质是「少几次内核拷贝」——pipe 是 4 次拷贝(用户 → 内核 → 内核 → 用户),mmap 是 1 次(直接共享)。同样传 1GB 数据,差的就是这 3 次拷贝。
十、信号:异步控制通道#
signals/signals.tex 把信号定位为「异步通知」而不是「通信」:
“Signals are a convenient way to deliver low-priority information and for users to interact with their programs when other ways don’t work… Crafting a program that uses signals well is tricky due to how signals are handled. As such, signals are usually for termination and clean up. Rarely are they supposed to be used in programming logic.” ——
signals/signals.tex
这一段是教材里我最喜欢的一段元认知——它在告诉你「什么时候不要用信号」。这是非常工程化的忠告。
教材把信号的 disposition(处置方式)归类成 6 种:
- TERM - 终止进程(默认行为)
- IGN - 忽略(但
SIGKILL和SIGSTOP不可被忽略) - CORE - 生成 core dump
- STOP - 暂停进程(同 SIGSTOP)
- CONT - 继续进程(同 SIGCONT)
- 执行自定义函数 - signal handler
教材把 SIGKILL 和 SIGSTOP 单独拎出来强调「不可被 catch / block / ignore」,这是一个非常重要的工程事实——这两个信号是内核「兜底」的,任何用户态代码都不能拦截它们。
教材给的信号处理流程图非常关键:
信号产生 ──► 投递(deliver) ──► 进程从内核态返回时检查 signal mask
                            ──► mask 允许 ──► 按 disposition 处置
──► mask 屏蔽 ──► 暂存到 pending 队列,等 mask 解除教材把 signal mask 和 pending 队列分开,这一条让我对信号的整个心智模型清晰了——信号不是一发必中的,它要等进程当前路径「窗口」才被处理。
我自己最常用的工程经验:
- handler 里只做
volatile sig_atomic_t flag = 1;,复杂的逻辑放到主循环里查 flag - 不要在 handler 里调用
printf或malloc(它们不是 async-signal-safe) SIGCHLD是父进程等子进程退出的关键——它在子进程变 zombie 时发出,触发父进程从wait返回
教材最后给了一个关键警告:信号和线程交互是「噩梦级」——一个信号投递到多线程进程时,内核会挑一个线程处理,挑哪个你不知道。这让多线程程序的信号处理几乎不可预测。教材建议的工程方案:专门起一个线程用 sigwait 同步等待信号,把异步变成同步。
十一、文件系统:对数据持久化的工程妥协#
filesystems/filesystems.tex 把文件系统定位为「对慢速存储介质的合理组织方式」:
“Filesystems are important because they allow you to persist data after a computer is shut down, crashes, or has memory corruption. Back in the day, filesystems were expensive to use. Writing to the filesystem (FS) involved writing to magnetic tape and reading from that tape.” ——
filesystems/filesystems.tex
教材在这一章里做了一个非常良心的事情——它花了整整一节解释「KB / KiB」这个经典坑:
“In this chapter, we will refer to sizes of files in the ISO-compliant KiB or Kibibyte… KiB = 1024B, MiB = 1024 * 1024 B…” ——
filesystems/filesystems.tex
这个区分直到今天还在让无数工程团队犯错——买硬盘标着「1 TB」,实际只有 931 GiB,差 7%。教材把这个摆在前几节,是希望学生从一开始就建立「不要假设 1024 = 1000」的习惯。
教材对 inode 的描述遵循经典 Unix 哲学:inode 是文件的元数据,name 只是路径名。同一 inode 可以有多个名字(hard link),但目录文件不算文件(目录也是文件,但内容是「name → inode」的映射)。
教材最后给了一个非常贴近现代系统的章节——虚拟文件系统(VFS):
“Often, operating systems will add a layer of abstraction and require that the operating system satisfy its API instead (think imaginary functions linux_open, linux_close etc). The two benefits are that one filesystem can be implemented for multiple operating system APIs and adding a new OS filesystem call doesn’t require all of the underlying file systems to change their API.” ——
filesystems/filesystems.tex
这就是为什么 Linux 能同时挂载 EXT4 / NTFS / FAT32 / NFS / overlayfs——所有 FS 都通过 VFS 抽象层对内核暴露同一套 inode_operations。
十二、网络:OSI 7 层 + POSIX socket#
networking/networking.tex 整章以 OSI 7 层模型作为骨架:
| 层 | 名字 | 例子 |
|---|---|---|
| 1 | Physical | 电信号、光信号、无线电波 |
| 2 | Data Link | Ethernet、WiFi |
| 3 | Network | IP |
| 4 | Transport | TCP、UDP |
| 5 | Session | RPC、SSL |
| 6 | Presentation | TLS、压缩 |
| 7 | Application | HTTP、DNS、FTP |
教材对 POSIX socket 的描述非常实在——它直接跳过理论,给一段经典的 socket() → bind() → listen() → accept() 流程,然后给一个完整的 echo server。这种「先给代码再讲原理」的方式和前面 introc 章一致,贯穿全书。
教材点了一条非显而易见的事:POSIX 用同一个 socket() 调用处理 TCP 和 UDP,只是 type 参数不同。这是 Unix 「一切皆文件」哲学在网络的延伸——网络 socket 也是 fd,可以用 read/write 操作(虽然有些细节要 recv/send)。
教材对 select / poll / epoll 的演进讲得非常清晰——**它们都是为了解决「如何同时监听多个 fd」**这个问题。select 是 O(N) 扫描 fd 位图,poll 是 O(N) 扫描链表,epoll 是 O(1) 内核回调注册。这是从 90 年代到 2000 年代 Linux 网络性能飞跃的关键。
我自己的工程经验:epoll 不是「永远比 select 好」——连接数小(<100)时 select 更省事,因为 epoll 的 syscall 开销在小规模下不划算。
十三、安全:工程现实主义 + CFAA 的法律红线#
security/security.tex 把安全分成三类人:
“There are different types of attackers. There are white hat hackers who attempt to hack a defender with their consent. This is commonly a form of pre-active testing… black hat hackers are hackers who hack without permission and the intent to use the information obtained for any purpose. Gray hat hacking differs because the hacker’s intent is to inform the defender of the vulnerability.” ——
security/security.tex
然后用了一整节讲 CFAA(Computer Fraud and Abuse Act)——这才是这一章真正想强调的:
“Before we let you go much further, it is important that we talk about ethics. Before you skip over this section, know that your career quite literally can be terminated over an unethical decision that you might make. The Computer Fraud and Abuse Act (CFAA) is a broad, and arguably terrible law, that casts non-authorized use of a ‘protected computer’ as a crime.” ——
security/security.tex
这一节我读的时候非常震撼——一本技术教材花了整整一节告诉你「CFAA 是笼统的,而且 protected computer 这个定义范围极广,基本上任何联网的电脑都算」。它在劝告学生:先拿到书面授权,再去动手。
教材给了一个非常具体的授权 ladder:
- 首选:拿到上司的书面许可
- 次选:和工程方走「按步骤走」的流程
- 最差:自己判断「intended use」,但要承担后果
这是工程现实主义——不是教你「不要攻击」,而是教你「什么时候可以攻击,要先有谁背书」。
教材最后列了 8 类常见攻击(buffer overflow / ROP / format string / integer overflow / TOCTOU / SQL injection / XSS / CSRF),但每一类只点到为止,深度都在 processes 和 malloc 章里——比如 buffer overflow 的根因是 strcpy 不检查长度,教材在 introc/common_bugs.tex 里讲过。
我自己的学习笔记:这一章和「技术」关系不大,和「工程规范」关系极大。它教你的不是「怎么 hack」,而是「怎么在被 hack 的时候不被反咬一口」。
十四、调度:不要被「公平」骗了#
scheduling/scheduling.tex 整章围绕一个被工程现实反复毒打的问题:CPU 是稀缺资源,谁先跑?
教材开篇引了一段 Alice in Wonderland 的歌词(“I’m late, I’m late, I’m late”)——这是非常文学化的开场,但它要表达的意思很硬核:调度是延迟(cold start latency)和吞吐量(throughput)的取舍。
教材对「短时调度」和「长/中时调度」的区分很有教学价值:
- 长时调度(long-term):决定哪些进程能进内存(实际上是 admission control)
- 中时调度(medium-term):决定哪些进程要被换到 swap
- 短时调度(short-term):决定CPU 现在跑哪个进程
CS341 这门课重点讲短时调度,但会顺手提一下 Hadoop / Celery 这类「用户态调度器」——它们的策略就是用 SIGSTOP / SIGCONT 控制进程组,这是一个非常巧妙的复用信号的方式。
教材对 FCFS / Round-Robin / MLFQ 的讲解和 OSTEP 类似,但 CS341 多了一个工程现实——
“You can implement schedulers yourself! If you are given a list of commands to exec, a program can schedule them with SIGSTOP and SIGCONT. These are called user space schedulers.” ——
scheduling/scheduling.tex
我在 Kubernetes 的源码里真的看到过这种模式——kubelet 在节点压力过大时,会给某些容器发 SIGSTOP,这就是教材里讲的「用户态调度」的现代版。
教材最后给了一个最实用的心智——调度不是「对」的,是「够用」的。Round-Robin 简单但会让 IO 密集型进程卡死 CPU;MLFQ 聪明但复杂到 Linux 维护者都想替换它(著名的 CFS 改革)。
十五、学习笔记收尾:这本书真正在教什么#
读完整个 coursebook,我把它**真正在传达的「心智主线」**总结成下面 5 条——这 5 条也是我想从这篇文章里留给你的:
15.1 心智主线一:C 程序 = 一段字节流#
C 不是「面向对象」也不是「函数式」——C 是「字节序的」。int 是 4 字节,struct 是连续字节块,malloc 是「给我 N 字节,告诉你基地址」。这本书从头到尾都在强化这个心智:先想字节怎么排,再想语法怎么写。
15.2 心智主线二:进程是「内核对象」#
一个进程 = 一个 task_struct + 一个地址空间 + 一个 fd 表 + 一个 signal disposition 表。这四样东西是绑定的,任何一项出问题,进程都”死”。fork 是「复制这四样」,exec 是「替换地址空间」,wait 是「回收 task_struct」,信号是「异步修改 disposition 状态」。
15.3 心智主线三:线程是「共享地址空间的进程」#
线程 ≈ 进程,只是不复制地址空间。教材反复强调「栈是线程私有的」——因为同步问题的根就在「栈私、堆共享」这个不对称上。
15.4 心智主线四:锁不只是互斥,还是「happens-before」#
mutex 不只是「不准两个线程同时进」,它在内存模型层面建立了事件顺序。没有这个顺序,即使代码看着对,CPU 的乱序执行也会让你读到陈旧数据。CS341 在 synchronization 章里把这件事讲得很清楚——比很多教科书都清楚。
15.5 心智主线五:一切皆文件 + 一切皆 syscall#
POSIX 的核心哲学:所有外部资源都是 fd,所有 fd 上的操作最终都进 syscall。文件、socket、pipe、epoll、inotify——长一个样,调用一个套路。这一条心智模型让你在 Linux 上写代码时几乎不用思考就能找到对的 API。
十六、横向对比:CS341 和其他系统书的差异#
读完这本书,我把它和 OSTEP / CSAPP / MIT 6.828 / Linux Kernel Development 等书做了一个横向比较,这是我个人的判断:
| 书 | 强项 | 弱项 |
|---|---|---|
| CS341 Coursebook | LaTeX 排版用心,内核工程细节扎实,代码示例贴近 Linux | 不够系统化(更像 wiki 而非 textbook),例子偏教学 |
| OSTEP | 教学设计最优雅,从零开始构建操作系统 | 偏理论,工程细节少 |
| CSAPP | 从硬件讲到软件,覆盖面最广 | 太厚(1000+ 页),不能当手册用 |
| MIT 6.828 | xv6 源码 + 实验,真上手 | 只讲 RISC-V,概念覆盖度小 |
| LKD (Linux Kernel Development) | Linux 内核视角,工程级真实 | 偏内核开发者视角,不适合 application 层 |
CS341 的定位在我看来非常独特——它不是为内核开发者写的,也不是为应用开发者写的,它是为「想从应用跨到内核」的工程师写的。这一类人最痛苦的不是不会 C,而是不知道「用户态的某一行 C 翻译到内核后变成了什么」。CS341 把这件事讲透了。
十七、这个项目本身的几个亮点#
最后说说我对这个项目本身的几个观察,既是技术笔记也是写给读者的”项目八卦”:
- 以 LaTeX 为唯一源,自动生成 PDF/EPUB/HTML/Wiki 四种产物——
.github/workflows/deploy.yaml里定义了 5 条 CI 流水线,每条产物走不同路径。这是非常值得借鉴的「文档工程」做法。 - 所有插图都是手绘的
.eps——包括那张著名的封面小鸭子(_images/duck-alpha-cropped.png)。我读的时候发现introc/drawings/里有一套专门讲 C 内存模型的 11 张图(空/有长度/有内容三态),作者对教学是真的用心。 - 有一章叫
post_mortems/——记录过去的”事故复盘”。这种”我们以前做错过什么”的章节在教科书里很少见,体现了作者的工程反思习惯。 - 每一章都有
.bib文件——引用真实文献。比如 atomicity 那段就引用了 Schweitzer 的 Evaluating Atomic Operations 和 Intel 手册。 - Ducky 彩蛋——README 里写 “Oh and the duck? Keep reading until synchronization :)“,意思是同步章里那只鸭子会再出现。这是我见过的最可爱的课程彩蛋。
十八、给读者的三条建议#
如果你打算精读这本书,这是我读完后的三条具体建议:
18.1 不要从 introduction 开始读#
introduction/introduction.tex 是项目自述,读了能了解背景,但对学习没帮助。直接从 introc/c_memory_model.tex 开始,用 xdg-open 边读边打开 introc/drawings/memory_model_empty.eps 等图片看(目录里有 SVG/PNG 多份)。把 struct 是字节块、malloc 是字节流这条心智钉死,后面所有章节就读得动了。
18.2 边读边跑#
每个章节的代码示例都要手动敲一遍,哪怕照抄。比如 threads/threads.tex 里的 countgold race condition 代码,你如果不真的开两个 pthread 跑一次,看到 sum += 1 那行不会有什么感觉。亲手制造一次 bug,胜过读十遍「会发生 race」。
18.3 对照源码读 LaTeX#
introc/the_c_and_linux.tex 那段 open / socket / epoll_create1 是教学代码,但真正的工程代码在 glibc / musl / Linux 内核里。建议读到「系统调用」相关的章节时,顺便 apt source glibc 或者 git clone https://gh-proxy.com/https://github.com/bminor/musl.git 看一眼,文件描述符和 syscall 在内核源码里的样子。这一步下来,你才真正”看到”了那行 C 在内核里变成了什么。
十九、可复用方法论:读教材的正确姿势#
读完这本书,我把自己用的方法论总结成下面 4 步,适用于所有”大而杂”的开源教材:
- 先看
main.tex+order.yaml——目录是骨架,主入口是缝合方式。 - 找「心智根」章节——CS341 是
introc/c_memory_model.tex,你的项目可能是另一章。找到它,反复读。 - 画一张总图——把心智根到叶子节点的关系画在一张图里。我这次画了 2 张:虚拟地址空间图 + 进程生命周期图。
- 横向比较同类项目——读完一个,横向比 3 个。这一步能看出”这个项目独特在哪”。
这套方法论不挑项目——你可以用它读 MIT 6.824(找心智根到 Raft 那条线)、读 Linux Kernel(找心智根到进程调度那条线)、读 Postgres 源码(找心智根到 MVCC 那条线)。
二十、写在最后#
cs341-illinois/coursebook 不是一本”完美”的教材——它的写作风格偏 wiki,部分章节还在 TODO 状态,图也大多不是专业排版。但它做对了一件事:把”系统编程”里那些最难讲清楚的概念,用一段段非常朴素的 LaTeX 给你讲清楚了。
这种朴素让我想起 Bhuvy(项目维护者)在 introduction 章节里写的那句话:
“We don’t think information should be behind a walled garden, and we truly believe that complex concepts can be explained simply and fully, for anyone to understand.” ——
introduction/introduction.tex
我读完这句话的时候,想起了自己刚学 C 时的茫然——为什么 int *p 和 int* p 不一样?为什么 fork 会返回两次? 这些问题在这本书里都能找到答案,而且答案的语气都很平和,没有”你应该早就会”的不耐烦。
如果你也想读 C 系统编程,我把它推荐给你。
参考与引文#
本文涉及的所有引用都来自 cs341-illinois/coursebook 仓库本身,以下是我精读过的章节(目录里的 .tex 文件):
introc/introc.tex—— C 编程语言总论introc/c_memory_model.tex—— C 内存模型(心智根)introc/pointers.tex—— 指针基础introc/the_c_and_linux.tex—— 「一切皆文件」与系统调用introc/history_of_c.tex—— C 语言历史introc/common_bugs.tex—— C 常见 bugprocesses/processes.tex—— POSIX 进程(fork/exec/wait)malloc/malloc.tex—— 内存分配器threads/threads.tex—— 线程(LWP / pthread)synchronization/synchronization.tex—— 同步原语(全书最长)deadlock/deadlock.tex—— 死锁与 Coffman 条件ipc/ipc.tex—— 虚拟内存 + IPCsignals/signals.tex—— 信号(异步通知)scheduling/scheduling.tex—— CPU 调度filesystems/filesystems.tex—— 文件系统(KiB / inode / VFS)networking/networking.tex—— OSI 7 层 + POSIX socketsecurity/security.tex—— 安全 + CFAA
仓库地址:github.com/cs341-illinois/coursebook ↗
关于配图:本文两张图都是用 matplotlib 重新画的——
img1-c-memory-layout.png是 C 进程虚拟地址空间总图,img2-fork-exec.png是 fork/exec/wait/信号四阶段链路图。原书里的.eps图我也保留了供对照,但重画的目的是中文注释更贴近学习笔记的口味。