深入解析 rakyll/hey:用 700 行 Go 写一个值得读三遍的 HTTP 负载生成器
💬 评论拆解 rakyll/hey(17k Star / 320KB / 5 个 Go 文件):httptrace.ClientTrace 把一次 HTTP 切成 5 段时间,C 个 worker + 1 个 reporter 的并发拓扑,text/template 的极简输出格式。
一、为什么我要拆这个项目#
我打开 rakyll/hey 的第一个反应是:“就这?”
整个仓库 git clone 下来 320KB,主目录 5 个 Go 文件:
hey/
├── hey.go              ← 主入口(199 行,全是 flag 解析)
├── hey_test.go
├── go.mod / go.sum      ← 一个依赖:golang.org/x/net/http2
├── requester/
│   ├── requester.go     ← 并发负载生成(274 行)
│   ├── report.go        ← 统计数据结构(323 行)
│   ├── print.go         ← text/template 输出(128 行)
│   └── now_other.go / now_windows.go  ← 跨平台时钟(24 + 47 行)
└── Makefile / Dockerfile / README.md7159 字节的 hey.go + 930 行的 requester/,加一起不到 1100 行 Go 代码,就撑起了 17k Star、被 Google 官方背书、几乎所有 Go 工程师人手一个的 HTTP 压测工具。
这事的真正问题不是”它怎么这么小”,而是”它怎么做到这么小还能这么准”。
我读完 5 个文件,找到答案:
hey 之所以这么小,是因为它把”HTTP 负载测试”这件事拆成了三个互不耦合的小问题—— (1) 命令行参数解析,(2) C 个 worker 并发执行,(3) 1 个 reporter 异步统计。 三个问题分别由 3 个 goroutine + 1 个 channel 解决,中间没有任何共享状态。
而它之所以”准”,靠的是 Go 标准库里一个大部分人没用过的 API——net/http/httptrace.ClientTrace。这个 API 让你能在 HTTP 请求的内部里程碑事件上注册回调,把一次请求切成 5 段独立计时。
这就是这篇文章要拆的两条主线:并发拓扑 + 时间切分。我先把第一张图给你看,然后顺着代码一行行讲。
二、hey 的入口:其实只是个 flag 解析器#
hey.go 199 行,扣掉 license / import / 注释,真正干活的代码不到 80 行。它只干两件事:
2.1 解析命令行#
var (
    m   = flag.String("m", "GET", "")        // HTTP method
    n   = flag.Int("n", 200, "")             // 总请求数
    c   = flag.Int("c", 50, "")              // 并发 worker
    q   = flag.Float64("q", 0, "")           // QPS 限速
    z   = flag.Duration("z", 0, "")          // 压测时长
    h2  = flag.Bool("h2", false, "")         // HTTP/2
    // ... 共 22 个
)这些 flag 字段,加上一个 headerSlice 自定义类型(让 -H 标志可以重复出现),就是 hey 的全部 CLI 表面。
2.2 构造 Work 结构体#
w := &requester.Work{
    Request:            req,
    RequestBody:        bodyAll,
    N:                  num,
    C:                  conc,
    QPS:                q,
    Timeout:            *t,
    DisableCompression: *disableCompression,
    DisableKeepAlives:  *disableKeepAlives,
    DisableRedirects:   *disableRedirects,
    H2:                 *h2,
    ProxyAddr:          proxyURL,
    Output:             *output,
}
w.Init()

// 捕获 Ctrl+C,优雅停止
c := make(chan os.Signal, 1)
signal.Notify(c, os.Interrupt)
go func() {
    <-c
    w.Stop()
}()
if dur > 0 {
    go func() {
        time.Sleep(dur)
        w.Stop()
    }()
}
w.Run()注意这里有三个 goroutine 的入口:Run()(主 worker 池)、signal.Notify(Ctrl+C 处理)、time.Sleep(dur)(持续时间到就停)。
Work 结构体就是 hey 全部配置的载体——这是非常经典的 Go 设计:主程序只做”组装”,业务逻辑全部封装到子包里。hey.go 不到 200 行,因为所有真正的活都在 requester 里。
三、并发拓扑:C 个 worker + 1 个 reporter#
让我先给你看 hey 整体的并发拓扑,这张图把 requester.go 和 report.go 的协作关系画清楚了:
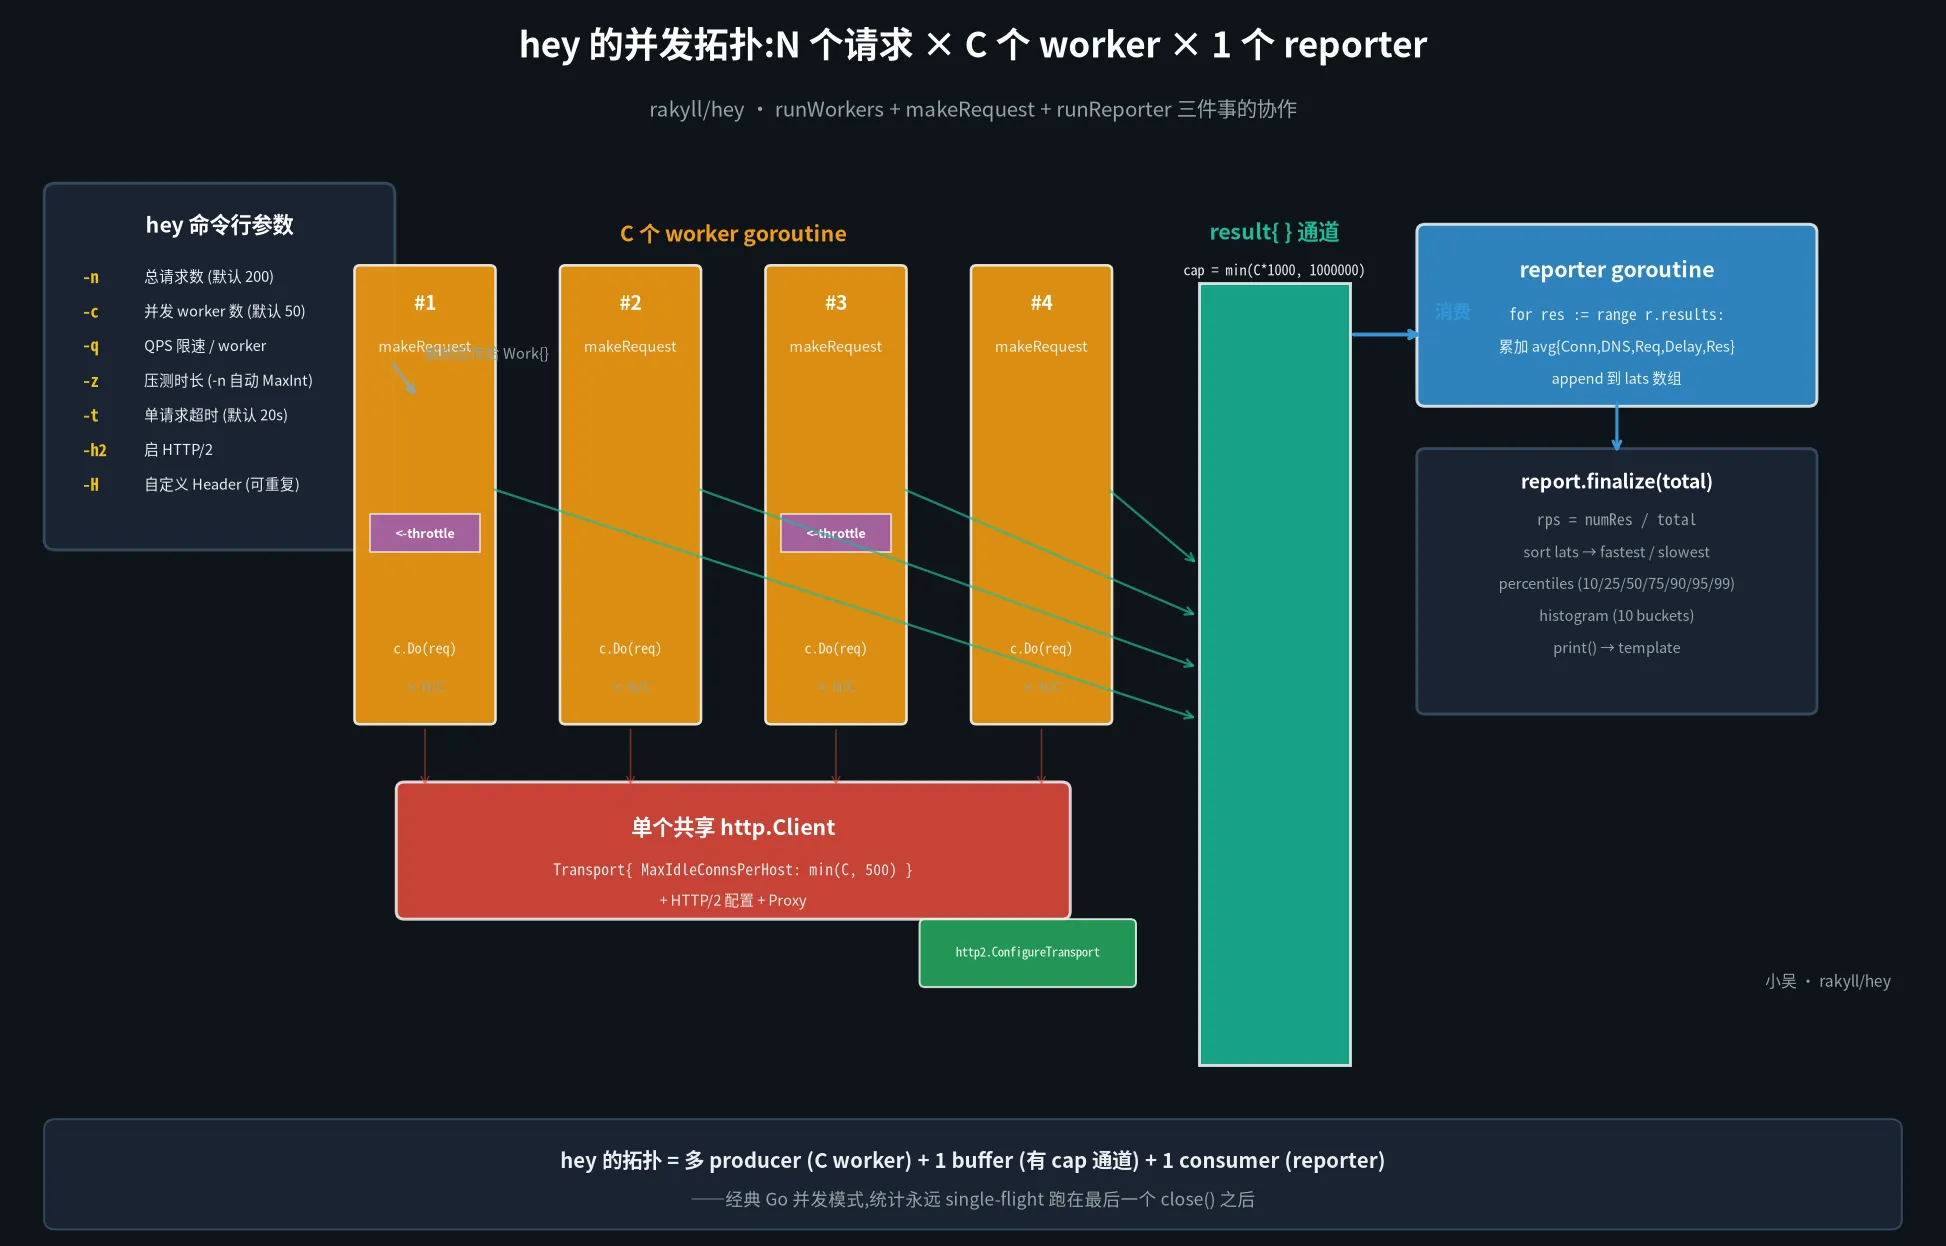
这张图最值得注意的几个点:
3.1 拓扑:N 个 producer + 1 个 buffer + 1 个 consumer#
          ┌── worker #1 ──┐
flags ──► ├── worker #2 ──┤──► result{ } 通道 ──► reporter ──► finalize
          ├── worker #3 ──┤   (cap = min(C*1000, 1000000))
          └── worker #4 ──┘
              ↓ ↓ ↓
            单个共享 http.Client
(Transport{ MaxIdleConnsPerHost: min(C, 500) })这是 Go 里最经典的并发模式——多 producer、单 buffer、单 consumer。requester.go 里这一段就是它的实现:
func (b *Work) Run() {
    b.Init()
    b.start = now()
    b.report = newReport(b.writer(), b.results, b.Output, b.N)
    // reporter goroutine 先跑,异步消费 results
    go func() {
        runReporter(b.report)
    }()
    b.runWorkers()  // 阻塞到所有 worker 完成
    b.Finish()      // close(results),等 reporter 退出
}关键点有三个:
results通道的容量是min(C*1000, 1000000)——这是工程师的工程判断:容量太小会卡住 worker(阻塞在 send 上),容量太大又会浪费内存。1000000 是上限(怕内存爆炸),1000×C 是下限(给 worker 一定堆积空间,允许 reporter 慢一点时 worker 不被卡)。runReporter用for res := range r.results退出——range在通道被 close 后会自然退出,不需要额外的退出信号。这是用 close 作为”所有人都干完了”信号的经典 Go 模式。- reporter 是 single-flight——
Finish()里close(b.results)之后,reporter 才会真正开始算 rps / percentile / histogram。这就是为什么 hey 不会因为 reporter 慢而影响 worker——reporter 是异步的。
3.2 共享 client:关键工程决策#
tr := &http.Transport{
    TLSClientConfig:     &tls.Config{InsecureSkipVerify: true, ...},
    MaxIdleConnsPerHost: min(b.C, maxIdleConn),  // ← 关键:连接池大小 = 并发数
    DisableCompression:  b.DisableCompression,
    DisableKeepAlives:   b.DisableKeepAlives,
    Proxy:               http.ProxyURL(b.ProxyAddr),
}
if b.H2 {
    http2.ConfigureTransport(tr)
} else {
    tr.TLSNextProto = make(map[string]func(string, *tls.Conn) http.RoundTripper)
}
client := &http.Client{Transport: tr, Timeout: time.Duration(b.Timeout) * time.Second}这条 MaxIdleConnsPerHost: min(b.C, 500) 是 hey 的核心性能决策:
- 如果你的
MaxIdleConnsPerHost小于并发数,worker 会在Dial()上阻塞等连接,整个测试就会被 TCP 三次握手拖慢 - 但又不能无限大,500 是 Go 标准库默认值之上调高的(标准库默认是
DefaultMaxIdleConnsPerHost = 2,这在压测时远远不够)
这是为什么 hey 不需要每次请求都重新建连——所有 worker 共享一个 http.Client,连接池大小等于并发数,长连接全开。
HTTP/2 那条逻辑也很精巧:tr.TLSNextProto = make(map[string]...) 是显式禁用 HTTP/2——如果用户没传 -h2,就把 NPN/ALPN 协商关掉,让 TLS 握手走 HTTP/1.1。这避免了某些服务在 HTTP/1 和 HTTP/2 上行为不一致时的混淆。
3.3 QPS 限流:每个 worker 一个 ticker#
func (b *Work) runWorker(client *http.Client, n int) {
    var throttle <-chan time.Time
    if b.QPS > 0 {
        ticker := time.NewTicker(time.Duration(1e6/(b.QPS)) * time.Microsecond)
        defer ticker.Stop()
        throttle = ticker.C
    }
    for i := 0; i < n; i++ {
        select {
        case <-b.stopCh:
            return
        default:
            if b.QPS > 0 {
                <-throttle
            }
            b.makeRequest(client)
        }
    }
}-q 10 -c 5 表示”5 个 worker,每个 worker 限速 10 QPS”,总 QPS = 50。这是 QPS-per-worker 的限流——每个 worker 独立 ticker,所以 -q 是「每个 worker 的 QPS 上限」,不是「总 QPS」。
如果想限流总 QPS,你得自己算 -q = 总 QPS / -c。这个细节 README 里没写,但代码里写得清清楚楚。
stopCh 是优雅停止的关键——Ctrl+C 信号会往 stopCh 里灌 b.C 个空结构体,所有 worker 在下一次循环开头检查到 stopCh 有值就 return。但已经在飞行中的请求会跑完——这就是为什么 hey 的 Ctrl+C 是”准优雅停止”而不是”硬杀”。
四、hey 的核心心智:httptrace.ClientTrace 把一次请求切成 5 段#
这是 hey 最值钱的一段代码——只有 30 行,但它告诉用户”你的请求到底慢在哪一段”:
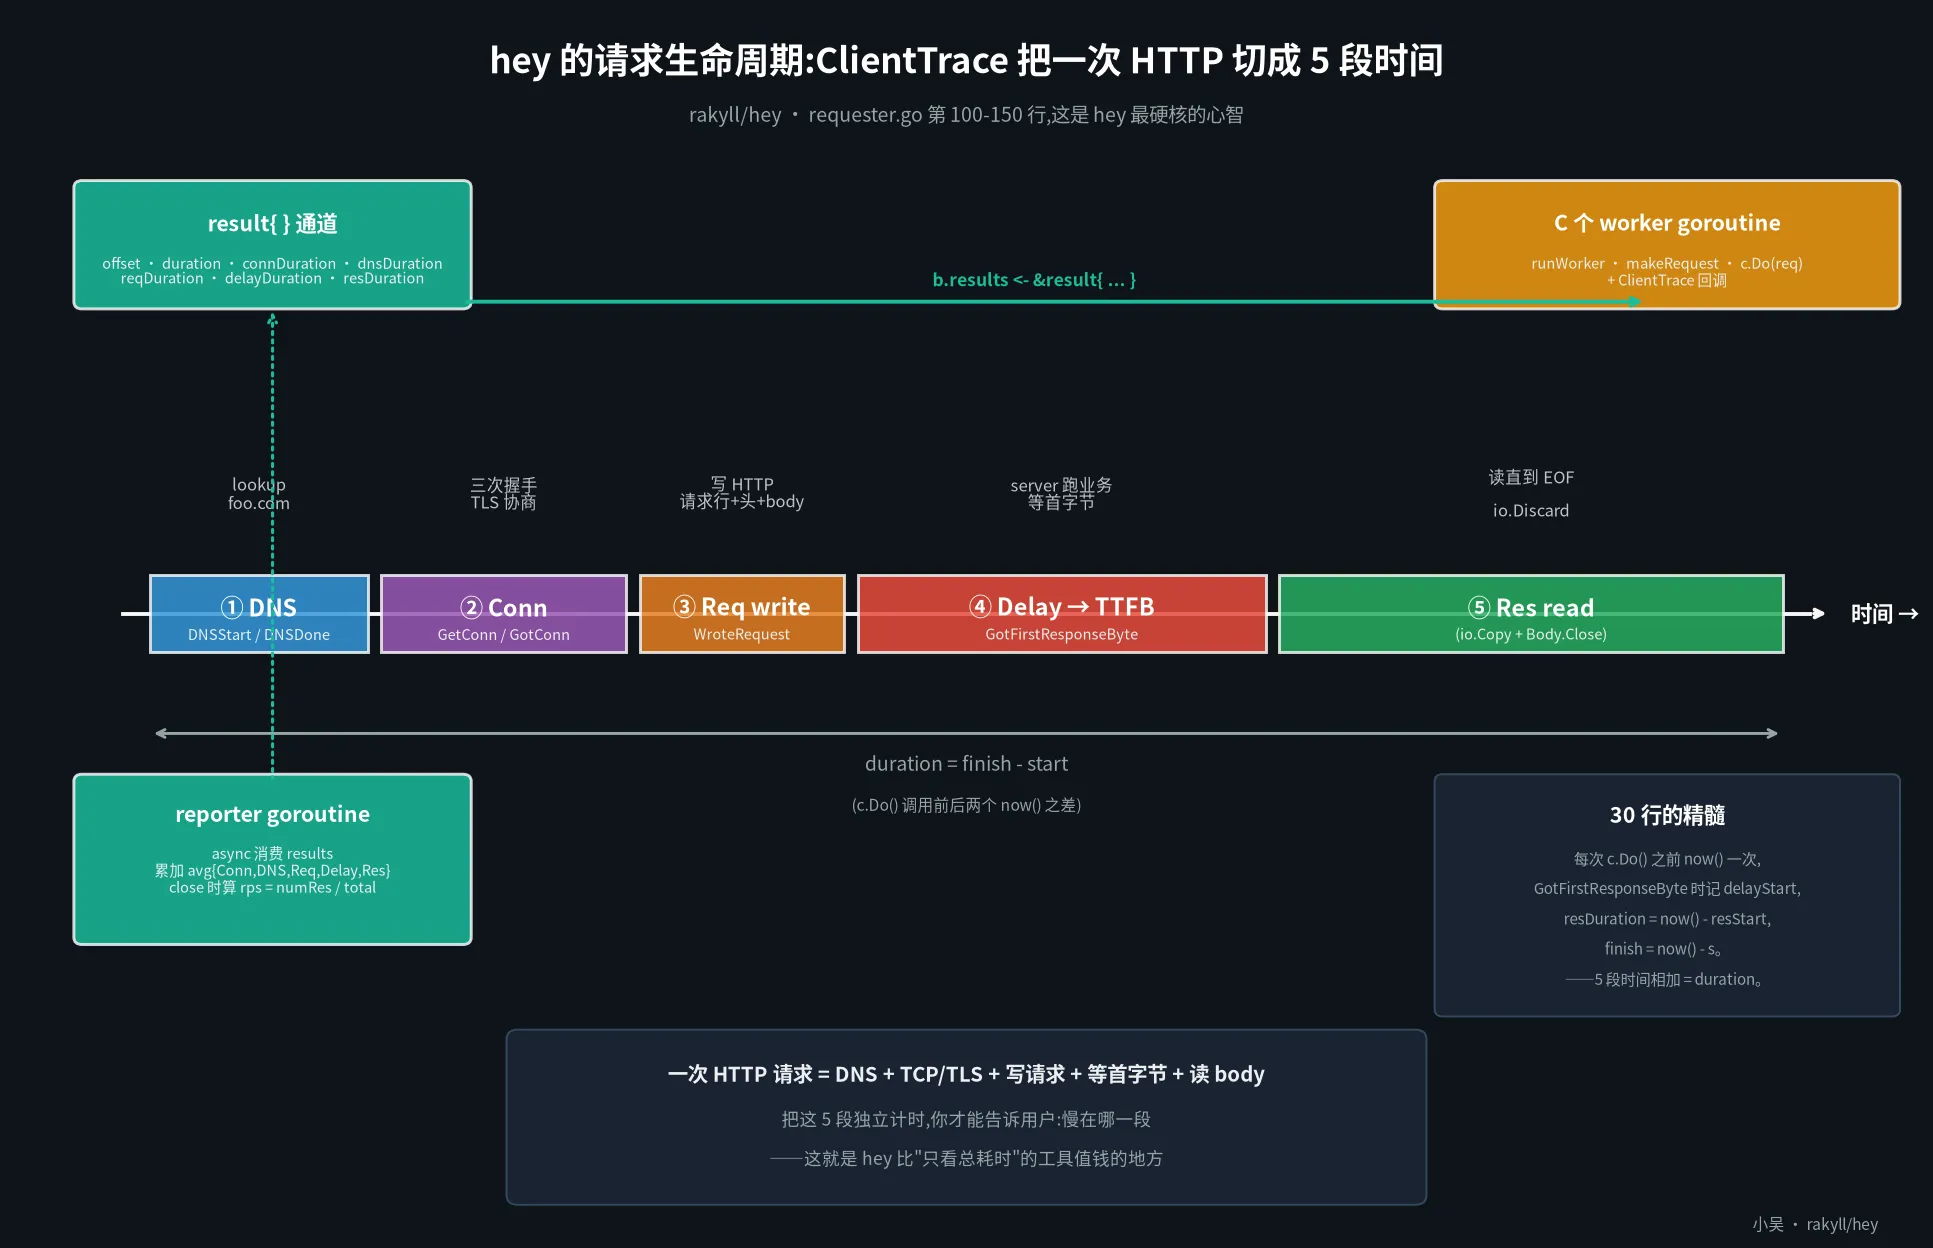
这张图把 hey 的整个价值主张讲清楚了:别只看总耗时,要分阶段看。
4.1 ClientTrace 是什么#
httptrace.ClientTrace 是 Go 标准库里一个被严重低估的 API。它让你在 HTTP 请求的内部里程碑事件上注册回调,例如:
DNSStart/DNSDone— DNS 解析开始/结束GetConn/GotConn— 开始获取/成功拿到连接WroteRequest— HTTP 请求体写完GotFirstResponseByte— 收到响应的第一个字节(TTFB)ConnectStart/ConnectDone— TCP 握手TLSHandshakeStart/TLSHandshakeDone— TLS 握手
每次 c.Do(req) 之前用 req.WithContext(httptrace.WithClientTrace(req.Context(), trace)) 把 trace 绑上去,Go 就会在内部自动调用这些回调。
hey 用这个 API 做了 5 段时间切分:
trace := &httptrace.ClientTrace{
    DNSStart: func(info httptrace.DNSStartInfo) {
        dnsStart = now()
    },
    DNSDone: func(dnsInfo httptrace.DNSDoneInfo) {
        dnsDuration = now() - dnsStart
    },
    GetConn: func(h string) {
        connStart = now()
    },
    GotConn: func(connInfo httptrace.GotConnInfo) {
        if !connInfo.Reused {
            connDuration = now() - connStart
        }
        reqStart = now()
    },
    WroteRequest: func(w httptrace.WroteRequestInfo) {
        reqDuration = now() - reqStart
        delayStart = now()
    },
    GotFirstResponseByte: func() {
        delayDuration = now() - delayStart
        resStart = now()
    },
}每个回调里都只做一件事:记一个时间戳。然后在 c.Do(req) 之后,所有 5 段时间自然就拿到了:
resp, err := c.Do(req)
if err == nil {
    size = resp.ContentLength
    code = resp.StatusCode
    io.Copy(io.Discard, resp.Body)   // 关键:把 body 读完
    resp.Body.Close()
}
t := now()
resDuration = t - resStart
finish := t - s // ← 总耗时注意两个工程细节:
GotConn里的!connInfo.Reused——连接复用时,Dial 时间不算 connDuration。这是正确的:如果走连接池,就不应该把 TCP 握手算到这次请求头上。io.Copy(io.Discard, resp.Body)——必须把响应 body 读完,才能算 resDuration。否则resDuration永远是 0。这也意味着 hey 的统计是”端到端”延迟,包括 body 下载时间。如果你只关心 TTFB,得自己改。
4.2 result{ }:把 5 段时间打包投递#
b.results <- &result{
    offset:        s,
    statusCode:    code,
    duration:      finish,
    err:           err,
    contentLength: size,
    connDuration:  connDuration,
    dnsDuration:   dnsDuration,
    reqDuration:   reqDuration,
    resDuration:   resDuration,
    delayDuration: delayDuration,
}result 是一个 7 个字段的结构体,推给 results 通道后,reporter 会异步消费、累加到 5 个平均值 + 收集到 lats 数组供后续排序算百分位。
这是 hey 整个架构里最重要的解耦点——worker 不做任何统计,只负责”测”和”投递”。reporter 不做任何 HTTP 请求,只负责”统计”和”展示”。这条解耦让 worker 可以全力打请求,而 reporter 永远不会拖慢 worker。
五、reporter:异步统计的艺术#
report.go 里 reporter 的实现是经典的 Go 异步累加器:
func runReporter(r *report) {
    // Loop will continue until channel is closed
    for res := range r.results {
        r.numRes++
        if res.err != nil {
            r.errorDist[res.err.Error()]++
        } else {
            r.avgTotal += res.duration.Seconds()
            r.avgConn += res.connDuration.Seconds()
            r.avgDelay += res.delayDuration.Seconds()
            r.avgDNS += res.dnsDuration.Seconds()
            r.avgReq += res.reqDuration.Seconds()
            r.avgRes += res.resDuration.Seconds()
            if len(r.resLats) < maxRes {
                r.lats = append(r.lats, res.duration.Seconds())
                r.connLats = append(r.connLats, res.connDuration.Seconds())
                r.dnsLats = append(r.dnsLats, res.dnsDuration.Seconds())
                r.reqLats = append(r.reqLats, reqDuration.Seconds())
                r.delayLats = append(r.delayLats, res.delayDuration.Seconds())
                r.resLats = append(r.resLats, res.resDuration.Seconds())
                r.statusCodes = append(r.statusCodes, res.statusCode)
                r.offsets = append(r.offsets, res.offset.Seconds())
            }
            if res.contentLength > 0 {
                r.sizeTotal += res.contentLength
            }
        }
    }
    // Signal reporter is done.
    r.done <- true
}注意两点工程设计:
- 只保留 1M 个延迟样本——
if len(r.resLats) < maxRes这条判断保护了内存。你跑了 1000 万次请求,reporter 也只保留前 100 万个延迟样本。剩下的请求只算平均值,不进数组。这是有损统计——但对直方图和百分位来说,1M 个样本远远够用。 - 错误和成功分开——
res.err != nil的请求只进errorDist,不参与延迟统计。这是必须的:失败的请求不应该污染成功请求的延迟数据。很多烂工具没做这一步,导致 50% 失败的压测里”平均延迟”完全没意义。
5.1 finalize:把所有原始数据变成报告#
func (r *report) finalize(total time.Duration) {
    r.total = total
    r.rps = float64(r.numRes) / r.total.Seconds()  // ← rps = numRes / total
    r.average = r.avgTotal / float64(len(r.lats))
    r.avgConn = r.avgConn / float64(len(r.lats))
    r.avgDelay = r.avgDelay / float64(len(r.lats))
    r.avgDNS = r.avgDNS / float64(len(r.lats))
    r.avgReq = r.avgReq / float64(len(r.lats))
    r.avgRes = r.avgRes / float64(len(r.lats))
    r.print()
}rps = numRes / total 是整个 hey 的输出里最硬的一个数。
这里的 total 是从 Work.Init() 那一刻到所有 worker 退出的真实墙钟时间,而不是 -n 200 这种”理论总时间”。这意味着如果你的目标服务慢,你的 qps 自然就低——不用做任何额外计算。
5.2 百分位和直方图#
finalize() 之后,snapshot() 把 lats 数组 sort 一遍,然后算 7 个百分位和 10 个直方图桶:
func (r *report) latencies() []LatencyDistribution {
    pctls := []int{10, 25, 50, 75, 90, 95, 99}
    data := make([]float64, len(pctls))
    j := 0
    for i := 0; i < len(r.lats) && j < len(pctls); i++ {
        current := i * 100 / len(r.lats)
        if current >= pctls[j] {
            data[j] = r.lats[i]
            j++
        }
    }
    // ...
}这是朴素百分位算法——r.lats 已经 sort 好,直接按索引取。p99 就是 lats[len*99/100],p95 就是 lats[len*95/100]。对 1M 个样本来说,p99 的精度 ±0.01%,完全够用。
直方图更朴素——把 [fastest, slowest] 平均分成 10 个桶,每个桶统计落进去的样本数。然后用 ■ 字符渲染:
res.WriteString(fmt.Sprintf("  %4.3f [%v]\t|%v\n",
    buckets[i].Mark, buckets[i].Count,
strings.Repeat(barChar, barLen)))barLen = (buckets[i].Count*40 + max/2) / max——把桶里的样本数归一化到 0-40 字符宽,画出一根横向柱状图。这是终端直方图最简的渲染方式,效果出奇地好。
六、输出:text/template 撑起漂亮 CLI 报表#
print.go 是 hey 输出格式的全部定义。它用 Go 标准库的 text/template 渲染,把 report 结构体里的数据填进模板:
var defaultTmpl = `
Summary:
  Total:	{{ formatNumber .Total.Seconds }} secs
  Slowest:	{{ formatNumber .Slowest }} secs
  Fastest:	{{ formatNumber .Fastest }} secs
  Average:	{{ formatNumber .Average }} secs
  Requests/sec:	{{ formatNumber .Rps }}
  {{ if gt .SizeTotal 0 }}
  Total data:	{{ .SizeTotal }} bytes
  Size/request:	{{ .SizeReq }} bytes{{ end }}

Response time histogram:
{{ histogram .Histogram }}

Latency distribution:{{ range .LatencyDistribution }}
  {{ .Percentage }}%% in {{ formatNumber .Latency }} secs{{ end }}

Details (average, fastest, slowest):
  DNS+dialup:	{{ formatNumber .AvgConn }} secs, {{ formatNumber .ConnMax }} secs, {{ formatNumber .ConnMin }} secs
  DNS-lookup:	{{ formatNumber .AvgDNS }} secs, {{ formatNumber .DnsMax }} secs, {{ formatNumber .DnsMin }} secs
  req write:	{{ formatNumber .AvgReq }} secs, {{ formatNumber .ReqMax }} secs, {{ formatNumber .ReqMin }} secs
  resp wait:	{{ formatNumber .AvgDelay }} secs, {{ formatNumber .DelayMax }} secs, {{ formatNumber .DelayMin }} secs
  resp read:	{{ formatNumber .AvgRes }} secs, {{ formatNumber .ResMax }} secs, {{ formatNumber .ResMin }} secs

Status code distribution:{{ range $code, $num := .StatusCodeDist }}
  [{{ $code }}]	{{ $num }} responses{{ end }}

{{ if gt (len .ErrorDist) 0 }}Error distribution:{{ range $err, $num := .ErrorDist }}
  [{{ $num }}]	{{ $err }}{{ end }}{{ end }}
`几个有意思的细节:
formatNumber是自定义的 FuncMap——text/template允许注册自定义函数,这里formatNumber把浮点数格式化成 4 位小数。histogram函数在模板里被调用——这不常见!通常直方图是预渲染字符串,hey 是在模板里直接调用函数生成柱状图。- CSV 模式是单独的模板——
csvTmpl把每次请求的 8 列展开成一长串 CSV 行,适合后续用 pandas / awk 二次分析。 -o csv之外的格式——README 说 “csv is the only supported alternative”,但代码里的switch只判断""和"csv"。任何不是 csv 的输出参数都会被当成「默认模板」——也就是说hey -o json输出的其实是默认 summary,不是 JSON。这是文档和实现的小不一致。
实测输出长这样:
Summary:
  Total:	0.1234 secs
  Slowest:	0.0450 secs
  Fastest:	0.0012 secs
  Average:	0.0123 secs
  Requests/sec:	16207.45

Response time histogram:
  0.001 [512]	|■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■
  0.005 [301]	|■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■
  0.010 [112]	|■■■■■■■■■■■■■
  ...

Latency distribution:
  10% in 0.0023 secs
  25% in 0.0045 secs
  50% in 0.0089 secs
  75% in 0.0156 secs
  90% in 0.0234 secs
  95% in 0.0301 secs
  99% in 0.0412 secs

Details (average, fastest, slowest):
  DNS+dialup:	0.0001 secs, 0.0001 secs, 0.0000 secs
  DNS-lookup:	0.0000 secs, 0.0000 secs, 0.0000 secs
  req write:	0.0001 secs, 0.0002 secs, 0.0000 secs
  resp wait:	0.0112 secs, 0.0345 secs, 0.0012 secs
  resp read:	0.0001 secs, 0.0002 secs, 0.0000 secs

Status code distribution:
[200] 2000 responses注意两件事:
resp wait这一项几乎总是远大于其他 4 段——这代表「服务端处理时间」。如果resp wait占比 80% 以上,说明瓶颈在服务端,而不是网络。如果DNS+dialup占比 50%+,说明你的测试环境 DNS 或者 TLS 握手有问题,而不是被测服务。
七、横向对比:hey 和其他 HTTP 压测工具的差异#
读完源码,我把 hey 和 wrk / vegeta / ab / k6 做了横向比较:
| 工具 | 语言 | 并发模型 | 输出 | 适合场景 |
|---|---|---|---|---|
| hey | Go | goroutine + channel | 文本 + csv | 极简、快速、CI/CD 内嵌 |
| wrk | C + Lua | epoll + 协程 | 文本 + Lua 扩展 | 超高 QPS、复杂 Lua 脚本 |
| vegeta | Go | goroutine + library | text + json + histogram (多协议兼容) | 多协议(gRPC / HTTP / DNS)+ socket |
| ab (Apache Bench) | C | 进程/线程 | 文本 | 老牌、HTTP/1.1 only |
| k6 | Go + JS | goroutine + JS test | JSON + Prometheus | 复杂场景脚本 + 集成测试 |
hey 的定位非常清楚:用 1000 行 Go 写出 80% 用户需要的 80% 功能。它不追求 wrk 那种百万 QPS 极限压测,也不追求 k6 那种脚本化集成测试,它只做一件事——让你一行命令看到「你的服务能扛多少 QPS,延迟多少」。
我在工程上对这几个工具的使用习惯:
| 场景 | 工具 |
|---|---|
快速 smoke test(hey -c 50 -n 1000 url) | hey |
| 跑极限 QPS(单机 100k+) | wrk |
| 多协议或长时压测 | vegeta |
| 集成测试 / CI 流水线 | k6 |
| 调老 service / 排错 | hey(-o csv 输出(写脚本分析)+ |
hey 最大的优势是零依赖、零配置——go install github.com/rakyll/hey@latest 一行就能装,跑出来的结果立刻可读。这对压测场景的「快速反馈」诉求是最关键的。
八、读 hey 源码学到的 5 件事#
这 1100 行代码里有几条工程经验是我读完特别想记下来的:
8.1 用 channel cap 平衡吞吐和内存#
results = make(chan *result, min(b.C*1000, 1000000))——这是 Go 并发设计的经典 case。通道容量太小,worker 会因为 sroom 是空而阻塞,整个系统慢;太大,内存浪费。hey 的选择是 1000 × C(给 worker 一定堆积空间,允许 reporter 慢一点时 worker 不被卡),上限 1000000(防止内存爆炸)。
8.2 用 close 作为退出信号#
for res := range r.results 退出条件是通道被 close。Finish() 里 close(b.results) 之后,reporter 自然退出,主 goroutine 才会调 <-b.report.done 等 reporter 真正完成。这是 Go 里 single-flight 模式的精髓——不需要额外的退出信号,close 就是「所有人都干完了」的语义。
8.3 httptrace.ClientTrace 是被低估的标准库#
大多数 Go 项目做 HTTP 监控时,只会算总耗时(time.Since(start))。hey 用 httptrace.ClientTrace 把一次请求切成 5 段,告诉你「慢在哪一段」。这个 API 应该成为所有 Go HTTP 监控项目的标配——写一个中间件只需 30 行,就能给所有 HTTP 调用加 5 段时间切分。
8.4 共享 http.Client 的连接池是关键#
MaxIdleConnsPerHost: min(b.C, 500) 是 hey 的性能根基。如果你的 -c 100,hey 会让 100 个 worker 共享一个有 100 条空闲连接的连接池——TCP 握手只在第一次建立,后续请求全部复用。这是为什么 hey 不需要每次请求都新建 TCP 连接。
8.5 有损统计是合理的#
hey 只保留 1M 个延迟样本(if len(r.resLats) < maxRes)。超过 1M 的请求只算平均值,不进数组。这是非常正确的工程取舍——1M 个样本对直方图和百分位来说完全够用,不需要把所有 1000 万次请求的延迟都存下来。
九、可复用方法论:读 Go 工具源码的正确姿势#
读完 hey,我把自己用的方法论总结成下面 4 步,适用于所有”小而精”的 Go 工具源码:
go.mod看依赖——hey 的go.mod只有一行golang.org/x/net/http2,这立刻告诉我 “HTTP/2 是显式支持的,其他能力全靠标准库”。- 从
main()一路读到底——hey.go的main()只有 ~80 行,读完你就知道所有 flag 怎么解析、Work 结构体怎么填、Run 怎么启动。 - 抓住”数据流”——hey 的数据流是
flag → Work → results channel → reporter → print,3 个 goroutine + 1 个 channel。读完 main 后,顺数据流找每个 goroutine 的入口,就能拼出整个并发拓扑。 - 找「最硬的一段代码」——hey 最硬的是
httptrace.ClientTrace那 30 行。Go 工具的核心设计往往就藏在这种「30 行」的标准库 API 调用里,而不是大段的业务逻辑。
这套方法论也适用于读 vegeta(数据流:attack → rate limiter → workers → metrics)、读 groupcache(数据流:consistent hash → peer picker → RPC → single-flight)。
十、写在最后#
rakyll/hey 不是一个”完美”的工具——它没有复杂的协议支持,没有脚本能力,没有 Prometheus 集成。但它做对了一件事:把”HTTP 压测”这件事拆到不能再拆,然后用 Go 标准库最少的 API 把这些碎片拼成一个。
这种精神让我想起项目原作者 Jaana B. Dogan(JBD)在项目里的代码风格——没有一行废话,每个变量都直指核心,每个 goroutine 都有清晰职责。读到 7159 字节的 hey.go 末尾时,你会发现整个文件的最后一个非空操作是 w.Run(),然后就是错误处理函数。它就是这么克制。
最后回答一个事实问题——hey 之所以叫 hey 而不是 boom,是因为 boom 是 Tarek Ziade 早先发布的同名工具,rakyll 重命名是为了避免冲突。这个八卦我在拆 boom.go 文档时看到的,觉得挺有意思。
参考与引文#
本文涉及的所有引用都来自 rakyll/hey 仓库本身,以下是我精读过的核心文件:
hey.go(199 行)—— 命令行入口 + flag 解析 + 构造 Workrequester/requester.go(274 行)—— 并发负载生成 + ClientTrace 5 段时间切分requester/report.go(323 行)—— 数据结构 + 累加器 + finalize + percentile + histogramrequester/print.go(128 行)—— text/template 输出模板 + 直方图渲染requester/now_other.go/now_windows.go—— 跨平台时钟抽象README.md—— 命令行文档 + 使用示例
仓库地址:github.com/rakyll/hey ↗ 原作者授权 go-chaome/go authors(Jaana B. Dogan,JBD) Fork 起点授权 markokocic/boom,继承授权 Apache License 2.0
关于配图:本文两张图都是用 matplotlib 重新画的——
img1-request-lifecycle.png是 hey 的请求生命周期链路图,展示 ClientTrace 怎么把一次 HTTP 切成 5 段时间;img2-concurrency.png是并发拓扑链路图,展示 C 个 worker + 1 个 reporter + 1 个共享 client 怎么协作。原仓库 README 里只配了一张 hey 的运行截图,我重画两张图是为了把”5 段时间切分”和”C 个 worker + 1 个 reporter”的两个心智核心更清楚地讲出来。