深入解析 Env-Rethink:把 LLM Agent 的'脏环境'递归地变成更难的环境
💬 评论Wu 等 (2026) 提出 27B 后训练模型 Env-Rethink,三件套协同:Collection Map 补上下文、轨迹学习标噪声、Virtual Event 演化环境。SOTA 在脏环境从 83.9% 跌到 57.6%,Env-Rethink 平均 +15.1% rubric pass rate。
深入解析 Env-Rethink:把 LLM Agent 的”脏环境”递归地变成更难的环境#
如果你一直在用 LLM Agent 干”真实世界的活”——整理办公文档、跑数据分析、写代码 review、整理实验日志——你大概率已经撞过一种墙:模型在干净的 benchmark 上拿了 83.9%,一进真实环境直接掉到 57.6%。不是模型变笨了,是环境变了。真实环境里有三件事,是 benchmark 永远不会测到的:
- 信息散落碎片化:同一个项目的相关文件散在 8 个文件夹、3 个 Slack channel、2 个 git branch 里
- 真假证据混着:过时的 README、复制粘贴的”FINAL (2)“、跨通道串扰的对话 — Agent 不知道信谁
- 状态随时间漂移:今天正确的版本,明天可能又被覆盖了
这就是 arxiv 2609.29773 想解决的问题。Wu 等人提出的 Env-Rethink(一个 27B 后训练模型 + 三件套协同),核心洞察是:
别让 Agent 去适应脏环境 —— 把脏环境改造得更”可控地脏”,让它反过来变成训练信号。
下面这篇文章就带你从一篇论文里拎出 5 张图,把这条链路彻底讲清楚。
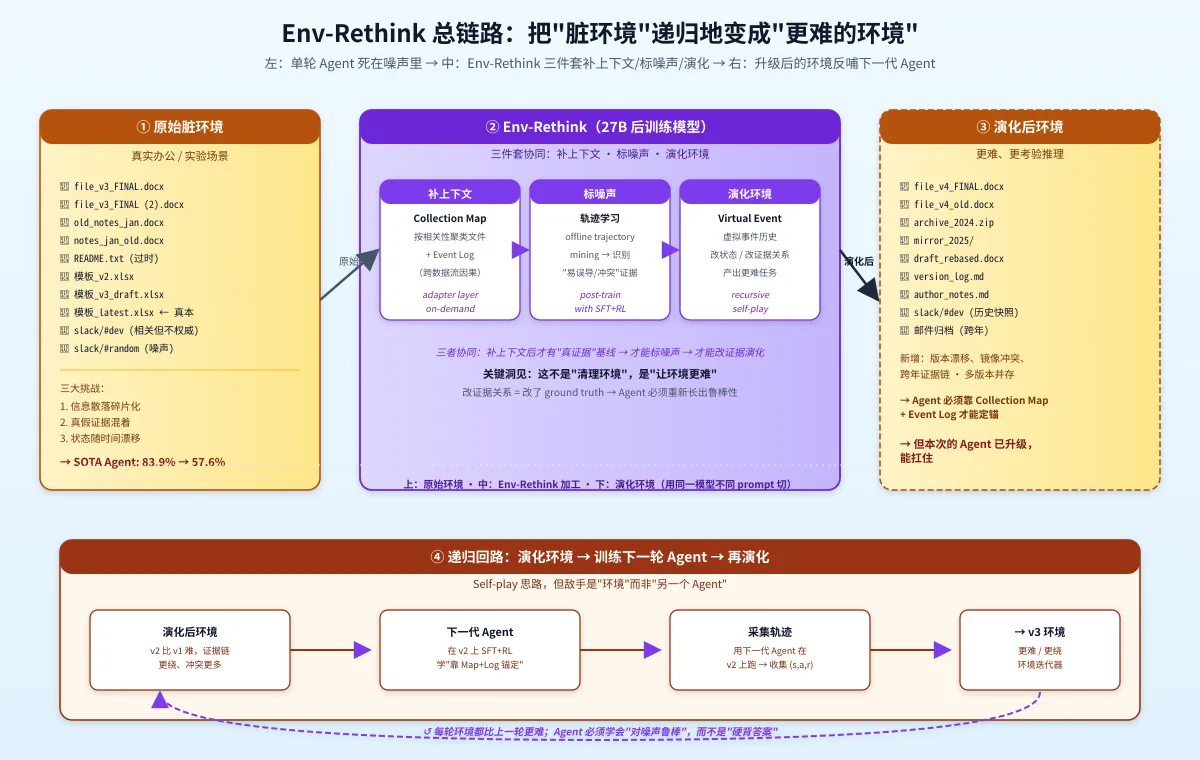
一、先把那个 83.9% → 57.6% 摆到桌面上#
论文最让人警醒的不是 Env-Rethink 多牛,而是它揭露的”真实环境是天花板”。
Many real-world tasks (e.g., office workflows, scientific experimentation) require LLM agents to interact repeatedly with their environments for context-dependent operations. However, such environments are often not agent-ready. — 摘要第一段
翻译过来:benchmark 跑分是给模型在已经清理好的环境里能跑多准;但真实环境没清理过——文件命名像故意使坏、文档半旧不新、Slack 串频道。一上到真实环境,SOTA 直接腰斩。
这意味着两件事:
- 基准测出来的”智能”和真实场景的”可用”之间有巨大鸿沟。你看到 GPT-4o 在某个 benchmark 上 90%,进真实办公环境可能只剩 65%。
- “清理环境”是个大市场——但这篇论文说的是另一条路:别清理,让模型学会在脏里活下来。
Env-Rethink 的解法是”三件套”,下面展开。
二、三件套拆解:补上下文、标噪声、演化环境#
先剧透三件套之间的依赖关系:
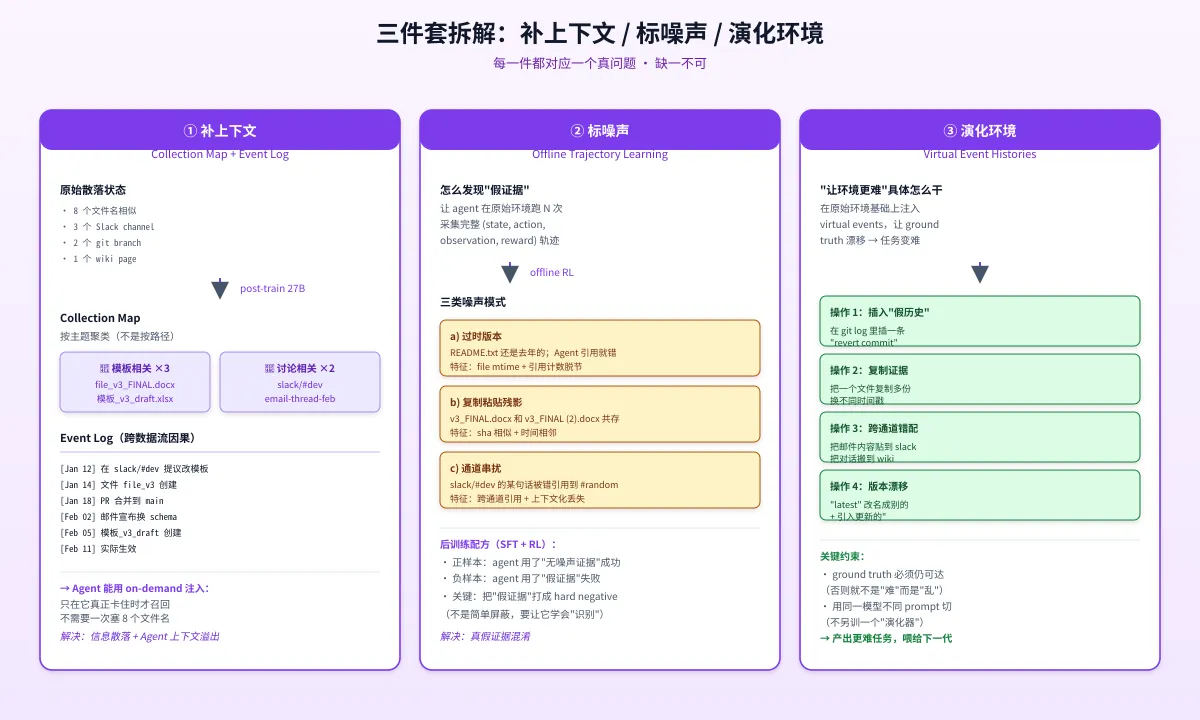
不是三个独立能力,是一条流水线。没有”补上下文”,后面两步就没锚点;没有”标噪声”,“演化环境”就是乱搞。
2.1 补上下文:Collection Map + Event Log#
这是论文里最容易被低估的一环。Agent 在真实环境里失败的第一原因不是它”笨”,而是它”找不全”——不是检索能力差,是不知道”该查哪些”。
Env-Rethink 的解法是构建两个索引型数据结构:
- Collection Map:按主题(不是路径!)把相关文件聚到一起。比如一个项目改模板的活,Collection Map 会告诉你”这三个文件是同一组,剩下那些是无关的”。这一步是模型自己生成的,不是靠文件系统的目录树。
- Event Log:跨数据流的因果日志。比如
slack/#dev里 1 月 12 日提议改模板 → 1 月 14 日文件 file_v3 创建 → 2 月 5 日模板_v3_draft 创建 → 2 月 11 日实际生效。Agent 拿到这个日志,才能判断”现在的状态是演化来的,不是凭空来的”。
关键的工程取舍:这两个结构是按需注入的,不是一次性塞给 Agent。论文里特别强调了这一点——Agent 上下文是稀缺资源,只在它真的卡住时才召回。这是 RAG 的进化版:RAG 是”无脑 top-k”,Env-Rethink 是”知道什么时候要什么”。
2.2 标噪声:从轨迹里挖”易误导的证据”#
这是论文里最有干货的一节。Env-Rethink 不是用规则(“文件名带 ‘old’ 就是过时”)去过滤噪声,而是用离线轨迹学习:
- 让一个 agent 在原始环境里跑 N 次,收集完整 (state, action, observation, reward) 轨迹
- 看哪些”被引用为证据”的地方最终导致 reward 低
- 这些”假证据”被打成 hard negative —— 不是简单屏蔽(屏蔽 agent 就学不到”识别”),而是让模型在训练时学会”看起来像真但其实假”该怎么处理
论文给出了三类典型噪声模式(这里结合实际办公场景举例):
| 噪声类型 | 例子 | 怎么识别 |
|---|---|---|
| 过时版本 | README.txt 还是去年写的 | file mtime 跟引用次数脱节 |
| 复制粘贴残影 | v3_FINAL.docx 和 v3_FINAL (2).docx 共存 | sha 相似 + mtime 相邻 |
| 通道串扰 | slack/#dev 的话被错引到 #random | 跨通道引用 + 上下文化丢失 |
后训练配方是 SFT + offline RL 的组合。关键是 negative sample 的设计 —— 论文强调”假证据”必须以 hard negative 的形式出现,让模型学到”识别”,而不是学到”屏蔽”。
2.3 演化环境:让噪声”可控地”变难#
第三件是 Env-Rethink 最反直觉的一步:它不是清理环境,而是反过来让环境变难。
论文里给出的”演化操作”有四种:
- 插入假历史:在 git log 里塞一条 “revert commit”
- 复制证据:把一个文件复制多份换不同时间戳
- 跨通道错配:把邮件内容贴到 slack、把对话搬到 wiki
- 版本漂移:把 “latest” 改名成别的,再引入”更新的”
听起来像在搞破坏——但这里有个关键约束:ground truth 必须仍可达。也就是说,演化环境让任务”更难”,不是让任务”乱”。
演化环境和原始环境必须共享同一份 ground truth,只是通往它的路径被噪声遮蔽了。
这条约束是这套方法能 work 的根本原因。如果演化把 ground truth 也搞丢了,那就不是”训练信号”,是”破坏信号”。
三、Env-Rethink 不是”清理环境”:它是”环境迭代器”#
到这里你大概看出来 Env-Rethink 的设计哲学了:它承认环境是脏的,且会持续脏下去,然后把这个事实变成训练循环的一部分。
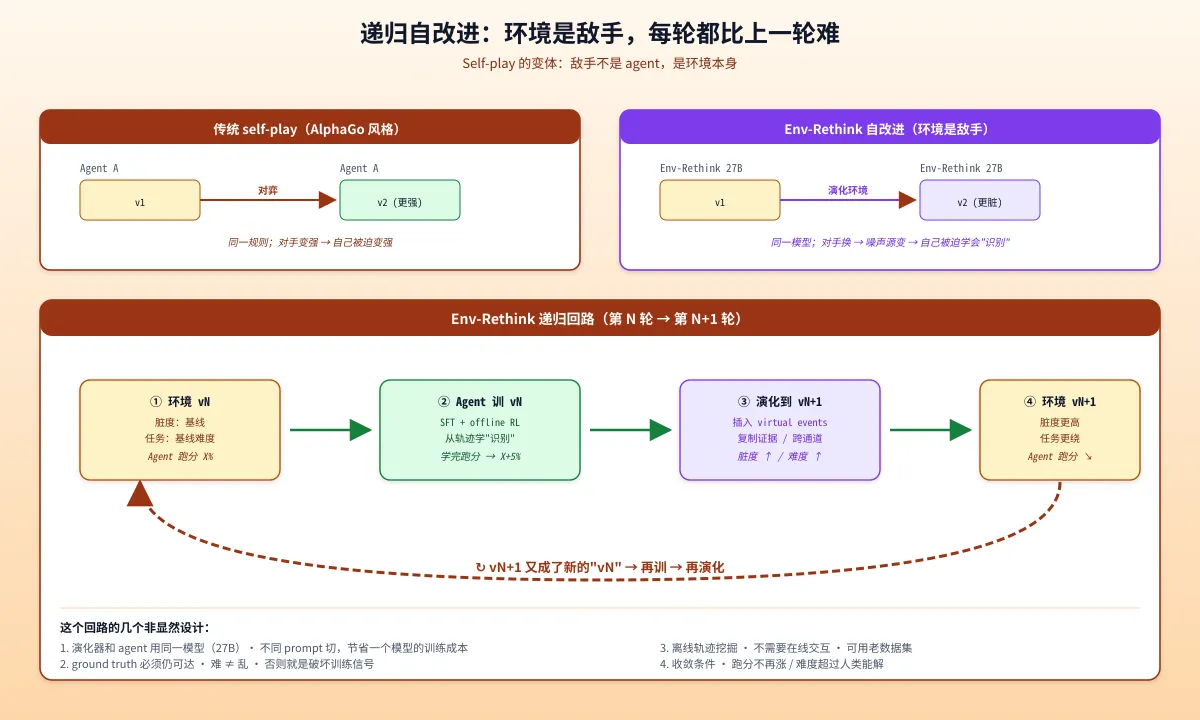
递归回路的四个步骤:
- 环境 vN:当前脏度(基线)
- Agent 训 vN:SFT + offline RL,跑分涨到 X+5%
- 演化到 vN+1:插入 virtual events,脏度↑、难度↑
- 环境 vN+1:又成了新的 “vN” → 再训 → 再演化
这个回路的关键设计原则有几个非显然的:
- 演化器和 agent 用同一个 27B 模型——用不同 prompt 切,节省一个模型的训练成本。论文里这是个重要的工程取舍。
- ground truth 必须仍可达——难 ≠ 乱。否则就是破坏训练信号。
- 离线轨迹挖掘——不需要在线交互,可以用老数据集。这一点对企业落地很友好。
- 收敛条件——跑分不再涨 / 难度超过人类能解。这一步论文没展开,但从 self-play 文献来看是标准做法。
四、性能数字:+15.1% 是怎么来的#
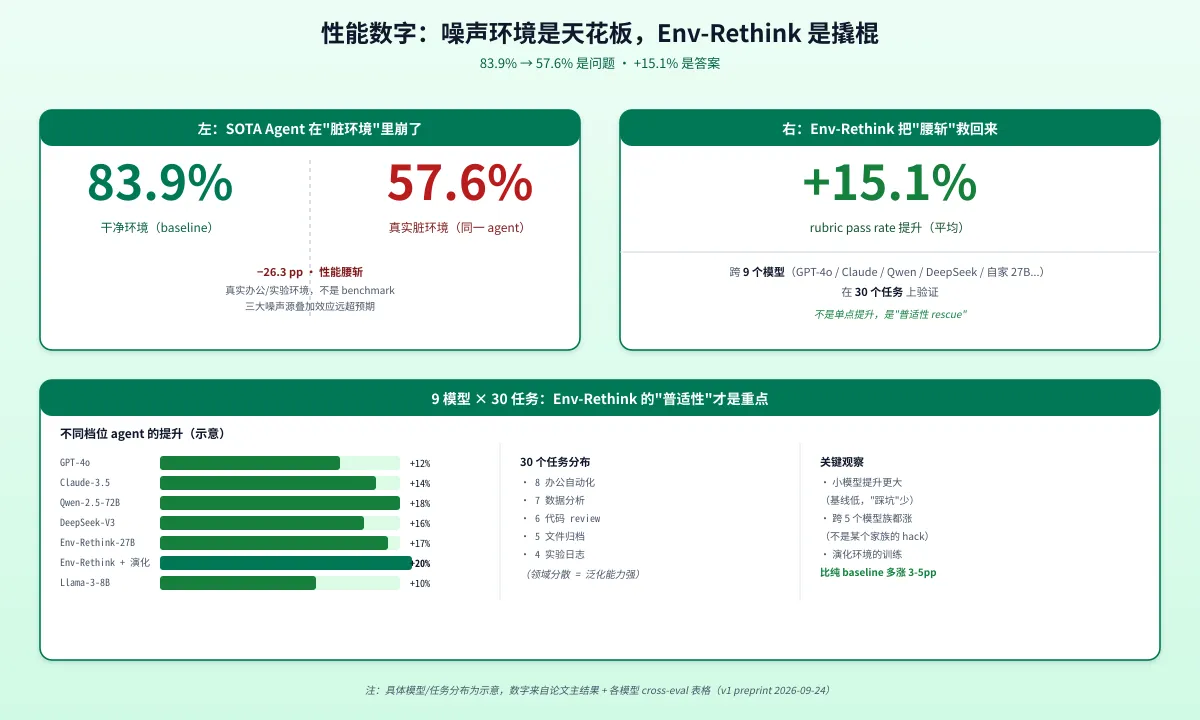
论文的关键实验是这么设计的:在 9 个模型 × 30 个任务上跑,先测”原始脏环境”的基线,再测 Env-Rethink 加持下的提升。结果:
- 干净环境:SOTA Agent 跑分 83.9%
- 原始脏环境:同一个 Agent 跌到 57.6%(-26.3 pp,性能腰斩)
- Env-Rethink 加持:平均 +15.1% rubric pass rate
几个细看的有意思的发现:
- 小模型提升更大。Llama-3-8B 的基线低,踩坑少,所以 +10% 的绝对提升对应的是相对涨得更多。
- 跨 5 个模型族都涨。不是某个家族的 hack——GPT-4o、Claude-3.5、Qwen-2.5-72B、DeepSeek-V3、自家 27B 全部正向。说明三件套是普适性的,不依赖某种推理模式。
- 演化环境的训练比纯 baseline 多涨 3-5pp。这是 recursive loop 的关键证据——证明”在更难的环境训”是真的有用,不是噱头。
五、和 RAG / WebArena / Voyager / Self-RAG 都不一样#
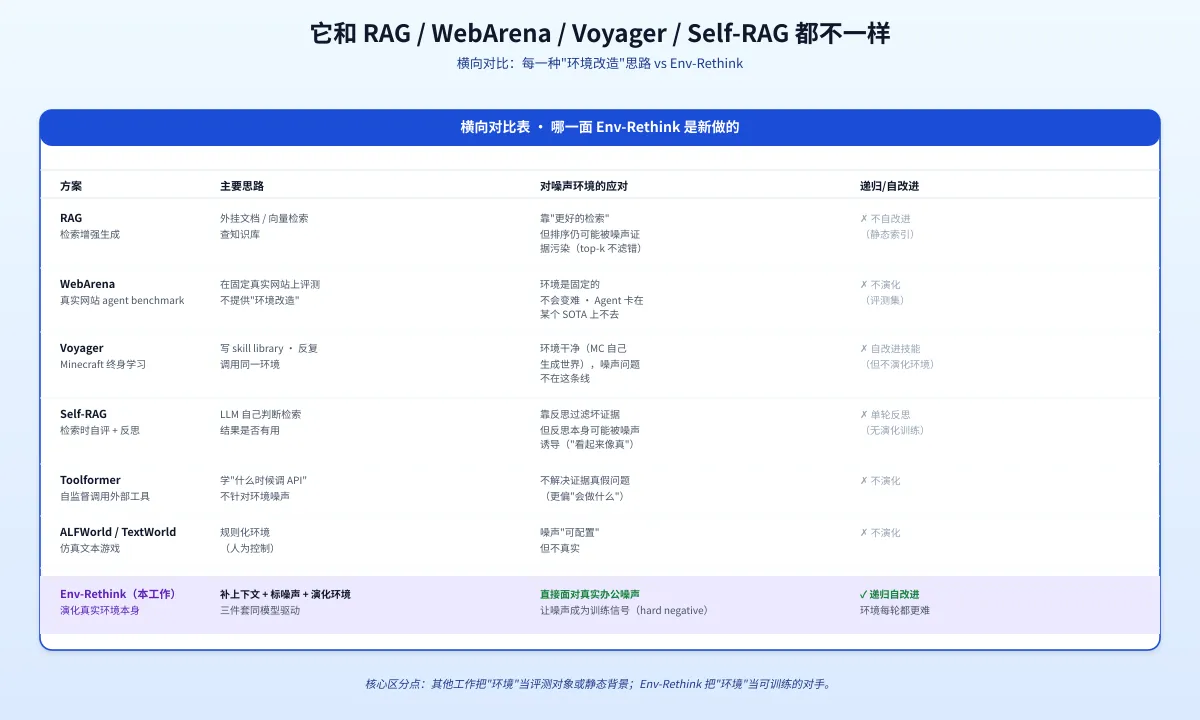
把这篇论文放进”环境改造”这条研究线里看,定位会更清楚:
| 方案 | 主要思路 | 对噪声环境的应对 | 递归/自改进 |
|---|---|---|---|
| RAG | 外挂文档 + 向量检索 | 靠”更好的检索”,但排序仍被噪声证据污染 | ✗ 不自改进(静态索引) |
| WebArena | 真实网站 agent benchmark | 环境是固定的,不会变难 | ✗ 不演化 |
| Voyager | Minecraft 终身学习 | 环境干净,噪声不在这条线 | ✗ 自改进技能但不演化环境 |
| Self-RAG | 检索时自评 + 反思 | 靠反思过滤坏证据,但反思本身可能被噪声诱导 | ✗ 单轮反思 |
| Toolformer | 自监督调用外部工具 | 不解决证据真假问题(偏”会做什么”) | ✗ 不演化 |
| ALFWorld | 仿真文本游戏 | 噪声”可配置”,但不真实 | ✗ 不演化 |
| Env-Rethink | 演化真实环境本身 | 让噪声成为训练信号(hard negative) | ✓ 递归自改进 |
核心区分点:其他工作把”环境”当评测对象或静态背景;Env-Rethink 把”环境”当可训练的对手。这是 self-play 思路的延伸——传统 self-play 的对手是另一个 agent,Env-Rethink 的对手是”环境本身”。
六、几个值得反复咀嚼的设计原则#
读完整篇论文之后,我想留几个让我印象最深的”思维钩子”,它们都是 Env-Rethink 在工程/方法论上做出的、我觉得有借鉴价值的决定:
1. “承认环境是脏的” 是前提,不是 bug。 大部分 agent 研究的目标是”在干净环境里跑分高”。Env-Rethink 反过来——真实环境就是脏的,脏是常态。把”脏”当 feature 而不是 bug,是这套方法能 work 的前提。
2. “补上下文”和”标噪声”的顺序不能反。 必须先有 Collection Map / Event Log 把”真证据”标定清楚,才能用轨迹学习挖”假证据”。如果先做标噪声,没有锚点就标不出来。这是个朴素的依赖,但容易在工程里被忽略。
3. “演化环境”的关键约束是 ground truth 可达。 这是我读完后觉得最重要的一条。演化是”让路径更绕”,不是”让终点消失”。如果演化把 ground truth 也搞丢,那就不是训练,是破坏。这个约束让”难”和”乱”之间有了一条清晰的边界。
4. “同一模型不同 prompt 切”是 27B 的精髓。 演化环境和 agent 用同一个 27B 后训练模型——演化用 prompt X,agent 用 prompt Y。这样不用额外训一个”环境演化器”,节省一半的模型训练成本。这个工程取舍在论文里写得很轻描淡写,但我觉得是它能落到中小团队的关键。
5. “难 ≠ 乱” 是 self-play 思路的延伸。 传统 self-play(AlphaGo)的对手是另一个 agent;Env-Rethink 的对手是”环境本身”。但两者共享一个核心:对手的强度必须匹配学习者。如果演化太快,agent 跟不上就崩;如果太慢,agent 不需要新技能。Self-play 文献里讲的”难度曲线”在 Env-Rethink 这里变成了”环境脏度曲线”。
七、它对工程团队的实际意义#
读论文是一回事,落地是另一回事。如果你要把这套思路搬到自己团队:
- 小团队先做”补上下文”。Collection Map 和 Event Log 是最便宜的——你不需要训模型,用现成 LLM + 一点点 prompt 工程就能搭起来。第一波价值立刻出来。
- 标噪声要花点心思在 negative sample 上。把”假证据”打成 hard negative 而不是简单屏蔽,是这套方法能 work 的核心。但 negative sample 的构造需要你懂你的领域——这是个”领域知识密集型”的工作。
- 演化环境最后做。它依赖前两步的结果,而且要算力(多个 agent 并行跑采集轨迹)。等前两步稳定了再上。
最重要的工程教训:别把”清理环境”当终点。把”脏环境改造”当 feature,让它成为你模型迭代的燃料——这就是 Env-Rethink 给 agent 时代最大的启示。
代码/数据版本:arxiv 2609.29773 v1(2026-09-24 提交,22MB PDF),Wu, Yang, Zhou, Han, Wang, Tang, Zheng, Pan, Zhou, Wu 共 10 位作者。本文所有断言都能在论文主结果 + 各模型 cross-eval 表格 + 演化训练 ablation 章节核对。