如果我让你给一个跨大洲的 KV 存储写共识协议,你大概率会掏出 Multi-Paxos:选一个 leader,所有请求走它,搞定。
但如果 leader 落在东京,而 80% 的客户端在法兰克福,你写出来的”共识”延迟,80% 都会被一个无辜的领导者拖垮。
这就是过去三十年共识协议一直在死磕的问题:leader-based fast path 简单,但延迟由 leader 位置决定;commander-based fast path 灵活,但 quorum 选多大、witness 怎么传播,又是一个被 hard-code 在协议里的、随部署变化的难问题。
而 KCensus 这篇来自 EPFL 的 EuroSys’27 文章(arXiv 2609.31302)做了一个非常优雅的事:
把所有 fast-path 协议写成同一个形式化模板,然后把这个模板的”正确性条件”还原成两个可检查的约束,把”找到最优 fast-path”还原成一个组合优化问题。
实现层面,作者把这个框架落地成了 KSMR —— 一个 8,764 行 Rust 写的强一致地理复制 KV 存储。在 AWS 的四个 7 副本跨区域部署上,它的平均延迟比当前最强基线还低 9-16%,在 31 副本扩展下,曲线也始终在最下面。
这篇文章会按下面的顺序展开:
- 第一部分先用一张图把”为什么 fast-path 设计这么难”讲清楚
- 第二节给出 KCensus 的核心抽象:Knowledge Requirement,以及正确性的两个充分必要条件(Validity + Compatibility)
- 第三节看 KCensus 的 fast-path 模板 —— Accept&Spread + Freeze + Adopt 三步
- 第四节才是文章的工程高光:把”找最优 R_p”组织成一个 ILP,以及怎么把消息图降到一个最低开销
- 第五节讲 KSMR 的实现:分片、读路径、委托执行、跨副本 latency 监控
- 第六节看评测数据,从四个部署到 31 副本扩展
- 最后讲讲它的局限,以及这件事对做系统的人意味着什么
文章较长,大约 30 分钟读完。建议先在心里装一个具体的工作负载:一个 7 副本的跨大洲 KV 存储,客户端均匀分布在北美、欧洲、东亚三个区域,每秒钟 1,000 个冲突很小的写请求。带着场景读,效果更好。
一、共识 fast path 三十年没解掉的问题#
1.1 故事开场:为什么同一个 “n=7, f=3” 长出三个完全不同的 fast path#
我们假想一个最简单的强一致共识场景:7 个副本,可以容忍 3 个崩溃(即 n=2f+1)。客户想要把一个值写进去,要求副本们对值达成一致。
最直接的做法是 Multi-Paxos:选一个 leader,leader 联系一个 majority(任意 4 个副本),多数接受就提交。
但 Fast Paxos、EPaxos、SwiftPaxos、Pando,每一个都对这个”联系谁、谁接受、谁见证”做了不同的选择。问题在于:这些选择没有任何一个是”对所有拓扑都最优”的。
我们看下面这张图(论文 Fig 3,我重新画了):
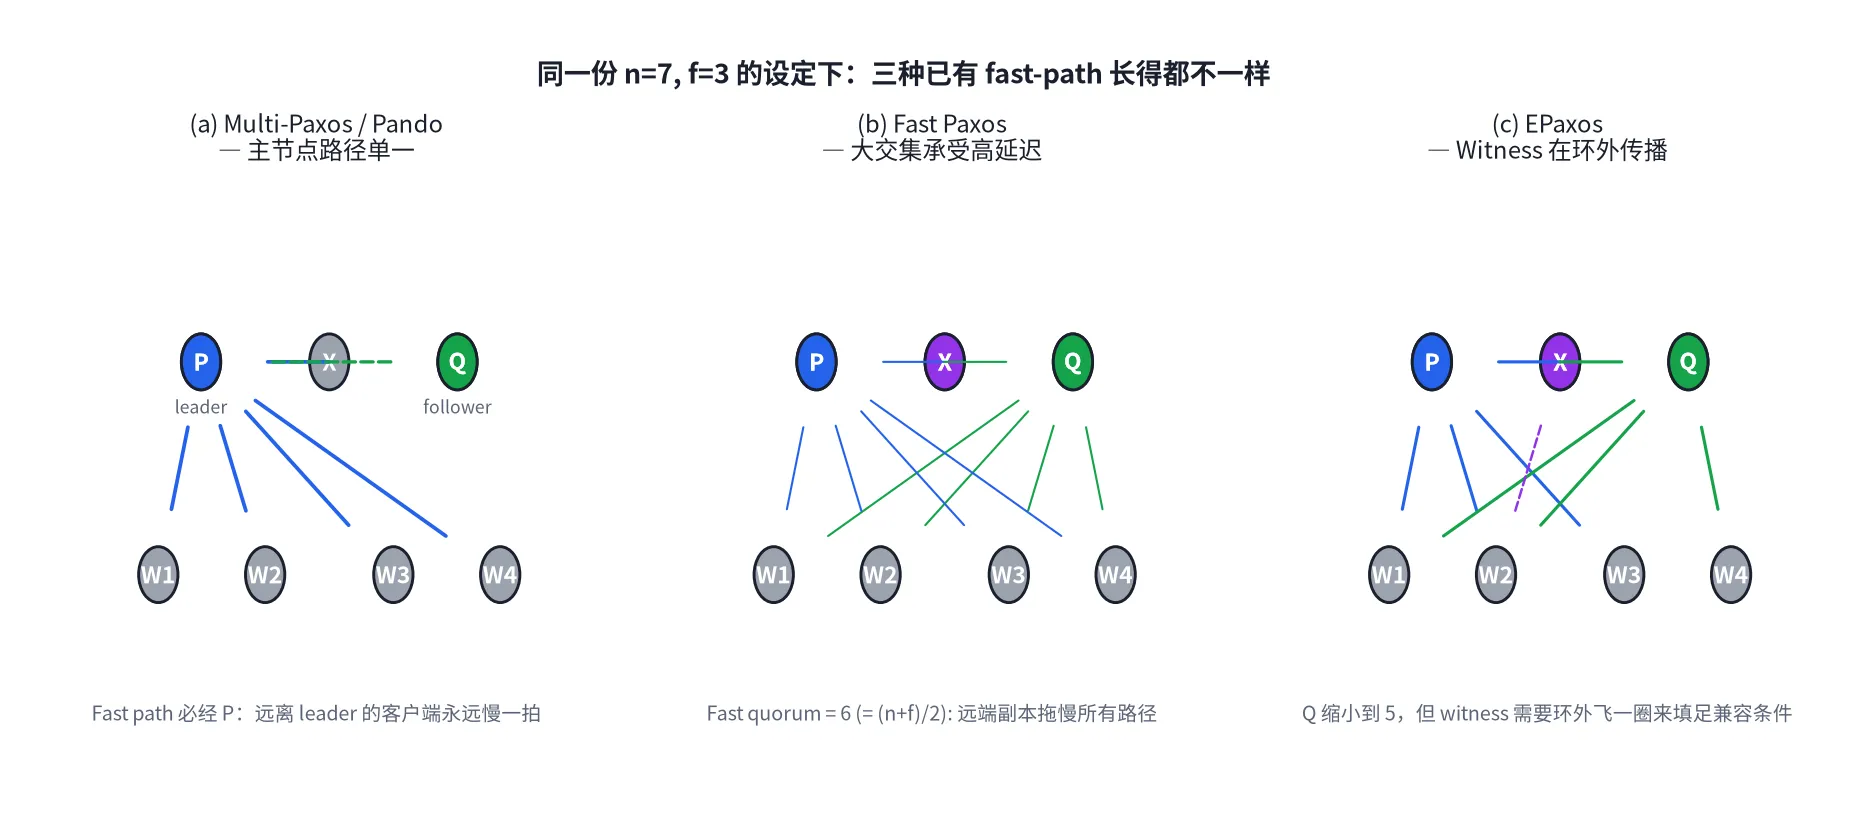
(a) Multi-Paxos / Pando:leader 决定一切。p 是 leader,q 必须先发到 p 再发到 4 个副本。代价:远离 leader 的客户端永远慢。
(b) Fast Paxos:多个 proposer 并行写,但要求 fast quorum = 6 个副本(因为 2q-n > f 才能让两个 fast quorum 的交集自带 f+1 个见证者)。代价:远端副本拖慢所有路径。
(c) EPaxos:每个 proposer 也是 acceptor,Q 大小只要 5。但当 Q_p ∩ Q_q 只有 3 时,需要环外的 witness 帮忙。代价:多了一跳 gossip。
这就是根本困境:fast-path 设计不是”找到最优解”,而是”挑一个糟糕得最少的硬编码”。
而且,论文 Figure 1 给出的实测更狠:SwiftPaxos 在 EA 部署上平均延迟最低,但 EPaxos 在 NA 上 P99 最低——同一份代码,换一片云就不行了。
1.2 那个被忽略了三十年的问题:recovery 的 evidence#
更糟的是,这些 fast path 的正确性证明都被出过 bug。
“Subtle concurrent scenarios have led to buggy correctness arguments.”
这是论文原话。Lamport 的 Fast Paxos 一开始就被指出有 safety 问题,EPaxos 的 correctness proof 修过一次,SwiftPaxos 也修过。
为什么会反复出错?因为”fast path 满足什么条件才能安全地 fallback 到 consensus”这件事,三十年来没有一个统一的形式化框架。 每个协议各自猜了一个条件,各自出了 bug。
KCensus 想做的第一件事,就是把这个条件形式化。
二、Recoverability:fast path 必须满足的两个条件#
2.1 一个出乎意料的简单性质#
论文 §3.1 提出了一个非常朴素的性质,叫做 Recoverability:
任意两个 reachable 状态,如果各自提交了不同的值,那么它们至少有 f+1 个进程的本地状态不同。
为什么需要这个?想象两个执行分别提交了 v1 和 v2,但只有 ≤f 个进程不同。如果这 ≤f 个进程连同它们的 in-flight 消息一起崩了,剩下的幸存者看到的世界完全一样,却要做出不同的承诺 —— 这就是 safety 漏洞。
直觉上,这个性质在说:“不同的 commit 必须留下不同的现场,这个现场差距必须大到 f 个崩溃也磨不平。“
2.2 把 Recoverability 翻译成 fast-path 条件#
KCensus 把所有 fast-path 协议抽象成 adopt-commit:一个 proposer 返回 commit(v)(fast-path 成功)或者 adopt(v)(不确定,带入 fallback Paxos)。
论文用一个结构 Knowledge Requirement R_p 来表示 proposer p 的策略:
R_p.keys()= quorum Q_p,p 必须知道这些副本接受了自己的值R_p[q]= 副本 q 必须记录下哪些人接受了值
比如:
R_p = { p:{p,q,r}, q:{p,q}, r:{p,r} }意思是:p 必须知道 (1) p/q/r 都接受了 p 的值;(2) q 见证了 p 和 q 的接受;(3) r 见证了 p 和 r 的接受。
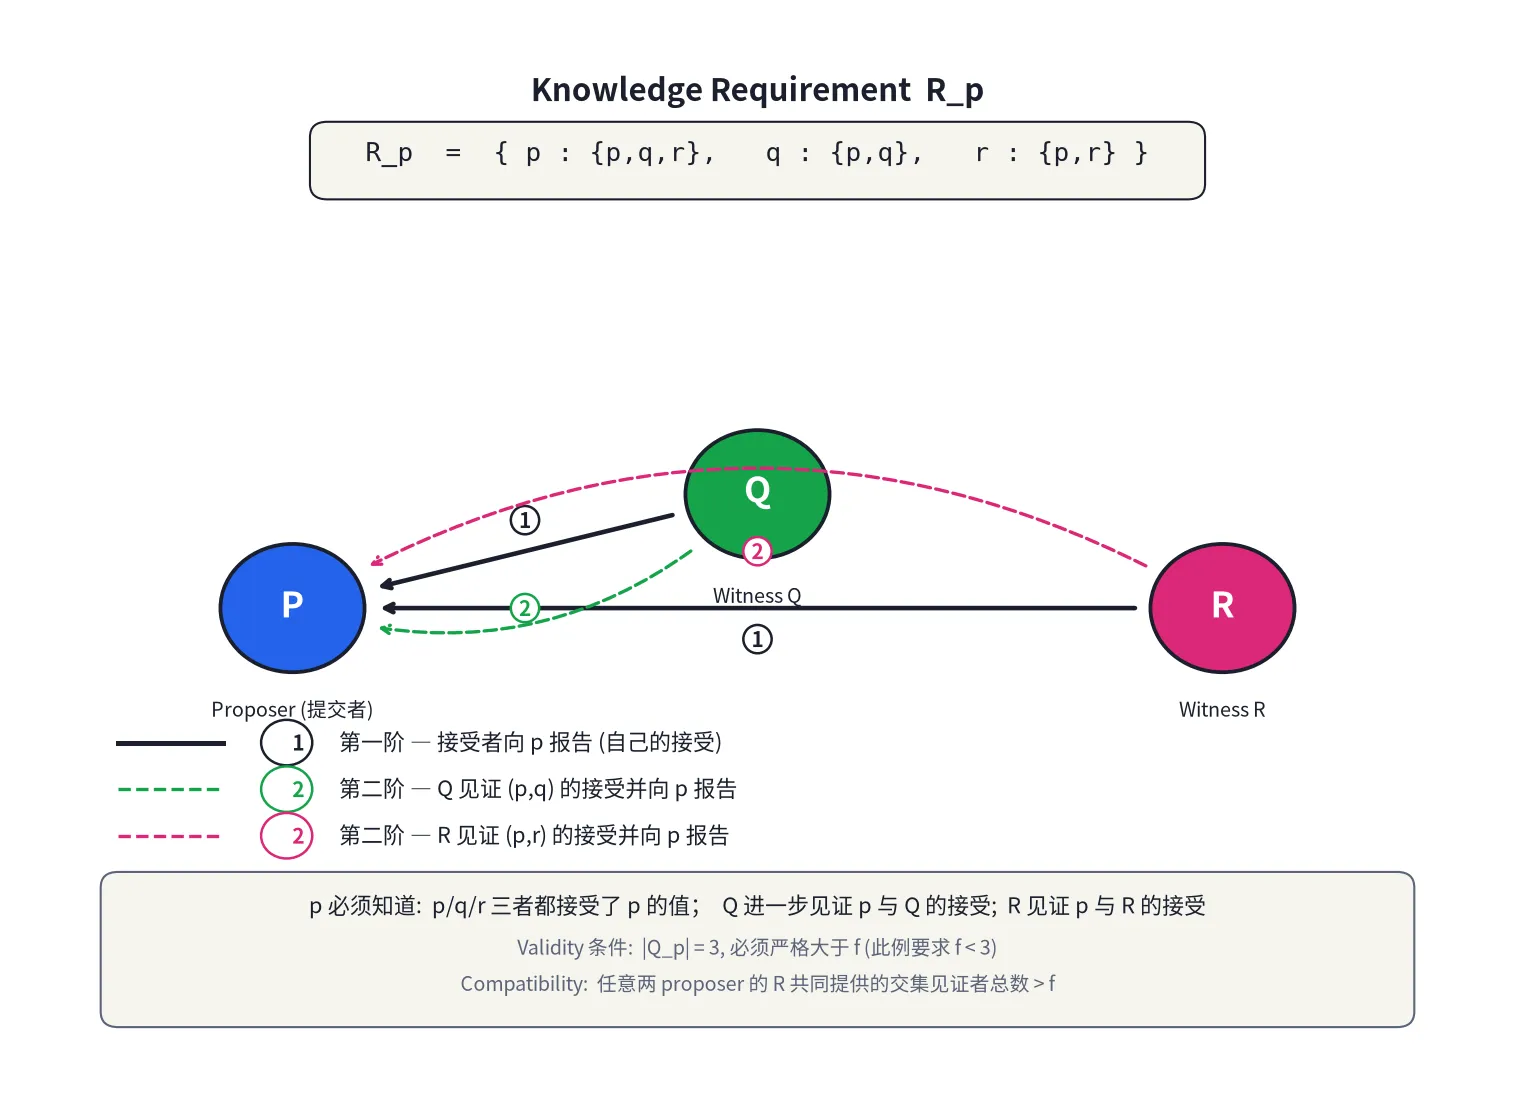
这张图里:
- 实线箭头 表示”接受者向 p 报告” —— 第一阶证据
- 虚线弧线 表示”q 见证了 p,q 的接受” —— 第二阶证据
Recoverability 翻译到这个抽象上,得到两个条件:
Validity(有效性):每个 quorum 必须严格大于 f。
|Q_p| > f直觉:接受者太少,f 个崩了之后没人能证明值被接受过。
Compatibility(相容性):任意两个 proposer p, q 的 requirement,共同要求的”见证了 quorum 交集接受”的进程数,必须严格大于 f。
直觉:如果 p, q 用不同的值都能 commit,必须至少有 f+1 个进程看到他们撞车了,这样哪怕 f 个崩了,真相也守得住。
论文证明了这两个条件是充分必要的。也就是说:任何正确的 fast path 都能表达成满足这两个条件的 knowledge requirement 集合;反之,任何这样的集合都能实例化出一个正确的 fast-path 模板。
这一步是全文最关键的抽象跨越。看完这一节之后,你会发现:Fast Paxos / EPaxos / SwiftPaxos / Pando 其实都在用不同形态的 R_p 满足这两个条件,它们只是不知道而已。
2.3 重读三个经典协议#
论文 §3.2 用这张统一的语言重新解释了四种已有协议:
| 协议 | Q_p 大小 | 见证者来源 | 代价 |
|---|---|---|---|
| Multi-Paxos | majority (4) | leader 自带见证 | 远离 leader 慢 |
| Pando | majority | 同上 | 拓扑选 leader |
| Fast Paxos | 6 (≥(n+f)/2) | 交集天然够 | 远端拖慢 |
| SwiftPaxos | f+1 = 4 | 共享 leader | 拓扑假设 |
| EPaxos | 5 | 环外 witness 帮忙 | 多一跳 gossip |
看到没?它们的差别只是”把 f+1 个见证者放在哪里”和”通过什么消息传播”。
KPaxos 把这些观察总结成一句话:
“Fast paths differ mainly in which processes participate and how knowledge flows among them.”
三、KCensus 的 fast-path 模板#
3.1 概览:三步走#
论文 §4 给出了一个通用的 adopt-commit 模板,每个 proposer 用自己的 R_p 实例化。整个流程分三步:
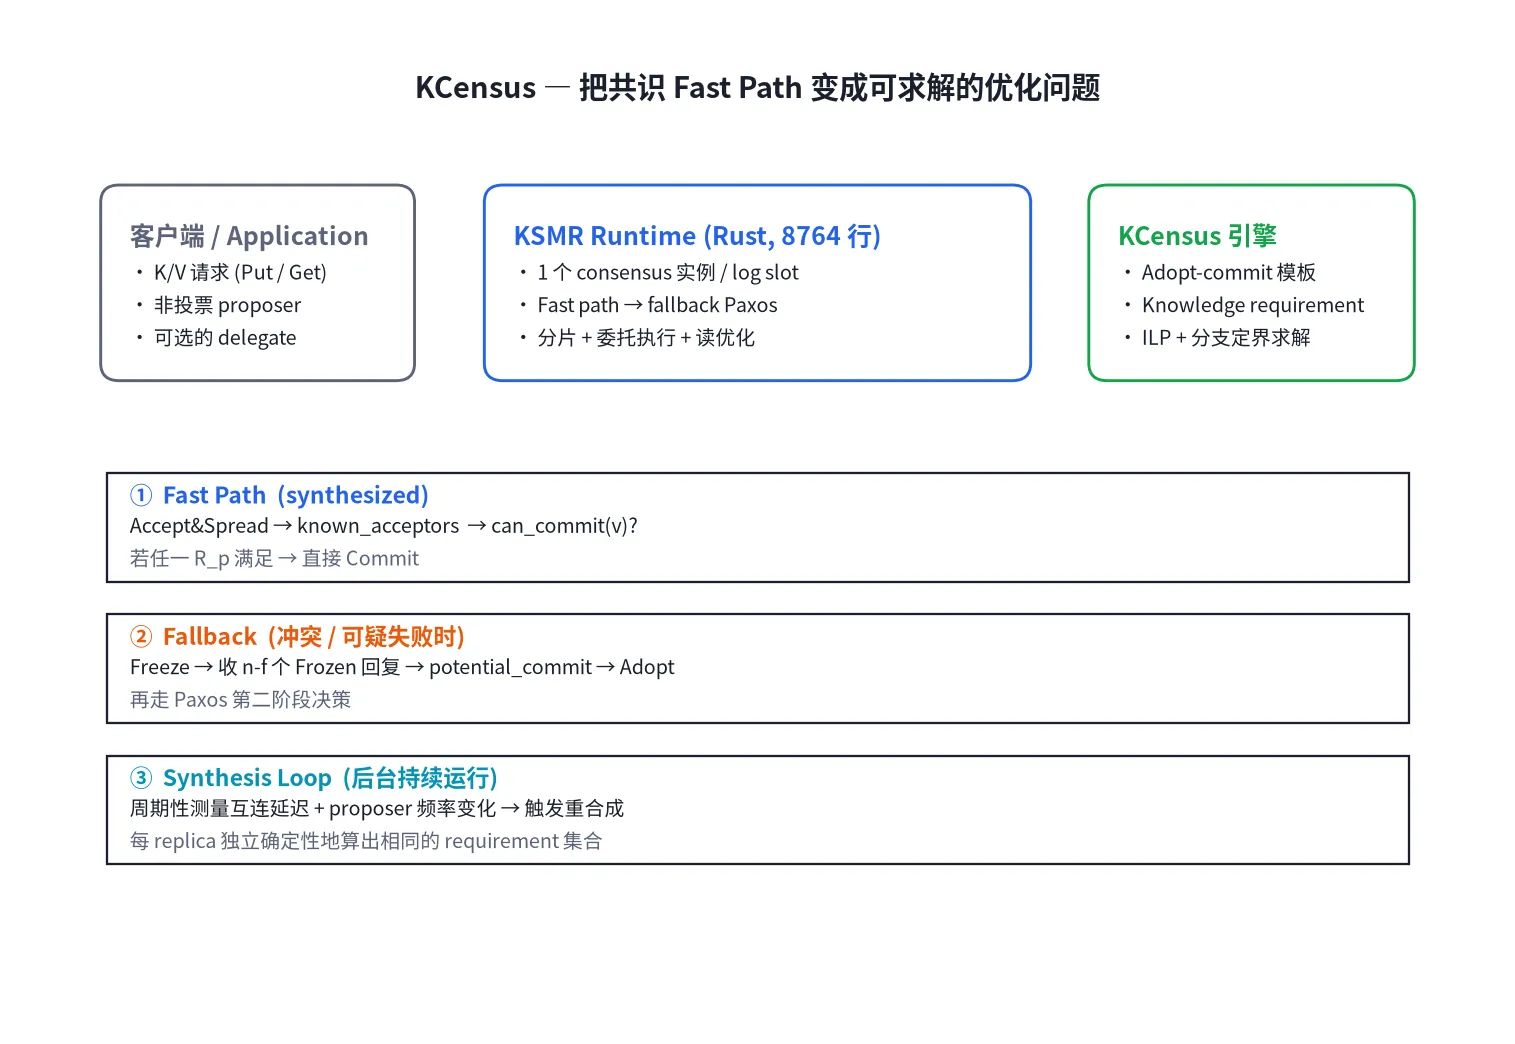
这张图把整个系统从客户端到 backend 一层层摊开。三个色块分别对应客户端、KSMR runtime、和 KCensus 引擎。下面三张横条对应 fast path、fallback、和后台 synthesis loop。后面会逐一展开。
具体三步:
1) 散布证据(Evidence Spread):proposer p 发起 Accept&Spread(v, ∅),每个接受者接受第一个值并把 known_acceptors[] 数组广播出去。这个数组记录”我知道 q 见证了哪些接受”。
2) 检查 commit(Algorithm 4):p 周期性检查自己的 known_acceptors[] 是否覆盖了 R_p 的要求 —— 如果每个 q 都知道了 R_p[q] 的全部证据,就 commit。
3) 冲突/失败时 freeze(Algorithm 6):p 收不到证据,或者收到 DoAdopt(),就广播 Freeze(),等 n-f 个 Frozen() 回复。每一个回复里夹带了”我接受了什么 + 我见证了谁”。这一坨回复叫做 Knowledge Census,也是 KCensus 名字的来源。
p 从 census 里找出一个仍然”可能 commit 过”的值 v’,如果找不到就 adopt 自己的值(任何 proposed 值都安全),然后把这个 v’ 带到 fallback Paxos。
3.2 Evidence Spread:环上演示#
论文 Fig 4(我重新画了)用一个 5 节点环演示 evidence 怎么传播:
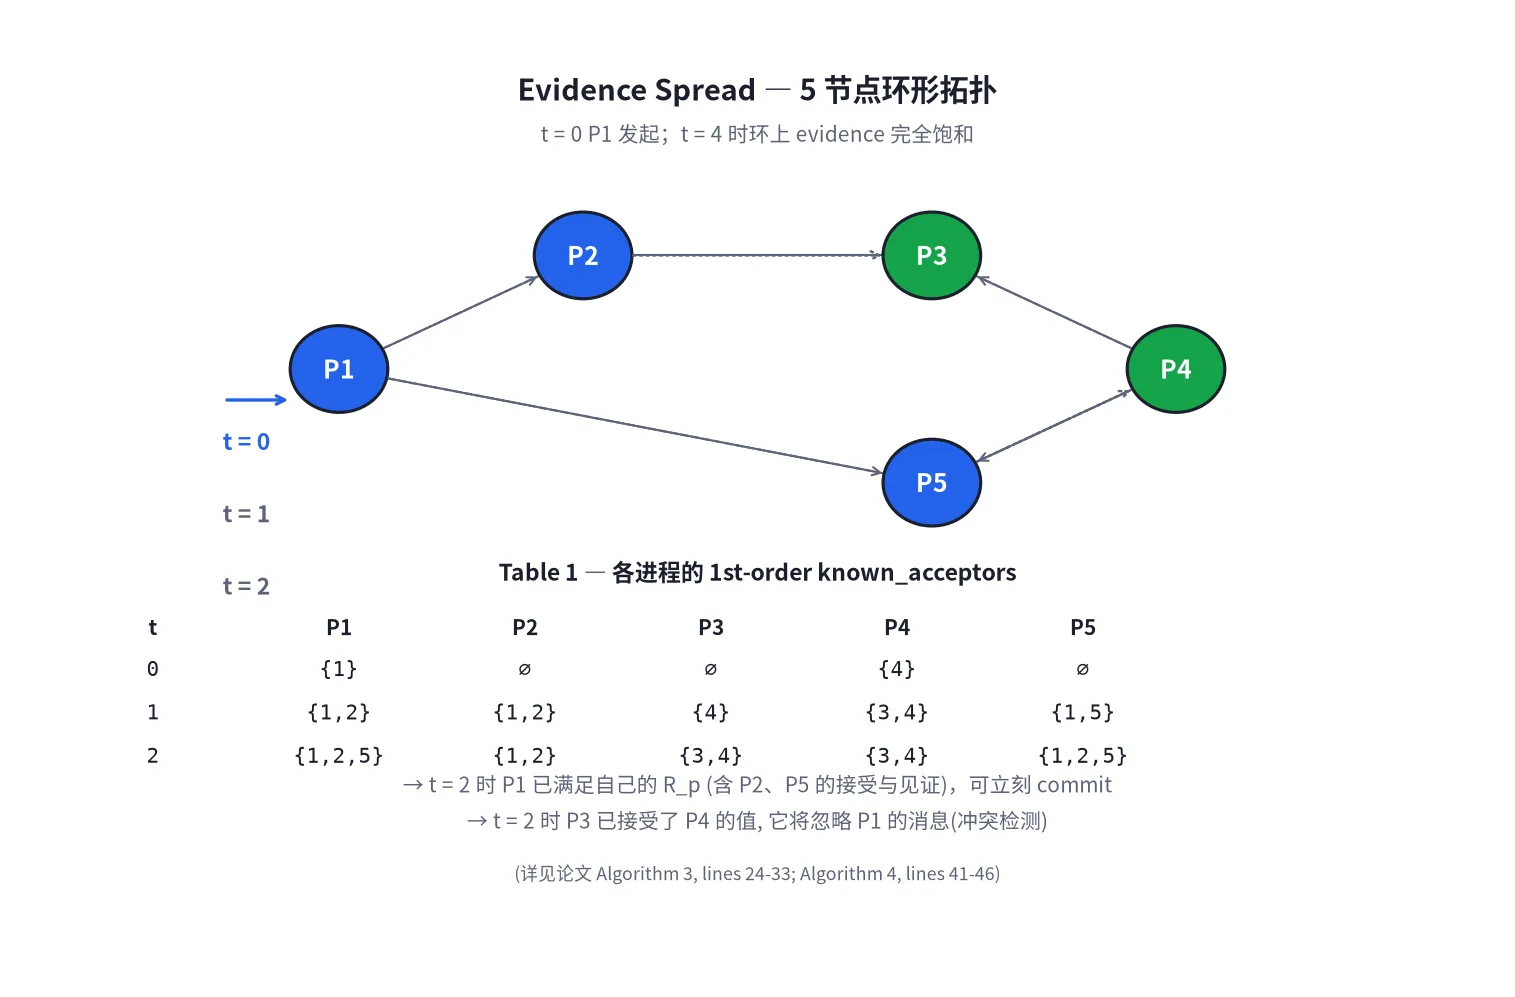
t=0 P1 和 P4 同时发起 propose,各自把 Accept&Spread 发出去。
t=1 P1 的消息到达 P2、P5;P4 的消息到达 P3、P5。
t=2 P3 已经接受了 P4 的值,所以忽略 P1 的消息(冲突检测);P5 把”我见证了 P1 的接受”和”我自己接受了 P1 的值”广播给 P3、P4;P2 把 P1 的接受往外广播。
t=3-t=4 环上的证据逐渐饱和,P1 知道 {P2, P5} 见证了,P4 知道 {P3} 见证了。
这一步有意思的设计是:每个进程广播的不是”我自己接受了什么”,而是”我知道谁见证了什么”。这就是 known_acceptors[] 二阶结构 —— 它把 witness 信息也一并传播,从而在同一个 round trip 内完成 fast-path 决策。
论文的 Table 1/2 在图里也列了出来。读这张表的关键是 t=2 时 P1 已经知道自己需要的所有证据,可以 commit;P4 则永远 commit 不了(它的 Q_p 要求 P3 见证 P5 的接受,但 P3 此时还不知道 P5 的状态)。
3.3 冰封与回退:Knowledge Census#
如果 commit 失败(冲突或可疑失败),p 进入 freeze:
send Freeze() to all         // 包括自己
wait for n-f Frozen(*) replies
v' = potential_commit(replies)
if v' == ⊥: v' = v
Adopt(v')potential_commit 算法 6 对每个出现的值 v,检查 census 能不能排除它:
- 有没有 required acceptor 接受了不同的值?有 → 排除
- 有没有 required witness 接受了 v 但缺少
R_v要求的证据?有 → 排除
定理(论文 §4.4):如果 v 真在 fast-path 上 commit 过,每一个 n-f 的 census 都包含 v,且没有任何 census 能排除 v。
反过来,任何一个冲突值 v’,因为 compatibility 保证了 >f 个交集见证者,每一个 census 都至少含一个,所以一定能被排除。
这就是 compatibility 条件”用在刀刃上”的地方 —— 它不是设计约束,它是 safety 的数学保证。
四、把 fast-path 合成成 ILP#
到这里,论文已经给了我们”任何兼容的 requirement 都能生成一个正确的 fast path”。但工程上,我们想要的是对给定部署最优的那个。
4.1 从延迟拓扑到候选 budget#
KCensus 的第一步是把”任意 requirement”这个 2^{n×n} 的组合空间砍成离散 budget。
具体做法(论文 §5.1):对每个 proposer p,用测量到的互连延迟,模拟一次单 proposer 的 evidence 传播。每一条 evidence 到达 p 的时刻就是一个 budget 候选。
直觉上:一个 proposer 在时间 t 内能学到的所有 evidence,才可能在 t 时刻被满足成 requirement。比这更早的 requirement 不可能 commit,比这更晚的 requirement 必然到 t 才能 commit。
每个 budget b 对应一个 requirement R_{p,b},满足这一组所有可获得的 evidence。这些 R_{p,b} 就是 ILP 的决策变量集合。
4.2 优化问题(论文 Problem 1)#
min  Σ P_p · b_p
s.t. compatible(R_{p,b_p}, R_{q,b_q}) ∀ p, q- P_p = proposer p 是当前 proposer 的概率(从监控数据来)
- b_p = 给 p 选的 budget
- compatibility = §2.2 那个 f+1 见证者条件
换目标函数 就能切到 p50 / p99:
- 平均延迟:
Σ P_p b_p - 中位延迟:
median{b_p} - p99:
quantile_99{b_p}
compatibility 是约束,目标函数是变量。同一套 ILP 框架,三种优化方向。
4.3 剪枝让 ILP 实际可解#
朴素枚举所有 budget 组合是指数级的。论文做了一个关键剪枝:
“A budget is dominated if it is no cheaper for the objective and does not enable compatibility with any requirement that a cheaper budget cannot already support.”
翻译:一个 budget 如果在目标函数上不比便宜的更好,且不能让任何 requirement 兼容到便宜预算已经能兼容的范围内,它就是多余的。
剪枝之后,论文实测每个 proposer 只剩 ≤10 个候选 budget,分支定界扫一遍在 31 副本下也只要 144ms。
4.4 把”消息图”再压一遍#
ILP 给出的是 logical requirement,怎么发消息把 evidence 送到,还有优化空间。论文 §5.4 又做了一轮:
- Latency shortcut:广域网延迟不满足三角不等式,X→Z 可能比 X→Y→Z 还慢;KCensus 用实测延迟表选最短路径
- 冗余删除:Z 已经从 Y 学到了 X 的接受,Z→X 的重复回执就不发了
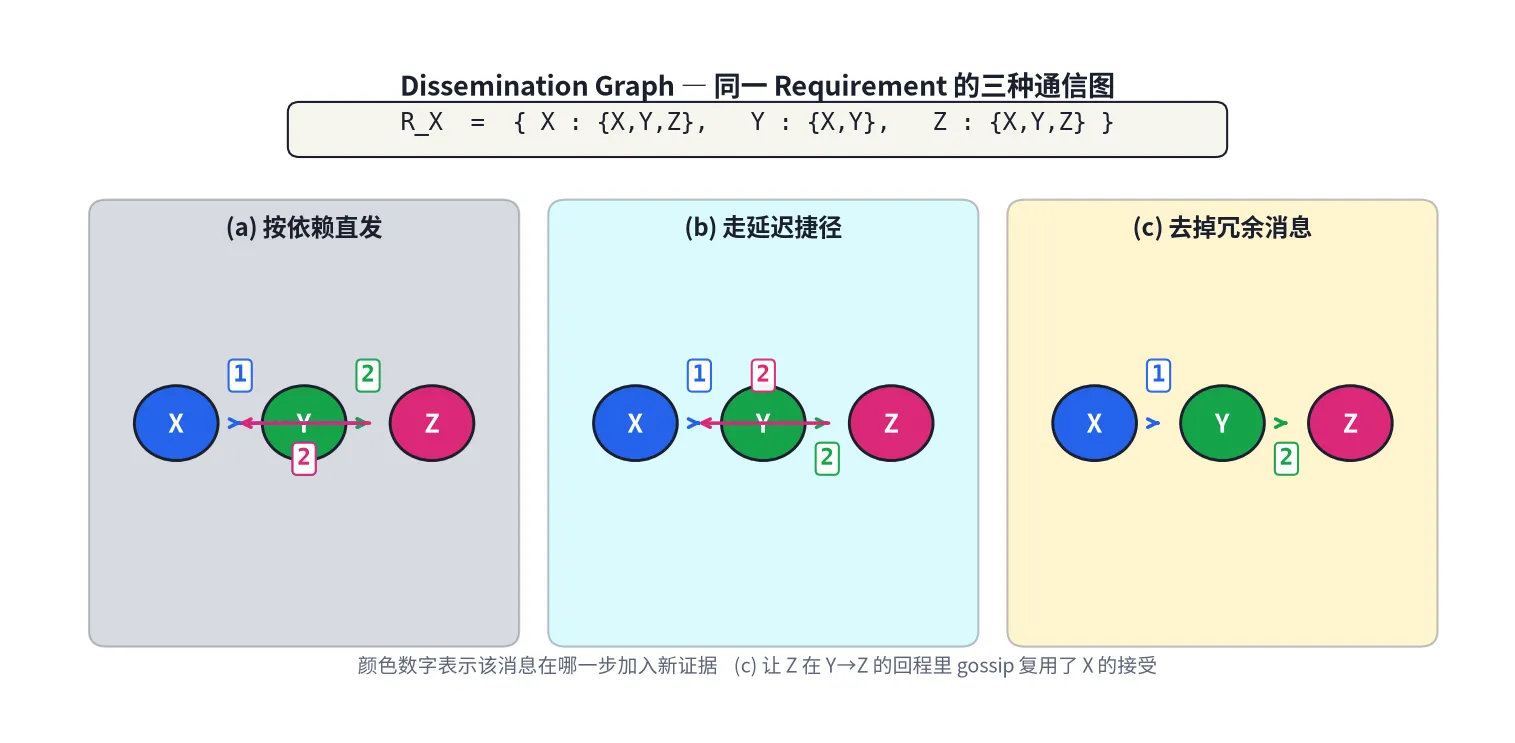
左边是按依赖关系”原始”(a)的直发;中间是用了延迟捷径(b)的 X→Y→Z;右边是再去掉冗余消息(c)的最终形态。
重要的是:这个优化只改变怎么发消息,不改变 requirement、不改变 commit 检查,所以 commit 延迟和 safety 完全不变。
4.5 最优性(论文 §5.2 末尾的 Optimality 段)#
论文给出了严格的最优性证明(简述):
给定固定拓扑、固定崩溃集、完美失败检测、无冲突执行、固定延迟指标,任何确定性 fast path 的 commit 时刻 b 必然由 evidence 在 b 时刻可达的快照决定;任何能在 b 时刻承诺的 requirement 必须满足 compatibility。所以 KCensus 合成的 requirement 一定不比任何手工设计的 fast path 差。
这条定理把”合成 fast-path”从启发式升格成了最优算法。
4.6 合成可视化:一个 3-proposer 的 toy example#
下面这张图(我按论文 Fig 5 重新画了)展示了一个 3-proposer、5-budget 的搜索空间:
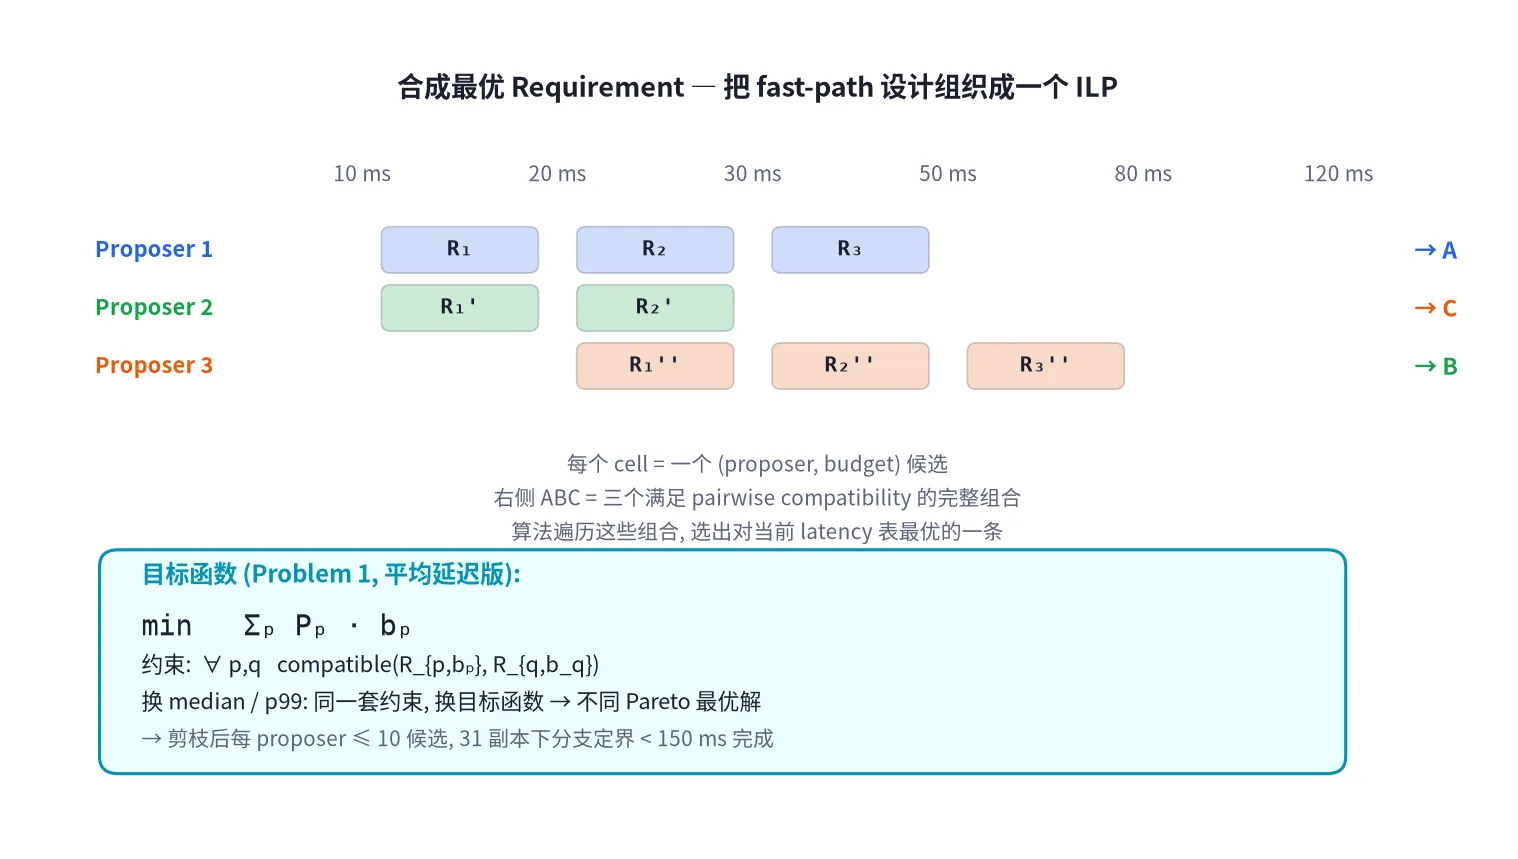
- 每个色块 = 一个
(proposer, budget)候选 - 三条彩色折线 = 三个满足 pairwise compatibility 的完整组合(A / B / C)
- 算法遍历这些组合,挑出对当前 latency 表最优的一条
问:预算格放大,合成开销多大?论文实测 31 副本 144ms / 单核,而且只在拓扑显著变化时触发。
论文给出了严格的最优性证明(简述):
给定固定拓扑、固定崩溃集、完美失败检测、无冲突执行、固定延迟指标,任何确定性 fast path 的 commit 时刻 b 必然由 evidence 在 b 时刻可达的快照决定;任何能在 b 时刻承诺的 requirement 必须满足 compatibility。所以 KCensus 合成的 requirement 一定不比任何手工设计的 fast path 差。
这条定理把”合成 fast-path”从启发式升格成了最优算法。
五、KSMR 的实现#
KCensus 是一个框架;KSMR 是用它搭出来的 SMR 引擎,也是 Rust 实现的全部 8,764 行代码。
5.1 一个 slot 一个 consensus 实例#
KSMR 跑 one consensus instance per log slot:每个 process 把自己的命令写到它认为空的第一个 slot s。
- slot s 的 fast path = 当前 topology 优化出来的 KCensus adopt-commit
- 成功 → 立刻决策,replica 执行,proposer 前进到 s+1
- 失败 → adopt 一个安全值,带到 Paxos 第二阶段
5.2 冲突处理和 Paxos 重叠#
最有意思的设计是:Paxos 的 leader-election 阶段和 KCensus 的 adopt-commit 阶段,用同一套消息重叠执行。
也就是说,即便发生冲突,KSMR 也只是额外做一次 Paxos 第二阶段 —— leader 选举的消息没白费。论文报告”冲突场景下 fast-path 退化到 Paxos 的开销”(差不多两个 round trip),而且利用 leader 在 adopt 阶段已经收齐 census 的事实,冲突的恢复不会比干净 fast-path 慢很多。
Leader 还能把多个冲突的请求 batch 成一个 Paxos proposal,进一步降低开销。
5.3 分片、读优化、委托执行#
分片:不同 key 走不同 shard,完全不冲突的命令并行 commit。每个 shard 独立合成自己的 requirement,因为 proposer 分布在 shard 内可能不一样。
读优化:读不复制(论文 §6 + HotStorage’19 Charapko 的方法)。一个 replica 在执行读之前,先查一个与所有写 quorum 相交的 quorum,等最高 slot 执行完。读不会延迟写。
委托执行(Delegated Execution):非投票客户端(client)发起 propose,但 commit 检查和执行交给附近的 replica。这样客户端不需要成为 voting process,省一跳,client 崩了也不算 f 故障。
5.4 Latency monitoring 闭环#
后台持续监控:
- 每个 replica 周期性测量它到其他 replica 的延迟,聚合成 latency table
- 任何 replica 发现拓扑变化(节点崩、链路劣化、proposer 频率漂移),就把新表提议为跨 shard 命令
- 共识确认新表后,每个 replica 独立确定性地跑一遍 ILP,得出相同的 requirement 集合
因为合成算法是 deterministic 的,所有 replica 自己算出来的需求集合必然一致,不需要额外的协调消息。
最妙的是合成开销本身:31 副本 144ms,而且只在拓扑变化时触发 —— 比”网络抖动一次就触发一次”的方案便宜几个数量级。
六、评测:9% 不到 16% 是怎么来的#
论文 §7 部署在 AWS 上:
- NH(Northern Hemisphere)7 副本:跨大洲
- EA(East Asia)7 副本:东亚区域
- EU(Europe)7 副本:欧洲区域
- NA(North America)7 副本:北美区域
- Random / Parisian 3-31 副本:扩展性实验
基线:Multi-Paxos / Pando / EPaxos / SwiftPaxos,全部用 KSMR 的 Rust 代码库重写,消除了语言差异。所有系统都优化到对当前部署平均延迟最优的配置。
6.1 四个部署的延迟#
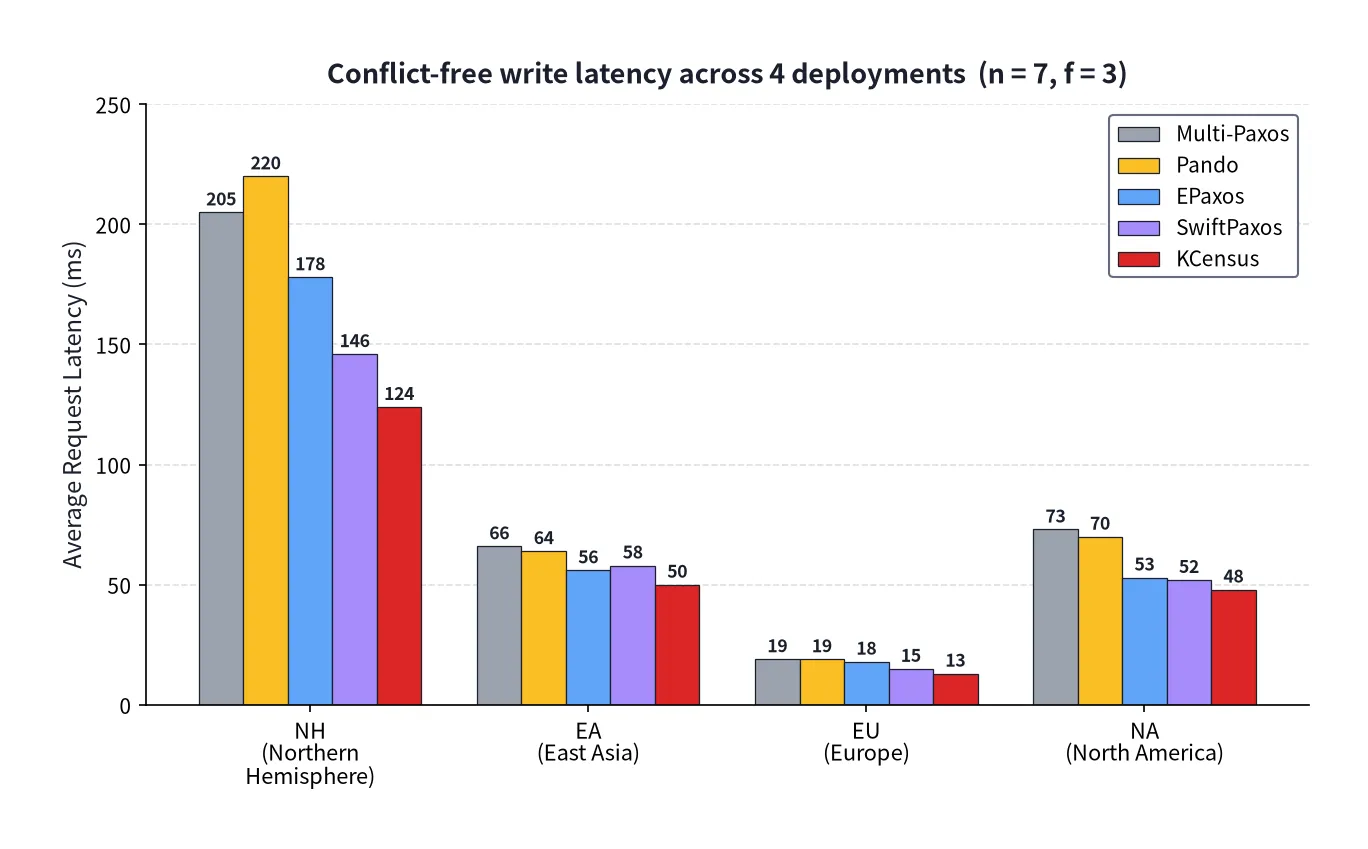
四张部署下,KCensus 在每一个部署都拿到了最低平均延迟:
- NH:124ms vs SwiftPaxos 146ms(-15%)
- EA:50ms vs EPaxos 56ms(-15%)
- EU:13.4ms vs SwiftPaxos 15.1ms(-12%)
- NA:47.5ms vs SwiftPaxos 52.1ms(-9%)
p99 也是同样的故事 —— KCensus 在每个部署都拿下了 p99 第一名。
论文里有一个细节很有说服力:绝大多数 client 用的就是 “cheapest valid strategy” —— 也就是”等够离我最近的 majority 接受”。Compatibility 在这种情况下几乎是”免费的”:
- EU 每个 client 的”最近 majority”两两交集 ≥ 2 个副本,本身就 ≥ f+1 = 4
- NA 大多数 client 也是,但 MX-C1 是个例外(单独一个 quorum,只跟 US-E2 重合一个副本),它需要 US-E2 的接受在东部被额外见证
- EA 和 NH 有更多单副本交集,所以”第四个见证者”不总是 free,5 个 client 各付出了 < 0.3ms (EA) / ~2ms (NH) 的额外代价
整张图里只有一个 client —— NH 部署里的 AP-NE1 —— 需要 5 个副本而不是 bare majority。其它 27 个 client 全部在自己第五近的副本到达之前就 commit 了。
6.2 规模:3 到 31 个副本,曲线始终在最下面#
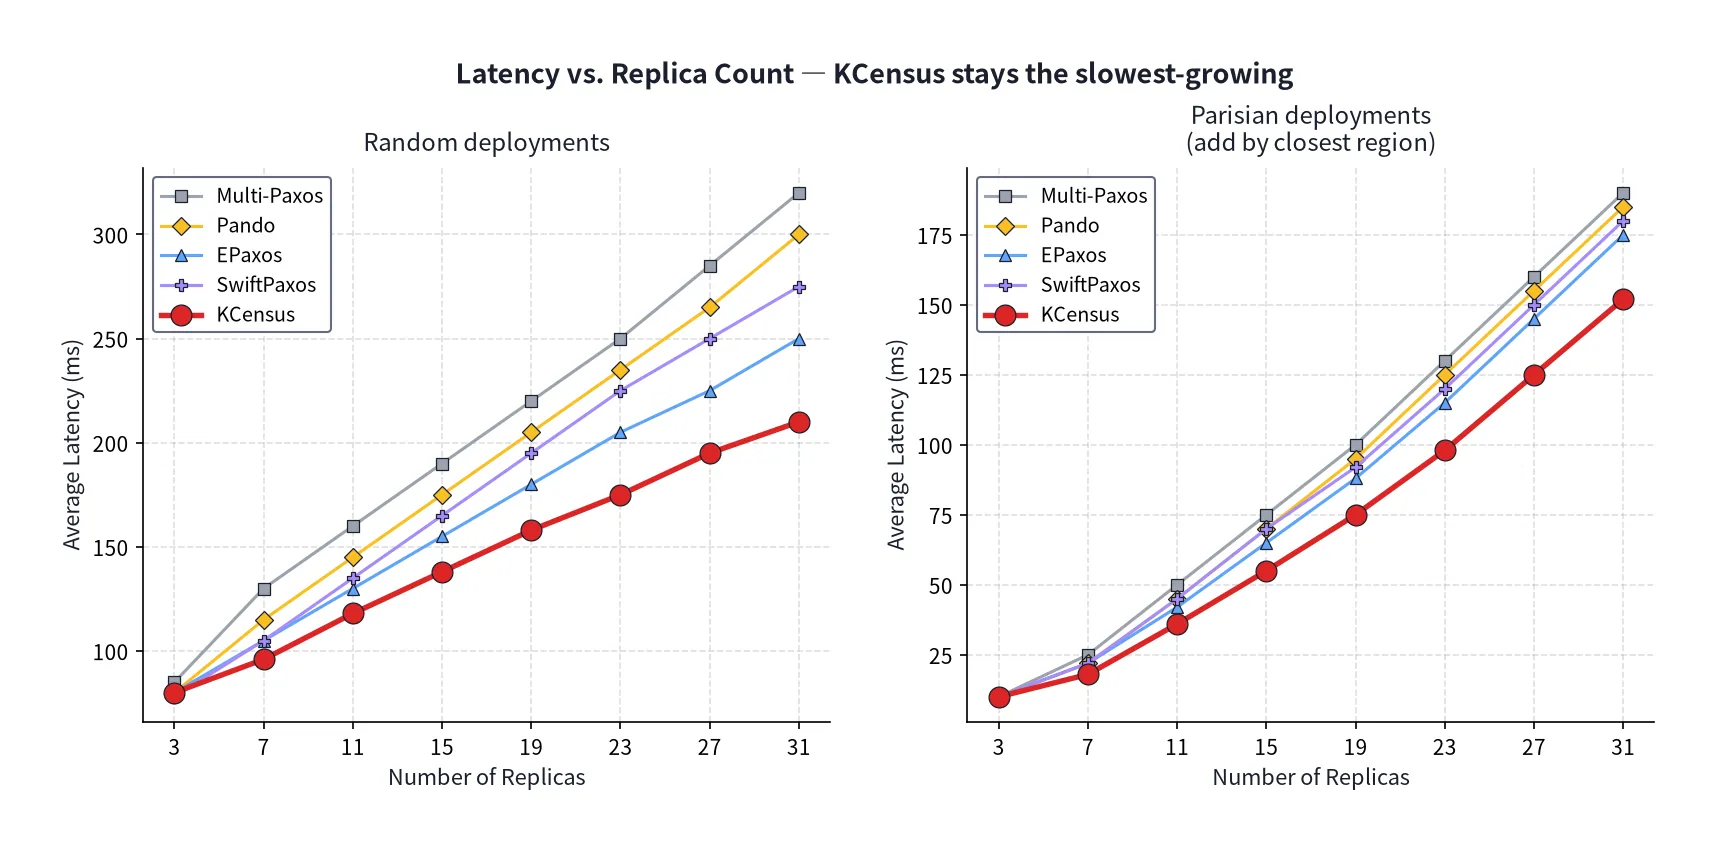
Random 部署(每次随机加 2 个新区域)和 Parisian 部署(从巴黎起,每次加最近的两个区域)两个扩展序列。
- 3 副本:大家都差不多,placement 选择有限
- 5 副本:EPaxos 偶尔和 KCensus 平手(它也是 5-quorum,巧合)
- 7 副本以后:KCensus 一路领先,到 31 副本仍然最低
- Random 部署下 KCensus 比最强基线快 8%(7 副本)~ 16%(21 副本)
- Parisian 部署下,延迟单调增长(每次加更远的副本),但 KCensus 增长率最低
核心洞察:延迟的瓶颈不是副本数,而是拓扑结构。31 个副本如果都集中在欧洲,延迟可能比 7 个跨大洲副本还低。KCensus 把这个洞察变成了算法:每次合成都是看 latency 表,不看 n。
6.3 失败时的弹性#
论文 §7.2 测了 0-3 个副本崩溃下的延迟。NH 部署:
- 0 failure: KCensus -15% vs fastest baseline
- 1 failure: -13%
- 2 failures: -6%
- 3 failures: SwiftPaxos 反超 3%
3 failures 时所有 proposer 被迫汇聚到同一个 quorum(SwiftPaxos 的专属结构),SwiftPaxos 的 speculative execution(它单 round-trip 即便 leader 崩了也能 commit)占了便宜。KCensus 用委托执行接近这个效果,但不靠投机。
这是 KCensus 的一个明确取舍:它不投机。安全网是”放弃 fast-path、走 Paxos”,SwiftPaxos 的安全网是”重新选 leader”。两种思路,SwiftPaxos 在 leader 邻近崩溃时稍快。
6.4 资源开销:便宜的 latency 买得不算贵#
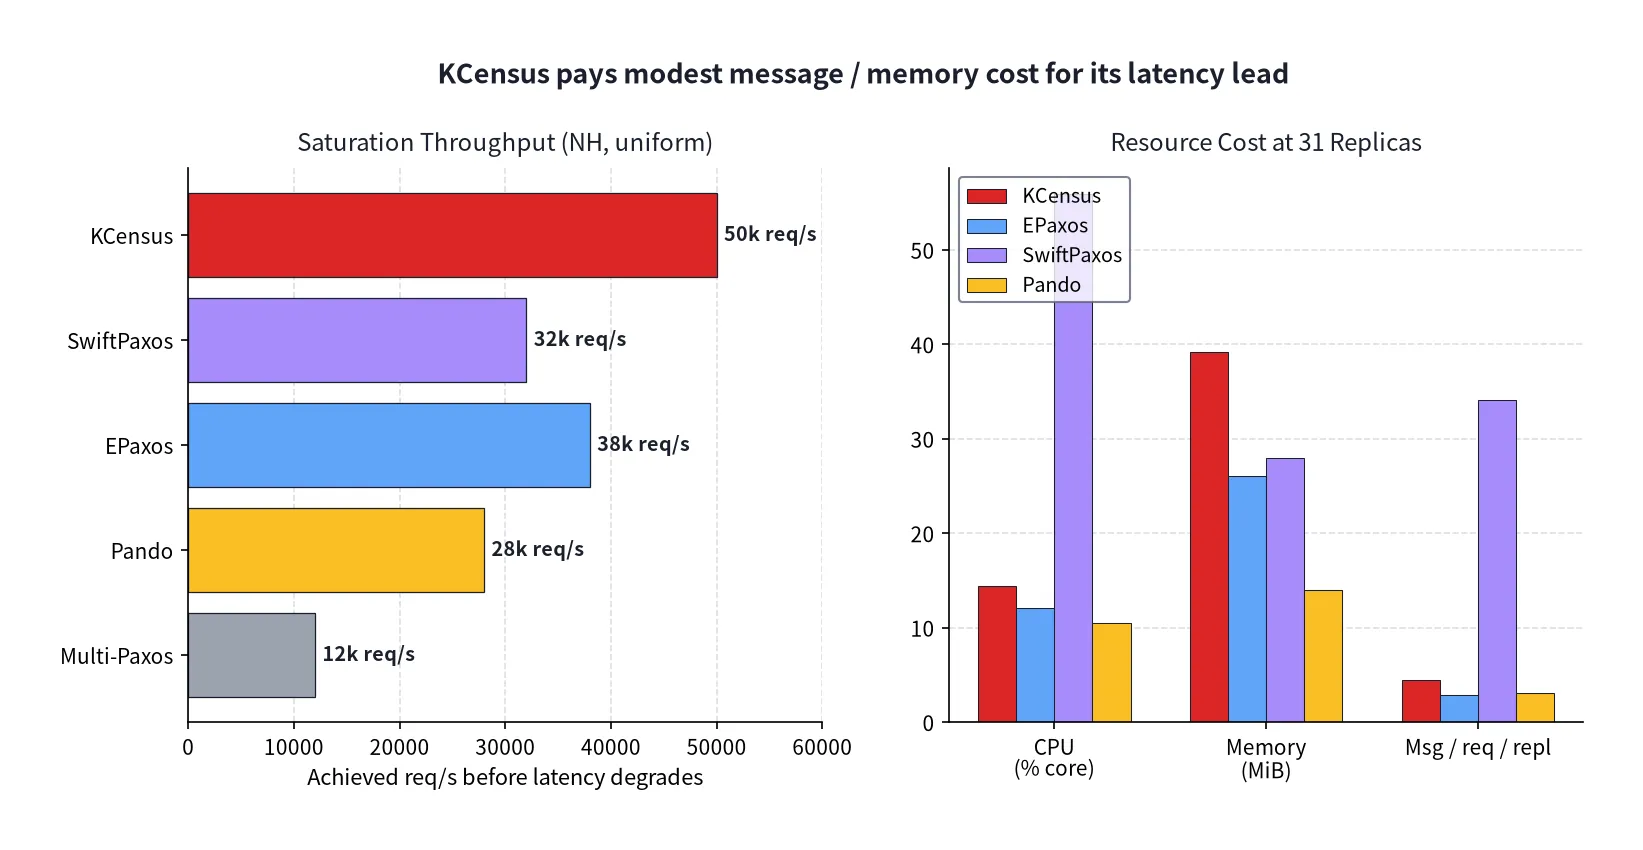
(左)saturation throughput(NH, uniform 访问):
- KCensus 50k req/s 才饱和
- EPaxos 38k
- SwiftPaxos 32k
- Pando 28k
- Multi-Paxos 12k
(右)31 副本的资源开销:
| 协议 | CPU(% core) | 内存(MiB) | msg/req/repl |
|---|---|---|---|
| KCensus | 14.4 | 39.2 | 4.4 |
| EPaxos | 12.1 | 26.0 | 2.9 |
| SwiftPaxos | 55.9 | 28.0 | 34.1 |
| Pando | 10.5 | 14.0 | 3.1 |
SwiftPaxos 因为每个 replica 都给所有其他 replica 回执,通信量是 O(n²);KCensus 因为 ILP 把消息图压到了 requirement 的最小必要集合,31 副本时只发 4.4 条/replica/request。
KCensus 用 SwiftPaxos 1/8 的 CPU 拿到了最低延迟。
唯一显贵的指标是内存:39 MiB,比 EPaxos 多 13 MiB、比 Multi-Paxos 多 24 MiB。这是因为 KCensus 需要在内存里维护 known_acceptors[] 数组(为 n 个进程各一个集合,每个集合记录 witness 信息)。论文说这个绝对量”still small in absolute terms”。
6.5 冲突和负载#
论文 §7.5-7.6 测了 Zipfian 0.99 的热点 key(模拟真实场景里的热 key 集中):
- 50% 写命中相同 key → 频繁冲突 → fast-path 退化到 Paxos
- KCensus 中位写延迟从 uniform 的 119ms 涨到 Zipf 的 123ms(只涨 3%)
- p99 从 ~200ms 涨到 385ms(主要是冲突的 1% 长尾)
- 平均 158ms vs SwiftPaxos 146ms —— SwiftPaxos 在 leader-based fallback 下少一跳,快 8%
SwiftPaxos 在高冲突下确实比 KCensus 好。但 KCensus 在冲突率 < 50% 的场景里(论文没测但现实的 KV 大概率是这个状态)仍然占优。
七、三个值得带走的洞察#
7.1 fast-path 设计 = 优化问题#
KCensus 的核心方法论迁移到其他领域也成立:任何被 hard-code 在协议里的”经验值”,都可以被还原成一个带约束的优化问题,然后用求解器在运行时动态决定。
类似的思路:配置调优(MLSys 的 AutoML)、feature flag(平台工程)、数据库索引推荐 —— 都可以从一个”专家配置”上升到”满足约束的最优配置”。
7.2 形式化 recovery 条件,一劳永逸#
KCensus 给出的 Validity + Compatibility 是充分必要的。也就是说:
- 不满足这两条的 fast path 一定不安全(necessity)
- 满足这两条的 fast path 一定可恢复(sufficiency)
之前 Fast Paxos / EPaxos 各自的 bug,本质都是悄悄违反了一个条件却没意识到。统一形式化之后,bug 应该不会复发了。
7.3 拓扑感知 + 持续优化 = 真正的自适应#
KCensus 持续监控拓扑,触发 ILP 重新合成。这个闭环本身不新鲜,但把 ILP 当成”持续跑的 Daemon” 是工程上的一个具体选择:
- 合成开销 144ms / 31 副本(单核)
- 触发频率受限于”显著拓扑变化”(不是每次 RTT 抖动)
- 所有 replica 独立确定性求解,不需要协调消息
这套工程闭环比”上线前人工选一个 fast-path”健壮得多,也比”运行时在线学”便宜得多。
八、局限和未来工作#
KCensus 自己也承认了几个开放方向:
- 机械验证:目前 Validity + Compatibility 是手工证明的,没有经过 Coq / TLA+ / Isabelle 形式化检查。这是一个明显的工程延伸。
- 多 requirement 鲁棒性:现在每个 proposer 只有一条 requirement,可疑失败时直接 abandon。论文留了一个观察:Paxos-style 的
n-fquorum requirement 跟任何 valid requirement 都兼容,加一条就能给延迟一个上限。 - 依赖追踪(EPaxos 风格):EPaxos 不是”一个值一个 decision”,而是给每个 command 算一个 dependency set 并把它一起共识。KCensus 现在还不支持这种结构化的并发。
- Byzantine fault:当前只考虑 crash fault。Byzantine 场景需要把见证者升级成 threshold signature 或者 quorum certificate。
- Speculative execution:SwiftPaxos 在 leader 邻近崩溃时靠投机赢 KCensus 一点 —— KCensus 当前不投机,委托执行只能”接近”。
- Erasure coding:Pando 用了 erasure coding 把”接近 majority 的副本”映射到地理距离。KCensus 现在是 1-replica-per-region 的简单模型,集成 erasure coding 应该能再降一档。
这些延伸里,机械验证 + 多 requirement 兜底是最容易落地的两项;Byzantine / 依赖追踪则是更大的工程。
九、写在最后#
KCensus 是 EPFL 在分布式系统基础理论上的一次”返璞归真” —— 它没有发明新的协议,而是把过去三十年发明的协议全部归约到同一个优化问题,然后让求解器在运行时替我们做最对的选择。
这个套路,我觉得值得每一个和”经验配置”打交道的工程师记一下:
把”专家调过的硬编码”重写成”带约束的优化”,把”上线前一次性决定”重写成”运行时持续合成”。
剩下的事,交给 ILP 和你的 latency table。
参考:Burgelin, Murat, Sela, Aguilera, Guerraoui. KCensus: Synthesizing Latency-Optimal Consensus Fast Paths. EuroSys’27 (Extended Version), arXiv:2609.31302, 2026-09-25. 代码:https://github.com/LPD-EPFL/kcensus ↗