深入解析 OpenResearch: 把 4 个 AI 编码 Agent 改造成科研实验编排器的 Rust CLI#
仓库: alphaXiv/OpenResearch ↗ · 94000 行 Rust / 114 文件 / 8 compute backend · MIT License · 仍以 8 月 26 日 0.26.x 系列高频迭代
如果你以为「让 Claude Code 做科研」就是把一个 prompt 改改、让它跑训练脚本,那 alphaXiv 这群人给你看的答案要复杂得多——也合理得多。
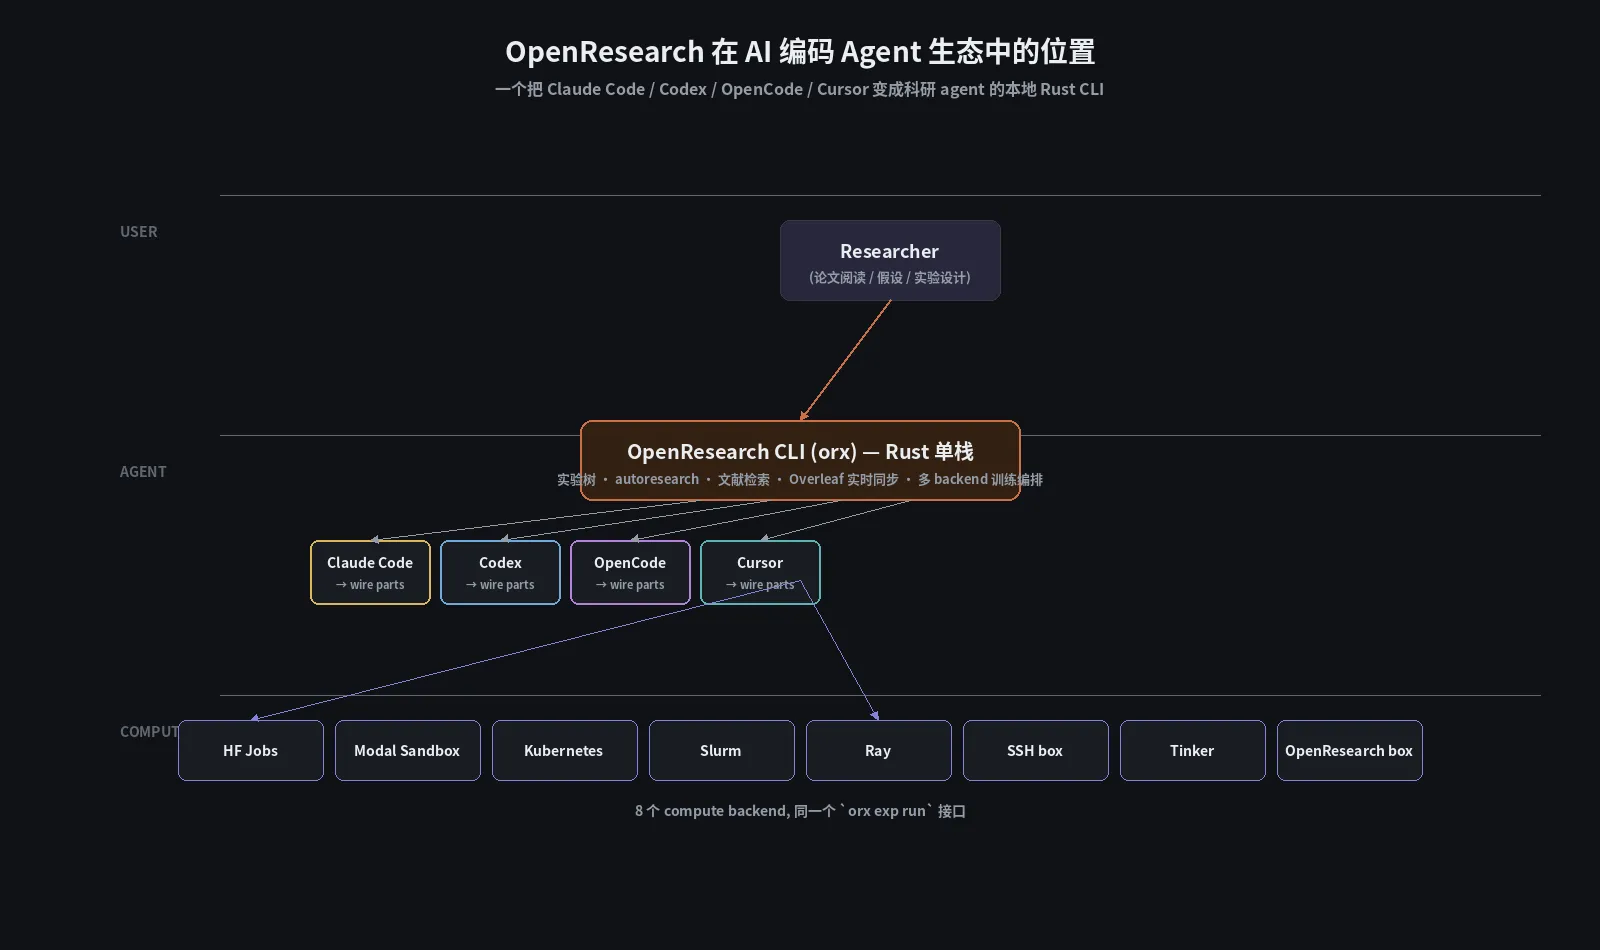
OpenResearch (命令行名 orx) 是一个本地优先的 Rust CLI,它的核心主张是:Claude Code / Codex / OpenCode / Cursor 这些 AI 编码 Agent 不是研究 agent,只是「会改代码的」;要让它们做真正的科研,你需要在它们外面套一层把研究工作的不变量——**实验树、git 分支、训练任务 detach、Overleaf 双向同步、文献检索——**作为一等公民抽象出来的运行时。
它怎么做到的?这正好是我们这次要拆的。
一、项目定位:不是新 Agent,是 Agent 之上的”研究运行时”#
先抛开所有细节,OpenResearch 在生态里的位置就一句话:
它是一个 Harness 抽象层 + 一个 SQLite 实验 store + 一套 compute backend,跑在用户的本地,把 4 个商业/开源编码 Agent 改成科研实验编排器。
写一个全新的 Agent 多累——你得训模型、做 alignment、写 prompt、写工具调用、写 harness,而且竞争对手全是 Anthropic / OpenAI 这种有数据飞轮的厂。alphaXiv 选择了一个非常聪明的赛道:不做 Agent,做 Agent 的 harness。
- 4 个 harness adapter (
claude-code/codex/opencode/cursor) 共享同一个Harnesstrait - 用户用 Claude Code 的账号登,起 Codex 当「主 agent」,用 OpenCode 当本地 free 备选,随意切——orx 的 chat 层只关心 wire 协议,不关心厂商
- 一个项目 (project) = 一棵实验树,根 baseline 节点 + 任意多 children,每个节点是一个独立 git 分支 + 一个固定的 run command
- 一次 run = 一个
BackendDescriptor(HF Jobs / Modal / K8s / Slurm / Ray / SSH / Tinker / OpenResearch Box),detached supervisor 持久化在 SQLite,机器重启可恢复 - Overleaf 论文同步走 socket.io (不走 git bridge),实时双向,250ms tick
整个项目的”非显然性”全在这些抽象的边界上。下面我们一层层拆。
二、仓库全貌:9.4 万行 Rust 怎么分#
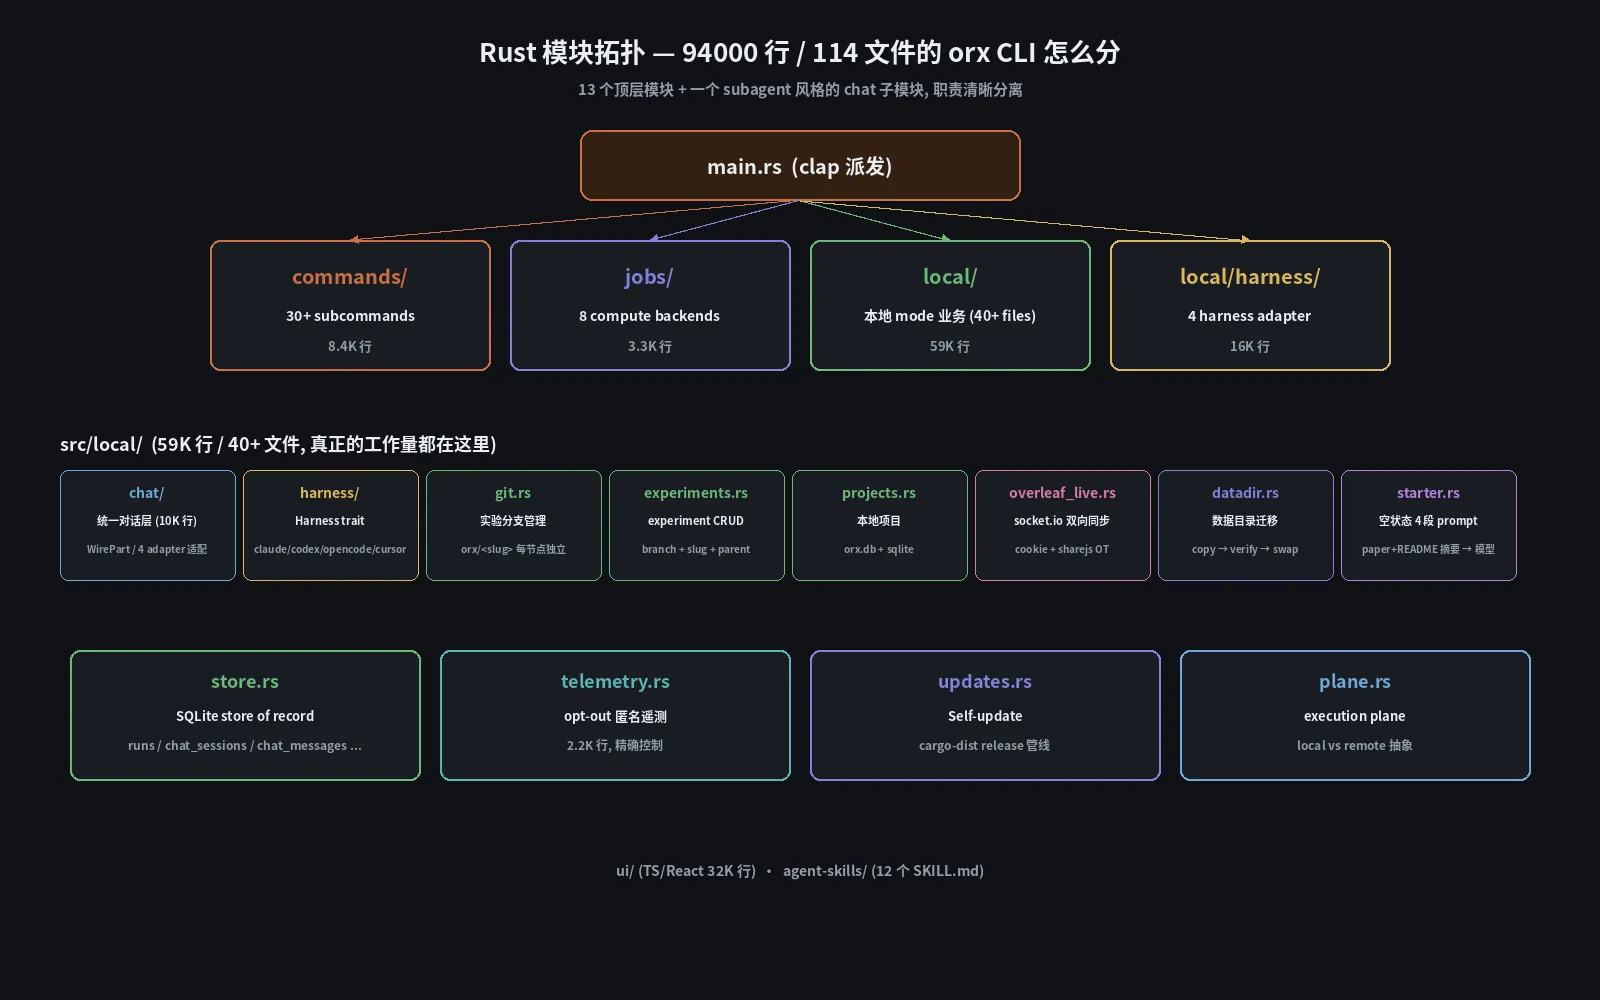
先看下数字,这个 CLI 真实不小:
| 模块 | 行数 | 说明 |
|---|---|---|
src/main.rs | 1K | clap 子命令派发,30+ subcommand |
src/store.rs | 5088 | SQLite store of record,runs / chat_sessions / chat_messages / experiments / ssh_host_tests / ui_state 等 14 张表 |
src/commands/up.rs | **8456 | 本地 dashboard server (axum),SPA + SSE + WebSocket + PTY 终端** |
src/jobs/ | 34885 (8 backend) | hf_jobs / modal / k8s / slurm / ray / ssh / tinker / openresearch |
src/local/ | 59K (40+ 文件) | 本地 mode 业务 (真正的肉) |
src/local/harness/ | 16K | 4 个 adapter:claude (3.3K) / codex (5.8K) / opencode (2.5K) / cursor (1.2K) |
src/local/chat/ | 10K | 统一的 WirePart 模型 + ChatHost turn 派发 |
src/agent-skills/ | 908 行 SKILL.md × 12 | 给 agent 看的”操作手册”模块 |
ui/ | 32K TS/TSX | React + TanStack Router + xyflow,134 个组件 |
而 src/local/harness/mod.rs (整个抽象层的入口) 只有 844 行——其中 200+ 行还是测试代码。这是”把复杂度推到实现层,保持抽象层小巧”的经典案例。
整个仓库的设计风格你能从注释里直接看出来——文档密度极高,overleaf_live.rs 的模块开头就是 4 段长注释解释为什么不用 git bridge、orx_retry_delay 的注释连 jiterring 算法都写了。读它像读论文,代码是次要的。
三、Harness trait:为什么这一个 trait 撑住了 4 个完全不同的 Agent#
src/local/harness/mod.rs 是一切的中心:
#[async_trait]
pub(crate) trait Harness: Send + Sync {
    fn id(&self) -> &'static str;        // "claude-code" / "codex" / "opencode" / "cursor"
    fn name(&self) -> &'static str;      // UI 显示名

    // === chat 能力 ===
    fn supports_chat(&self) -> bool { false }
    async fn detect(&self) -> Option<HarnessInfo> { None }
    async fn run_turn(&self, _ctx: &mut TurnCtx) -> TurnResult { ... }
    fn supports_steering(&self) -> bool { false }
    fn options(&self) -> HarnessOptions { HarnessOptions::none() }
    async fn one_shot(&self, _req: OneShot<'_>) -> Option<String> { None }

    // === prompt 回答回流 ===
    async fn resume_from_prompt(&self, _ctx: &ResumeCtx,
                                 _prompt: &WirePrompt,
                                 _answer: &PromptAnswer)
        -> Result<ResumeAction> { Ok(ResumeAction::Nothing) }

    // === skill install 能力 ===
    fn config_home(&self) -> Option<PathBuf> { None }
    fn skill_target(&self) -> Option<PathBuf> { None }
    fn skill_shim(&self) -> Option<&'static str> { None }
    fn extra_skill_targets() -> Vec<(PathBuf, &'static str)> { Vec::new() }

    // === 每个 session 自带 skills ===
    fn session_skills_dir(&self) -> Option<&'static str> { None }
}设计原则很简单——每个方法都有合理的 default,一个 harness 只实现它能实现的。detect / run_turn / skill_target 都是可选的,使得加一个 detection-only 的 harness (比如未来的 Codex-A) 只需要写一个文件 + 一行 Box::new(...) 加进 registry()。
3.1 为什么需要”两套”prompt 协议#
这是 Harness trait 里最值得讲的设计——resume_from_prompt 返回的 ResumeAction 是一个 enum:
pub enum ResumeAction {
    SendMessage { text: String, mode: Option<PermissionMode>, plan_mode: Option<bool> },
    Handled    { plan_mode: Option<bool> },  // 已经自己处理完了
    Nothing,
}因为 Claude Code 和 OpenCode 处理 permission / question 的方式完全不同:
- Claude Code (end-turn-and-resume):用户在 chat 里点 “Accept” 时,Claude 的 native session 会 end,answer 变成一条新的 user message,通过
--resume <session_id>开下一个 turn。 - OpenCode (inline-over-live):permission.asked / question.asked 是 SSE 推过来的,原 turn 还没结束(在 paused 状态),answer POST 回
opencode serve的 live session,同一 turn 继续。 - Codex (inline-over-app-server):用 JSON-RPC over app-server,行为跟 OpenCode 类似,但 prompt 类型不同 (
permission/question)。 - Cursor (end-turn-print-mode):因为
agent --print不能 prompt,permission 必须前置:问模式决定--mode ask(read-only)/--force(auto)/ 关闭 sandbox。
ChatHost 把用户答案路由回对的 harness,统一通过 ResumeAction 决策,而每个 harness 在自己的 resume_from_prompt 里实现”我怎么把答案塞回我的 native session”。
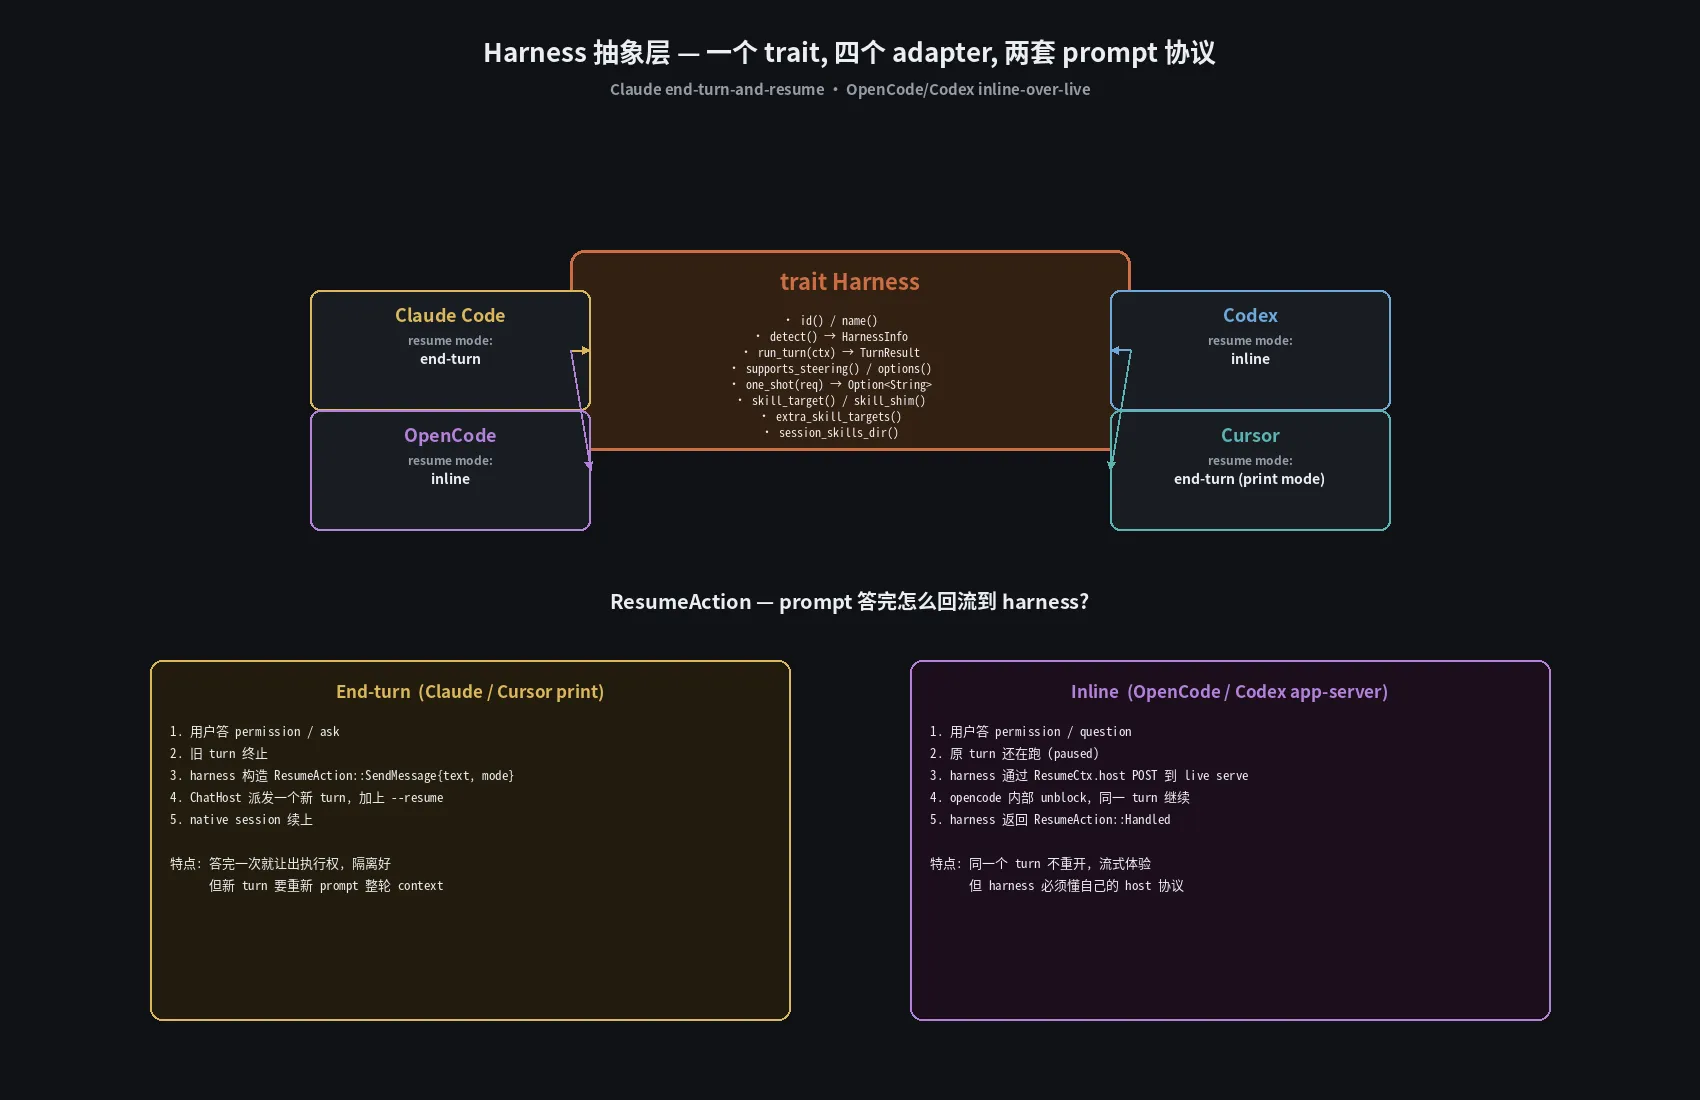
这套设计带来一个不变量:ChatHost::respond 永远只负责 mark resolved / busy-check / broadcast idle,不关心具体怎么投回——所以加新 harness 不用动 chat dispatch,这是 trait-as-extension-point 的教科书用法。
3.2 Claude adapter 的几个工程细节#
最复杂的 adapter 是 Claude Code (claude.rs, 3269 行)。几个值得抄的设计:
- resident 子进程:每个 chat session 一个长期存活的
claude --print --input-format stream-json子进程,多 turn 共用,靠--replay-user-messages回放判定 turn 边界。比起 spawn-per-turn,避免了每次 ~3s 的 CLI 启动开销。 - stdin held open + session_id 稳定:子进程在每次 turn 之间保持 stdin 打开,
session_id在子进程生命周期里不变。配置改动 / interrupt / crash 才 respawn,respawn 用--resume接续 native session。 - playbook 走
--append-system-prompt-file,不是塞 user message 里——避免被 tokenized 时当成普通文本污染 attention。 claude auth status --json是 readiness 唯一真相,~/.claude.json只是 display metadata,ANTHROPIC_API_KEY/ANTHROPIC_AUTH_TOKEN是 fallback。plan mode通过 mcp-gate bridge:Claude 在 plan mode 里 mid-turn 卡着,等 ExitPlanMode 答案;adapter 必须支持”一个 turn 中等两次 resume”,代码里专门有_is_paused_for_plan状态机。
3.3 Codex adapter 的双轨实现#
Codex 有两个完全不同的传输路径——codex >= 0.144 用 app-server JSON-RPC,旧的用 --json exec。
- 新路径:
codex app-server是个长连接 JSON-RPC 进程,每个 session 一个 thread (thread/start/thread/resume),每个 user message 一个turn/start。playbook 通过developerInstructions通道注入,不是 first-turn<system-context>文本包。 - 旧路径:每个 turn 一个
codex exec --json进程,JSONL events 流到 stdout,多 turn 用codex exec resume <session>。 - 通过
ORX_CODEX_EXEC=1强制旧路径,这是测试用的兜底——生产环境里要永远走 app-server。
更细节的是:Codex 检测跟着 $CODEX_HOME/config.toml 里的 active provider。自定义 provider 用它声明的 env_key 鉴权,默认 provider 看 auth.json 里的 OPENAI_API_KEY 或 OAuth JWT (unverified decode 出 email + plan)。这种配置跟随用户本地,不引入 orx 自己的中央账号,是它”本地优先”哲学的一个细节。
四、实验树 + autoresearch 闭环:这是 OpenResearch 最不像”Agent harness”的地方#
如果只有 Harness 抽象层,OpenResearch 就只是”又一个 chat 前端”。真正让它变成”研究工具”的是实验树模型。
4.1 一棵实验树长什么样#
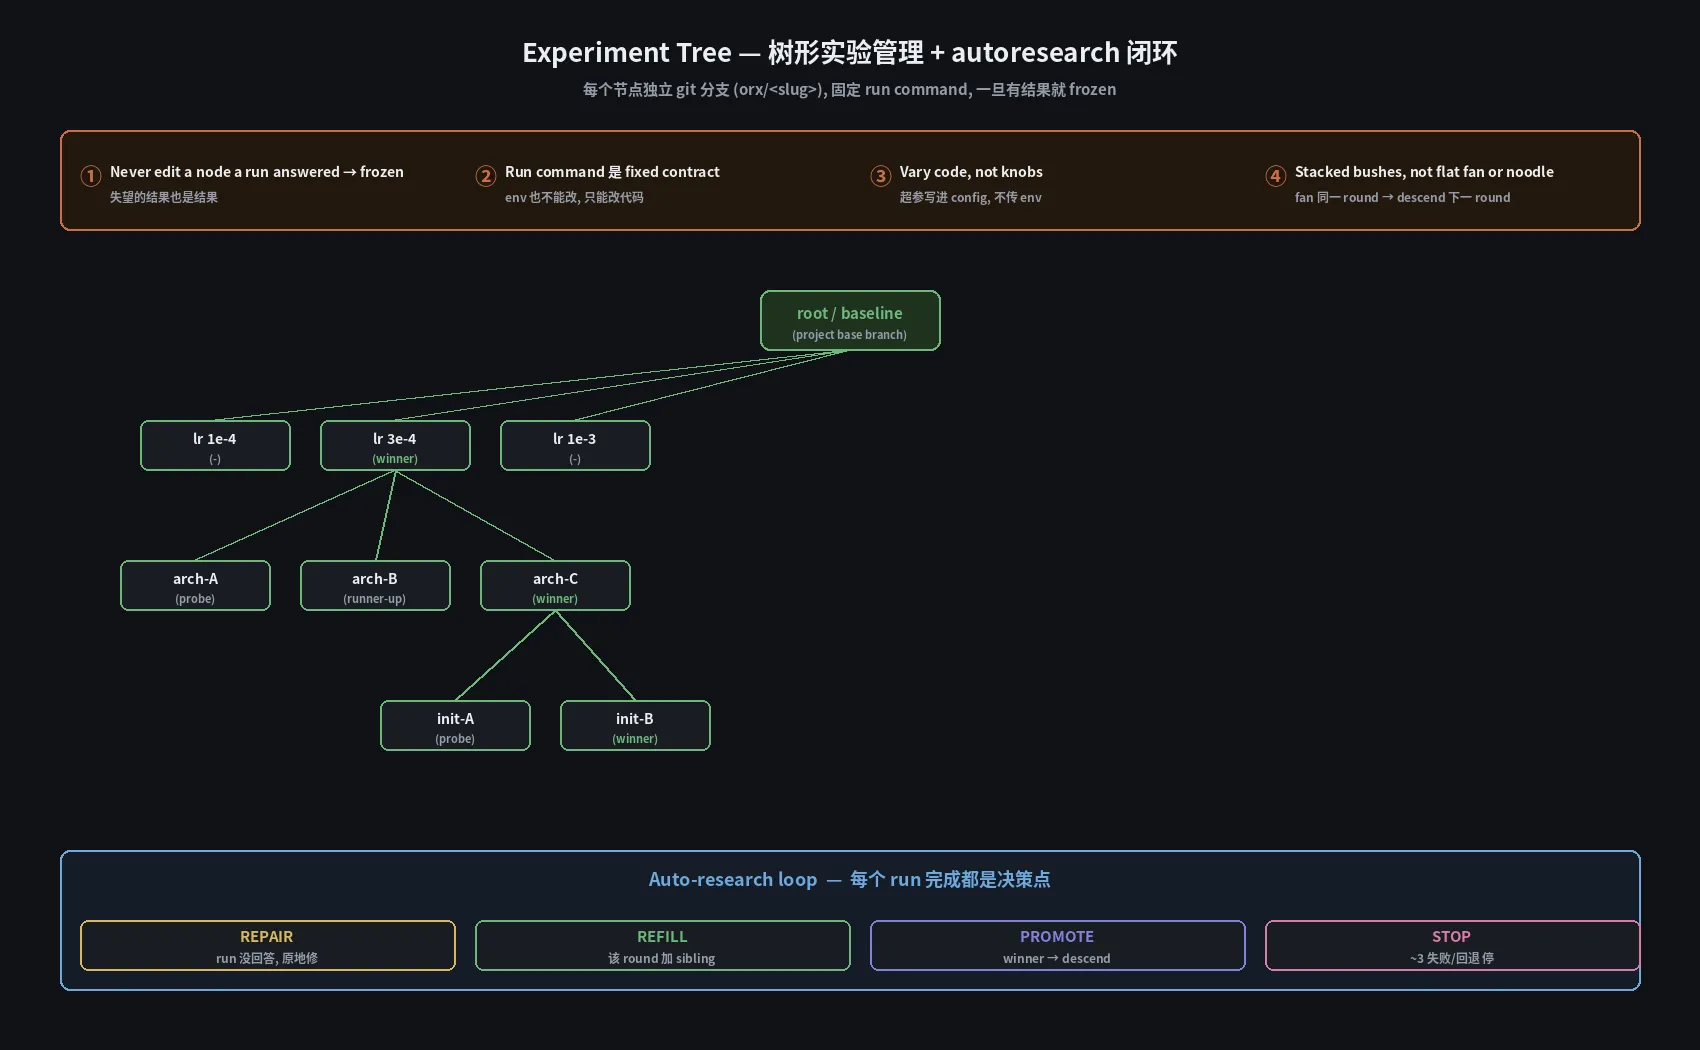
每个 project 是一棵节点树:
root (baseline)
├── exp_1  (branches: orx/<slug>)
├── exp_2
│   ├── exp_2a
│   └── exp_2b
└── exp_3节点 = 一个 git 分支 + 一个固定的 run command + 一组结果。每个节点独立:
- 创建时从 parent 节点或 baseline branch 拉出
orx/<slug>分支 - 一旦 run 出了结果 (成功 / 失败 /
nan/ metric 达标),节点 frozen——分支永远不再改 - “想再试一次?” 不允许修同一个节点,必须分支出 child 改代码
这是 agent-skills/orx-experiment-tree/SKILL.md 里写的 4 条 cardinal rules:
① Never edit a node a run answered → frozen ② Run command 是 fixed contract ③ Vary code, not knobs(超参写进 config,不传 env) ④ Stacked bushes, not flat fan or noodle
4.2 树形 vs 链形:一个反直觉的设计#
第 4 条特别有意思。常见的失败模式有两种:
- Flat fan (错的):每个 sweep 都挂在 root 上,结果都跟 baseline 比,win 永远不累积
- Noodle (错的):一长串单 child 链,深度注水,每步没真正 build on 上一步
- Stacked bushes (对的):一个 round 内 fan(3 个 LR 选项),然后descend 到 winner 开下一 round(架构层)
判断一条边是不是”对的 descend” 的简单规则:在你把 X 做 Y 的 child 之前,说清楚 Y 确立了什么是 X build on 的。能说出来 → 真深度;说不出来 → 应该是 sibling,不是 child。
这套形状直接由 create_experiment 强制:fork_point 必须等于 parent 的 branch_name,baseline 永远 fork 自 project.baseline_branch。
4.3 自动循环 4 个动作#
每次 run 完成,agent (其实就是个跑 orx 的 Claude Code session) 做 4 选 1:
- REPAIR:run 没回答问题 (OOM / div / missing dep),在原节点原地修(但有 cap: 同一节点连续 2 次失败就问用户,不同错误也算)
- REFILL:该 round 的 sibling 不够,加几个同 parent 的 child
- PROMOTE:winner → 把下一 round descend 到它上面
- STOP:~3 个失败/回退就停,别硬试
这是把”科研的决策循环”编码成 4 个动词——一个能自动跑的研究 Agent 不需要自己想出这些,它照着 SKILL.md 的指令循环就行了。
4.4 “provisional until it answers”——一个隐式的状态机#
每个节点有 4 个状态隐藏在 store 里:
running(有 active run)provisional(刚创建,还没出结果)frozen(有结果,不能再改)failed-provisional(跑完没结果,但被诊断为 implementation 失败而不是 hypothesis 失败——比如 OOM、divergence by bug)
注意:一个”失败”的结果(比如 nan 或者 loss 没下降)也让节点 frozen——这是一个核心哲学转变:失望的结果也是结果,别因为结果不漂亮就重跑掩盖它。
这跟主流 ML 实验管理工具不一样。Weights & Biases / MLflow 把 “failed run” 当异常;OpenResearch 把”失败的 hypothesis”当成成功实验,只把”失败的 implementation”当成需要 repair 的状态。
五、8 个 Compute Backend:同一个 orx exp run,8 种落地#
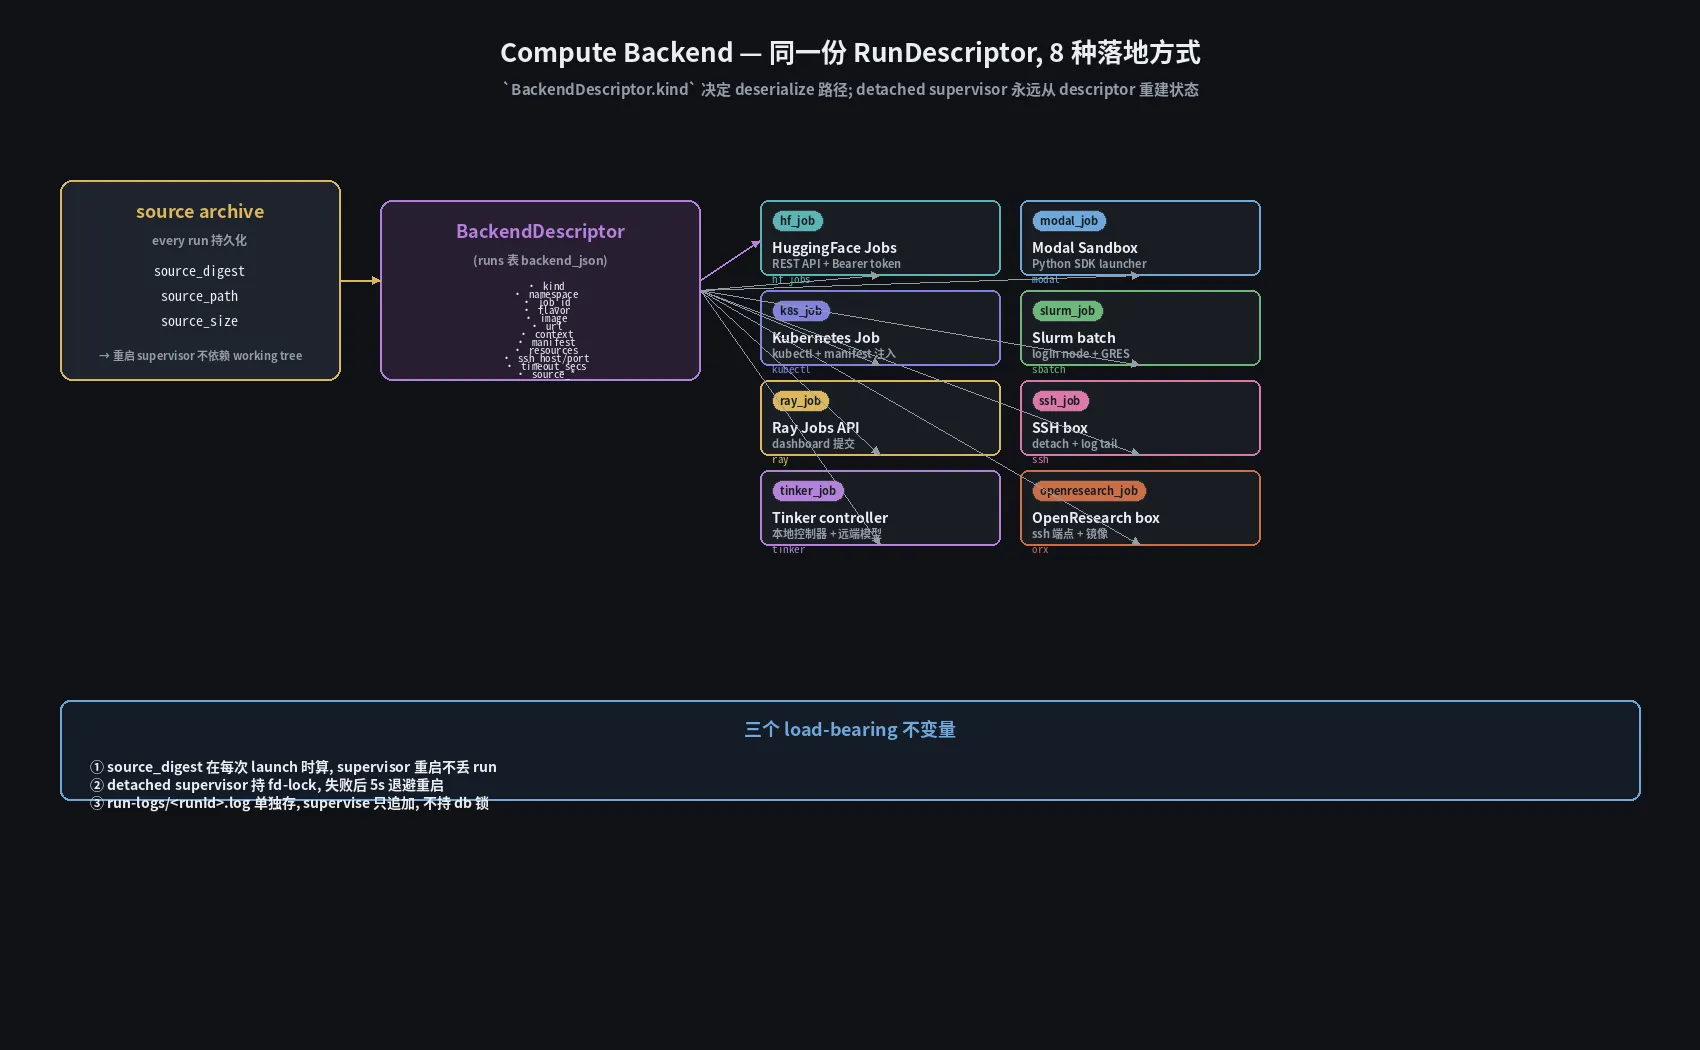
这是 orx 工程上最值得抄的设计之一。compute backend 不是一个枚举,是一个 trait + 8 个实现,而且用户只跟一个 BackendDescriptor 结构交互:
#[derive(Serialize, Deserialize)]
pub struct BackendDescriptor {
    pub kind: String,               // "hf_job" / "modal_job" / "k8s_job" / ...
    pub namespace: Option<String>,  // HF namespace / Slurm login host / OpenResearch box ssh host
    pub job_id:   Option<String>,    // run id / sandbox id / job name / (host, slurm id)
    pub flavor:   Option<String>,   // HF flavor / k8s flavor
    pub image:    Option<String>,   // container image
    pub url:      Option<String>,   // exposed URL (Ray dashboard 等)
    pub context:  Option<String>,   // k8s kubeconfig context
    pub manifest: Option<String>,   // k8s manifest path
    pub resources: Option<Vec<String>>, // k8s: kind/name handles created by manifest
    pub ssh_host: Option<String>,   // openresearch_box
    pub ssh_port: Option<i64>,
    pub ssh_user: Option<String>,
    pub timeout_secs: Option<u64>,
    pub source_digest: Option<String>,  // ← 3 个 load-bearing 不变量之一
    pub source_path:   Option<String>,
    pub source_size:   Option<u64>,
}这是个 tagged-union-by-string 模式(kind 字段是 discriminator),跟 Rust 习惯的 enum 不一样——理由很务实:JSON 序列化跨进程兼容,加了字段不破坏历史 run。BackendDescriptor::parse() 在 supervisor 重启时是唯一的入口,它能跑通就说明 run 状态恢复正确。
5.1 每个 backend 的差异点#
- hf_job — REST POST
{api}/jobs/{namespace},同步 volume 走api.sync_job_volume(),读 native hf-api 客户端 - modal_job — Modal 没有 REST job API,只能走 Python SDK,so every operation shells out to bundled
python -c LAUNCHER。launcher 是 Rust 里嵌的字符串常量,core.py 自己不存 Python 解释器,auto-provision 一个 orx-managed venv - k8s_job —
kubectl apply -f,但 manifest 注入是 orx 自己做的(支持kind/nameresource handles 收集,cancel 时精确删) - slurm_job — sbatch + login node + GRES,host 字段从
BackendDescriptor.namespace来(命名复用很巧妙) - ray_job — Ray Dashboard REST API
- ssh_job — 通用 SSH box,或者直接是用户的本机(最简单的 backend,不需要任何远端账号)
- tinker_job — 本地控制器 + 远端 model,走自己实现的小协议(不是 Tinker 官方 SDK,是 orx 自己写的 thin wrapper)
- openresearch_job — alphaXiv 自家的”研究机”,启动时 provision 一个 box(SSH 端点 + 镜像),supervisor 记录 ssh_host/port/user 后切到标准 SSH 流程
5.2 三个 load-bearing 不变量#
- source archive 持久化:每次 launch 计算
source_digest(sha256),run 表里存source_digest/path/size。supervisor 重启 / 换机器都不依赖 working tree。 - detached supervisor + fd-lock:run launch 完,
orx supervise <runId>是 detached 的子进程,持orx.lifecycle.lock(fd lock)。重启时先 acquire lock,5s 退避。 - run-logs/
.log 单独存 :supervise 只追加这个文件,完全不持 db 锁。SSE 500ms 增量 diff 直接 grep 这个文件,不阻塞 writes。
第 3 条特别聪明——传统的 supervisor 设计是把日志塞数据库,结果 writes 跟 reads 互相 block;OpenResearch 把”日志”和”元数据”彻底分离到两个物理文件,store.db 只存 chat 消息 + run 元数据,流式输出永远走 plain log。
5.3 PyO3 兼容性兜底——一个我之前没见过的细节#
default_python_env 在每个 backend 都被调用:
pub const PYTHONUNBUFFERED:  &str = "PYTHONUNBUFFERED";   // = "1"
pub const PYTHONIOENCODING:  &str = "PYTHONIOENCODING";  // = "utf-8"

pub fn default_python_env(env: &HashMap<String, String>) -> HashMap<String, String> {
    let mut env = env.clone();
    env.entry(PYTHONUNBUFFERED.to_string()).or_insert_with(|| "1".to_string());
    env.entry(PYTHONIOENCODING.to_string()).or_insert_with(|| "utf-8".to_string());
    env
}PYTHONUNBUFFERED=1 让 Python 输出不缓冲——supervisor 才能 tail 到实时 log。PYTHONIOENCODING=utf-8 解决 Windows 默认 cp1252 撞 emoji / 中文 crash 的问题。Kubernetes backend 因为要拼 JSON env 不能用 setdefault,所以 open-code 写了一遍自己的版本。这种”两个后端各自处理边角细节,但共享语义”的写法,才是真正的工程化。
六、Overleaf 实时双向同步:不走 git bridge,自己实现 socket.io 通道#
src/local/overleaf_live.rs 是整个项目里最”非主流”的代码——它不依赖任何 git,直接用 cookie 鉴权的 socket.io 0.9 协议跟 overleaf.com 的 realtime service 通信。
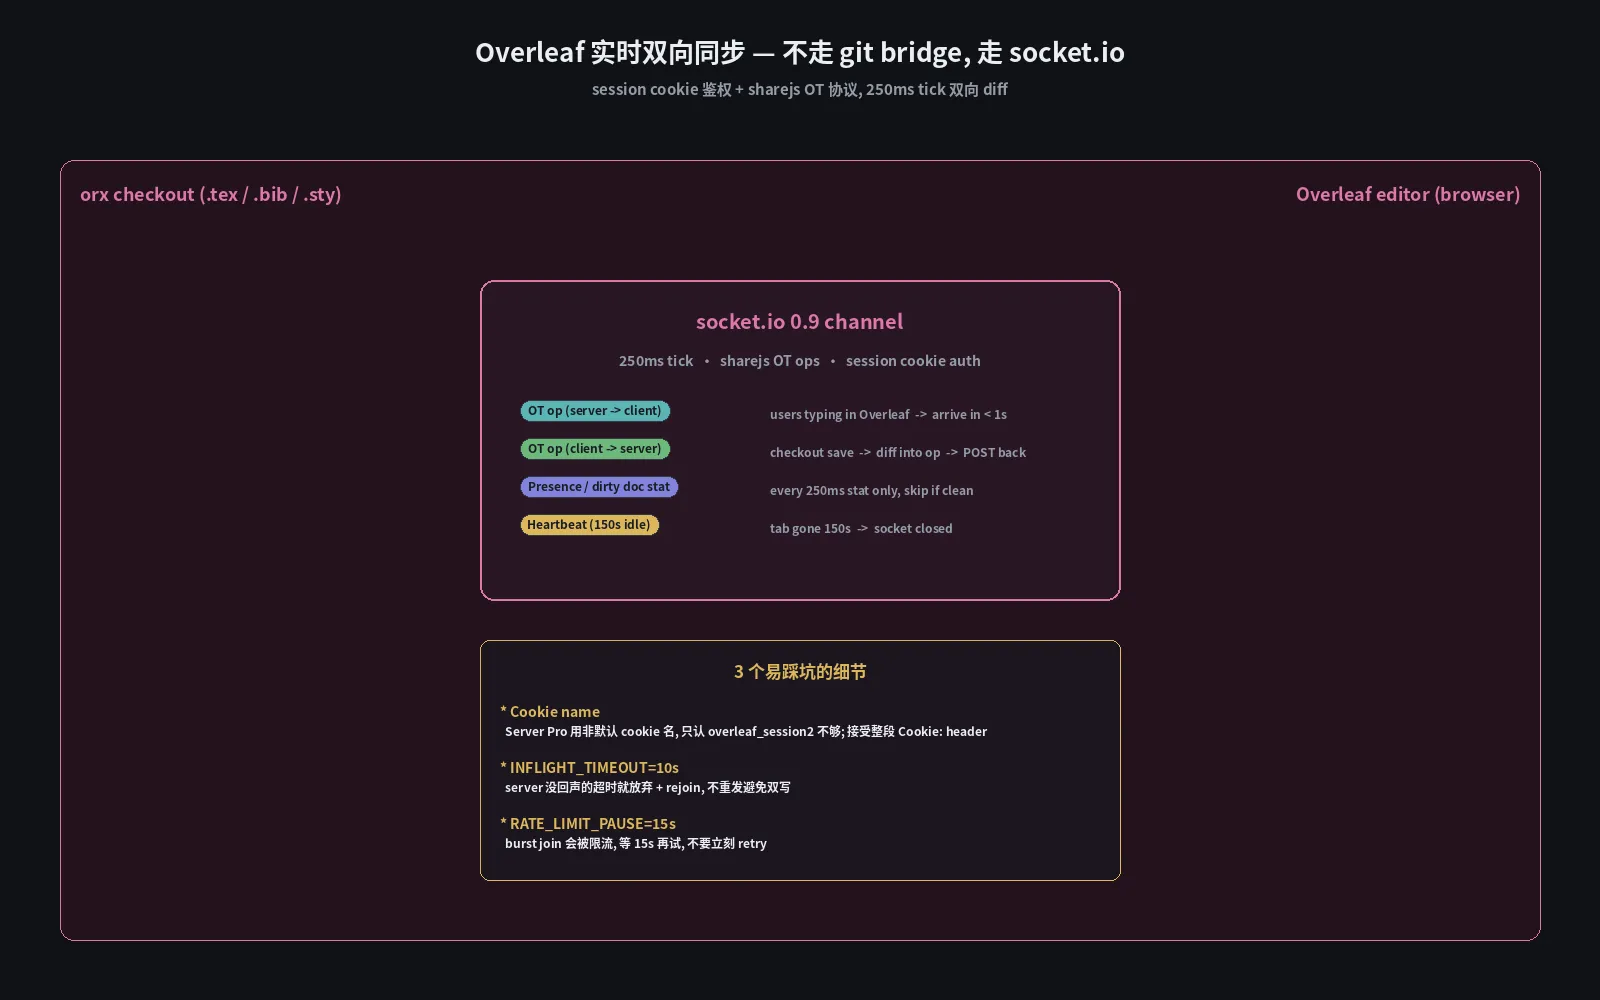
为什么这么做?官方解释在模块注释里:
The git bridge rate-limits anyone who asks often. This module speaks the channel Overleaf’s own editor uses, which has neither limit: a socket.io (0.9) connection that streams each document’s operational-transform ops as they happen.
换句话说:用户在 Overleaf 编辑器里敲的每一次 key,都通过这个 socket.io 通道推送 OT ops。orx 的 checkout 不需要等 git pull 就能拿到最新内容,反向也是——你在 orx 改文件,250ms tick 监测 dirty 文档,diff into op,POST 给 overleaf server。
6.1 三个边角 case 处理得特别干净#
- Cookie 兼容:
DEFAULT_COOKIE_NAME = "overleaf_session2",但用户可能给的是整段Cookie: foo=bar; baz=qux,或 Server Pro 的非默认 cookie 名。normalize_session接受所有常见形态,不动用户粘贴的格式。 - 不双写保证:每个本地 op 提交后,设一个
INFLIGHT_TIMEOUT=10s计时;超时没收到 server 回声 → 当作丢,重新 join 而不是重发。send-then-rejoin永远比resend-on-timeout安全,后者会产生冲突 ops。 - 限流退避:burst join 会被 Overleaf 限流(15s),代码硬等
RATE_LIMIT_PAUSE,不重试不报错,静默 backoff。MAX_BACKOFF=60s控制长失败上限。
整个模块 1K 行不到,但把 OT 这种分布式协议的 corner case 处理得比很多正式产品都细致。
6.2 跟 git bridge 的取舍#
Overleaf 官方提供的 git bridge 仍然是 orx 的默认(模块注释里叫它 crate::local::overleaf),适合 push-only 场景和”我不实时写论文,只想最终 sync 一次”。overleaf_live 是 opt-in 通道——orx overleaf-live start <project> 主动起。
两套机制共存,用户自己选。这是一种”default 安全 + 高级用户能开快车”的克制。
七、12 个 SKILL.md:Agent 的”操作手册”#
agent-skills/ 目录下 12 个 SKILL.md 文件,每个对应 agent 的一个工作场景:
orx-experiment-tree— 实验树规则(就是上面的 4 条 cardinal rules)orx-create— 创建实验的命令模板orx-paper— 论文写作工具链orx-lit-review— 文献检索(下面单独讲)orx-figures— 图表生成orx-git— git 操作纪律orx-fix— 修复 protocol
每个 SKILL.md 都是纯 markdown,无前置依赖——用户安装 orx 后,Claude Code / OpenCode 等 Agent 通过 skill install 流程把 SKILL.md 文件复制到 ~/.claude/skills/orx/ 等位置,然后 Agent 在 system prompt 里看到”想用 orx 工作流就 cat 这个 SKILL.md”。
为什么不直接写进 system prompt? SKILL.md 是 lazy load 的——System prompt 只放一句”调用 orx skill 加载完整手册”,避免每次 prompt 浪费 token 给一个 200 行 markdown。这种渐进披露是 Anthropic Skill 标准的设计,OpenResearch 直接 follow。
7.1 orx-lit-review:一个有意思的检索设计哲学#
orx-lit-review/SKILL.md 里的检索设计特别有”alphaXiv 自家”的味道:
Never delegate this loop to a sub-agent. You are the retrieval ranker. Call the alphaXiv, OpenAlex, and bioRxiv primitives yourself.
也就是说——文献检索 必须主 agent 亲自做,不能 spawn sub-agent。原因不是性能,是质量控制:sub-agent 拿到候选后会自作主张地筛掉”不相关”的,结果常常漏掉边缘相关、跨学科关键的论文。
接下来,主 agent 自己:
- 估算 difficulty 1-10,这个数字等于 follow-up rounds 的预算(1-3 → 0 轮 / 4-7 → 1 轮 / 8-10 → 2 轮)
- 一次确定 publication window 和 priority——每个 follow-up 都继承,不中途放宽窗口
- keyword 和 embedding 并行(不是先后),因为 keyword 的精确匹配能补 embedding 的语义盲区
- ranked results 不重试——空结果就报空,不重新跑同一个 query
这套设计把”科研文献检索”这种容易陷入”retrieval hell”(不断放宽 query 重试)的任务,预算化了——agent 不能无限重试,只能按 difficulty 配的预算做有限轮深挖。
八、Store 设计:14 张表,Runs / Chats / Projects 三类#
src/store.rs 5088 行,OpenResearch 的真数据层是 SQLite。关键表:
| 表 | 用途 |
|---|---|
runs | 每次 run 的元数据 + backend_json + source_* |
local_projects / local_experiments | 实验树节点 + slug + parent_experiment_id |
chat_sessions | 一次 chat session,持有 native_session_id 给 harness resume |
chat_messages | 用户/助手消息,parts JSON |
chat_turns | 一个 user message → 一个 turn 任务,持有 admission / leases |
chat_queued_messages | session 满了之后的排队 |
chat_run_wakeups | run 完成后 wakeup chat 的 notifier |
chat_spawns | spawn 状态机(idle / starting / ready / crashed) |
chat_turn_leases | turn 持有期间的心跳租约 |
data_dir_move_lease | 整个数据库迁位置时的全局锁 |
ssh_host_tests | 远端 SSH box 启动时的连通性测试记录 |
overleaf_links | Overleaf project ↔ 本地 checkout 绑定 |
ui_state | UI 面板的 persist state(workspace / file tab 等) |
8.1 data_dir_move_lease:非破坏性迁移是这个项目的另一个亮点#
src/local/datadir.rs 写了一个完整的 non-destructive move 流程:
The whole dir is a self-contained, relocatable unit, so a move is: validate target → checkpoint the DB → copy the tree (streaming byte progress) → verify → swap the persisted path in
settings.json→ delete the old copy.
旧目录在 verify 通过 + swap 完成之前不会被删——中断随时可恢复。一个真正的数据库迁移不走这种流程的话,90% 的概率会丢数据。
迁移前的验证报告也漂亮——返回 tree_bytes / free_bytes / same_filesystem 让 UI 提前告知用户”要 copy 多少 GB,目标盘够不够,要不要走瞬时 rename 代替 copy”。这种把不可能失败的操作的失败路径都显式化的写法,是 OpenResearch 的工程水准底线。
8.2 chat_turn_leases:防 turn 孤儿#
chat_turn_leases 表是 turn 进程的心跳租约——supervise 进程每 N 秒更新一次。机器宕机后 lease stale,reconcile_unfinished_turns (commands/up.rs:run) 启动时扫描 stale leases,重新调度没完成的 turn。
这是分布式系统里的 stale-leader 检测 + leader election,套到了单机 SQLite 上。OpenResearch 的 story 一直强调”本地单机”,但工程实现里它用分布式思路设计本地系统,所以单机也能扛崩溃。
九、UI 层:32K 行 TS / React,TanStack Router + xyflow#
UI 不是 orx 的核心,但是用户唯一会交互的部分,所以作者也花了大量力气。
- TanStack Router(
routeTree.gen.ts自动生成)——type-safe 路由,9 条主路由 - xyflow / React Flow——实验树画布
- React Query(
setScopedQueryData/useMutation/useQuery)——数据缓存 - Paraglide i18n——多语言,CI 有专门的
check-i18n.mjs保证翻译完整性 - CodeMirror 风格组件(
CodeEditor/CodeView/GitDiff)——内嵌编辑器,直接编辑 checkout 内的文件
UI 的”Side-by-side 三栏”(文件树 / 编辑器 / chat)是 GitHub Copilot Workspace / Cursor Composer 的同款,但集成度更深——文件树的节点直接对应 experiment 节点,改完直接挂 run。
Artifact 标签页能预览 run 输出的 figure / log / metrics;OverleafPanel 把实时同步的双向内容渲染到一个 Web view 里;HarnessSetupDialog 是新人 onboarding 的入口——第一次跑 orx up 时自动探测用户的 4 个 harness 哪个能用,弹一个配置对话框。
整个 UI 层 32K 行不算大——关键组件密度高,辅助代码密度低,作者没用 Ant Design / Material UI 这种重框架,自己写了一套 design token (ui/scripts/check-styles.mjs 保证统一)。
十、Supply chain hardening:这又是个细节大宝库#
.github/workflows/ci.yml 显示的 CI 不止”跑 test”,还有几条值得抄的:
- Localization catalogs:
node ui/scripts/check-i18n.mjs验证所有 i18n key 都有翻译 - Style tokens:
node ui/scripts/check-styles.mjs验证所有用到的 style token 都有定义 - UI typecheck + UI unit tests(
pnpm typecheck+node --test --experimental-strip-types ui/tests/*.test.mjs)——TS + 跑的 test 用 ESM strip-types cargo fmt --all --check+cargo clippy --all-targets -- -D warnings——Rust 端 linting 也是 CI 卡控的pnpm install --frozen-lockfile——不允许 lockfile 漂移Swatinem/rust-cache@v2——Rust build cache
发布用 cargo-dist 自动生成 .deb / .rpm / .msi / macOS DMG + SHA256,平台通吃。release-on-bump.yml 监听 conventional commit 的 feat: fix: 自动 bump 版本号。
release-macos-app.yml 还单独有一个 Mac App 商店发布流程——这是个”产品级 CLI”,不是 toy。
十一、能直接抄的 7 个工程模式#
最后,这份拆解不能止于”了解了什么”,要落地到”我下次写自己项目能用什么”。我列 7 个完全可复用的模式:
- Trait as extension point:4 个 harness 用一个 trait,加新 harness 不动 dispatch 代码。适合任何”多 vendor 适配”场景。
- Tagged union by string +
parse()入口:JSON 反序列化进BackendDescriptor,加字段不破坏历史。适合任何”配置文件 schema 演化”场景。 - Source archive digest 持久化:supervisor 重启不丢状态,机器迁移可恢复。适合任何”长时间 detached 任务”。
- SQLite + fd-lock + plain log 三件套:db 存元数据,log 存流式输出,锁防 supervisor 多开。适合任何”单机多任务调度器”。
- end-turn vs inline prompt 两套协议:通过
ResumeActionenum 让 chat host 永远只做一件事,具体怎么投回由 harness 自己负责。适合任何”代理多种第三方服务统一交互”场景。 - Non-destructive move via validate→copy→verify→swap→cleanup:数据目录迁移的标准动作,UI 提前显示 free bytes / needed bytes。适合任何”用户能改路径的本地存储”。
- SKILL.md 渐进披露:system prompt 只放 lazy load 提示,详细 manual 按需
cat。适合任何”系统 prompt 受限但功能多”的 Agent 产品。
十二、一些非显然的小细节#
orx_retry_delay用 turn_id 哈希做 deterministic jitter:同一 turn 的同一 retry 次数 sleep 时长永远一致,status 在 sleep 前一致(不让 UI 显示”等 5s”实际 sleep 7s)recovery_snapshot取最新 32KB UTF-8-safe 尾部:对话出错恢复时,只截最后 32KB 的对话历史给新 turn,避免 prompt 爆炸;UTF-8 safe (while !value.is_char_boundary(start)) 保证不切断 emojichat/messages广播用 75ms flush interval:流式 parts 频繁更新,但每个 frame 不能 db 写太频繁;最终 flush 永远无条件,保证落点不丢TOOL_TEXT_CAP=16000+ head/tail 双截:tool 输出超长时保留头尾各 ~8000 字符,加… [output truncated]marker;UI 也只展示前 20K,双重保险ALWAYS_REQUIRE_TOOL_TARGET_VALIDATION:tool 的target必须是 8 位十六进制或 36 位 UUID,避免 agent 把任意字符串塞进 tool call#[serde(skip_serializing_if = "Option::is_none")]在BackendDescriptor每个 Optional 字段上——JSON 不存空字段,parse 时缺字段 = None,加新字段不破坏老 rundetect_harness的 double check (registry().iter() + supports_chat):一个 harness 既要”在 registry”又要”声明支持 chat”才被选入 chat picker——detect撒谎了也能被 trait 兜住- Mac cluster mode (
cluster/mod.rs不在 src 里但 release 流程里有):一个 coordinator + 16 workers 跑 distributed inference,持久 TCP,一层 routed batch-union 一次 round-trip
结语#
OpenResearch 不是”又一个 Agent 框架”,它是研究工作流的运行时——把 Claude Code / Codex / OpenCode / Cursor 当成”可以调用的 substrate”,在上面搭实验树、训练编排、Overleaf 同步、文献检索,让 AI Agent 真正具备跑科研的能力。
它最值得借鉴的不是某个具体模块,是它那种”把每条不变量都显式化”的纪律—— git 分支、run command、source digest、cookie 名、retry jitter、lease heartbeat、window priority,所有”如果忘了做,用户就会丢东西”的边角都被写成代码 + 注释 + 测试。
这种纪律的源头我猜是 alphaXiv 自己做研究的痛苦——他们真的每天用这个工具跑 ML 实验,所以每个 bug 都会真实地打断自己的工作流;不是”做出来给别人用的产品”,是”做给自己用的工具,顺手开源”。
这种工具往往最扎实。
参考#
- 仓库: https://github.com/alphaXiv/OpenResearch ↗
- LICENSE: MIT
- 协议面: socket.io 0.9 (Overleaf) · JSON-RPC (Codex app-server) · stream-json (Claude) · HTTP+SSE (OpenCode serve)
- Cargo workspace 单 package,build 产物 ~50 MB (含 v2d 浏览器嵌入式)
- Rust 端 9.4 万行 / 114 个 .rs 文件;TS 端 3.2 万行 / 134 个组件