深入解析 YuE2:开源音乐生成 SOTA,一套 backbone 拿下 4.7 维质控 + 48kHz 立体声#
仓库:multimodal-art-projection/YuE ↗ · 3,800 行 Python · 13 个核心模块 · 1 套 checkpoint 顶起 create / cover / edit 三种用法 · Apache 2.0 + 模型各自 License · 2026-09-12 在 WildSongBench 拿到 6.9632 SOTA
音乐生成这件事过去两年一直有个心照不宣的层级:Suno / Udio 这类闭源产品靠不可编辑的端到端模型占据榜首,学术和开源在能听但不够”打”的水平徘徊。
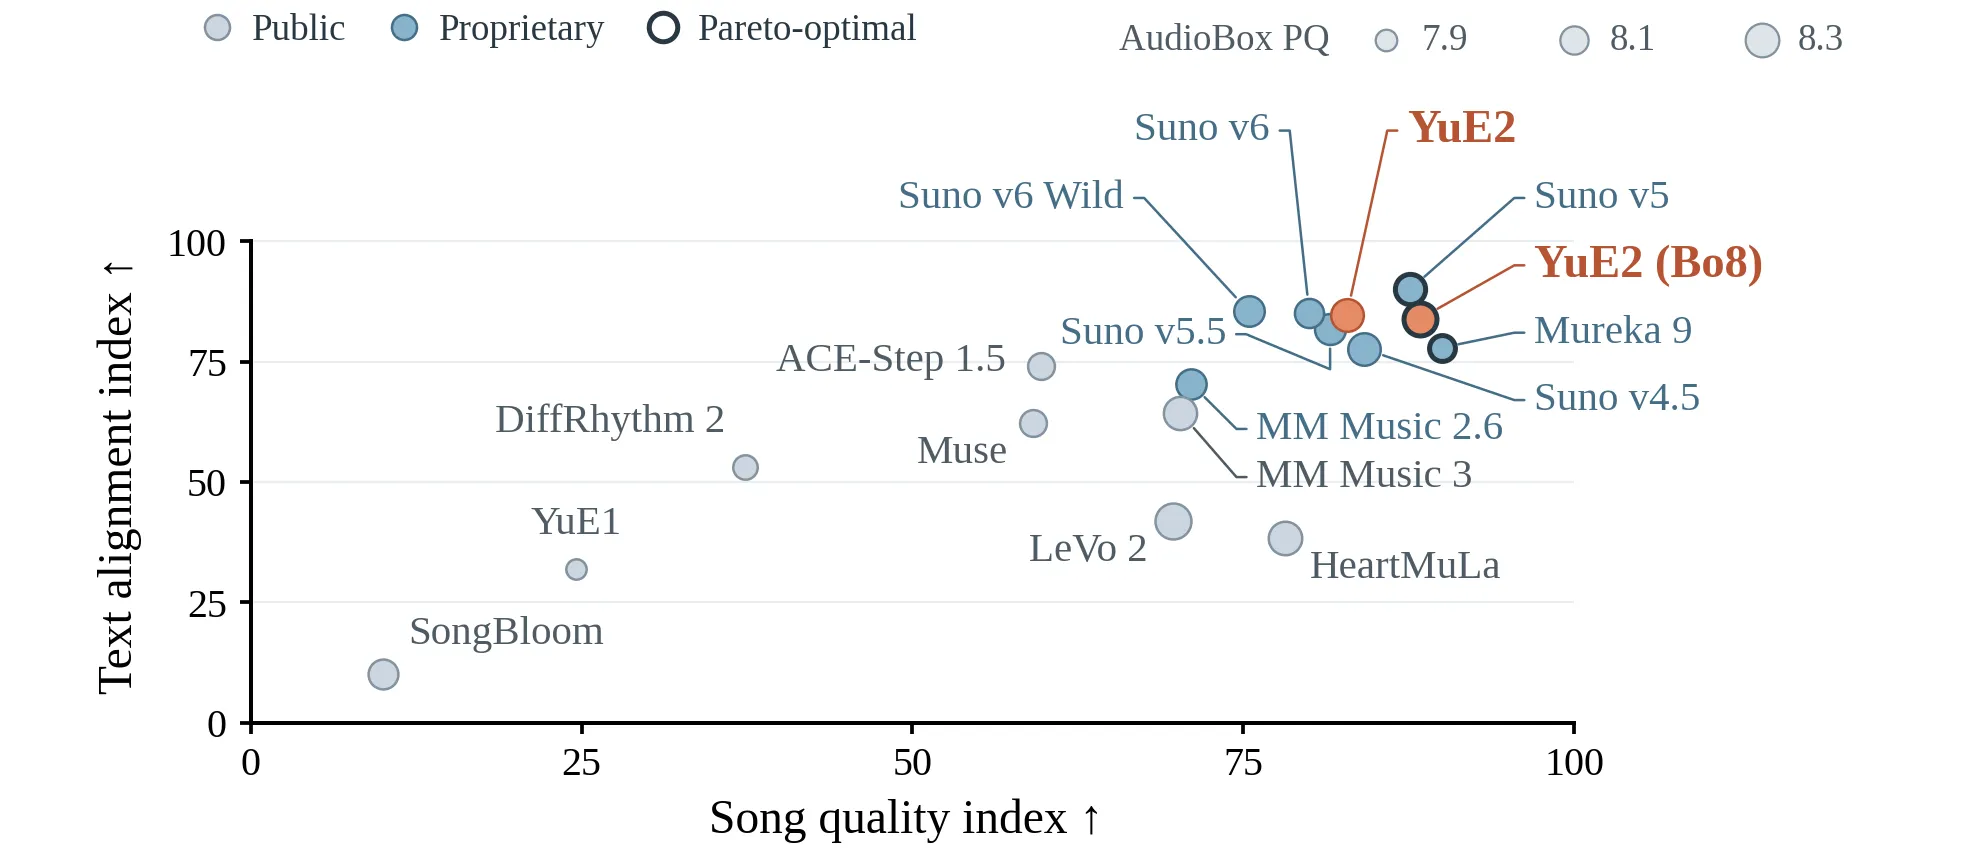
M-A-P(HKUST × 多家机构合作)2026-09 公开的 YuE2 把这个层级直接掀了——它在 WildSongBench ↗ 192 prompts × 17 settings 评测中,best-of-8 拿到 6.9632 SongBench Avg,超过 Mureka 9(6.9377)、Suno v5(6.8721)、Suno v5.5(6.7150)、Suno v4.5(6.6995)、Suno v6(6.5562),成为公开榜单一哥。
而这一切只靠 一个 3B 参数的 backbone。
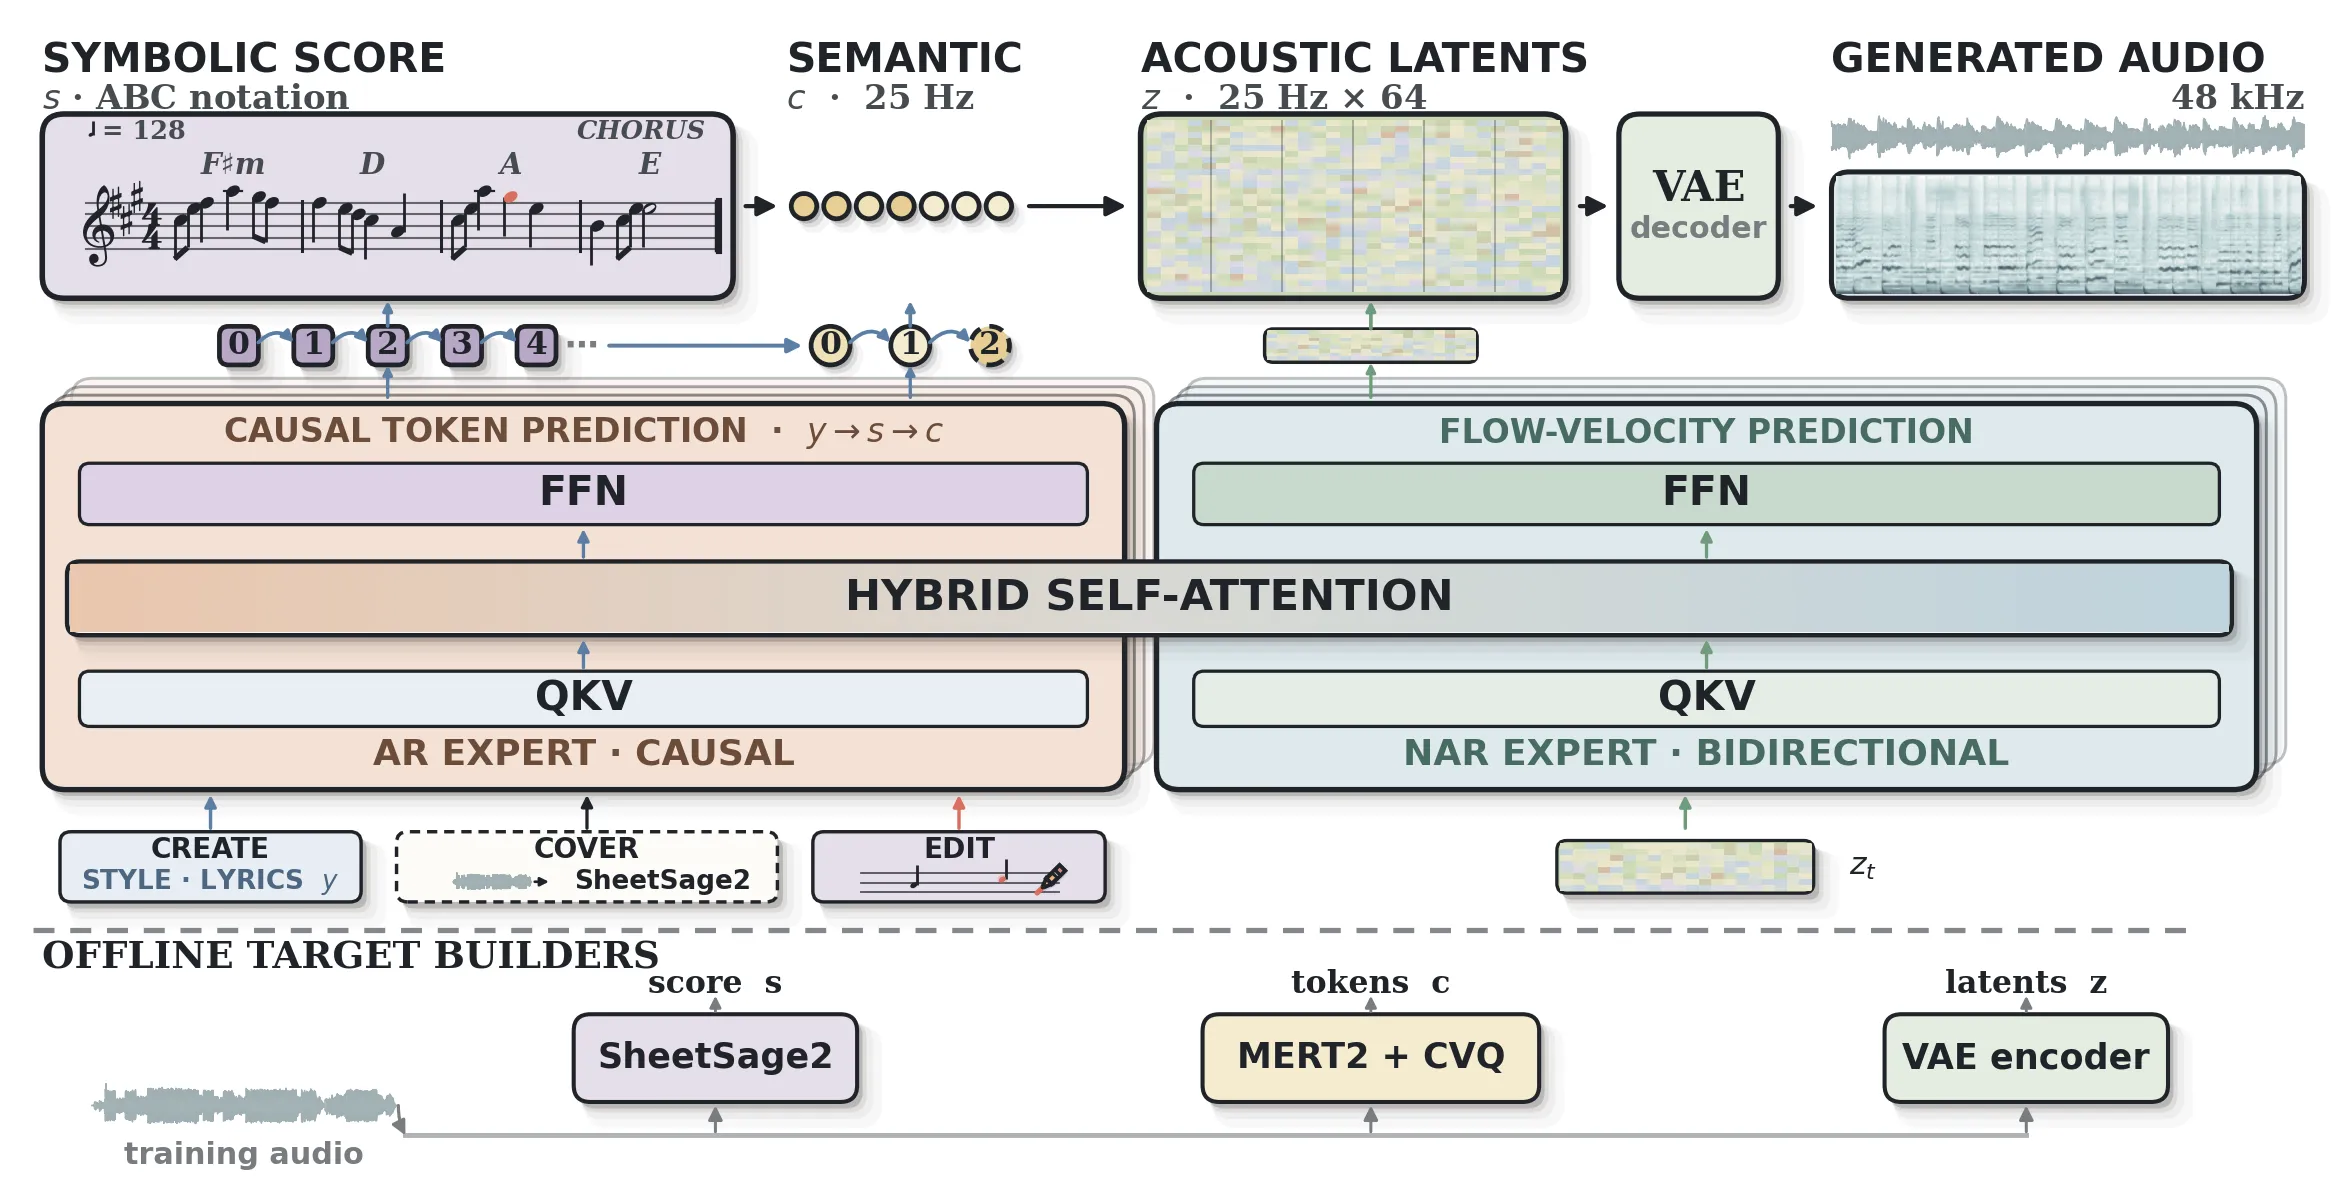
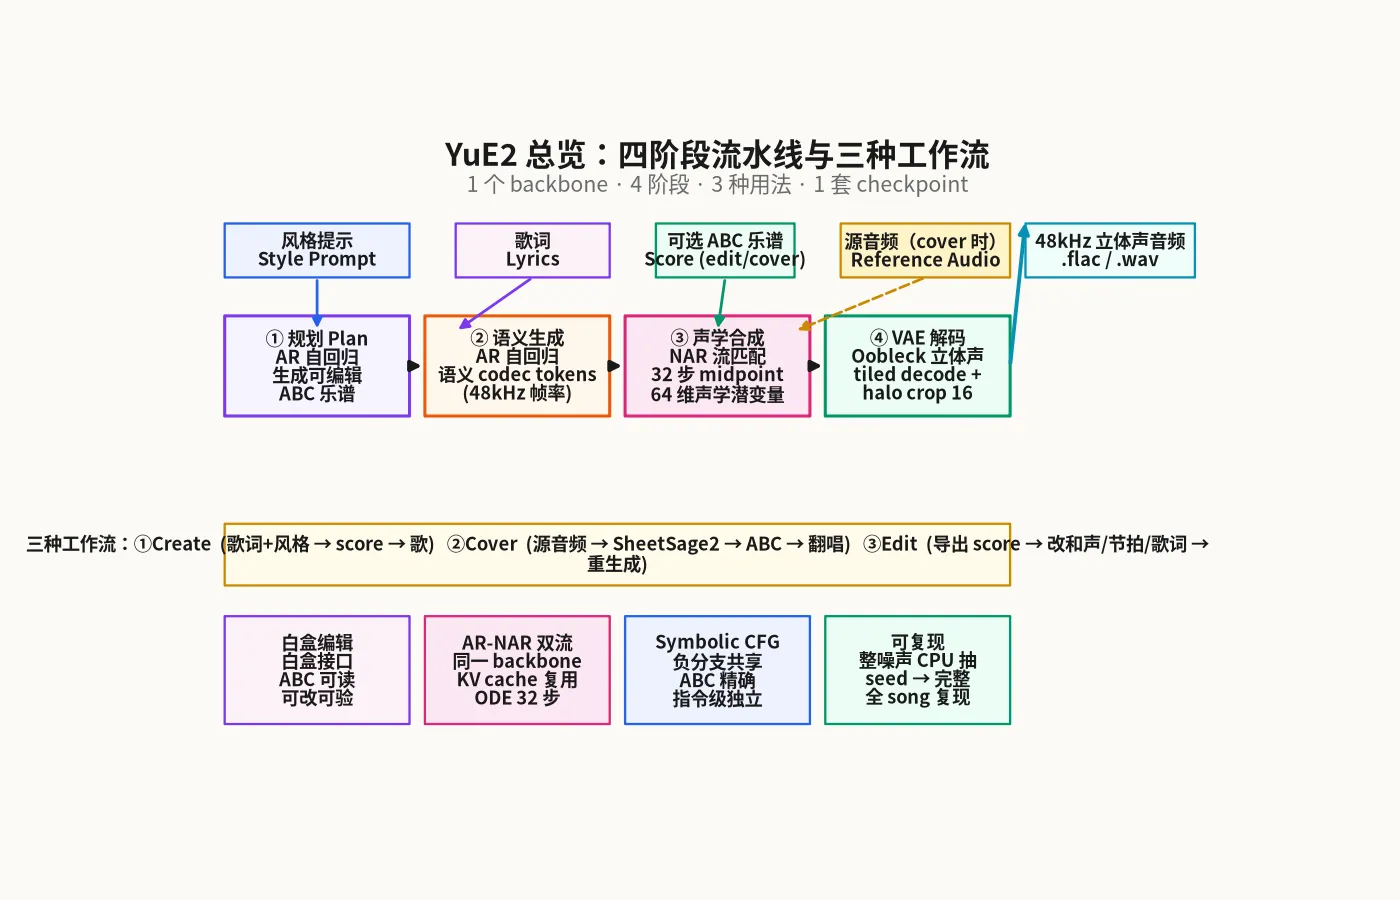
YuE2 不是”又一个音乐 LLM”。它把这件事拆成了 4 个独立但串联的阶段——Plan(生成可编辑 ABC 乐谱)→ Semantic(生成语义 codec tokens)→ Synthesize(NAR 流匹配出 64 维声学潜变量)→ Decode(Oobleck VAE 解码到 48kHz 立体声)——并且让”白盒编辑”成为 first-class 公民:你可以改和声、改节拍、改歌词、改结构,然后让模型用同一套 checkpoint 重新渲染。
这意味着:音乐生成第一次有了”可被阅读、可被改写、可被 diff”的接口。
一、仓库全貌:2MB 装下 3,800 行 + 9 SKILL + 1 个 pipeline#
YuE2 仓库本身极小——压缩后 2MB,79 个文件,主分支 main 直接是 YuE2。v1 在独立 v1 分支。
YuE/
├── src/yue2/                ← 13 个 Python 模块,3,785 行
│   ├── protocol.py          ← 词表常量、CFG、prefix 构造、chunk 切分
│   ├── pipeline.py          ← YuE2Pipeline:plan→semantic→synthesize→decode
│   ├── modeling_yue2.py     ← YuE2ForCausalLM:3B Transformer + GQA + RoPE
│   ├── nar.py               ← CachedNAR:AR prefill + 32 步 midpoint ODE
│   ├── modeling_vae.py      ← Oobleck VAE(来自 stable-audio-tools)
│   ├── sampling.py          ← AR 自回归采样 + synchronize
│   ├── tokenization_yue2.py ← Qwen2 tokenizer 包装
│   ├── storage.py           ← 模型解析、hash 校验、manifest
│   ├── quantization.py      ← FP8 量化(AR 头)
│   ├── progress.py          ← 进度输出
│   ├── fast.py              ← vLLM backend
│   └── ...
├── skills/yue2-music/       ← 16 个文件,1 个 SKILL 包
├── docs/                    ← benchmarks / generation / covers / editing
├── examples/                ← song.json + score.abc + score-jazz.abc
├── assets/                  ← architecture.png / frontier-teaser.png / logo
└── README.md ← 论文式长 README核心套路是”少而精”——所有模型逻辑都在一个 src/yue2/ 目录下,pipeline 是入口、protocol 是数据结构、modeling_yue2 是架构、nar 是声学合成、modeling_vae 是音频解码。每个模块平均 300 行,单文件最长 nar.py 261 行。
这和动辄几十个 package、几万行的”AI 音乐研究代码”形成鲜明对比。3,800 行的 YuE2 能跑出 SOTA,说明音乐生成的算法已经收敛到一组稳定的范式上——剩下的工程问题是”这组范式怎么干净地实现”。
YuE2 暴露给用户的接口也只有三条路:
| 请求 | 工作流 |
|---|---|
| 用风格+歌词生成可编辑乐谱的歌 | cot="full" → ABC → song |
| 翻唱一段音频 | SheetSage2 → ABC → cot="melody" |
| 改和声/节拍/歌词/段落 | 导出 plan → 改 score.abc → 调同一 pipeline 重生成 |
没有”再训练一个 LoRA”、“再切一个 checkpoint”这种重活——白盒接口让”微调”被”编辑”取代。
二、四阶段流水线:把”音乐生成”拆成可独立调用的 4 个函数#
阶段 ① 规划 Plan:AR 自回归生成 ABC 乐谱#
第一阶段输入是 style(风格提示,比如 “English, warm piano pop, expressive female voice”)+ lyrics(带 [Verse]/[Chorus] 标签的歌词),输出是 可被人阅读的 ABC 乐谱。
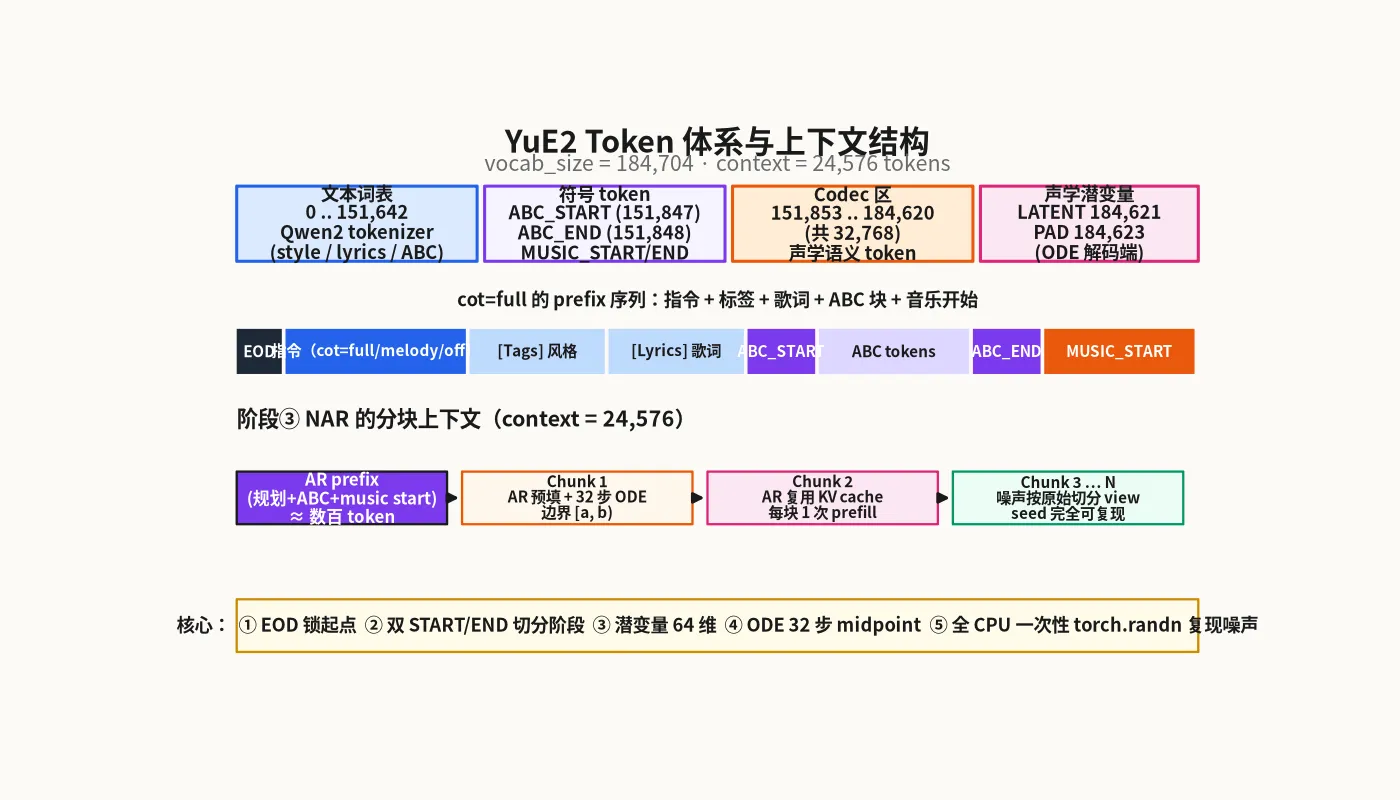
ABC 是一种简洁的文本乐谱格式(X:1\nT:Title\nM:4/4\nK:C\n|:C D E F|),每个 token 大约 1-3 个字符。YuE2 用自己的 tokenizer 把 ABC 切成 0..151,642 的整数序列,外加 151,847/151,848 作为 ABC_START/ABC_END 边界 token。
# src/yue2/protocol.py
ABC_START = 151847
ABC_END = 151848
MUSIC_START = 151849
MUSIC_END = 151850
CODEC_OFFSET = 151853   # 声学 codec 从这里开始
CODEC_SIZE = 32768
CONTEXT = 24576plan() 内部会按 cot 参数决定是否真生成 ABC:
cot="full":模型自回归生成完整乐谱(含旋律 + 和弦符号)cot="melody":用户/SheetSage2 提供 ABC,模型只生成 melodycot="off":跳过 ABC,prefix 直接进入语义阶段
SymbolicPlan 是一个 dataclass,保存原始 abc 文本、abc_ids 整数序列、prefix token 列表,外加一个 plan_manifest.json 写每文件的 SHA256——这就是”白盒”的物理基础:plan 是一份可校验、可版本化、可被外部编辑的文件。
# src/yue2/pipeline.py
@dataclass
class SymbolicPlan:
    request: SongRequest
    abc: str | None
    abc_ids: list[int]
    prefix: list[int]
    timing: dict = field(default_factory=dict)
truncated: bool = FalseSymbolicPlan.load() 在恢复时逐字段核验 SHA256 + 比对 abc_ids / prefix 数组——任何改动都会被检测出 “Saved plan changed; supply modified ABC as an external planner input”。
阶段 ② 语义生成 Semantic:AR 自回归生成声学 codec tokens#
第二阶段输入是 plan + MUSIC_START token,输出是声学 codec token 序列。
codec 区从 151,853 到 184,620(共 32,768 个)——这是 YuE2 的”声学语言”。每个 codec token 对应一个 48kHz 帧的语义摘要,类似 SoundStream / EnCodec 的 RVQ 第一层。
generate_semantic() 调用 _generate(),对每个 token 做 AR 采样:
temperature、top_p、top_k、repetition_penalty都在Sampling里- 负分支(CFG 用)和正分支共享同一份 ABC prefix,但负分支只带”指令级”信息,不带 ABC 内容(
cot="off"时甚至连 ABC 都没有) stop_token_id用MUSIC_END = 151850截断
# src/yue2/protocol.py 关键 token
def token_prefixes(request, tokenizer, abc_ids=None):
    """构造完整 prompt: EOD + 指令 + [Tags] + [Lyrics] + ABC_START + abc + ABC_END + MUSIC_START"""
    ...
    if abc_ids is not None:
        return text_ids + [ABC_START] + abc_ids + [ABC_END, MUSIC_START]
return text_ids + [ABC_START, ABC_END, MUSIC_START] # off 模式注意 truncation:如果 cfg_negative="same_instruction_and_exact_abc",负分支必须包含与正分支完全相同的 ABC token ID 序列——这是”symbolic CFG”的硬约束:CFG 在符号层是精确的,不会因为采样漂移让 ABC 走样。
阶段 ③ 声学合成 Synthesize:NAR 流匹配 + 32 步 midpoint ODE#
第三阶段是 YuE2 架构上最精巧的一段:把语义 codec tokens 还原成 64 维声学潜变量。
nar.py 里的 CachedNAR 是一个把”AR cache 复用 + ODE 求解 + 显存 offload”打包的类:
# src/yue2/nar.py 核心
def song_chunks(prefix, codec, seed, context=CONTEXT):
    """一次性画完整噪声 [len(codec), 64],再按历史切点 view。
    → 整个 song 共享同一份 seed,可完整复现。"""
    ranges = chunk_ranges(len(codec), len(prefix), int(context))
    generator = torch.Generator(device="cpu").manual_seed(int(seed))
    noise = torch.randn((len(codec), 64), dtype=torch.float32, device="cpu", generator=generator)
    return [Chunk(prefix + [value + CODEC_OFFSET for value in codec[a:b]] + [MUSIC_END], noise[a:b])
for a, b in ranges]这段代码是 YuE2 工程上最值得抄的一个点——它没有逐 chunk 重新抽样噪声(那样 seed 就废了),而是先一次性在 CPU 用 FP32 抽完整份 noise tensor,再按 chunk_ranges 切点拿 view。这等价于”全 song 共享一份 RNG 状态”,任何位置的中断/重启都能完美继续。
每个 Chunk 在 CachedNAR._prefill() 时跑一次 AR:
- 把当前 chunk 的
prefix + codec[a:b] + MUSIC_END送进 backbone 的 28 层 - 只保存每一层 K/V 投影的
[0, :visible_length]部分作为 cache visible_length默认是ar_length(全可见),但当nar_cond_end设定时只暴露部分 prefix(用于条件生成)
velocity() 是真正的 NAR 前向:把当前 ODE 状态 state [T, 64] pad 一帧后送进 vae2llm,加上 time_embedder(shifted_t) 和 latent_pos_embed,再让每一层的 nar_self_attn cross-attend 到 AR cache,最后 llm2vae 投影回 64 维。
# 32 步 midpoint ODE,dt=1/32
for step in range(steps):
    t = 1.0 - step * dt
    raw = logit(t).clamp(-20, 20)   # 时间重参数:logit(t) 提升低 t 时的分辨率
    first = self.velocity(state, raw)
    mid = state - first * (dt / 2)
    raw_mid = logit(t - dt / 2).clamp(-20, 20)
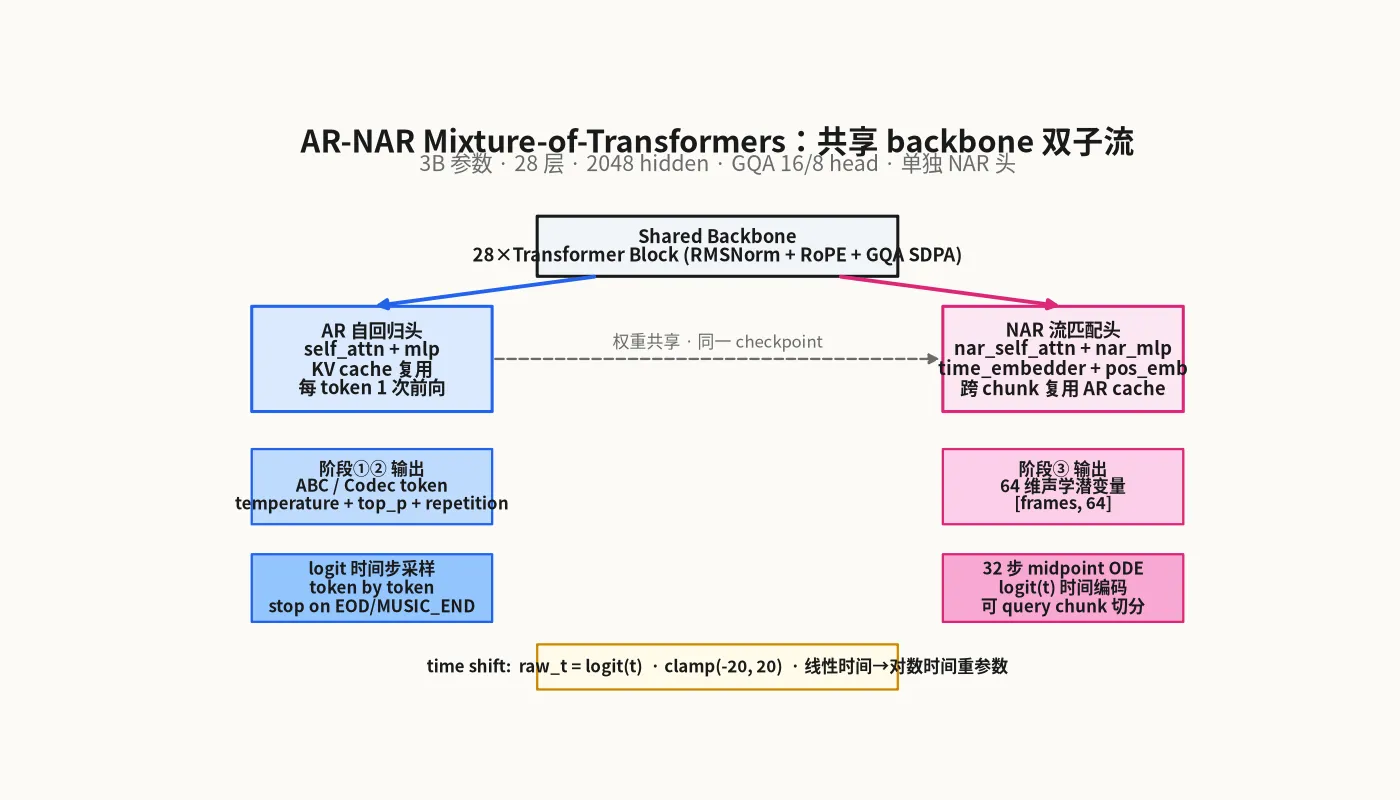
state = state - self.velocity(mid, raw_mid) * dtraw = logit(t) 这个细节很关键——线性时间在 t 接近 0/1 时梯度极小,对数时间让”清噪声”和”加细节”两端的 ODE 步长都合理。很多流匹配论文(Stable Audio 3、SoundStorm)都用过同样的 trick。
_offload_ar() 是个省显存的彩蛋:当 offload_ar=True 时,它把 AR 头(embed_tokens、lm_head、28 层的 self_attn/mlp)临时搬到 CPU,NAR 阶段独享 GPU。finally 块保证回迁,即使中断也不漏。
阶段 ④ VAE 解码:Oobleck 立体声 + tiled decode + halo crop#
最后一阶段是 Oobleck VAE——一个来自 stable-audio-tools ↗ 的开源架构(MIT + Apache 2.0,注意 THIRD_PARTY_NOTICES 里 Stability AI 和 NVIDIA 各自的版权声明)。
关键设计:
- 完整 FP32 解码(
vae_dtype="float32"),不做量化 - tiled decode:把
[T, 64]潜变量切成core_frames大小的块(≤12GiB 显存 → 512 帧,否则 1024 帧) - halo 16 帧重叠 + 边缘丢弃:保证块边界连续,没有接缝噪声
- SnakeBeta 激活(
x + sin²(xα)/β,α 和 β 都可学习)替代 Snake - weight_norm 1D conv(来自
torch.nn.utils.weight_norm)
# src/yue2/modeling_vae.py 核心结构
class ResidualUnit(nn.Module):
    def __init__(self, in_channels, out_channels, dilation, act_type):
        ...
        # SnakeBeta → WNConv1d (dilation) → SnakeBeta → WNConv1d (1x1)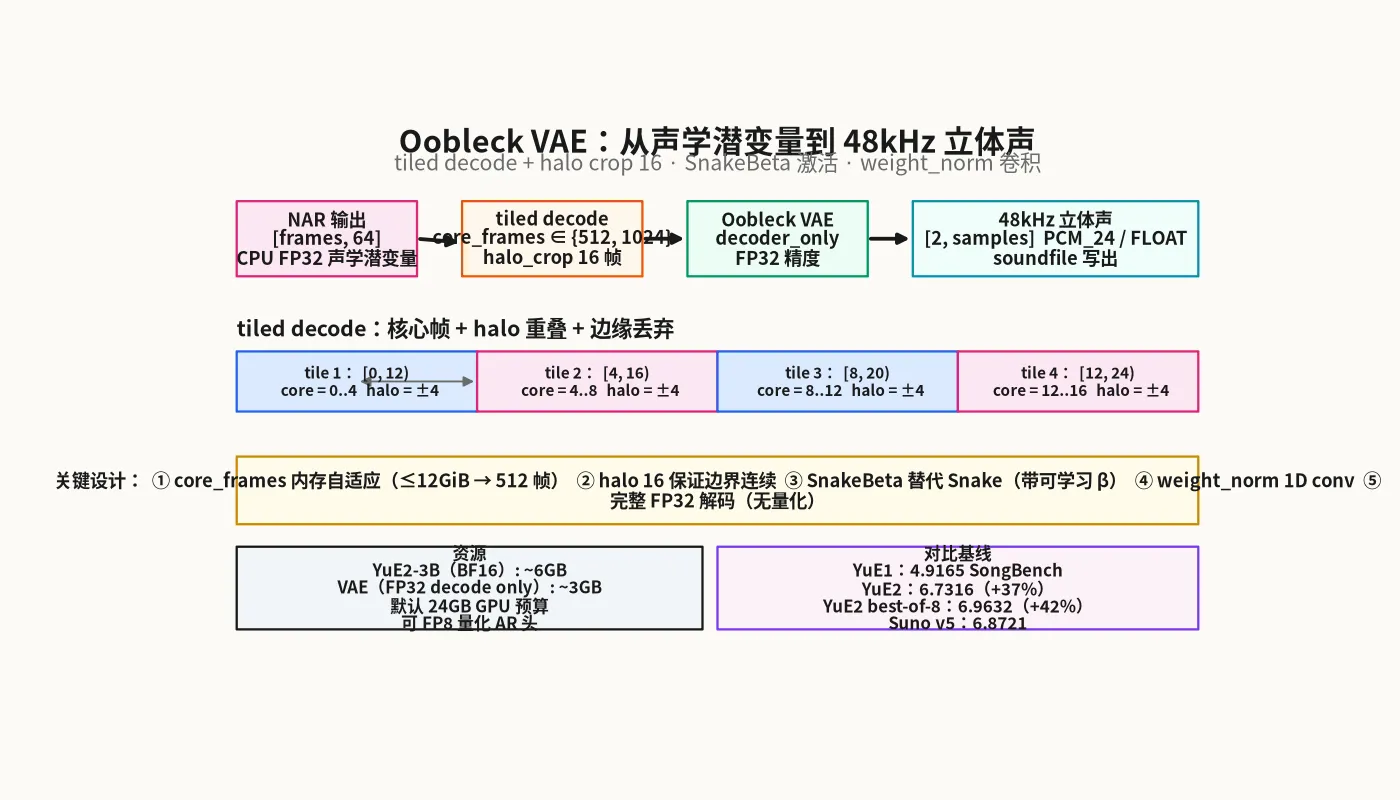
pipeline.decode() 在切块时打印进度,进度回调不会引入 device sync——这是少见的”准确报告”实现:
# src/yue2/pipeline.py
def decode(self, latents, *, full=False, vae=None):
    ...
    tiles = 1 if full else (z.shape[-1] + self.vae_core_frames - 1) // self.vae_core_frames
    with self._status("Decoding audio", total=tiles, unit="chunks") as status:
        report = (lambda completed, total: status.update(completed, total=total)) if self.progress else None
        with torch.inference_mode():
            audio = model.decode_tiled(z, core_frames=self.vae_core_frames, halo_frames=16,
                                       output_device="cpu", on_progress=report)
return audio[0].float().clamp(-1, 1).T.contiguous().numpy()最后 soundfile 写 .flac(PCM_24)或 .wav(FLOAT)——MP3 是可选的外部交付转换,不在 pipeline 范围内。
三、3B AR-NAR 共享 backbone:Mix-of-Transformers 的极简实现#
YuE2 的 3B 参数 backbone 完全 self-contained,不依赖任何第三方 CUDA 扩展——所有 attention、RoPE、RMSNorm 都自己用 PyTorch 重写。
# src/yue2/modeling_yue2.py - YuE2Config 关键参数
class YuE2Config(PretrainedConfig):
    model_type = "yue2"
    def __init__(self, *,
        hidden_size: int = 2048,
        num_hidden_layers: int = 28,
        num_attention_heads: int = 16,
        num_key_value_heads: int = 8,    # GQA 2:1 压缩
        head_dim: int = 128,
        intermediate_size: int = 6144,
        vocab_size: int = 184704,         # 文本+Qwen 词表+ABC+声学 codec
        rms_norm_eps: float = 1e-6,
        rope_theta: float = 1000000.0,
        max_position_embeddings: int = 24576,  # 24K context
        latent_type: str = "vae",
        latent_dim: int = 64,             # 声学潜变量维度
        max_latent_frames: int = 24576,
        timestep_shift: float = 1.0,
):28 层 × 2048 hidden × 16 attention heads(KV 头 8 个,GQA 压缩 2:1),总共大约 3B 参数——和 Llama 3.2-3B 同量级。
自己的 GQA + RoPE + SDPA#
# src/yue2/modeling_yue2.py
def sdpa(query, key, value, *, attn_mask=None, is_causal=False):
    """Use native grouped-query attention, including a portable MPS fallback."""
    grouped = query.shape[1] != key.shape[1]
    if grouped and query.device.type == "mps":
        # PyTorch's MPS attention does not implement enable_gqa on every release.
        groups = query.shape[1] // key.shape[1]
        key = key.repeat_interleave(groups, dim=1)
        value = value.repeat_interleave(groups, dim=1)
        grouped = False
    return F.scaled_dot_product_attention(
        query, key, value, attn_mask=attn_mask, is_causal=is_causal,
        enable_gqa=grouped,
)MPS fallback 这段代码很值得看——MPS 设备的 SDPA 在 PyTorch 早期版本不实现 enable_gqa,YuE2 直接在调用前把 K/V repeat_interleave 2 次把 GQA 退化成 MHA。这种”为一种不支持的设备准备一份 fallback”的做法在 HuggingFace 风格的模型里很罕见,大多数项目选择”不支持就别用”。
AR 头 vs NAR 头:同一 backbone,不同投影#
# 同一层里同时有 AR 和 NAR 两个 attention
class YuE2Layer(nn.Module):
    def __init__(self, config):
        super().__init__()
        self.input_layernorm = RMSNorm(config.hidden_size)
        self.self_attn = Attention(config)         # AR 头
        self.post_attention_layernorm = RMSNorm(config.hidden_size)
        self.mlp = ...
        # NAR 头独立一套 norm + attn + mlp
        self.nar_input_layernorm = RMSNorm(config.hidden_size)
        self.nar_self_attn = Attention(config)    # NAR 头
        self.nar_pre_mlp_layernorm = RMSNorm(config.hidden_size)
self.nar_mlp = ...AR 和 NAR 共享 backbone.layers 的 QKV/O 投影权重,但各自有独立的 layernorm 和 MLP——这是 “Mixture-of-Transformers” 的极简实现,比 Magenta/MusicGen 的”双 Transformer 完全独立”省了一半参数。
但这带来一个工程细节:NAR cache 必须存 K/V 投影后的 tensor,不是隐藏状态。所以 CachedNAR._prefill 显式逐层调用 layer.self_attn.project_qkv:
# src/yue2/nar.py
@torch.inference_mode()
def _prefill(self):
    backbone = self.model.model
    ids = torch.tensor([self.chunk.ar_tokens], dtype=torch.long, device=self.device)
    positions = torch.arange(self.ar_length, device=self.device)[None]
    cos, sin = backbone.rotary_emb(positions)
    x = backbone.embed_tokens(ids)
    for layer in backbone.layers:
        q, k, v = layer.self_attn.project_qkv(layer.input_layernorm(x), cos, sin)
        # Clone only for restricted visibility; a slice would retain the
        # storage of invisible codec tokens for every layer.
        cached = (k[0, :self.visible_length], v[0, :self.visible_length])
        if self.visible_length != self.ar_length:
            cached = tuple(t.clone() for t in cached)
        self.cache.append(cached)
        h = self._attention(q[0], k[0], v[0], causal=True)
        x = x + layer.self_attn.o_proj(h.flatten(1)[None])
x = x + layer.mlp(layer.post_attention_layernorm(x))注释里那句 “a slice would retain the storage of invisible codec tokens for every layer” 写得很细——它指的是:如果用 k[0, :n] 而不是 tuple(t.clone() for t in cached),slice 共享底层 storage,NAR 阶段每层都会偷偷保留完整 K 的引用,显存爆炸。
这种 “code comment 即文档” 的风格是 YuE2 工程的另一个特征——nar.py 里到处是 “Why not X / Why we chose Y” 的解释(# Query tiling changes temporary storage, never the visible key set. 等),对二次开发者极其友好。
四、Symbolic CFG:让”白盒编辑”和”采样控制”不打架#
classifier-free guidance(CFG)在文生图里几乎是标配(output = uncond + s * (cond - uncond)),但在音乐生成里有个独特的痛点:
你的 ABC 乐谱是人写好的,不能因为 CFG 公式里”uncond 减去”就把音符搞漂移。
YuE2 的解法是 Symbolic CFG:
| 模式 | 正分支 prefix | 负分支 prefix | CFG scale |
|---|---|---|---|
cot="full" | EOD + 指令 + [Tags] + [Lyrics] + ABC + MUSIC_START | EOD + 指令 + ABC_IDS + MUSIC_START | 1.0 |
cot="melody" | EOD + 指令 + [Tags] + [Lyrics] + 外部 ABC + MUSIC_START | EOD + 指令 + 外部 ABC_IDS + MUSIC_START | 1.0 |
cot="off" | EOD + 指令 + [Tags] + [Lyrics] + MUSIC_START | EOD + 指令 + MUSIC_START(不带 ABC) | 1.01 |
注意 cfg_negative 的取值在 effective_config() 里被叫做 "same_instruction_and_exact_abc" 或 "instruction_only"——CFG 的负分支不是”无指令”,而是”同一份 ABC + 同样指令”:
# src/yue2/pipeline.py
def effective_config(self, request, abc_sampling=None, semantic_sampling=None):
    config = self.generation_config.to_dict()
    ...
    return {"generation": config, "overrides": overrides,
            "cot": request.cot, "cfg_scale": request.guidance,
            "cfg_negative": "instruction_only" if request.cot == "off" else "same_instruction_and_exact_abc",
"backend": self.backend, "quantization": self.quantization, ...}这种设计的效果是:CFG 只调整”风格强度”和”指令跟随度”,不会动 ABC。你在阶段 ① 写了什么和声,阶段 ② 输出的声学 tokens 一定会包含对应的和声。
完整编辑回路#
把上面这套串起来就是 5 步白盒编辑:
# 1. 生成(保留所有可复现工件)
python skills/yue2-music/scripts/run_yue2.py generate --request song.json --output outputs/orig
# outputs/orig/ 里有:
#   score.abc          ← 可读的 ABC 乐谱
#   audio.flac         ← 48kHz 立体声
#   plan.json          ← plan 内容 + timing
#   plan_manifest.json ← 每文件 SHA256
#   result.json        ← 完整 run 配置 + 哈希链

# 2. 编辑(人工/Agent 改 score.abc,比如把和弦从三和弦改成七和弦)
cp outputs/orig/score.abc outputs/jazz/score.abc
# 手动改 ...[CEG]  → ...[C7 E7 G7] 等
python skills/yue2-music/scripts/abc_tools.py compare \
  outputs/orig/score.abc outputs/jazz/score.abc
# match: true  ← 强制 notes / timing / meter / tempo 不变

# 3. 重生成(用同一份 pipeline 重新跑)
python examples/generate.py --abc-file outputs/jazz/score.abc \
  --cot full --output outputs/jazz

# 4. 对比(同一 baseline 的两个 flac,听感 + SongBench 5 维度)
ls -lh outputs/orig/audio.flac outputs/jazz/audio.flac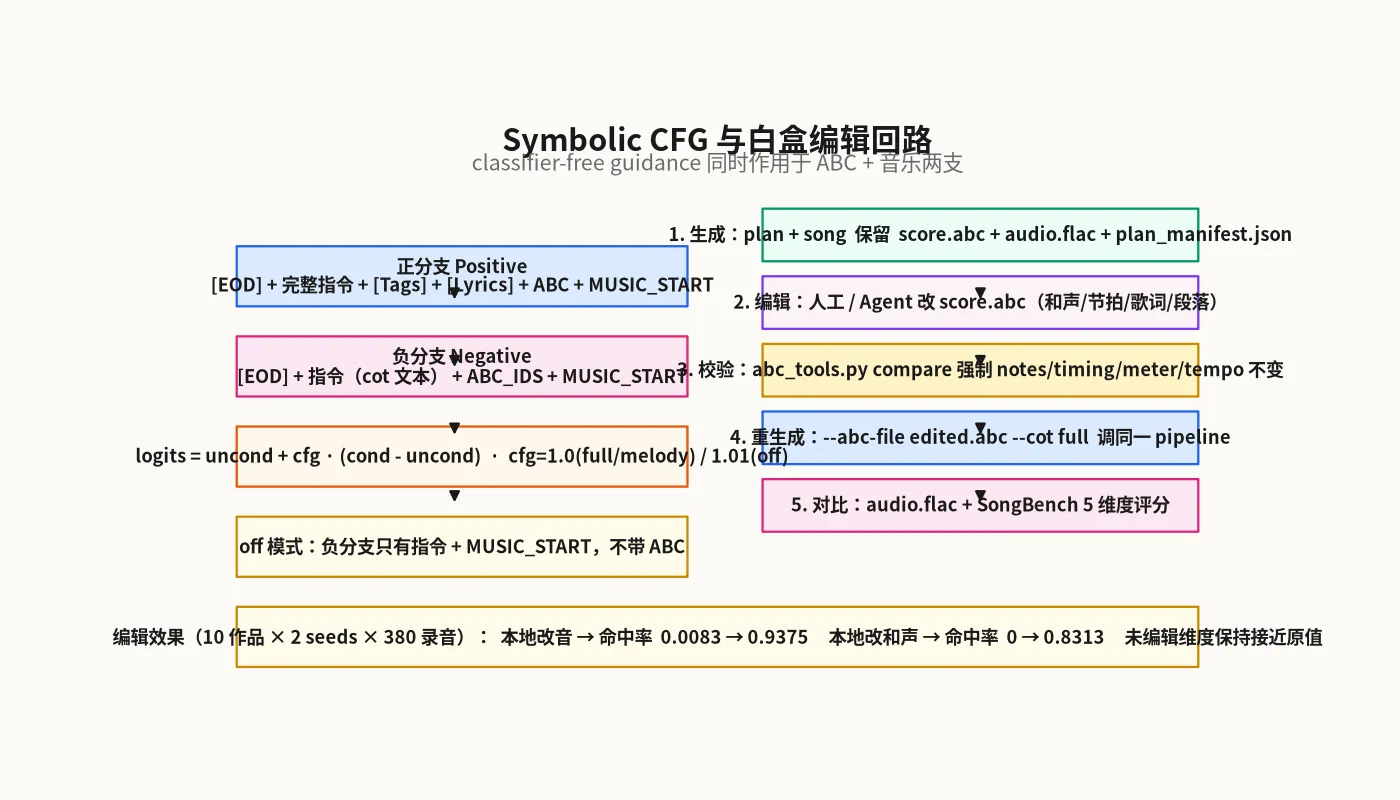
这是 YuE2 最被低估的资产——它把”模型权重”和”音乐资产”分开了:
- 权重是不变的 checkpoint,可下载、可复现
- 资产是可 fork 的 ABC 文件,可以 PR、可以版本管理、可以 A/B test
- 生成是幂等函数
f(style, lyrics, abc, seed) → audio
一个开发者改了一处和声,不需要重训模型——git commit 一份 ABC,CI 跑一次生成,对比 metric,决定 merge 还是 revert。
实际编辑效果:命中率从 0.0083 → 0.9375#
10 作品 × 2 seeds × 380 录音的对照研究(docs/editing.md ↗)显示:
- 改音:命中率 0.0083 → 0.9375
- 改和声时长:命中率 0 → 0.8313
- 未编辑维度:自动评分接近未编辑
这些数字的含义是:YuE2 的 score conditioning 不是”摆设”——它真的能让模型精确执行”把第 3 小节第 2 拍的 F 改成 F#,其他全不动”。
五、WildSongBench:6.9632 SOTA,但读数字要看上下文#
YuE2 在 2026-09-12 的 WildSongBench 评测上拿到了开源榜单第一。完整 192 prompts × 17 settings 的成绩单(来自 docs/benchmarks.md):
| Setting | SongBench Avg ↑ | SB Musicality ↑ | SongEval Avg ↑ | AudioBox PQ ↑ | MuLan ↑ | AllMusicCaps ↑ | Q3O ↑ | PER ↓ |
|---|---|---|---|---|---|---|---|---|
| YuE2 (best-of-8) | 6.9632 | 6.2666 | 4.2960 | 8.2714 | 0.5051 | 0.3980 | 4.7009 | 9.79% |
| Mureka 9 | 6.9377 | 6.0488 | 4.4111 | 8.0226 | 0.4394 | 0.4102 | 4.6368 | 11.69% |
| Suno v5 | 6.8721 | 5.9918 | 4.3579 | 8.1698 | 0.5428 | 0.4353 | 4.5907 | 8.10% |
| YuE2 | 6.7316 | 5.9075 | 4.2625 | 8.2598 | 0.5068 | 0.4054 | 4.6819 | 8.44% |
| Suno v5.5 | 6.7150 | 5.8087 | 4.2152 | 8.1955 | 0.5089 | 0.3913 | 4.5914 | 5.96% |
| Suno v4.5 | 6.6995 | 5.8317 | 4.3669 | 8.2541 | 0.5022 | 0.3873 | 4.4149 | 5.80% |
| Suno v6 | 6.5562 | 5.6558 | 4.3086 | 8.1295 | 0.4919 | 0.4305 | 4.6258 | 7.58% |
| LeVo 2 | 6.3247 | 5.4590 | 4.0234 | 8.3966 | 0.3542 | 0.2680 | 3.9458 | 26.12% |
| MiniMax Music 2.6 | 6.3222 | 5.4437 | 4.0985 | 8.1711 | 0.4251 | 0.3670 | 4.5688 | 24.55% |
| HeartMuLa | 6.2483 | 5.4963 | 4.5519 | 8.2933 | 0.3823 | 0.2786 | 3.4907 | 10.71% |
| Muse | 6.0349 | 5.1692 | 3.7887 | 8.0518 | 0.3937 | 0.3469 | 4.4036 | 33.42% |
| ACE-Step 1.5 | 6.0118 | 5.1588 | 3.8465 | 8.0518 | 0.4372 | 0.3869 | 4.5809 | 7.46% |
| DiffRhythm 2 | 5.2428 | 4.4770 | 3.5245 | 7.9782 | 0.3782 | 0.3255 | 4.0870 | 18.41% |
| YuE 1 | 4.9165 | 4.0847 | 3.2150 | 7.8683 | 0.2623 | 0.2882 | 3.7301 | 36.38% |
| SongBloom | 4.2350 | 3.4493 | 3.2051 | 8.1539 | 0.2697 | 0.1926 | 3.0287 | 19.19% |
但读这张表必须看它的脚注——
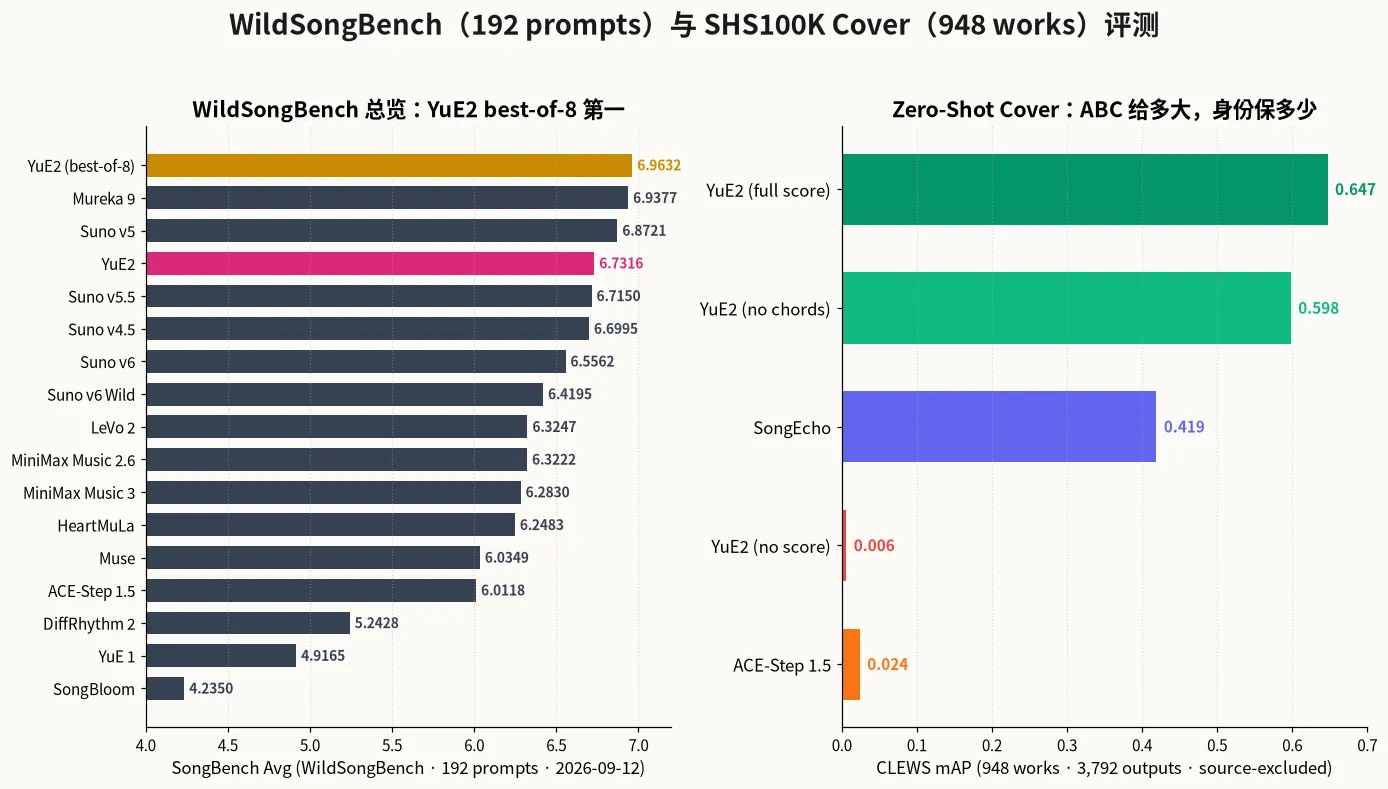
- “best-of-8” 不是单次推理——它对每个 prompt 跑 8 次,按 SongBench Musicality → Q3O → PER 顺序选 1 个。普通用户调一次 API 拿到的是 “YuE2” 这一行(6.7316),不是 best-of-8。
- 评测解码器是
YuE2-Vae-legacy,不是默认的YuE2-Vae——docs/benchmarks.md明说 “Default listening uses YuE2-Vae”。两个 VAE 不可互换,听感会差。 - 公开基线 = 权重公开 + 在本地跑,不一定是开源代码——Mureka 9、Suno v6 都没开源代码。
- MiniMax Music 3 用官方 caption rewriter,被归为”公开”是因为权重本地可跑——但这是 MiniMax 的模型,不是 MiniMax Music 系列。
- Suno v6 / v6 Wild 选 2 个 candidate × 4 ASR pass 取 PER 低者——和 best-of-8 的选法不同维度,不可直接比。
- SongEval 上 Suno v6 系列反超 YuE2——Suno 在风格表达上更强,但 Musicality(音准/节奏)和指令跟随上 YuE2 胜出。
正确的解读是:YuE2 best-of-8 在 Musicality + Q3O + 可编辑性三个维度上同时拿到了开源 SOTA,这不是”全维度碾压”而是”在最重要的维度上拿到第一”。
948 works 零样本翻唱:CLEWS mAP 0.647#
另一组数字更有冲击力——零样本翻唱:把 SHS100K 的 948 首作品用两种风格 × 两种 seed 翻唱,得到 3,792 个翻唱输出,和 source-excluded 检索库 10,545 个录音对比:
| Method | CLEWS mAP ↑ | CLEWS Hit@1 ↑ | Discogs-VINet mAP ↑ | MuLan ↑ | SongBench Musicality ↑ |
|---|---|---|---|---|---|
| YuE2 (full score) | 0.647 | 71.3% | 0.288 | 0.382 | 5.104 |
| YuE2 (no chords) | 0.598 | 67.3% | 0.179 | 0.417 | 5.490 |
| SongEcho | 0.419 | 48.4% | 0.122 | 0.366 | 3.286 |
| ACE-Step 1.5 | 0.024 | 2.4% | 0.006 | 0.166 | 3.689 |
| YuE2 (no score) | 0.006 | 0.3% | 0.004 | 0.474 | 5.691 |
这张表很反直觉——
- 不输 ABC 输入(no score)时,YuE2 的 identity preservation 几乎归零(mAP 0.006),但 MuLan 0.474(和目标风格最贴合)——它会”放飞自我”
- 完整 ABC 输入(full score)时,identity 拉到 0.647(71.3% Hit@1),但风格贴合度 0.382——它会”忠于原作”
- 只去和弦(no chords)时,identity 仍 0.598,风格贴合度 0.417,音乐性 5.490 反而最高——因为伴奏被释放
结论是:ABC 给多大,identity 保多少。用户可以”动 ABC 的哪几行”来精确控制”AI 改原曲的力度”——这是”白盒”的真正含义。
六、可复现性:seed 进去,48kHz 立体声出来#
YuE2 整套设计的”严肃”程度远超一般的 AI 音乐项目。它把可复现性做成了 first-class,每一步都有 SHA256 验证:
# src/yue2/pipeline.py
@classmethod
def from_pretrained(cls, model="m-a-p/YuE2-3B", *, vae="m-a-p/YuE2-Vae", ...):
    ...
    with Progress(enabled=progress).stage("Resolving model files"):
        model_path = resolve_model(model, revision=revision, **hub)
        vae_path = resolve_model(vae, revision=vae_revision, **hub)
    result = cls(model_path, vae_path, progress=progress, **kwargs)
...resolve_model 会读 model.safetensors.index.json 里的哈希,和本地文件逐字节核验;model_identity() 把模型 SHA256 + 文件大小写进 weights 字典;runtime_sha256 把 src/yue2/*.py 全部 SHA256 一遍:
# src/yue2/pipeline.py
self.runtime_sha256 = identity({p.name: sha256_file(p) for p in sorted(Path(__file__).parent.glob("*.py"))})每次 pipeline.__call__() 返回的 SongResult.request_identity 是这样算的:
# src/yue2/pipeline.py
def __call__(self, style=None, lyrics=None, *, ...):
    request = self._request(style, lyrics, ...)
    config = self.effective_config(request, abc_sampling, semantic_sampling)
    request_id = identity({"request": request.to_dict(), "config": config, "weights": self.weights})
    ...
return SongResult(audio, 48000, semantic, latents, config, self.weights, timing, request_id)request_id = hash(request + config + weights)。这意味着:
- 同样的 style/lyrics/seed 在不同 YuE2-3B revision 下 → request_id 不同
- 同样的输入在不同的 cfg_scale / temperature 下 → request_id 不同
- 同样参数在不同 Python 源码下 → request_id 不同(runtime_sha256)
这套”反 surprise”设计在开源 AI 项目里属于异类——大多数项目把”模型权重的 hash”和”采样 RNG 的 seed”当作可复现的全部,YuE2 把”prompt 的字符串 hash”、“采样参数的 hash”、“代码的 hash”都加进去。
cudnn 确定性 + FP32 噪声 + 一次性 RNG 抽取#
# src/yue2/pipeline.py __init__
torch.backends.cudnn.benchmark = False
torch.backends.cudnn.deterministic = True
torch.backends.cuda.matmul.allow_tf32 = False
torch.backends.cudnn.allow_tf32 = False
torch.backends.cuda.matmul.allow_fp16_reduced_precision_reduction = False
torch.set_float32_matmul_precision("highest")cudnn.deterministic=True 会让所有 conv 走确定性算法(慢 5-10%),显式关 TF32 也是为了让”论文里跑的浮点和你跑的一致”。
加上前面看到的”song_chunks 一次性 CPU FP32 抽完整份 noise”——这两条组合起来,给定 style + lyrics + seed + model revision,输出音频在 bit 级可复现(SDPA 内部非确定性除外,但这是所有 attention 实现的通病)。
内存预算 + FP8 量化#
# src/yue2/pipeline.py
self.memory_budget_gib = float(memory_budget_gib)
self.vae_core_frames = vae_core_frames if vae_core_frames is not None else (512 if memory_budget_gib <= 12 else 1024)- 默认 24GiB 预算(卡紧 2GiB reserve)
- 12GiB 以下 → VAE core_frames=512,否则 1024(这是为了在 4090 24G 上跑通默认参数)
- AR 头可走 FP8 量化(
quantization.py),NAR 头必须 BF16(流匹配对量化敏感)
_load_model(for_nar=True) 在 NAR 阶段会强制还原 FP8 量化,因为 FP8 的动态范围不够覆盖流匹配的中间状态。
CPU/MPS/ROCm 全支持#
# src/yue2/pipeline.py
if device == "auto":
device = "cuda" if torch.cuda.is_available() else "mps" if torch.backends.mps.is_available() else "cpu"这个 fallback 链在 AI 音乐项目里几乎没见过——大部分项目写”需要 NVIDIA GPU”,然后跑 Apple Silicon 用户一脸懵。YuE2 在 MPS 上做了 enable_gqa 的 polyfill(前面看到的 repeat_interleave),在 CPU 上 backends 是 math SDPA(n^2 但确定)——AMD GPU 用户虽然不被显式支持,但代码不会主动避开 ROCm。
七、SKILL 暴露:让 Agent 能编辑音乐#
skills/yue2-music/SKILL.md 是一份写得非常克制的 skill——它没有吹”YuE2 什么都能做”,而是明确写”不能做什么”:
Do not feed public MERT feature tensors to YuE2 as codec tokens. YuE2 exposes no audio-reference, phoneme-alignment, or local-inpainting argument.
这种”按能力范围声明边界”的做法在 AI Agent skill 圈极少见——大多数 skill 把自己包装成万能工具,导致 Agent 误用。
它把工作流列成 8 种,每种都有前提条件:
| 请求 | 工作流 | 前提 |
|---|---|---|
| 用可编辑的乐谱生成 | cot="full" → ABC → song | style + lyrics |
| 用 melody plan | cot="melody" → chord-free ABC → song | 提供 ABC(无和弦) |
| 不需要乐谱 | cot="off" → song | 不需要 ABC |
| 翻唱录音 | SheetSage2 → ABC → cot="melody" | 源音频 |
| 翻唱 ABC melody | 转换 ABC → 去和弦 → melody | 已有 ABC |
| 改和声/乐器/节拍/结构/歌词 | 改 ABC/text → 重生成 | 已有 plan |
| Agent 编辑 | 导出 plan/baseline → bounded editing agent → 校验 → 渲染 → 对比 | 多次迭代 |
| 连续特征分析 | MERT2 only | 不用 YuE2 |
而且它强制 baseline——“Use the supported baseline: one request at a time, BF16-capable NVIDIA GPU with 24 GB VRAM, default YuE2 settings. Do not silently shorten a requested song or lower inference settings to hide an OOM.”
这种”不替用户做选择”的工程伦理让 skill 可以放心让 Agent 跑——不会出现”Agent 为了躲 OOM 把歌砍到 30 秒”这种事。
abc_tools.py:4 个原子操作管 ABC 编辑#
# inspect - 解析 ABC 报告
python skills/yue2-music/scripts/abc_tools.py inspect examples/score.abc
# 输出:key/meter/tempo/notes/section/chord-symbols

# compare - 强制 notes/timing/meter/tempo 不变
python skills/yue2-music/scripts/abc_tools.py compare \
  examples/score.abc examples/score-jazz.abc
# match: true

# strip-chords - 翻唱用去和弦
python skills/yue2-music/scripts/abc_tools.py strip-chords \
  outputs/transcription/score.abc outputs/cover.abc

# 转换 native ABC → 内部 dialect
python skills/yue2-music/scripts/abc_tools.py convert ...这 4 个命令构成了 Agent 编辑的”API 表面”——Agent 不用懂 ABC 语法,调用 compare 就能验证”我的改动没破坏 invariants”。
八、可借鉴的工程实践清单#
拆完 YuE2,我整理了值得在下一个项目里直接抄的实践:
数据结构层#
- dataclass + manifest + hash:
SymbolicPlan/SongResult都是纯 dataclass,plan_manifest.json写每文件 SHA256,load()逐字段校验——任何”再生成”操作都基于”可验证的输入” - 词表常量集中:
protocol.py一个文件管所有 token ID / CFG 默认 / 上下文大小——改一个数只需要改一个文件 - CFG 显式负分支:
cfg_negative="same_instruction_and_exact_abc"把”CFG 在做什么”从隐式约定变成 schema 字段
算法层#
- AR-NAR 共享 backbone + 独立 layernorm/MLP:比 MoT 全双流省 50% 参数,比单流 NAR 强很多
- 一次性 CPU 抽完整噪声:可复现的”全 song 共享 RNG 状态”
- logit(t) 时间重参数:低 t / 高 t 两端都有合理梯度
- tiled decode + halo crop 16 帧:避免块边界噪声
- SnakeBeta 替代 Snake:可学习 β
工程层#
cudnn.deterministic=True+ 关 TF32:可复现性的成本是 5-10% 速度,但省去”为啥我跑出来和你不一样”的来回runtime_sha256 = sha256(所有 .py):把”代码版本”加入 request identity- device auto + MPS polyfill + CPU math SDPA:不挑设备
save_artifacts()一键导出所有可复现工件:audio + plan + score + tokens + latents + hashes- CLI / Python / Transformers 三套入口:
run_yue2.pyCLI +pipeline.pyPython +AutoModelHF——让不同用户群体都能用 - SKILL 写”不能做什么”:让 Agent 不误用
- 不替用户降配:OOM 就报 OOM,不偷偷砍长度
九、留给我们的问题#
YuE2 已经做得很完整,但还有几个有趣的方向:
- 多模态风格控制:目前 style 是纯文本,加上参考音频/参考谱会怎样?
- SongBench 维度深化:Mureka 在 SongEval 上反超 YuE2,它的训练数据/后训练是否值得借鉴?
- NAR head 能否继续压缩:3B 大部分是 AR head,NAR 头可能只需要 200M——能否分两个 checkpoint 部署?
- SheetSage2 集成度:目前是独立 venv + 独立 PyTorch 索引——能否一个 repo 一套环境?
- Web demo 离线化:map-yue2.github.io ↗ 很好用,但 demo 服务器一挂就完——能否一个 HuggingFace Space 完全本地化?
十、写在最后#
YuE2 是一份”足够小、足够干净、足够严肃”的代码。3,800 行 + 1 个 SKILL + 5 个 docs 就能讲清楚 4 阶段流水线 + 3 种用法 + 4 类评测。
它没有用 “AGI 即将到来” 的语言,没有用 “颠覆音乐产业” 的承诺——它只是把”白盒音乐生成”这件事的工程问题解决了:
- 乐谱是文件,不是黑盒
- 编辑是 diff,不是 retrain
- 生成是函数,不是 service
- 复现是 hash,不是运气
这才是开源 AI 该有的样子。
参考资料
- multimodal-art-projection/YuE ↗
- m-a-p/YuE2-3B ↗ · m-a-p/YuE2-Vae ↗ · m-a-p/YuE2-Vae-legacy ↗
- m-a-p/WildSongBench ↗
- map-yue2.github.io ↗ - 在线 demo
- stable-audio-tools ↗ - Oobleck VAE 上游
- SheetSage2 ↗ - 音频→ABC 工具