把几百个 PDF 交给一个实习生,他居然自己编了本百科全书:腾讯 WeKnora 深度拆解
💬 评论腾讯 WeKnora v0.8.0 深度拆解:自适应三层分块、Wiki 模式让 Agent 自治生成互相链接的知识库、上下文压缩为什么必须保住文件路径、沙箱三种回收、九段 prompt 拼装,以及一句该抄进容量文档的话——加 worker 只会制造更多等待者。
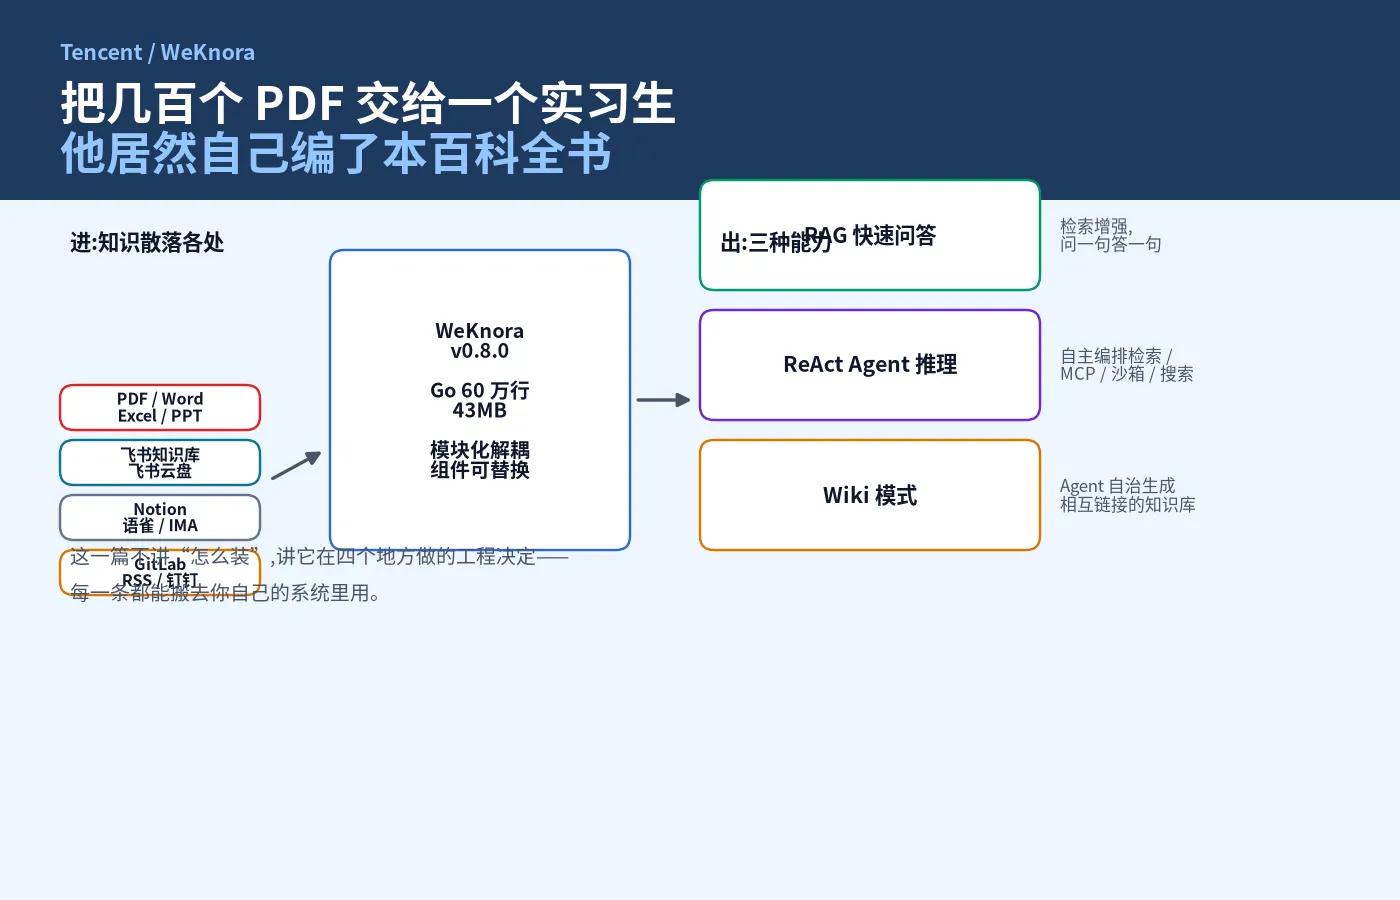
仓库:Tencent/WeKnora ↗ License:MIT · v0.8.0 · Go 60 万行 / 2,350 个 .go 文件 · 43MB tarball 前端 205 个 .vue + 362 个 .ts · 103 个数据库迁移 · 205 篇文档
先讲一个你肯定遇到过的场景。
一、你有一个文件夹,叫”以后再看”#
公司里的知识是散的。
产品文档在飞书知识库里,设计稿在飞书云盘,技术方案在 GitLab 的 issue 里,竞品分析在某个同事的 Notion,行业报告是下载下来的 PDF,还有几张 Excel 表格、几个 XMind 脑图、一堆钉钉群里传过的截图。
你当然可以全文搜索。但你搜不到关系。
你搜”这个指标怎么算的”,搜到三篇文档、两段代码、一个 Excel;你需要自己读完,然后自己在脑子里把关系连起来:“哦,原来 A 指标依赖 B 表,而 B 表的口径是 C 文档里定的。”
这一层”连接”,就是这一篇文章要讲的东西。
腾讯开源了一个叫 WeKnora ↗(维娜拉)的项目,它的官方定位是:
让文档活起来:RAG、Agent 推理与自动 Wiki 一体化的知识框架。
三个关键词,后面我一个一个拆。但先说结论——它不是又一个”上传 PDF 然后提问”的套壳产品。它是一个企业级的知识框架,而且它的代码和设计文档里,藏着大量可以直接搬去你自己系统里的工程决定。
我挑六个最有”内涵”的讲。不减速度,该慢的地方我会慢下来。
二、先看清楚它是什么#
WeKnora 把知识库的使用方式分成三种,层层加码:
| 模式 | 一句话 | 适合 |
|---|---|---|
| RAG 快速问答 | 检索 → 拼接 → 回答 | ”这个流程怎么走的?” |
| ReAct Agent 推理 | 自主编排:检索 + MCP 工具 + 技能沙箱 + 网络搜索 | ”帮我把这份数据整理成报告” |
| Wiki 模式 | Agent 从原始文档自治生成结构化、互相链接的 Markdown 知识库 + 知识图谱 | ”帮我把这批资料整理成一套可读的知识” |
第三种是它最有意思的地方,也是标题里那句”自己编了本百科全书”的来源——后面单独讲。
先看规模,让你有个手感:
- Go 60 万行(2,350 个文件),
internal/22MB - 前端 205 个 .vue + 362 个 .ts,14MB
docreader/是一个独立的 Python 解析服务(gRPC),1.2MB- 103 个数据库迁移,
internal/application/19.6 万行(业务最厚的地方) - 205 篇 Markdown 文档——其中有一批是设计评审文档,质量高得不像开源项目
最后这一点很关键。我写拆解文的经验是:读代码能知道它做了什么,读设计文档能知道它为什么这么做。而 WeKnora 把”为什么”写下来了。
所以后面六个点,我会尽量引用它的原话——因为这些原话,比我的转述更值钱。
三、内涵点一:分块是一切的地基,而它选择先说清楚基线#
RAG 的原理你应该知道:把文档切成小片 → 每片算一个向量 → 存进向量索引 → 提问时把最相关的几片捞回来喂给模型。
那么第一个问题就来了:怎么切?
切得太碎,一个完整的论述被拆到三块里,谁也答不全;切得太大,一块里混了三个主题,检索精度掉下去。这是 RAG 里最古老、也最容易被忽略的一个旋钮。
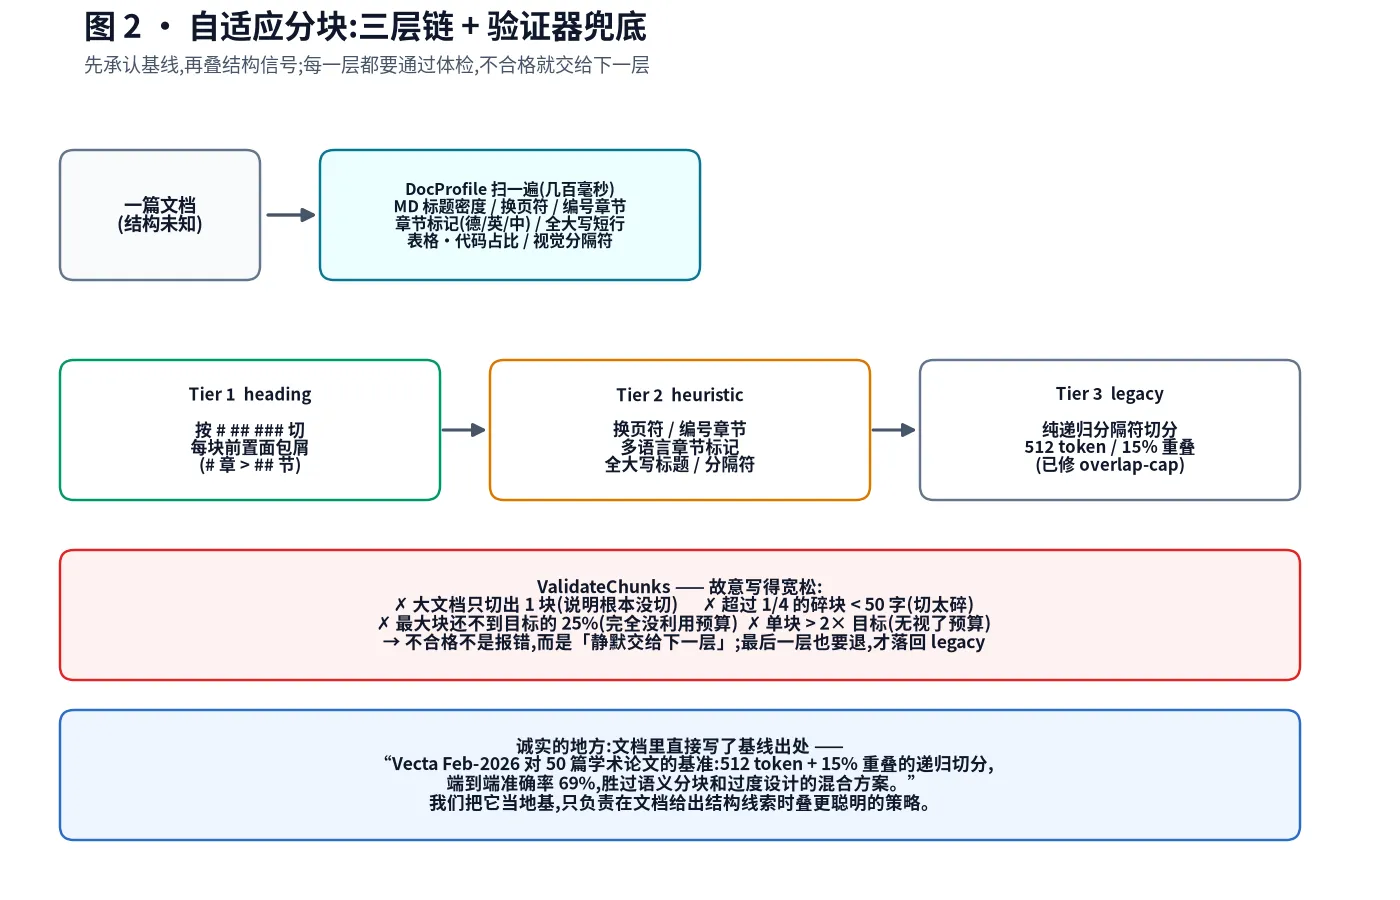
WeKnora 的处理方式,我很欣赏,因为它分了两步:先承认基线,再叠结构。
它的文档 CHUNKING.md 里直接写了出处:
Empirically (Vecta Feb-2026 benchmark across 50 academic papers): recursive splitting at ~512 tokens with ~15% overlap is the strongest single-knob baseline at 69% end-to-end accuracy, beating semantic chunking and over-engineered hybrids. WeKnora uses that as the foundation and layers smarter strategies on top when the document gives us structural cues.
翻译一下:在 50 篇学术论文的基准上,512 token + 15% 重叠的递归切分,是”只调一个旋钮”能拿到的最强基线,端到端准确率 69%,打败了语义分块和过度设计的混合方案。
这是一个非常诚实的工程态度。
因为大多数人做 RAG 的做法是:一上来就想搞”语义分块""LLM 分块""混合检索”,然后被自己的复杂度拖死。而 WeKnora 的选择是——先承认那个最简单的方案已经很强了,然后只在文档给出明确结构线索的时候,才叠更聪明的东西。
它怎么”叠”#
三步,按顺序:
第一步:先扫一遍文档,做画像(DocProfile)。
不打乱内容,只用几次正则 + 数 rune,统计这些信号:
- Markdown 标题密度(第 1~6 级各几个)
- 换页符数量、编号章节数量
- 多语言章节标记计数——
GermanChapterCount/EnglishChapterCount/ChineseChapterCount(也就是”第六章""Chapter 6”这类) - 全大写短行数、视觉分隔符数、重复页脚数
- 是否有表格 / 代码,代码占比
- 语言提示(尽力而为)
这个画像很便宜(几百毫秒),但决定了后面走哪条路。
第二步:按画像选一条”链”,而不是选一个策略。
链上三层:
| 层 | 什么时候用 | 怎么切 |
|---|---|---|
heading | 有 Markdown 结构 | 按 # / ## / ### 切,每块前置面包屑(# 章 > ## 节) |
heuristic | 像 PDF 的结构 | 换页符 / 编号章节 / 多语言章节标记 / 全大写标题 / 视觉分隔符 |
legacy | 其他,以及兜底 | 纯递归分隔符切分(就是那个 512/15% 基线) |
第三步(这是我最喜欢的地方):每一层都要过体检,不合格就静默交给下一层。
ValidateChunks 的逻辑写得故意宽松,文档里的原话:
The validator is intentionally permissive: a single “obviously broken” output is rejected, but plausible-looking variation is accepted so we don’t oscillate between tiers.
“故意宽松”这个设计很有意思——因为它要防的是”看起来就坏了”的输出,而不是追求完美。如果验证器太严,系统会在两层之间来回摇摆,反而不稳定。
它只拦四种”明显坏了”:
- 大文档只切出一块(说明根本没切)——
len(chunks) == 1 && totalChars > 2*chunkSize - 超过 1/4 的碎块小于 50 字(切得太碎)
- 最大块还不到目标的 25%(完全没利用预算)
- 单块超过 2 倍目标(无视了预算)
不合格怎么办?不是报错,而是记一条 debug 日志,然后交给下一层。 最后一层也退,才落回 legacy。
for i, tier := range chain {
    out := runTier(tier, text, cfg, profile)
    if v := ValidateChunks(out, totalChars, cfg.ChunkSize); v.OK {
        return out
    } else {
        logger.Debugf(ctx, "chunker: tier %s rejected: %s", tier, v.Reason)
    }
    ...
}为什么这个模式值得抄?
因为它把”降级”从异常处理变成了正常流程。大多数系统的降级路径是写在 catch 里的、很少被测试的、出问题才走的。这里降级是主路径的一部分——每次切分都在跑,而且有 reason 记录。
顺带一个细节:它还给调试面板暴露了 Diagnostics(选中哪层、试过哪些层、每层为什么被拒、文档画像是什么)。当一个东西会自己选路,你必须能看见它选了什么。
四、内涵点二:Wiki 模式——让 Agent 自己编百科#
现在讲标题里那件事。
普通的 RAG 是被动的:你问,它才去捞。文档之间的关系没人维护,索引里就是一堆孤立的块。
WeKnora 的 Wiki 模式换了个方向:让 Agent 把文档”读成”页面。
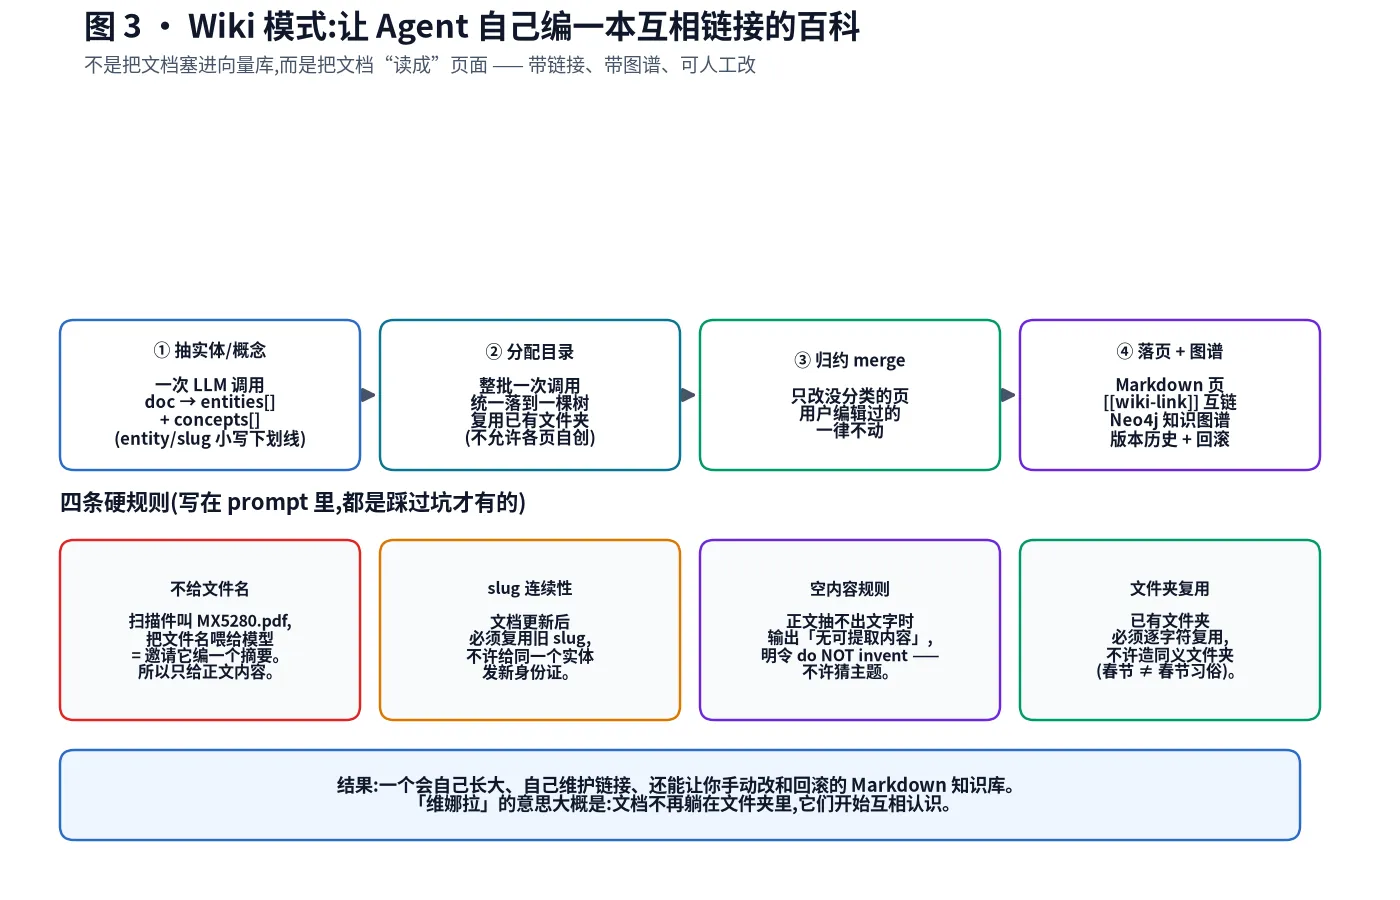
流程是四步:
- 抽实体和概念——一次 LLM 调用,把文档变成
entities[]+concepts[],每个带name/slug/aliases/description - 分配目录——把这批新页面分配到一棵统一的目录树上
- 归约合并(reduce)——只处理还没分类的页面,用户改过的一律不动
- 落页 + 建图——生成 Markdown 页面,用
[[wiki-link]]互相链接,同时写 Neo4j 知识图谱;页面有版本历史,支持行级 diff 和回滚
这四步里,每一条都藏着踩过坑才有的细节。
细节一:不许把文件名给模型看#
WikiSummaryPrompt 上面有一段注释,原文:
Filename and title are intentionally NOT passed to the LLM: documents uploaded to WeKnora often carry filenames that say nothing about the content (e.g. scanned PDFs named after the scanner model “MX5280.pdf”), and feeding such filenames to the model invites hallucinated summaries when the actual extracted content is thin.
“MX5280.pdf” 这个例子太真实了——扫描仪扫出来的文件,名字就是打印机型号。
如果你把文件名给模型,而文档正文又抽不出多少文字(扫描件常见),模型会很热心地根据文件名编一个主题出来。所以它选择:只给正文。
这是”防幻觉”最有效的一种做法——不是事后检查,而是不出让那个诱惑源。
细节二:空内容就明确说”我编不出来”#
同一个 prompt 里的第 10 条规则:
Empty content rule: If the
<content>block above is empty, contains only image references with no extracted text, or otherwise carries no substantive information, output exactly: “SUMMARY: No textual content was extractable from this document.” followed by a brief note explaining that the document could not be summarised. Do NOT invent a topic, do NOT guess from any other clue.
“不许编主题,不许从任何其他线索猜”——这句话是写死在 prompt 里的。
细节三:slug 必须连续#
文档更新了,同一个实体不能发新身份证。提取 prompt 里的规则:
- If an entity or concept from the previous extraction still exists in the current document, reuse its exact slug from the previous list. Do NOT generate a new slug for the same thing.
- If an entity or concept no longer appears in the document, do NOT include it in the output.
为什么要这么较真?
因为 slug 是页面之间的链接锚点。一旦同一个实体今天叫 entity/zhong-guo、明天叫 entity/china,那所有指向它的 [[wiki-link]] 就全断了——你的知识库会慢慢烂成一堆 404。
细节四:目录必须”一次分配”,不能各页自创#
这是我认为最漂亮的一个决定。
如果让每个页面自己决定放哪个文件夹,会怎样?在第一批文档进来的那一刻(知识库里还一个文件夹都没有,没有锚点可参考),十个页面会并行地各自发明十个风格各异的文件夹——“节日""传统节日""春节习俗""习俗”……从此这棵树就烂了。
所以 WeKnora 的做法是:把一整批实体的目录分配合并成一次 LLM 调用,让整批落到”一棵连贯的树”上:
Assign a directory path (category) to every entity / concept page produced by ONE ingest batch in a single call, so the whole set lands on one coherent tree that reuses existing folders — instead of each page inventing its own folders in parallel (which diverges worst on the founding batch, when the KB still has no folders to anchor on).
Prompt 里还有三条硬约束:
- If an existing folder in
<existing_folders>fits, REUSE its EXACT label (character-for-character). Do NOT invent a synonym folder (e.g. do NOT create “春节习俗” when “春节 / 传统习俗” already fits).- Only give an empty path
[]when an item genuinely belongs to NO durable subject at all. This must be RARE. The absence of a matching existing folder is NOT a reason for[]; create a folder instead.- Do NOT use the item type (“entity”/“concept”) as a folder.
“逐字符复用”(character-for-character)——连这个都写了。因为模型很容易觉得”春节习俗”和”传统习俗”差不多,然后就创造了一个新文件夹,树开始分叉。
而且注意第 2 条的思路:默认答案是”给它造个家”,而不是”留空”。给模型留 [] 这个选项,如果不加约束,它会大量使用,因为那是最省事的。所以明确说:留空必须罕见。
细节五:归约只动”没主的”页面#
The result is applied in reduce only to pages that don’t already have a category, so user edits and previously-filed pages are never churned.
自动系统动了人改过的东西,是最容易丢信任的一步。所以这里明确:只处理还没有分类的页面。
五、内涵点三:上下文压缩——全篇最见功力的一段#
前面几个都好懂。这一段我想请你慢一点看。
一个长会话的 Agent 迟早会遇到:上下文快满了,得压缩。
天真的做法是:“保留最近 N 个 token 的对话,把前面的做一份摘要。“——这听起来合理到不行,但真正实现的时候,你会掉进至少三个坑。
WeKnora 把这三个坑都填了,而且注释写清了为什么。
坑一:有些消息不能从中间切开#
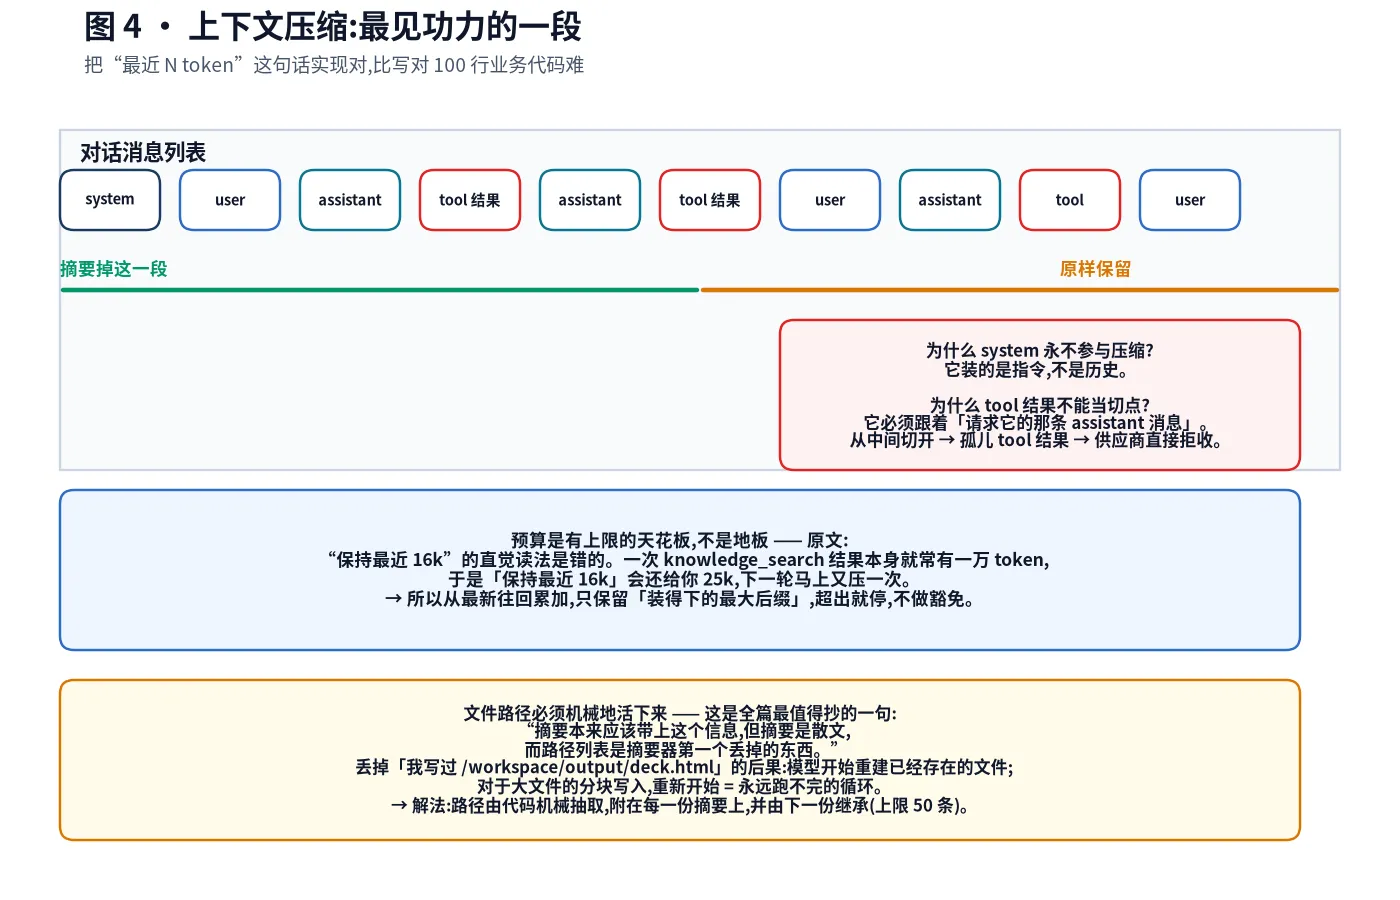
压缩的本质是找一个切点:切点之前的做摘要,切点之后的原样保留。
那么问题来了:哪些位置可以切?
答案:除了 tool 结果,哪里都能切。
isCutPointMessage 的注释:
Everything except a tool result qualifies. Tool results are excluded because they must stay with the assistant message that requested them — cutting between the two leaves an orphaned tool result and providers reject the request outright.
工具结果必须跟着”请求它的那条 assistant 消息”。 你在中间切一刀,就留下一个孤儿工具结果,而供应商会直接拒收整个请求。
这是那种”不知道就永远调不通,知道了就再也不会错”的知识。
而且它有个漂亮的推论:
The corollary is what makes mid-turn compaction safe: a cut that lands on an assistant message keeps that message and every tool result following it, so the pairing is never split from either side.
——切在 assistant 消息上,那条消息 + 它后面所有工具结果一起被保留,配对从两边都不会断。
还有一条更细的:system 提示词永不参与压缩,因为它装的是指令,不是历史:
historyStartis the first index compaction may touch. The system prompt is never a candidate — it carries the agent’s instructions, not its history.
坑二:“保留最近 16k”这句话的直觉读法是错的#
这是全篇最反直觉的一条。原文:
The budget is a ceiling, not a floor. Stopping at the first message that reaches the budget and keeping that message too is the obvious reading and the wrong one: a single
knowledge_searchresult is routinely ten thousand tokens on its own, so “keep the recent 16k” would hand back 25k and leave barely a round of headroom before the next compaction.
预算是有上限的天花板,不是地板。
为什么?因为一次知识库检索的结果,本身就可能有一万 token。你按”够 16k 就停”的直觉去切,实际会交回 25k,下一轮马上又得压一次——每次都多压一点,每次都立刻又满。
正确做法:从最新的消息往回累加,只保留”装得下的最大后缀”,一超预算就停,而且不给任何豁免:
Nothing here consults the current turn. That is deliberate: the budget is the only rule, and a turn large enough to exceed it on its own gets split rather than exempted.
“预算就是唯一的规则”——当前轮次再重要,也算不得例外,超了就拆。
坑三(最值钱):文件路径必须机械地活下来#
如果只能抄一句,我建议抄这段注释:
Dropping the history that says “I wrote
/workspace/output/deck.html” leaves the model with no record of the artifacts it already produced, so it starts rebuilding files that are already on disk — and for a file large enough to need chunked writes, restarting is exactly the loop that never terminates.The LLM summary is supposed to carry this, but it is prose and a list of paths is the first detail a summarizer drops.
请感受一下这句话的层次:
- 压缩掉了”我写过这个文件”的历史
- 模型就不知道自己已经写过了,开始重建
- 对于需要分块写入的大文件,重来一次 = 一个永远不会结束的循环
然后是对”指望摘要”这件事的否定:
“摘要本来应该带上这个信息,但摘要是散文,而路径列表是摘要器第一个丢掉的东西。”
这句话说得太准了。我们做压缩的时候,总有一种幻觉:“摘要会把重要的都说出来的。“不会的。摘要器会保留叙事、因果、结论;它第一个丢的就是那些看起来干巴巴的清单——路径、ID、参数、配置项。
所以 WeKnora 的解法是:不指望 LLM,用代码机械地抽。
- 从工具调用里提取读过的文件、写过的文件、编辑过的文件(三个集合分开)
- 把路径列表附在每一份摘要上,并由下一份摘要继承
- 渲染时只有两个列表:写过的只报成”已修改”,即使它也被读过
- 上限 50 条——超过就丢最旧的,不让这块内容无限膨胀
这是一个通用的工程模式:凡是”必须精确、不能让模型自由发挥”的信息,就别放在自然语言里让模型去记。
附带一个:24 种”上下文超了”的说法#
同一个包里还有 overflow.go,里面收集了 24 条正则,匹配各家供应商在上下文超限时返回的错误文案:
regexp.MustCompile(`(?i)prompt is too long`),                                  // Anthropic
regexp.MustCompile(`(?i)request_too_large`),                                   // Anthropic (HTTP 413)
regexp.MustCompile(`(?i)input is too long for requested model`),               // Amazon Bedrock
regexp.MustCompile(`(?i)exceeds the context window`),                          // OpenAI
regexp.MustCompile(`(?i)input token count.*exceeds the maximum`),              // Google Gemini
regexp.MustCompile(`(?i)maximum prompt length is \d+`),                        // xAI Grok
regexp.MustCompile(`(?i)model_context_window_exceeded`),                       // z.ai
regexp.MustCompile(`(?i)prompt too long; exceeded (max )?context length`),     // Ollama
regexp.MustCompile(`(?i)range of input length should be`),                     // DashScope / Qwen
// ... 还有 15 条而且更妙的是,它还有一份排除列表:
nonOverflowPatternsare errors that mention token counts while meaning something else. Bedrock throttling reads “ThrottlingException: Too many tokens, please wait before trying again”, which matches an overflow pattern and is not one.
Bedrock 限流的原文是 “Too many tokens, please wait before trying again”——它提到了 token,匹配超限正则,但它根本不是超限,是限流。
“看起来像”和”是”之间的差别,就是这一份排除列表。
为什么要区分得这么细?注释里也说了:
Context overflow is worth detecting precisely because the recovery is specific: compact and retry once. Misread as a generic failure it ends the turn; misread as a transient error it retries the same oversized request until the attempts run out.
判错的代价是双向的:当成普通错误 → 这一轮直接死;当成临时错误 → 拿同一个超大的请求重试到次数用尽。
最后还有一个”成功响应其实也超了”的检测(ResponseHitContextLimit),识别三种形态:供应商默默接受了一个超大的请求(z.ai)、供应商把输入截断到刚好填满窗口导致没有生成空间(Xiaomi MiMo)、以及供应商在”长度”上停下但输出量小于我们允许的量。
这段代码里没有一个”聪明”的算法,全是”踩过坑之后写下的判断”。
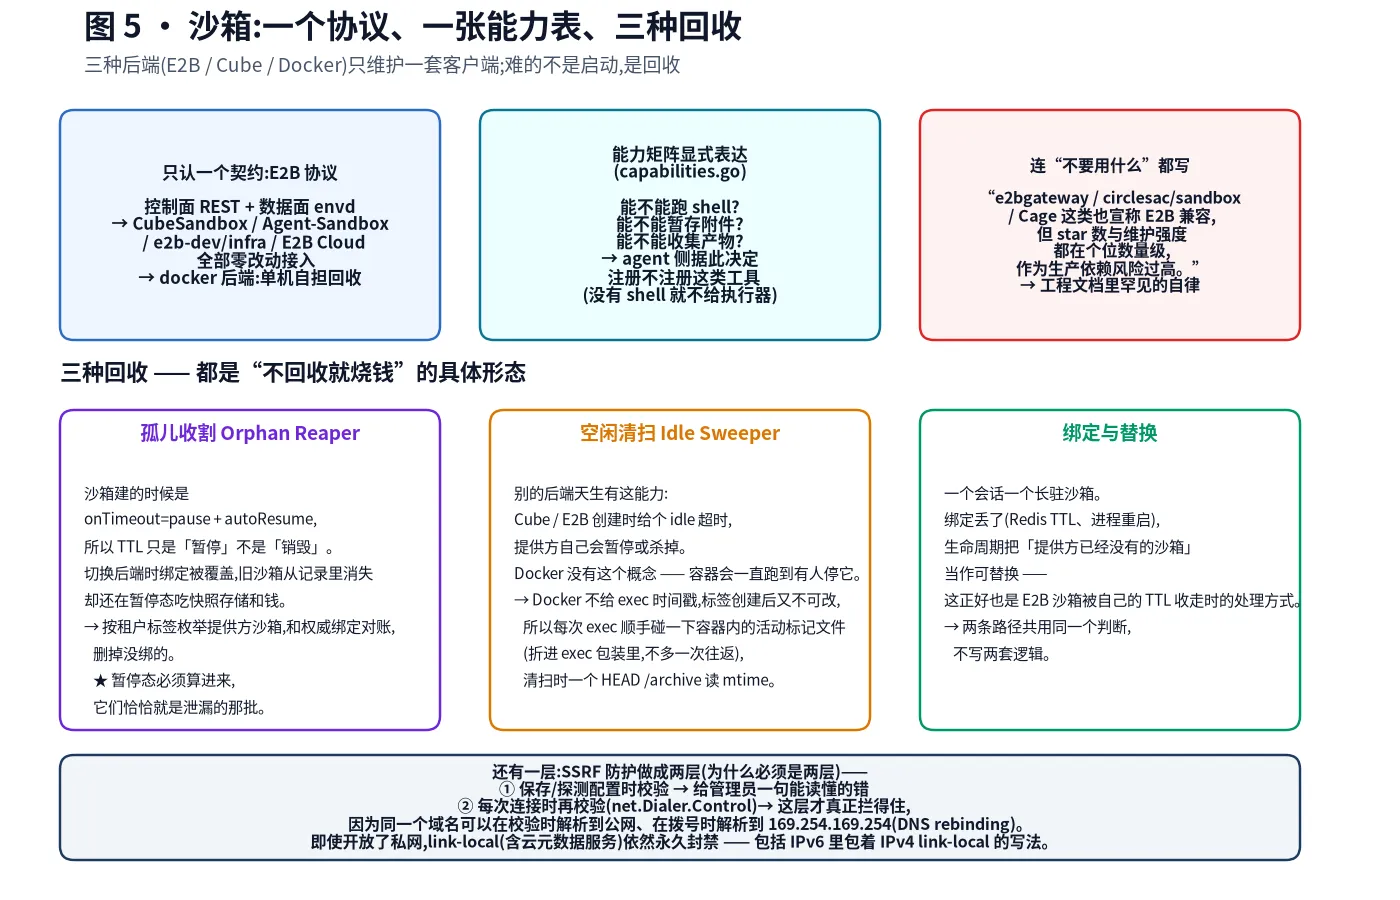
六、内涵点四:沙箱——一个协议、一张能力表、三种回收#
Agent 要真干活(跑脚本、装依赖、生成 PPT),就得给它一个执行环境。这部分 WeKnora 写了 3.3 万行,我挑三件事讲。
6.1 只认一个协议#
docs/sandbox-protocol.md 的标题就说明了立场:以 E2B 协议为唯一接入契约。
跨主机、需要内核级隔离的部署走 E2B 协议(控制面 REST + 数据面 envd):WeKnora 只维护一套这样的客户端,具体隔离能力由社区实现提供。
这样一来,四个实现都能零改动接入:
| 实现 | 隔离方式 |
|---|---|
| CubeSandbox(腾讯云开源) | KVM MicroVM + eBPF 网络隔离 |
| Agent-Sandbox | K8s Pod(可叠 gVisor/Kata) |
| e2b-dev/infra | Firecracker MicroVM |
| E2B Cloud | 托管 MicroVM |
“只维护一套客户端”是一个架构上的克制。 每支持一种后端就多一套客户端代码,短期看起来是”支持得多”,长期是”三个都要修”。
而单机部署走 docker 后端,牺牲的是:空闲回收、执行超时这些控制面职责由 WeKnora 自己承担(这也是下面三件回收工作的由来)。
6.2 能力矩阵显式表达#
capabilities.go 显式表达每个后端能做什么,agent 侧据此决定注册不注册这类工具:
能力矩阵在
internal/sandbox/capabilities.go中显式表达,agent 侧据此决定是否注册 shell/文件类工具。
所以你在没有 shell 的后端上,看不到一个”自称能执行但其实跑不了”的工具。文档里那句说得很直接:
没有 Shell 时只阅读技能,明确告知执行不可用,不再暴露一个实际无法承接同等能力的执行器。
6.3 连”不要用什么”都写#
这在开源文档里非常罕见:
不建议采用的方向:
e2bgateway、circlesac/sandbox、Cage这类项目虽然也宣称 E2B 兼容并支持 Docker 后端,但当前 star 数与维护强度都在个位数量级,作为生产依赖风险过高。
点名说”这几个不建议用”是有风险的。但它选择说,因为不说才是对部署方不负责。
6.4 三种回收——“不回收就烧钱”的具体形态#
这部分是全篇最”生产环境”的内容。三个不同的泄漏场景,三种不同的解法。
① 孤儿收割(Orphan Reaper)
沙箱创建时用的是 onTimeout=pause + autoResume,所以提供方的 TTL 只是”暂停”,不是”销毁”。
那么当一个绑定被替换掉(切换后端时的 CAS)或者丢了(Redis TTL、进程重启)的时候,会发生什么?旧沙箱从我们的记录里消失了,但沙箱本身还活着——躺在暂停态里,继续吃快照存储和钱。
原文说得很清楚,而且指出了一个关键:
Neither existing cleanup path covers that: session deletion works from a live binding, and the lifecycle’s orphan cleanup is lazy, triggering only when someone touches the binding that has already been overwritten.
… Paused sandboxes MUST be included: they are precisely the leaked ones.
“暂停态必须算进来,它们恰恰就是泄漏的那批。”
这个循环做的事:按租户元数据标签枚举提供方所有沙箱,和权威绑定对账,删掉没有绑定的。还有两个细节很有经验:
ConfigID必须参与过滤——只按租户扫,会删掉同一个提供方账号上兄弟配置的沙箱Grace保护刚创建、还没来得及绑定的沙箱
② 空闲清扫(Idle Sweeper)
注释第一句就把对比讲明白了:
Every other backend gets this for free. Cube and E2B are told an idle timeout at creation and the provider pauses or kills the sandbox when it elapses… The Docker daemon has no such concept: a container runs until something stops it. Without a sweep, one abandoned session pins its memory and CPU share on the host forever.
Docker 没有”闲置超时”这个概念。
那怎么知道一个容器闲置了多久?这里有个很妙的绕路:
Docker exposes no exec timestamps. Labels cannot help either — they are immutable after create. So each exec touches an activity marker file inside the container (folded into the exec wrapper, costing no extra round-trip), and the sweep reads its mtime with a single HEAD /archive call per container.
Docker 不给 exec 时间戳,标签创建后又不可改。 所以:每次 exec 顺手碰一下容器内的一个活动标记文件(折进 exec 包装里,不额外多一次往返),清扫时用一个 HEAD /archive 读它的 mtime。
还有三个约束,都是”防止清扫本身成为问题”:
dockerIdleTTLLabel:记录每个容器创建时的 TTL,避免一个工作区的清扫把别的 TTL 应用到不属于它的容器上dockerSweepMinInterval = time.Minute:不管多少请求触发,一个 daemon 每分钟最多扫一次dockerSweepBudget = 2 * time.Minute:一次清扫的时间上限,避免一个卡住的 daemon 留下永远挂着的 goroutine
而且它明确说了:删一个闲置容器不需要和绑定库协调——因为生命周期本来就把”提供方已经没有的沙箱”当成可替换的,这正好也是 E2B 沙箱被自己 TTL 收走时的处理方式。一条判断,两条路径共用。
③ SSRF 防护(顺带)
租户可以配置自己的沙箱控制面地址,服务端会去拨号——这就是一个 SSRF 原语。
注释第一段就把最危险的目标点出来了:
the most damaging target is the cloud metadata service (169.254.169.254), which hands out instance credentials, followed by any internal service reachable from the application host.
防得很有讲究,两层,而且是故意的:
Defence is two-layered on purpose:
Validateruns when a config is saved or probed, giving the admin an immediate, readable error.DialControlruns at connect time on every request. This is the layer that actually holds, because a hostname can resolve to a public address during validation and to169.254.169.254at dial time (DNS rebinding).
第二层才是真正拦得住的那层——因为同一个域名,可以在校验时解析到公网,在拨号时解析到内网。这就是 DNS rebinding。
还有一个细节:即使是自托管部署、允许访问私网,link-local(包含云元数据)依然永久封禁——而且这个规则对”IPv6 里包着 IPv4 link-local”的写法同样生效。
七、内涵点五:权限,不要用 prompt 来实现#
这一段可能会改变你写 Agent 的方式。
WeKnora 的系统提示词不是”一大坨”,而是拼出来的九段。唯一入口是 internal/agent/prompts.go 里的 BuildSystemPromptSections:
| 段名 | 职责 |
|---|---|
base | 角色、领域工作流、业务要求 |
steering | 处理中途补充,保留未完成任务 |
runtime_contract | 数据与指令边界、当前文档范围、完成条件 |
sources | 依据实际工具集合确定本轮来源规则 |
tools | 通用执行、文件和沙箱约定 |
skills | 当前安装且可用的 skill 元数据 |
output | 用户输出格式、条件配图、完成检查 |
memory | 本轮召回的记忆封装 |
protocol | 来源句柄与输出引用协议 |
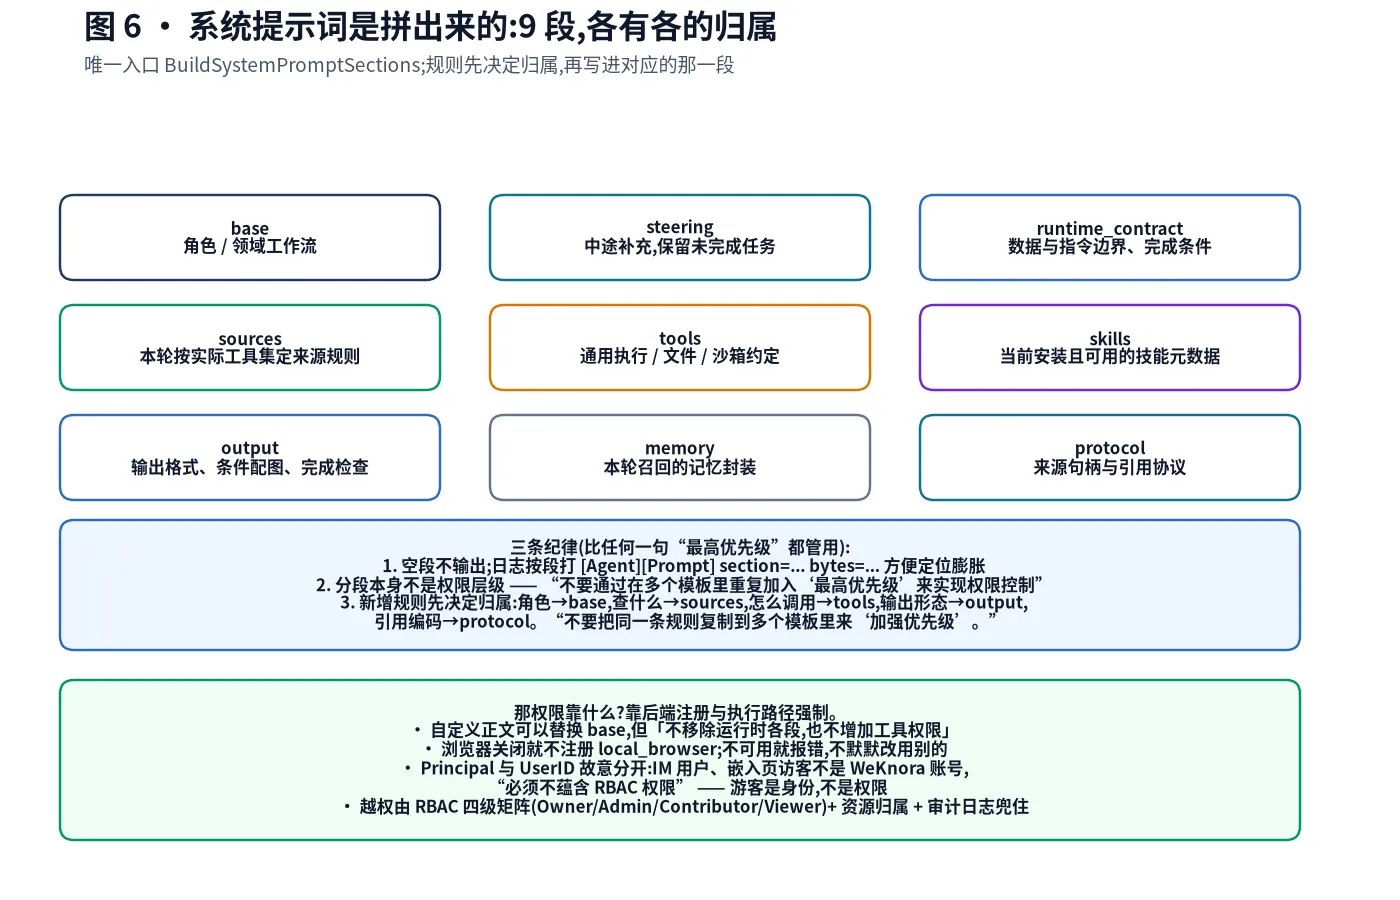
三条纪律#
① 空段不输出,而且每段有字节日志
空段不会输出。日志
[Agent][Prompt] section=... bytes=...记录每段大小。
② 分段不是权限层级——这句话请你记下来:
分段本身不是模型 API 的权限层级。用户正文与运行时规则仍处于系统提示词中;可调用工具的权限由后端注册与执行路径强制控制。
不要通过在多个模板中重复加入”最高优先级”来实现权限控制。
我们很多人在写 Agent 提示词时,下意识的做法就是:“在开头强调一遍、在中间再强调一遍、结尾再强调一遍,用’最高优先级’吓住它。”
这本质上是在用自然语言模拟访问控制。而自然语言不是访问控制。
真正的权限,应该由后端注册和执行路径来强制。提示词只负责”怎么用得更好”,不负责”能不能用”。
③ 新增规则先决定归属
后续新增规则先决定归属:角色与领域方法放
base,查什么放sources,怎么调用放工具定义/tools,输出形态放output,引用编码放protocol。不要把同一条规则复制到多个模板中来”加强优先级”。
这条纪律解决的是一个非常常见的病:同一条规则在五个地方各写了一遍,然后改的时候改漏了三处。
那权限到底靠什么?#
靠这几层:
- 工具注册:浏览器关闭 → 不注册
local_browser;开启但服务不可用 → 报错,不默默改用别的浏览器 - 自定义正文的边界:用户自定义正文可以替换
base,但**“不移除运行时各段,也不增加工具权限”** - Principal 模型:这是我觉得最漂亮的一个设计。原文:
Principal represents the terminal caller for per-subject isolation features. It is intentionally separate from UserID: many principals, such as IM users or embed visitors, are not WeKnora accounts and must not imply RBAC rights.
身份 ≠ 权限。
一个在微信里跟你嵌入页面聊天的访客,一个 IM 里的用户——他们都是Principal(有 ID、需要被隔离),但他们不是 WeKnora 账号,所以不应该蕴含任何 RBAC 权限。
如果这两个概念混在一起(很多系统就是这么做的:统一叫 user),那么”给访客一个标识”这件事就会自动变成”给访客一个身份”,然后权限系统就开始漏水。
它的 Principal 类型有九种:web_user / api_tenant / api_platform / api_external_user / im_user / embed_channel / embed_session / embed_visitor / mcp_endpoint——每一种都是”谁在说话”,而不是”他能做什么”。
至于”能做什么”,交给另外的机制:
- 空间 RBAC 四级矩阵:Owner / Admin / Contributor / Viewer
- 资源归属:知识库属于谁
- 权限范围 API Key:能力级授权 + 按 KB 限制
- 每空间审计日志
顺带:一次真实的工具瘦身#
docs/agent-tools-design.md 是一份设计评审文档,里面有一张”发现 → 后果 → 处理”的表。摘几条:
| 发现 | 后果 | 处理 |
|---|---|---|
read_skill 和 read_sandbox_file 各自维护读取入口 | 选工具和读大技能都多一层成本 | 合并为 read_file(path, offset, limit, max_bytes) |
| 每条工具失败都追加”换一种方式” | 权限问题反复改用其他工具尝试 | 删除统一重试提示;要求先改变相关条件再重试 |
| 所有工具可同时执行 | 同轮写脚本、执行、读取结果之间有竞态 | 仅显式列出的读取工具并发;写入、任意命令、未知/MCP 工具按原顺序形成屏障 |
| shell 的超时结果仍标记成功 | 模型可能误判完成 | 超时/终止/执行器错误返回工具失败;普通非零退出保留 exit_code |
| Docker 实际使用 sh,但工具宣称 Bash | 数组等合法 Bash 语法失败 | Docker shell 命令显式使用 Bash |
未指定 allowed_tools 的后端默认值 | 工具太多,选择成本高 | 从 11 项缩为 5 项 |
“显式列出的读取工具才并发,其余形成屏障”——这一条特别值得抄。并行工具调用很诱人,但写脚本 + 执行 + 读结果不该并行,这是竞态。所以它把并行限制在”读”这一类,而写和任意命令变成顺序屏障。
还有一条关于 prompt 缩减的:原来”每条工具失败都追加一句’换一种方式’“,结果模型遇到权限问题就换个工具反复试。删掉统一提示,改成**“先改变相关条件再重试”**。
最后一句特别有品味:
它不能证明当时已注册哪些检索工具,但暴露了 Prompt 中的真实缺口。
“截图不能证明”——它在文档里明确区分了”我看到的证据”和”我推断的结论”。
八、内涵点六:worker 并发是”调度预算”,不是”容量”#
最后一个点,是给所有做后台任务的人看的。
文档摄取(RAG 入库)是一条很长的流水线:解析 → 分块 → 向量化 → 摘要 → 多模态 → 图谱抽取 → 问题生成。WeKnora 用 asynq 做任务队列,但不是一个池,是六个:
| 池 | 每实例默认 | 队列 | 用途 |
|---|---|---|---|
| Core | 8 | default | 文档解析 + 手动重解析保障 |
| Post-process | 2 | postprocess | 解析收尾与富化扇出 |
| Enrichment | 12 | summary / multimodal / graph / question | 模型重活保障 |
| Maintenance | 4 | sync / low | 源同步、批量、移动/删除/清理 |
| Shared | 6 | 核心与富化队列 | 谁积压谁借的弹性容量 |
| Wiki | 8 | wiki | 独立治理,不占上面 32 个 |
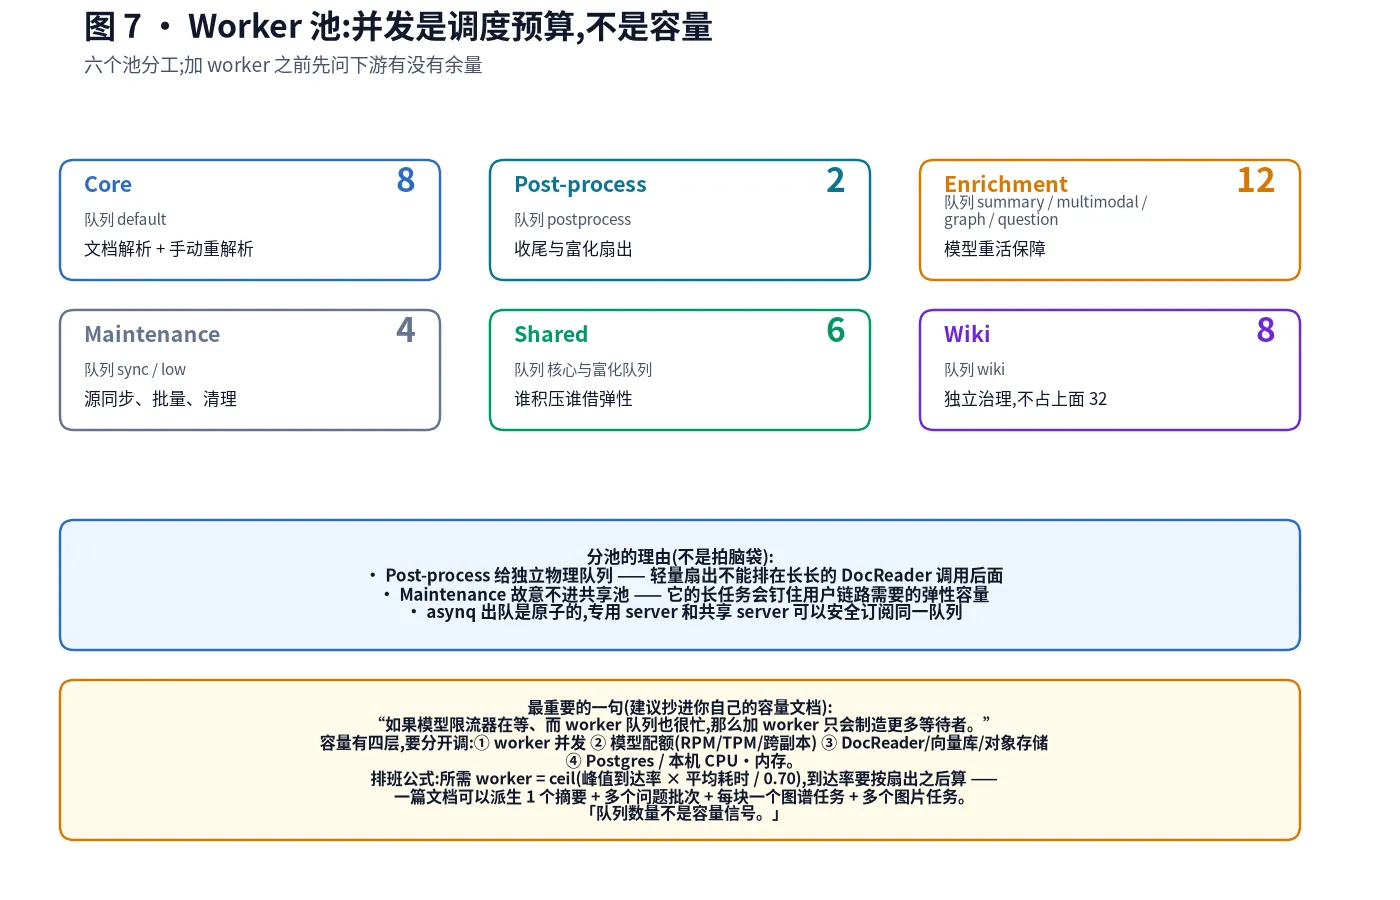
分池的理由都写清楚了:
Post-process has its own physical queue so lightweight fan-out work cannot sit behind long DocReader calls. Maintenance is intentionally excluded from the shared pool because its long-running tasks could pin elastic capacity needed by the user-facing pipeline.
一句话:给一个”轻活”单独的队列,因为它不该排在”重活”后面;把”长活”排除出弹性池,因为它会占着别人要用的资源。
然后是那句我想让你抄进自己文档里的话#
WeKnora uses guaranteed per-stage worker pools plus an elastic pool for the document ingestion pipeline. Worker concurrency is a scheduling budget, not a replacement for model quotas, DocReader capacity, vector-store limits, or database connection limits.
而下面这段是整篇文档里最锋利的一句:
If model limiter waiting grows while worker queues are busy, adding workers only creates more waiters. Increase the provider quota or reduce worker admission instead.
“如果模型限流器在排队,而 worker 队列也很忙,那么加 worker 只会制造更多等待者。”
我想你可以回想一下:你上一次遇到”任务积压”的时候,第一反应是不是”再多加几个消费者”?
这句话说的是:并发不是容量。 你的系统里有四层独立的限制,要分开调:
- worker 并发——每实例准入多少任务处理器
- 模型配额治理——跨副本、跨配额组的供应商并发 / RPM / TPM
- DocReader / 向量库 / 对象存储 / Postgres——各自的资源上限
- 本机 CPU / 内存
只调第一层,后面三层不变,就是把排队从队列搬到了限流器。
怎么算该开多少#
它给了一个可以直接用的公式:
required workers = ceil(峰值任务到达率 × 平均任务耗时 / 0.70)还有一个坑标出来了:到达率要按”扇出之后”算。
One parsed document can create one summary, multiple question batches, one graph task per chunk, and multiple image tasks. Queue count is not a capacity signal.
一篇文档会派生:一个摘要 + 多个问题批次 + 每块一个图谱任务 + 多个图片任务。 所以你看到的”队列里有 3 个任务”,实际可能是 300 个子任务。
最后这句我要单独引:「队列数量不是容量信号。」
以及调优的方向感也写清楚了:
Increase a pool only when backlog age grows while its downstream dependency has headroom. Reallocate to enrichment when core stays underutilized and fan-out queues grow. Reduce core admission when DocReader CPU, memory, or latency is the bottleneck.
当下游有余量、而积压时间在涨 → 才加。 反过来说:下游是瓶颈的时候,加 worker 是负优化。
九、最后:它最值钱的地方,是它知道自己不知道什么#
写到这里,我想把六个点收一下。它们的共同点不是”技术难”,而是**“诚实的工程”**。
你看这些原话:
- “Vecta 基准测了 50 篇论文,512/15% 是最强的单旋钮基线,69%。” —— 承认基线
- “Do NOT invent a topic, do NOT guess from any other clue.” —— 明确禁止编
- “
e2bgateway/circlesac/sandbox/Cage……star 数与维护强度都在个位数量级,作为生产依赖风险过高。” —— 点名说不建议 - “Paused sandboxes MUST be included: they are precisely the leaked ones.” —— 指出最容易漏的那一类
- “本次没有审阅其整个 monorepo,也没有复制实现。” —— 界定评审范围
- “本次没有调用线上模型回放……因此不宣称具体的 Token 或重试率降幅。” —— 不吹没测过的数字
- “队列数量不是容量信号。” —— 纠正一个常见的错误直觉
技术圈有句话叫”能力可以装,边界装不出来”。
一个系统能在文档里写下”我没测过这个""我不建议你用那个""这个错误看起来像超限但不是超限""暂停态的就是泄漏的那批”——说明它对自己实际上是什么样,有一个清醒的认识。
而这类清醒,恰恰是它最值钱的地方。
回到标题#
那个”实习生”其实不神秘。他做的事,拆开看就是:
- 把文档切对(三层分块 + 体检兜底)
- 把实体抽出来(一次调用,slug 连续,编不出来就说编不出来)
- 把目录分配对(整批一次定,复用已有,逐字符)
- 把历史压得住(切点合法、预算当天花板、路径机械保留)
- 把环境管得好(一个协议、一张能力表、三种回收)
- 把权限放在后端(而不是写进 prompt)
- 把并发当预算(而不是当容量)
没有一条是魔法。每一条都是”想清楚了”的结果。
如果一个知识库产品只做到第 1 条,它能用。做到第 4、5、6、7 条,它能进企业。
而你能从这篇文章里拿走的,不是”要不要用 WeKnora”——
是那七个决定,和你自己系统里的对应位置。
附:一些数字#
| 项 | 值 |
|---|---|
| 版本 | v0.8.0(2026-09) |
| License | MIT |
| Go | 2,350 个文件 / ~60 万行 |
| 前端 | 205 个 .vue + 362 个 .ts |
| 文档 | 205 篇 Markdown(含设计评审) |
| 数据库迁移 | 103 个 |
| 沙箱子系统 | 33,517 行(internal/sandbox) |
| Agent 工具 | 32,219 行(internal/agent/tools) |
| 模型厂商 | 20+ 家(含 LiteLLM) |
| 向量库 | PostgreSQL(pgvector) / Elasticsearch / OpenSearch / Milvus / Weaviate / Qdrant / Apache Doris / 腾讯云 VectorDB |
| IM 集成 | 企业微信 / 飞书 / Lark / QQBot / Slack / Telegram / 钉钉 / Mattermost / 微信 / 云之家 |
| 数据源 | 飞书知识库 / 飞书云盘 / GitLab / 腾讯 IMA / Notion / 语雀 / 钉钉文档 / RSS |
| MCP Server | 官方 PyPI 包 tencent-weknora-mcp,29 个工具,stdio / SSE / HTTP |
参考#
- Tencent/WeKnora 仓库 ↗
- README_CN.md ↗ — 项目介绍与最新更新
- docs/CHUNKING.md ↗ — 分块指南(含 Vecta 基线出处)
- docs/agent-tools-design.md ↗ — Agent 工具设计评审
- docs/agent-prompt-assembly.md ↗ — 九段提示词拼装与规则归属
- docs/worker-pool-governance.md ↗ — Worker 池治理
- docs/sandbox-protocol.md ↗ — 以 E2B 协议为唯一接入契约
- docs/sandbox-docker-backend.md ↗ — Docker 沙箱后端
- internal/agent/compaction/ ↗ — 上下文压缩(cutpoint / overflow / fileops)
- internal/sandbox/url_guard.go ↗ — SSRF 双层防护
- internal/infrastructure/chunker/ ↗ — 自适应三层分块
- 官方文档站 ↗